Du code au merge : organiser le travail des agents en équipe
Guide du talk Dev With AI : harnais, contrôles locaux, reviews IA, corrections bornées et résultats liés au bon commit. Exemples et slides.
Aller au résumé
Écrit par Florian Bruniaux
Founding Engineer / directeur technique chez Méthode Aristote. J’ai 13 ans d’expérience, de développeur à CTO, et j’ai accompagné la croissance d’équipes d’ingénierie. Je conçois des outils open source pour les développeurs. Découvrez mes autres réalisations.
Ce que vous en retirez
- ✓ Organiser les vérifications entre le poste, le dépôt, la CI et l’équipe
- ✓ Consolider les reviews et vérifier les corrections proposées
- ✓ Borner les tentatives des agents et rattacher les résultats au commit à merger
- ✓ Choisir une amélioration et mesurer son effet sur le travail de l’équipe
Prérequis
- → Connaître les pull requests, les tests et le rôle de la CI
Les agents produisent du code et des pull requests en parallèle. Derrière, quelqu’un doit comprendre le changement, vérifier son comportement et décider de l’intégrer. C’est le problème que j’ai présenté le 12 octobre 2026 à Dev With AI, au Forum des Images à Paris, dans le talk « Coder plus vite avec l’IA, livrer mieux en équipe : du code au merge ».
Je travaille aujourd’hui comme AI Founding Engineer chez Méthode Aristote. Mon sujet est le harness et le context engineering : les informations données aux agents, leurs outils, leurs permissions et les contrôles qui encadrent leur travail. Mon parcours en IA a commencé en 2017, avec le NLP, le machine learning et le big data ; depuis 2025, je travaille quotidiennement avec l’IA générative et les agents de développement.
Ce guide reprend le raisonnement du talk et développe les explications données à l’oral. Il distingue nos pratiques, le fonctionnement que nous cherchons à organiser et les exemples simplifiés. Il ne présente pas l’ensemble du harnais cible comme déjà déployé ni ses gains comme mesurés.
Pour les autres talks de la journée : retrouvez la synthèse de la conférence Dev With AI, avec le dossier illustré complet en français et en anglais.
Read this guide in English · Télécharger les 21 slides, sans notes présentateur (PDF)
Les 18 slides de contenu sont intégrées au fil du guide, avec le plan et les ressources. La couverture, ma bio et la photo de mon bureau sont laissées de côté. Cliquez sur une slide pour l’ouvrir en grand.
TL;DR
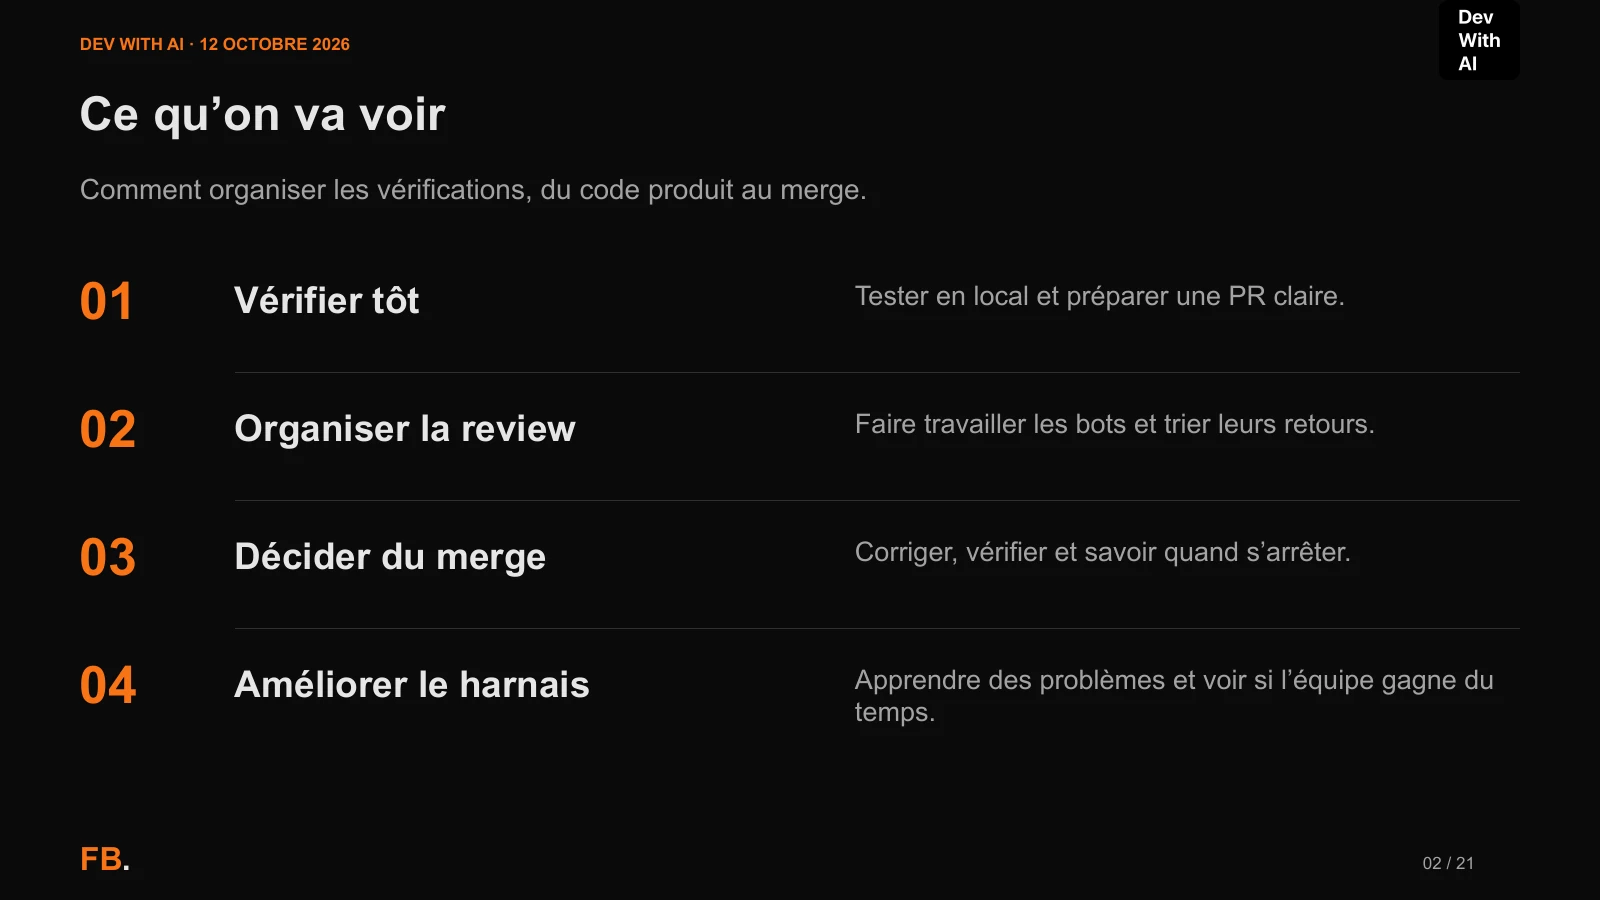
Je veux vérifier tôt, organiser la review et savoir arrêter les corrections. Produire davantage de PR aide seulement si les vérifications et les décisions suivent.
Je commence par des contrôles locaux adaptés au changement et une PR compréhensible. Je traite les retours des reviewers comme des propositions à vérifier dans le code actuel. Après une correction, je regarde le nouveau diff et les résultats qui concernent ce commit. Les tests requis et la décision humaine restent nécessaires dans le parcours présenté ici.
Le harnais s’améliore à partir des problèmes récurrents. Pour choisir ce qui mérite de rester, je regarde le temps humain, l’attente, les reprises, la qualité après livraison et les coûts, tentatives ratées comprises.
1. Où le travail s’accumule après la génération du code
Les résumés restent visibles. Ouvrez les parties que vous souhaitez approfondir.
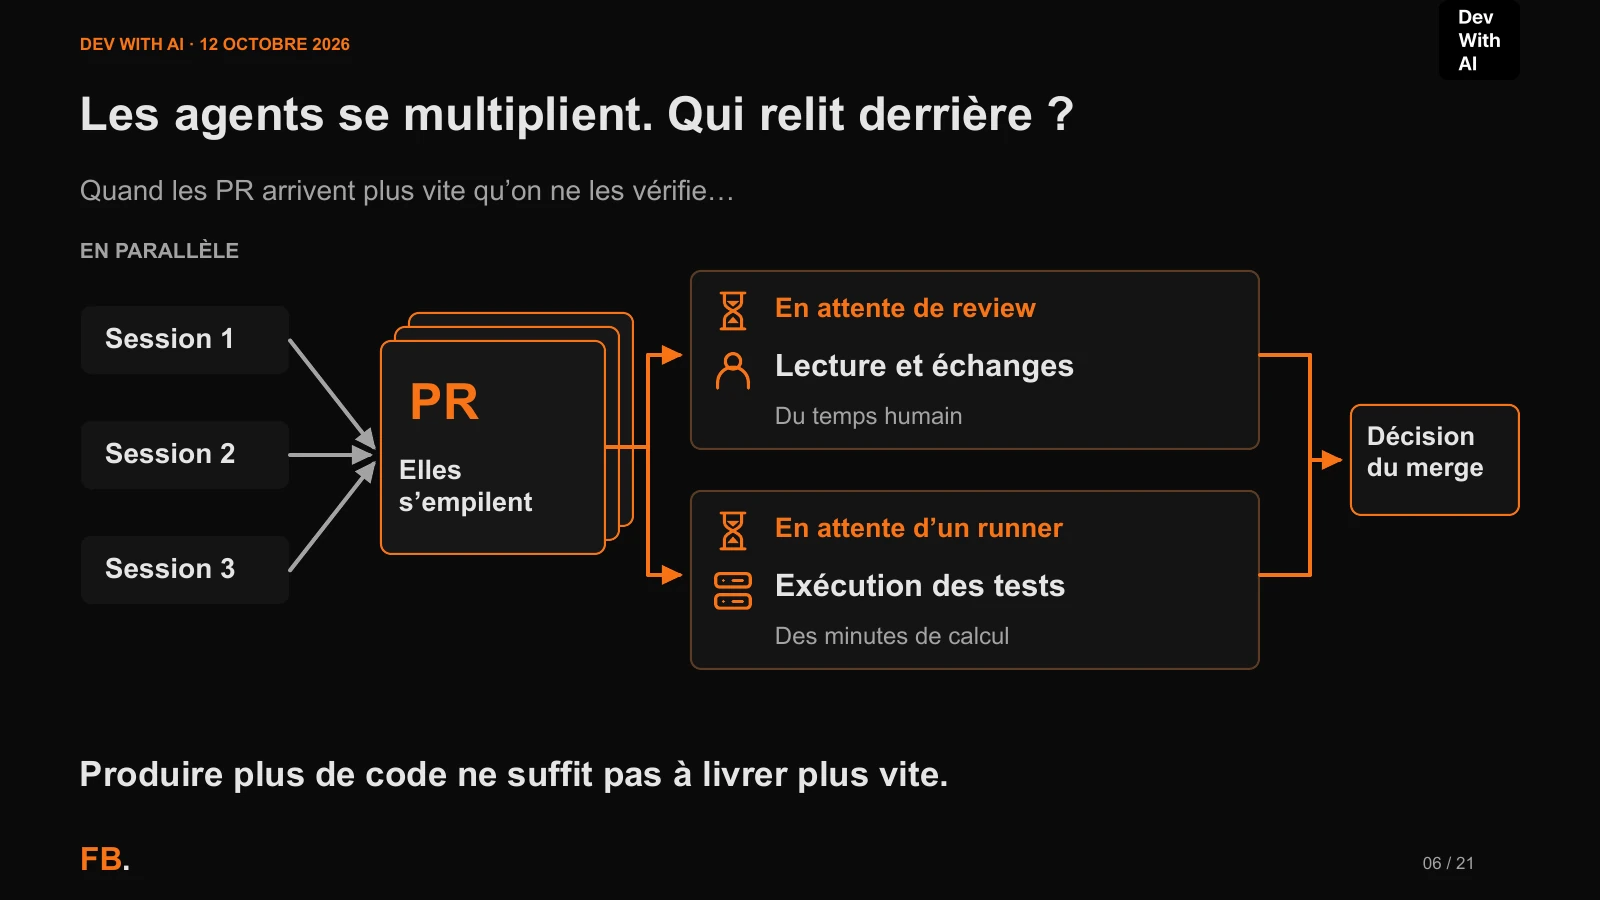
Produire plus de PR peut augmenter l’attente en review ou en CI. Je cherche où le travail se bloque, en séparant le temps de travail de l’attente.
Lire le détail, les exemples et les slides
Quand plusieurs sessions produisent des PR plus vite que l’équipe ne les vérifie, les PR s’empilent. Une session supplémentaire peut augmenter la production sans réduire le délai de livraison. La question devient : qu’est-ce qui attend, et qui peut débloquer l’étape suivante ?
Il faut séparer le travail de l’attente. Une PR peut attendre une personne disponible, puis demander du temps pour lire le diff, reconstruire le contexte et discuter d’une correction. La CI peut attendre un runner, puis consommer du calcul en exécutant les tests. Une relance ajoute du calcul et peut demander une nouvelle review. Ces activités ont des causes et des coûts différents.
Review et CI peuvent avancer en parallèle. Mais si une vérification nécessaire manque, la décision du merge attend. Compter uniquement les commits ou les PR ouvertes masque ce travail en aval.
Sur une PR récente, je cherche donc les moments où rien ne pouvait avancer : contexte absent, résultat de test manquant, reviewer indisponible ou correction à reprendre. C’est plus utile pour choisir une amélioration que le nombre de sessions en cours.
Coding faster moves the cost to verification (🇬🇧 EN) ouvre ma série Engineering the Review Loop : il relie ces files d’attente aux mesures de livraison et sépare le coût d’un essai du coût du travail accepté.
2. Les quatre couches du harnais et les contrôles locaux
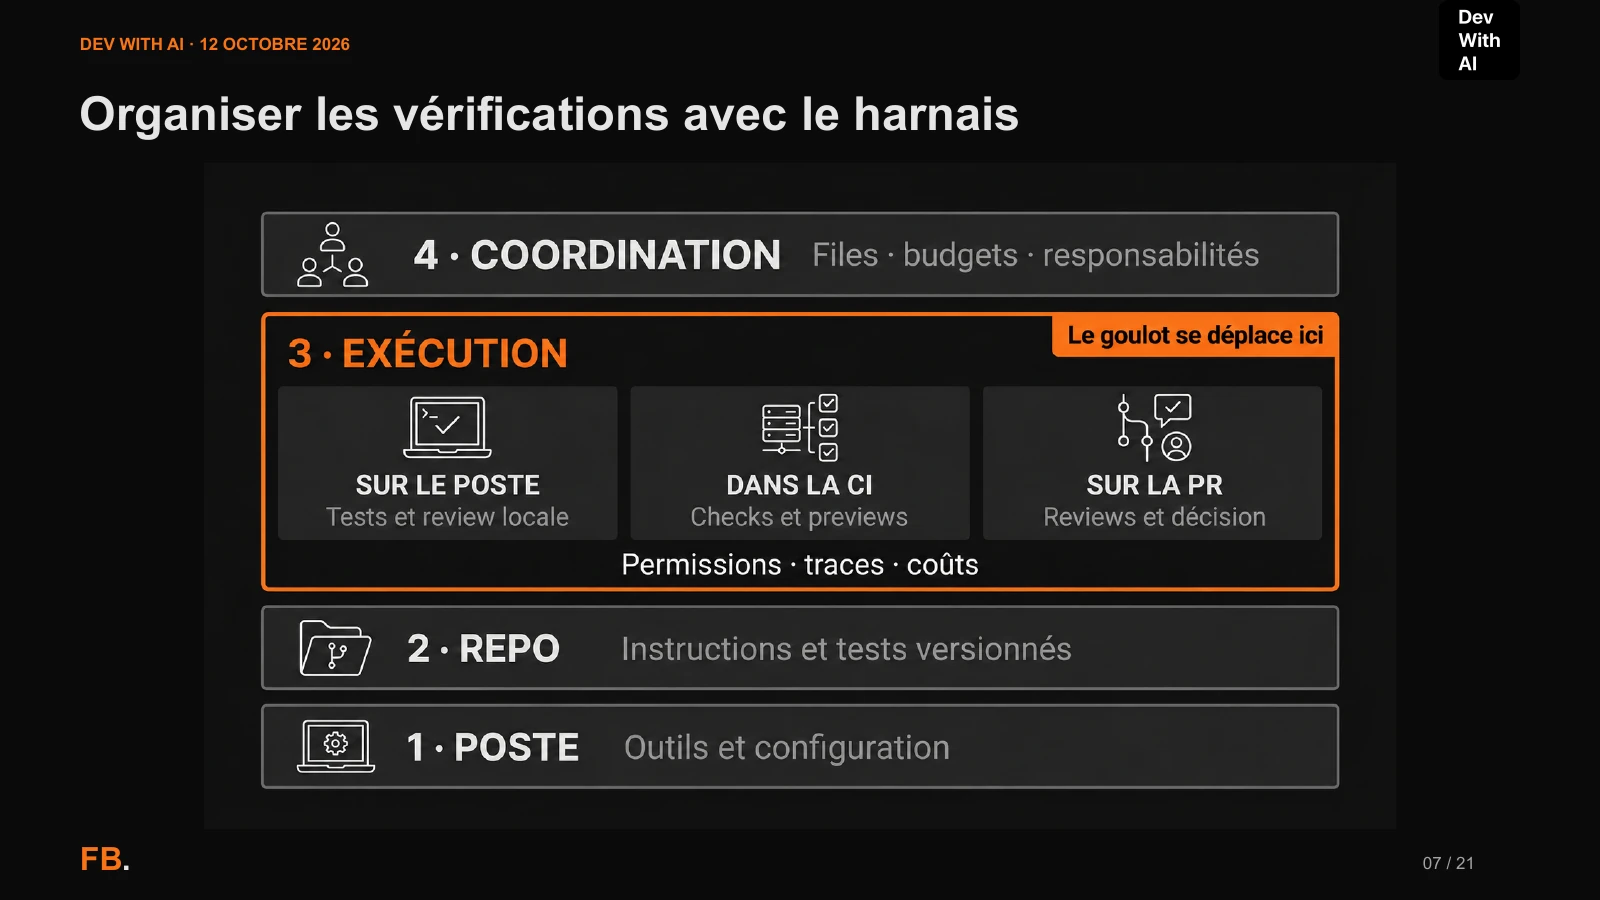
Le harnais relie le poste, les règles du dépôt, l’exécution des contrôles et la coordination. Les vérifications locales préparent la PR et restent complémentaires des tests obligatoires de la CI.
Lire le détail, les exemples et les slides
J’appelle harnais l’ensemble des instructions, des outils et des contrôles qui encadrent les agents, avec leurs permissions et leurs budgets. Son fonctionnement dépend aussi de l’organisation : qui relit, qui répond aux questions et qui décide ?
Dans Harness engineering for coding agent users (2 avril 2026), Birgitta Böckeler distingue les guides avant l’action et les capteurs après l’action. Chacun peut mobiliser des outils déterministes ou le jugement d’un modèle. Consignes, tests et reviews ont donc des rôles distincts. Maintenabilité, architecture et comportement demandent des contrôles adaptés. Le pilotage humain reste nécessaire ; des tests écrits par l’agent ne suffisent pas à établir le comportement attendu.
Pour la couche partagée par l’équipe, mon article sur le système d’instructions IA chez Aristote détaille les sources communes, les responsabilités et les contrôles de dérive. Il est en anglais et développe la partie organisationnelle du context engineering.
Pour choisir ce qui doit entrer dans le contexte, le guide L0–L5 du context engineering (🇬🇧 EN) part du problème observé : information manquante, règle hors sujet ou comportement à vérifier. Il distingue les consignes permanentes des procédures à charger selon la tâche. Ces capacités de contexte complètent les quatre couches du harnais ci-dessous ; les deux découpages décrivent des choses différentes.
Je le lis en quatre couches, du bas vers le haut :
| Couche | Ce qu’elle contient | Ce qu’il faut pouvoir retrouver |
|---|---|---|
| Le poste | Outils et configuration locale | Les moyens de travailler et de lancer les contrôles |
| Le dépôt | Instructions et tests partagés | Les règles communes au changement |
| L’exécution | Tests et review locaux, checks et previews CI, reviews de PR | Ce qui a tourné, sur quelle version, avec quel résultat |
| La coordination | Sessions, files d’attente, budgets et responsabilités | Ce qui attend et qui doit intervenir |
Vérifier sur le poste avant de demander une nouvelle review
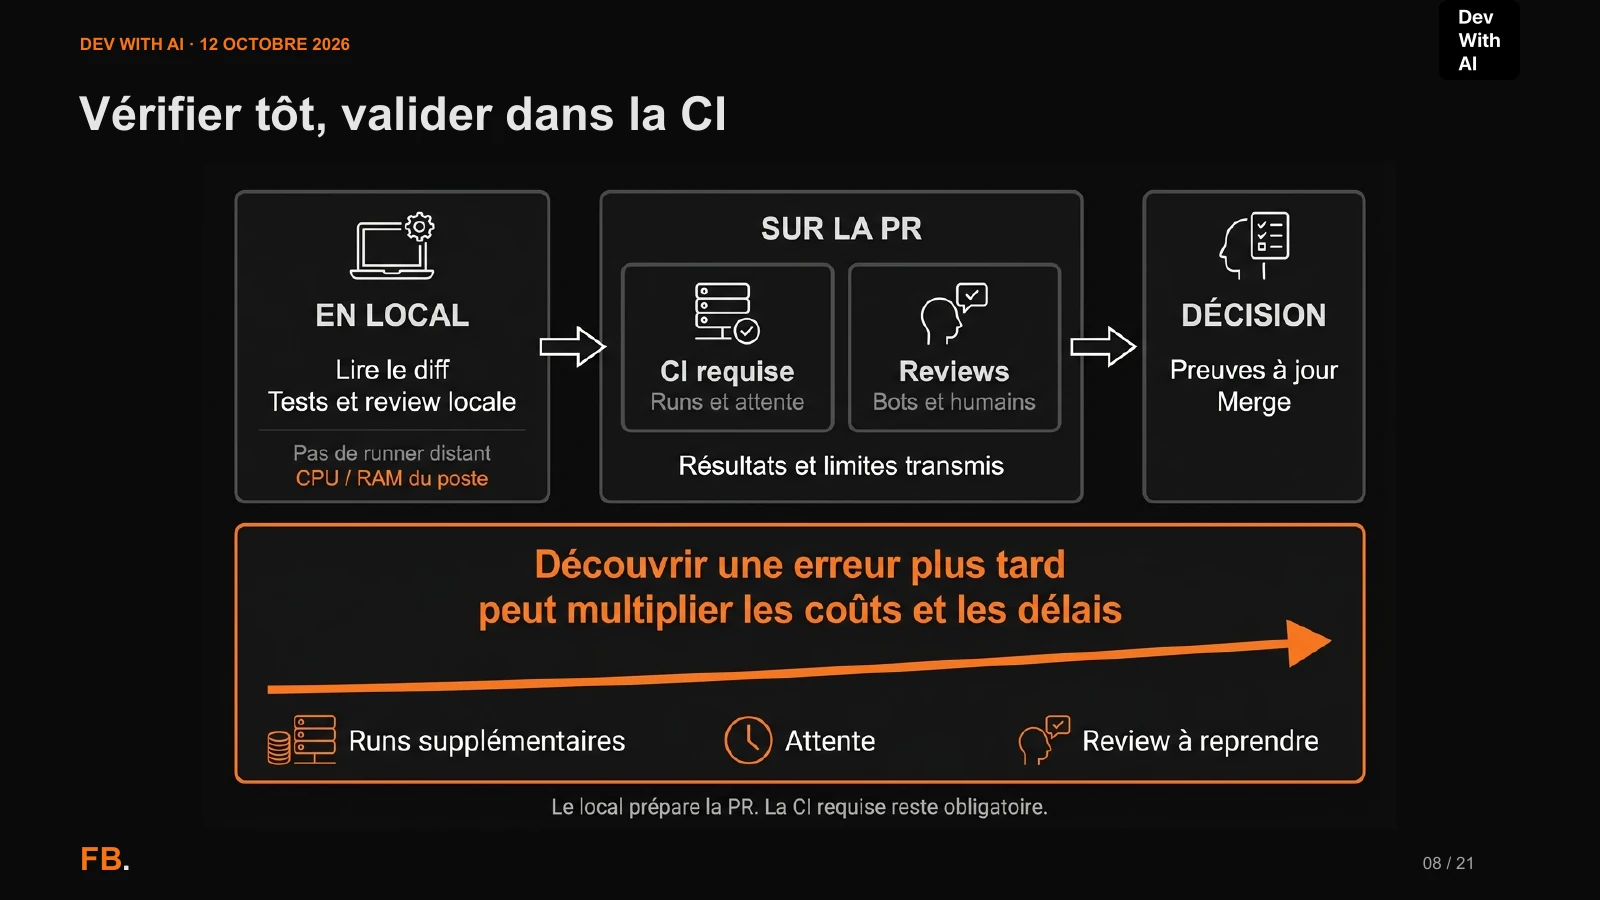
En local, je lis le diff et je lance les contrôles utiles au changement. Trouver une erreur à ce stade peut éviter un push de correction, une relance de CI et une sollicitation supplémentaire du reviewer. C’est une reprise possible que le talk illustre, pas une économie chiffrée.
Le local utilise le CPU et la RAM du poste. Plusieurs worktrees, builds et suites de tests peuvent saturer ces ressources. Et une review orchestrée depuis le poste peut appeler un modèle distant facturé : « lancé en local » ne signifie pas « gratuit » ou « entièrement exécuté sur cette machine ».
Quand plusieurs worktrees coexistent, Worktree Sweep, un de mes projets personnels, aide à inventorier les branches de travail et leurs fichiers locaux pour savoir ce qu’il faut préserver. Son MVP macOS reste en lecture seule : il ne supprime pas les worktrees.
Les contrôles locaux préparent la PR. Ils ne remplacent pas les tests obligatoires de la CI. On peut ouvrir une PR en draft tôt ; avant de la déclarer prête à relire, il faut préciser le changement, les tests effectués et ce qui reste à vérifier.
3. Une PR compréhensible, des vérifications adaptées et le choix des reviewers
Une PR utile explique le problème et les vérifications réellement exécutées. Les contrôles dépendent du risque du changement ; dans le parcours présenté, une personne garde la décision de merge.
Lire le détail, les exemples et les slides
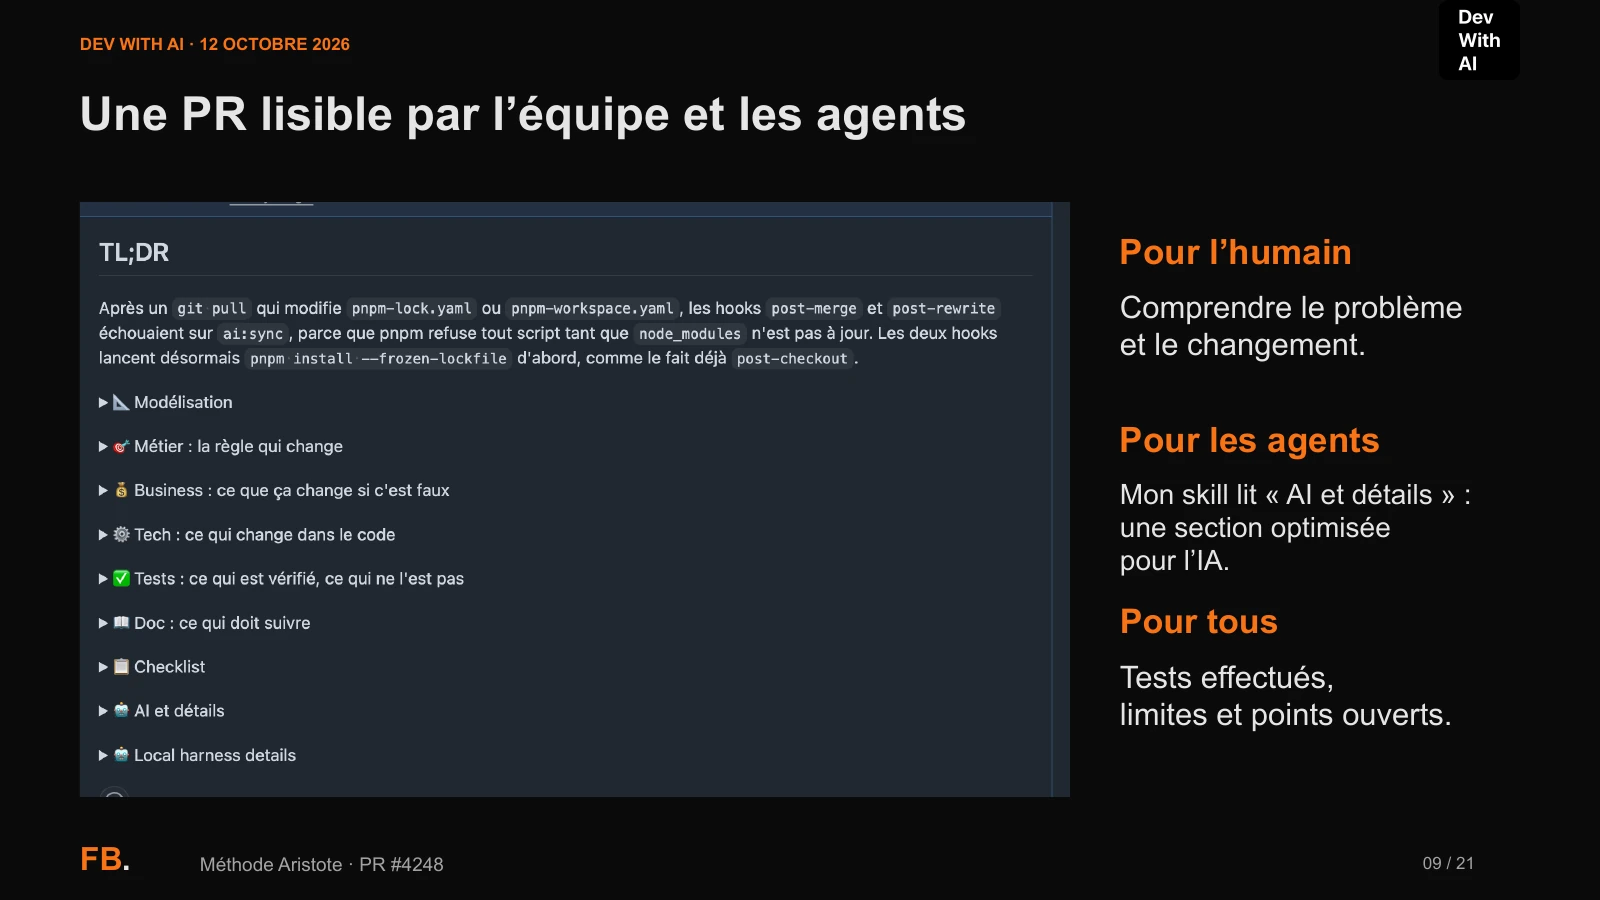
La description doit permettre de comprendre le problème avant de parcourir tout le diff. Elle sert aux humains et aux agents. Dans mon fonctionnement, le résumé explique le changement à l’équipe ; une section repliable « AI et détails » rassemble le contexte technique qu’un skill de lecture de PR va chercher.
Dans l’exemple Aristote présenté au talk, un pull modifiant les dépendances faisait échouer la synchronisation de la configuration IA. Les dépendances installées n’étaient plus à jour. Le correctif les met à jour avant la synchronisation. Ce résumé explique le déclencheur et le résultat attendu ; les détails peuvent ensuite montrer les hooks et les vérifications.
Une description utile donne le problème, le comportement obtenu après le changement, les contrôles réellement exécutés, leurs résultats et les limites restantes. Une liste de tests ou un commentaire « ça fonctionne » ne suffit pas à prouver le comportement.
Pour partir de modèles adaptables, mon projet Claude Code Plugins propose notamment des descriptions de PR, des demandes de review et des checklists de merge. Ce sont des supports pour structurer le travail ; chaque PR doit encore renseigner ses propres contrôles et résultats.
Partir de ce que le changement peut casser
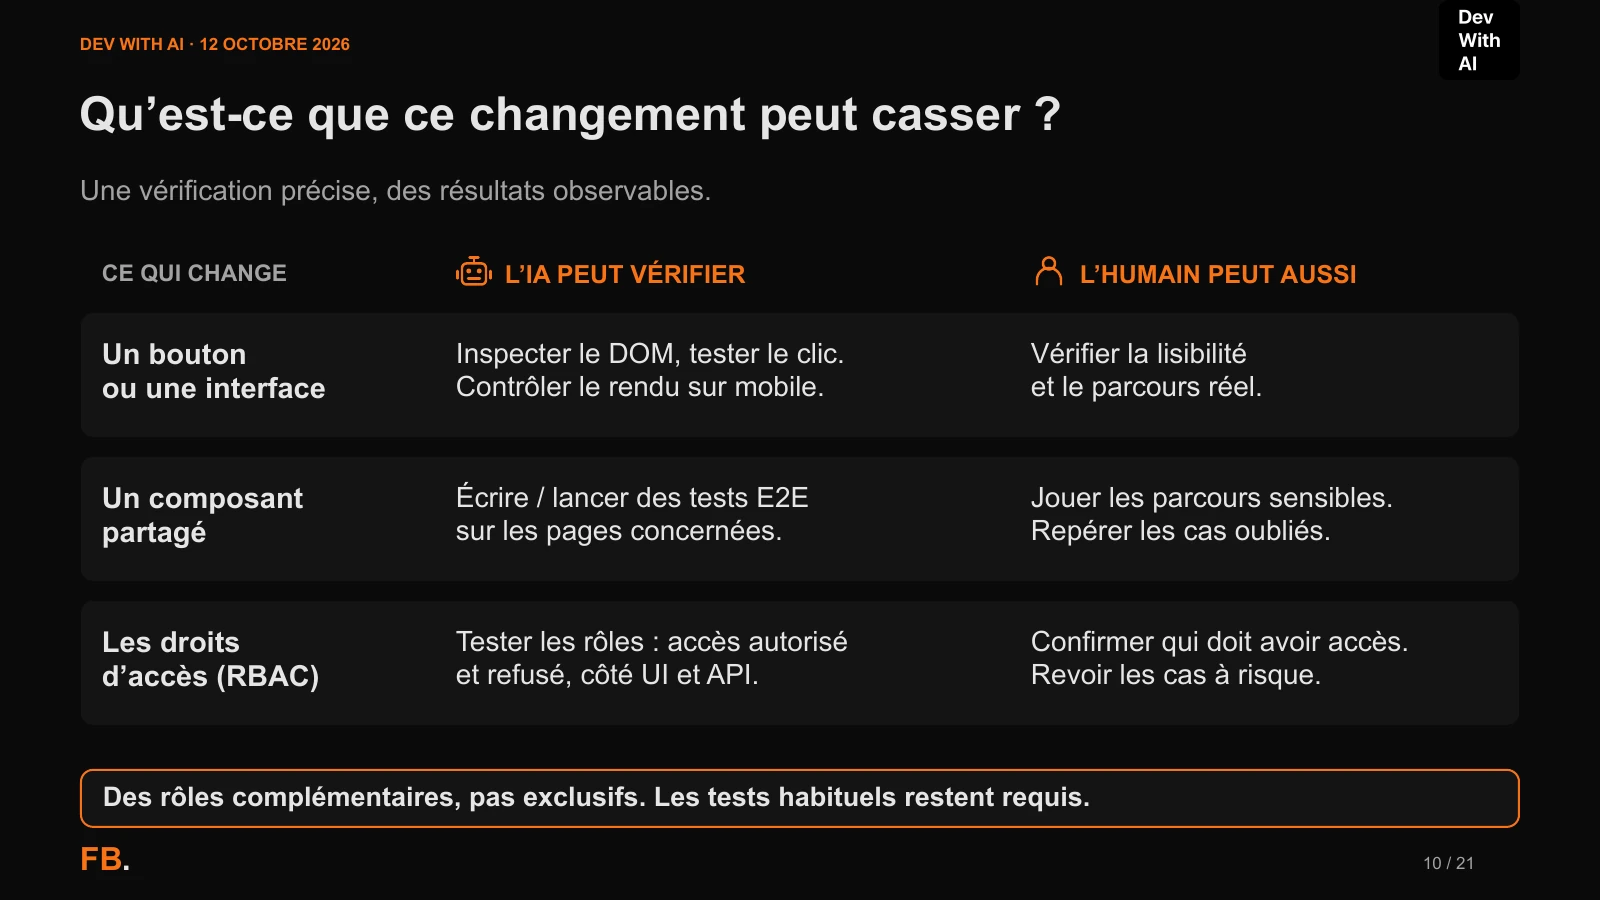
| Changement | Contrôle observable | Décision à clarifier |
|---|---|---|
| Bouton ou interface | Présence, visibilité, clic et rendu mobile | Le parcours est-il lisible et utilisable ? |
| Composant partagé | Parcours de bout en bout sur les pages touchées | Quelles pages et quels usages peuvent être affectés ? |
| Droits d’accès | Accès autorisé et refusé, dans l’interface et via l’API | Qui doit pouvoir faire quoi, sur quelles données ? |
Ces rôles peuvent être tenus par un agent, une personne ou les deux. L’agent a besoin du risque à vérifier, du résultat attendu et des outils nécessaires. L’humain peut compléter les cas, rejouer le parcours et arbitrer une règle métier incertaine.
Présent dans le DOM ne veut pas dire visible, lisible ou fonctionnel. Pour un bouton, il faut regarder le rendu et tester l’action attendue. Un composant partagé peut toucher plusieurs pages malgré un diff court. Pour les droits d’accès, masquer un bouton ne sécurise pas l’API : le serveur doit aussi refuser une requête non autorisée.
Un test écrit mais non lancé reste un contrôle à effectuer. Ces vérifications ciblées s’ajoutent aux contrôles habituels de l’équipe.
Rendre le besoin de review visible
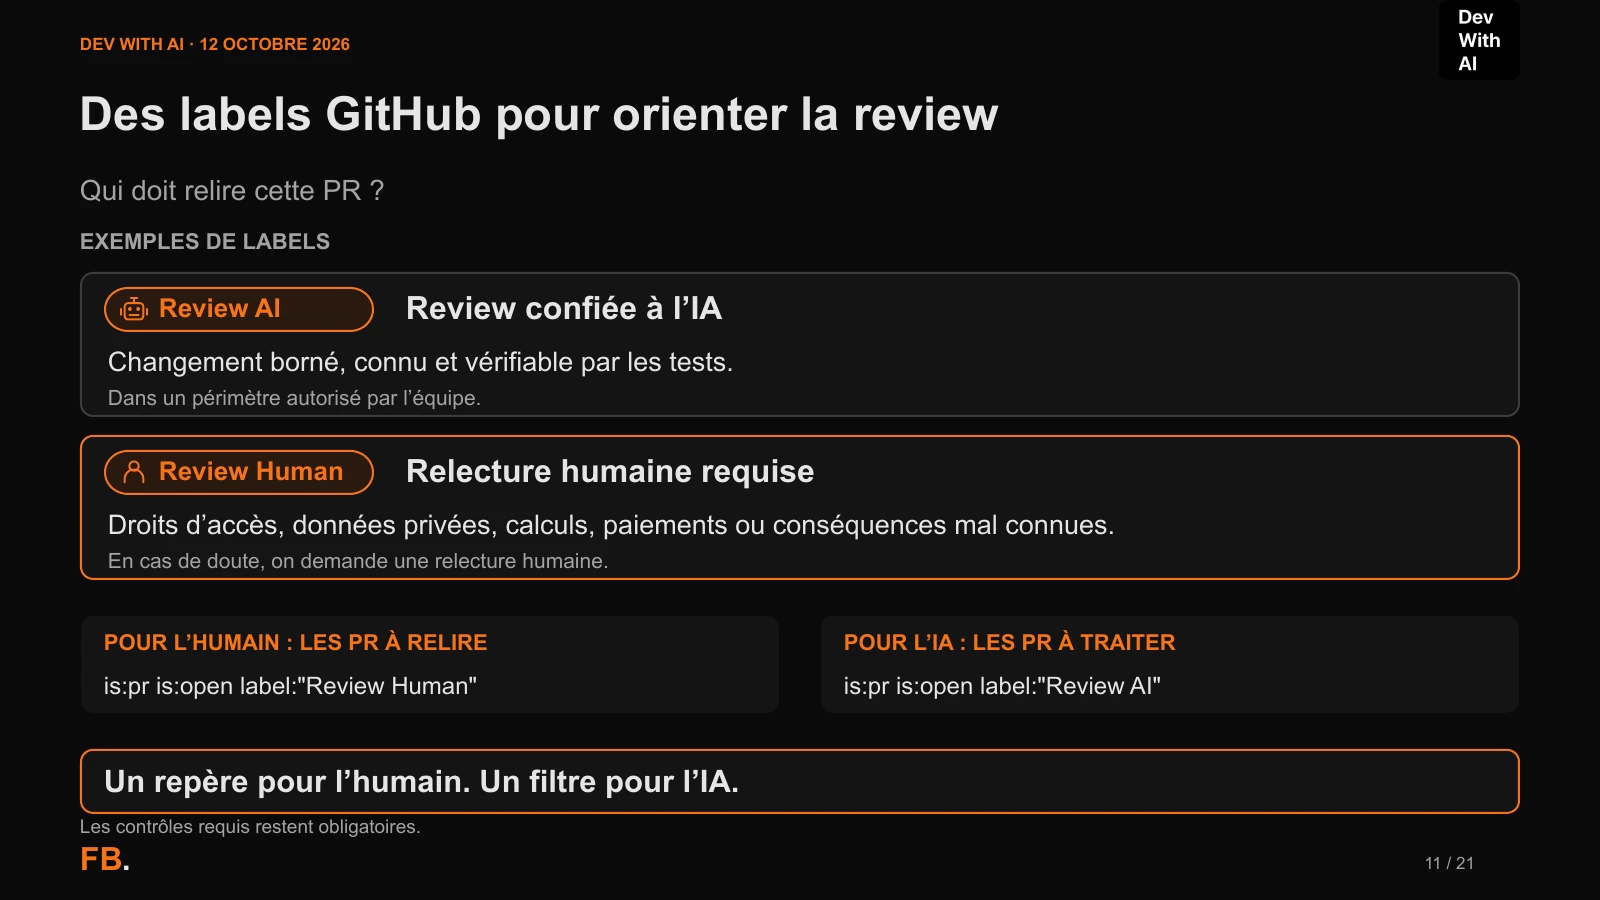
Le talk propose deux noms de labels GitHub : Review AI et Review Human. Ce sont des exemples pour orienter la review, pas la preuve d’un routage déployé partout.
Un changement mécanique, borné et couvert par des tests peut relever d’une review IA dans un périmètre autorisé par l’équipe. Les droits d’accès, les données privées, les paiements, les calculs métier et les conséquences mal comprises demandent une relecture humaine. Une petite PR peut avoir de grandes conséquences. En cas de doute, on demande une personne ; après un push qui change le périmètre, on réévalue ce choix.
Le label aide l’équipe à retrouver les PR qui l’attendent et un agent à sélectionner celles qu’il peut traiter ou préparer. Un filtre GitHub ne déclenche rien à lui seul : un workflow doit effectivement l’utiliser. Le label n’autorise pas le merge. Les contrôles requis restent applicables et, dans ce parcours, une personne décide de l’intégration.
4. Consolider trois reviews et vérifier aussi les corrections suggérées
Je rassemble les retours pour vérifier chaque signal, rapprocher les doublons et conserver les désaccords. Un reviewer peut trouver le bon défaut et proposer le mauvais correctif : les deux sont à vérifier.
Lire le détail, les exemples et les slides
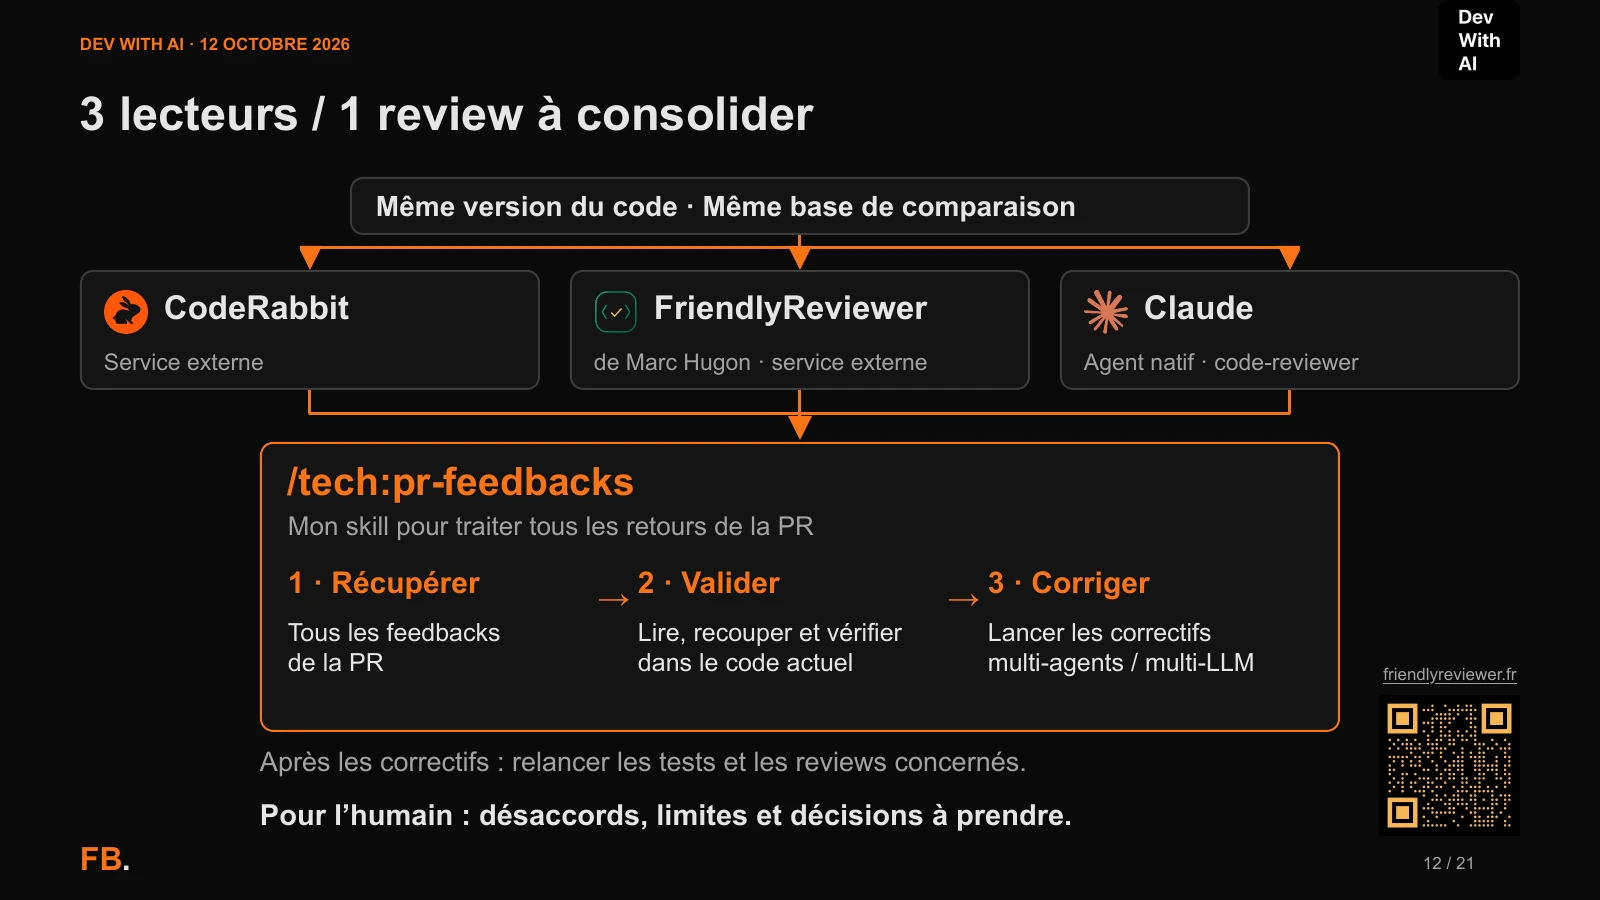
Chez Aristote, nous avons défini un trio : CodeRabbit, FriendlyReviewer de Marc Hugon et Claude comme agent natif de review. Le Claude natif est distinct du bot Claude qui intervient sur GitHub. Dans le workflow décrit au talk, CodeRabbit et FriendlyReviewer travaillent à distance sur un commit déjà poussé ; la coordination se fait depuis le poste.
Les trois lecteurs doivent examiner la même version et la même base de comparaison. Il faut aussi savoir ce qu’ils ont effectivement couvert. Sur la PR utilisée dans le talk, CodeRabbit indiquait exclure le Markdown, alors que nos skills sont écrits en Markdown. Le nom d’un reviewer ne garantit donc pas que tous les fichiers ont été lus.
La PR présentait le dispositif et des reviews GitHub. Elle ne démontrait ni l’exécution complète du trio local ni un gain mesuré. Multiplier les lecteurs reste utile seulement si leurs retours peuvent être exploités.
Traiter les feedbacks ensemble
Le workflow présenté au talk sous le nom /tech:pr-feedbacks organise trois étapes :
- Récupérer l’ensemble des feedbacks de la PR.
- Valider chaque remarque dans le code actuel, regrouper les doublons et faire ressortir les désaccords.
- Corriger les problèmes retenus, avec plusieurs agents ou modèles selon les besoins, puis relancer les tests et les reviews concernés.
Il s’agit d’un workflow personnalisé que je décris, pas d’une commande standard livrée avec les outils de review.
Une remarque peut concerner une ancienne version, manquer de contexte ou contredire une autre proposition. Plusieurs commentaires identiques ne sont pas plusieurs bugs. Le coordinateur garde le lien entre chaque problème, la décision prise et la correction, et vérifie que les modifications restent cohérentes entre elles.
Pour l’humain, la synthèse doit conserver les désaccords, les limites et les décisions à prendre. Une remarque rejetée mérite une raison vérifiable. Une correction lancée mérite un résultat, pas seulement le nom de l’agent chargé de la faire.
Pour examiner l’apport d’un lecteur supplémentaire, When an independent reviewer earns its place propose une comparaison sur le même diff. Operating a multi-reviewer system safely détaille les rôles, les permissions et les sorties dégradées. Ces deux textes sont en anglais ; leurs protocoles ne prouvent pas que notre trio a déjà passé cette évaluation.
Un diagnostic juste peut conduire à un mauvais correctif
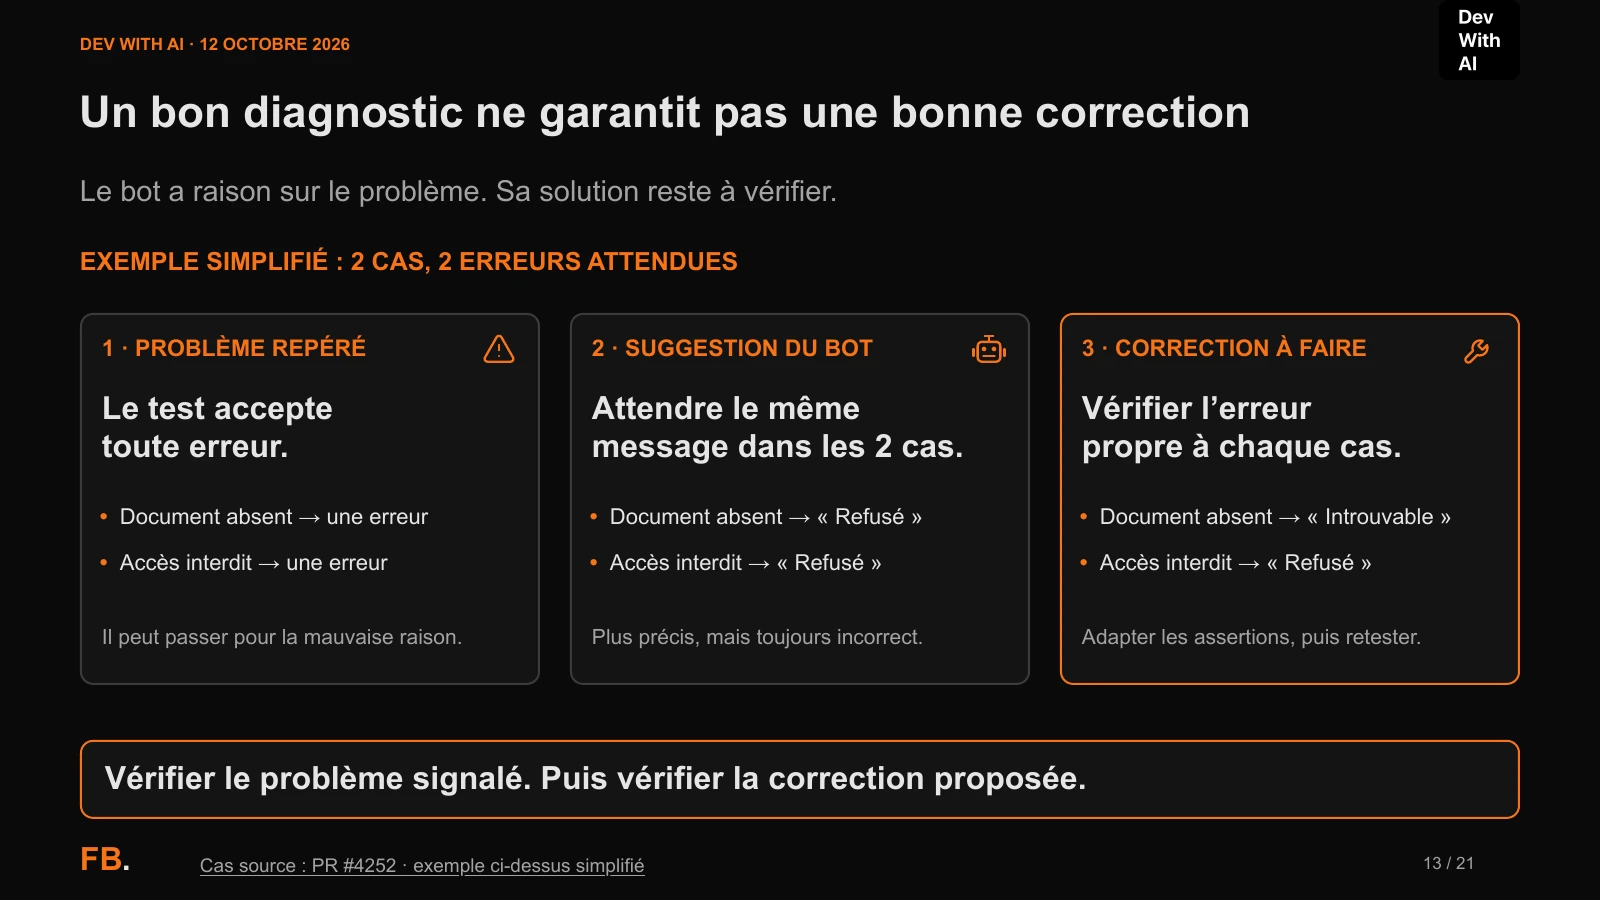
Dans une PR Aristote, CodeRabbit a repéré un test acceptant n’importe quelle erreur. Le diagnostic était utile ; la suggestion utilisait toutefois un même message attendu pour des cas qui en demandaient différents.
Voici l’exemple simplifié du talk, pas les cas ni les messages exacts de la PR :
| Cas | Assertion trop vague | Correction trop générale | Comportement attendu ici |
|---|---|---|---|
| Document absent | Une erreur survient | Le message est « Refusé » | « Introuvable » |
| Accès interdit | Une erreur survient | Le message est « Refusé » | « Refusé » |
L’assertion vague peut passer parce que le code échoue pour la mauvaise raison. La suggestion ajoute de la précision, mais se trompe sur le premier cas. Il faut adapter les assertions au comportement attendu et relancer les tests.
Il y a donc deux décisions à vérifier : le problème signalé, puis la correction proposée. Si le comportement attendu est inconnu, l’agent a besoin d’un arbitrage humain. Après le correctif, le nouveau diff et les résultats doivent être relus.
5. Borner les corrections, lire la CI et rattacher les résultats au bon commit
Les corrections ont un objectif, un budget et une condition d’arrêt. Je distingue un test en échec d’un test non exécuté et rattache les résultats au commit effectivement contrôlé.
Lire le détail, les exemples et les slides
Un agent chargé de corriger après une review ou une CI a besoin d’un objectif, d’un nombre de tentatives autorisées et d’un budget définis avant son lancement. Sinon, une nouvelle tentative peut seulement répéter la précédente.
Designing a bounded review loop développe le contrat du contrôleur, ses compteurs et ses cas d’échec. A green review is not a merge gate complète cette partie avec les résultats associés au commit et la politique de branche. Ces deux ressources en anglais distinguent le contrôle proposé de son fonctionnement effectivement vérifié dans un dépôt.
| Situation | Suite attendue |
|---|---|
| Objectif atteint | Transmettre le changement et les résultats pour review et décision |
| Progrès observable et budget disponible | Poursuivre une correction dans le périmètre prévu |
| Même erreur sans progrès, décision manquante ou budget épuisé | Passer la main avec les tentatives, le blocage et l’interlocuteur connu |
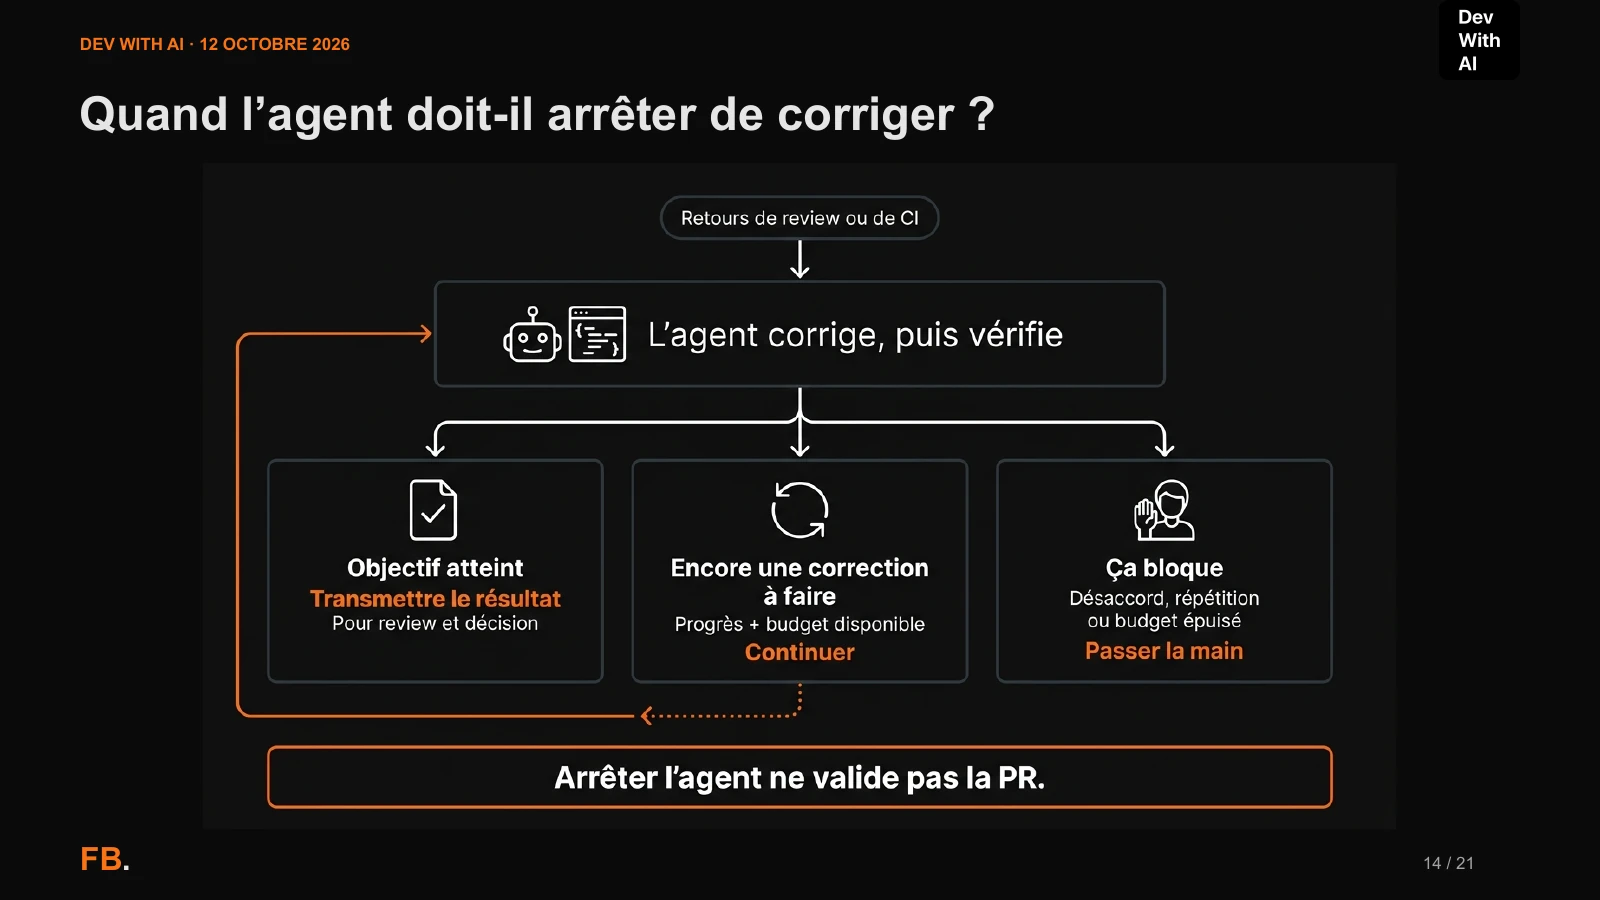
Un passage de main utile explique ce qui a été essayé, ce qui reste inconnu et la prochaine action possible. Le budget épuisé ne prouve pas un bug. Si l’agent tourne dans un job CI, le statut de ce job dépend de son rôle ; les tests obligatoires doivent toujours produire leurs propres résultats.
Une CI rouge demande d’abord un diagnostic
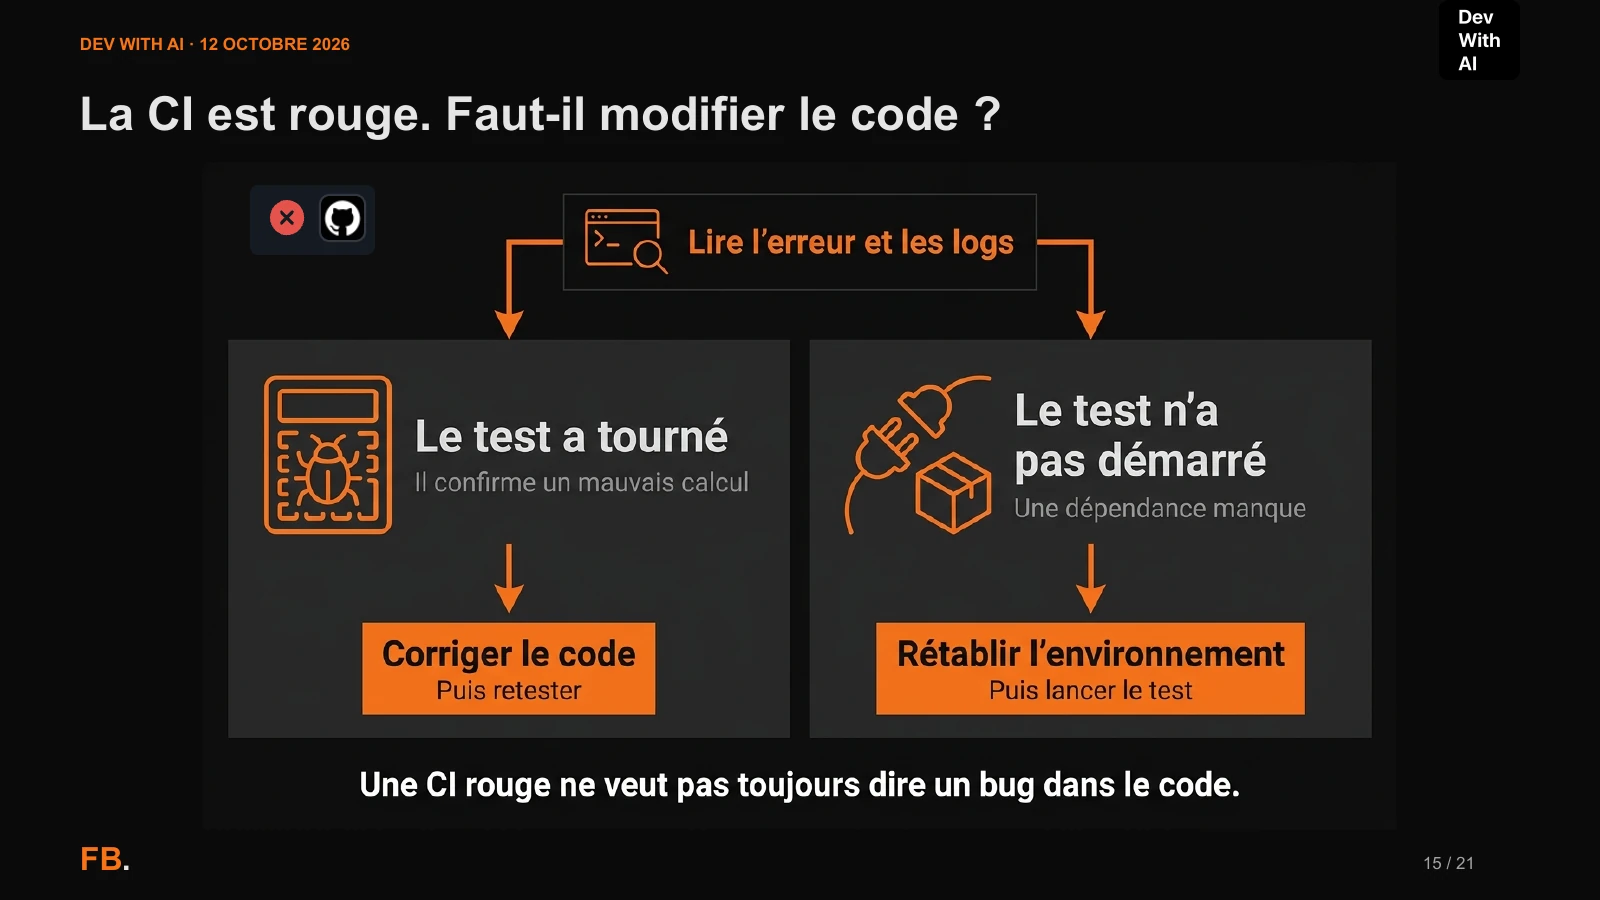
Je commence par lire les logs. Deux cas du talk suffisent à montrer pourquoi :
- Le test a tourné et a constaté un mauvais calcul. On corrige le code, puis on reteste.
- Le test n’a pas démarré parce qu’une dépendance manque. On rétablit l’environnement, puis on exécute le test. Le calcul n’a pas encore été vérifié.
Si le résultat attendu est lui-même flou, il faut préciser la règle métier. Si le résultat du job manque, il faut le récupérer. Demander systématiquement une modification du code à partir d’une croix rouge mélange ces situations.
Les résultats restent attachés à la version testée
Le commit A a été testé et relu. L’agent pousse une correction : le commit B. Les succès sur A restent des résultats sur A ; ils ne prouvent pas le comportement des modifications de B. La review précédente ne couvre pas automatiquement ce qui a changé.
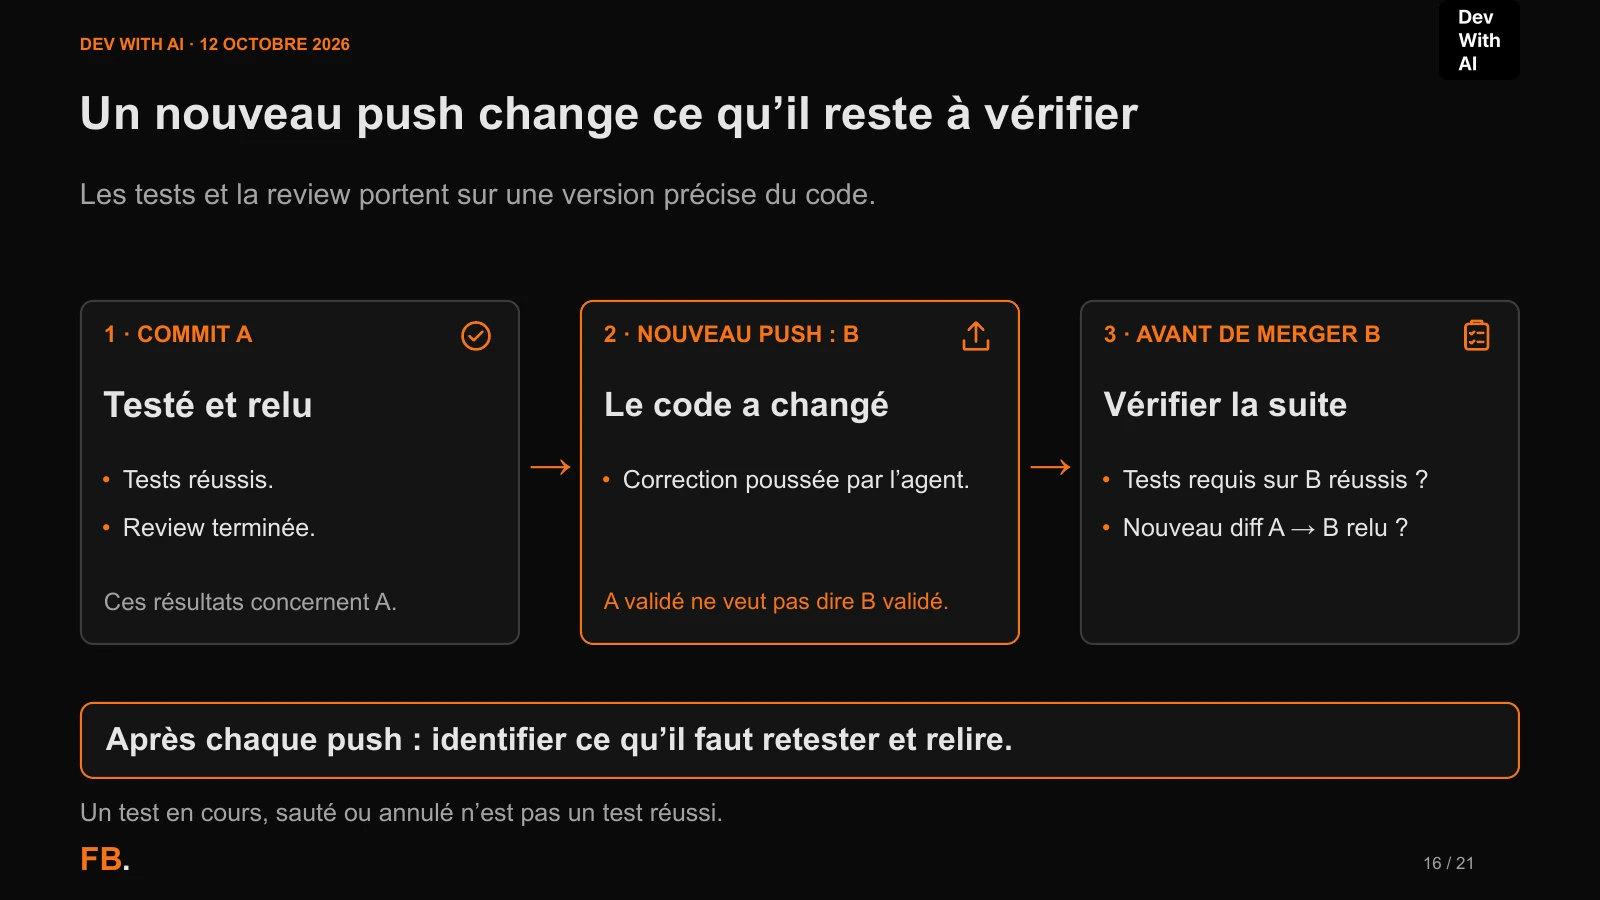
Avant de merger B, je regarde ce qui a changé entre A et B, quels tests ont tourné sur B, leurs résultats et la version effectivement relue. Je reprends les contrôles concernés par le changement, ainsi que ceux requis par l’équipe. Tout n’est pas forcément à refaire, mais ce qui reste couvert et ce qui doit être revérifié doivent être explicites.
Un test en cours, sauté ou annulé n’est pas réussi. Cela ne prouve pas un bug ; il manque un résultat. Une exemption suit les règles de l’équipe. La trace utile sur la PR rassemble le commit, les contrôles et leurs résultats, la couverture de la review, les points ouverts et l’accord humain.
6. Transformer les problèmes récurrents en contrôles testés
Une erreur récurrente mérite un cas précis et une correction de sa cause, dans le code, les tests ou les instructions. Son effet doit ensuite être vérifié sur ce cas et sur les changements suivants.
Lire le détail, les exemples et les slides
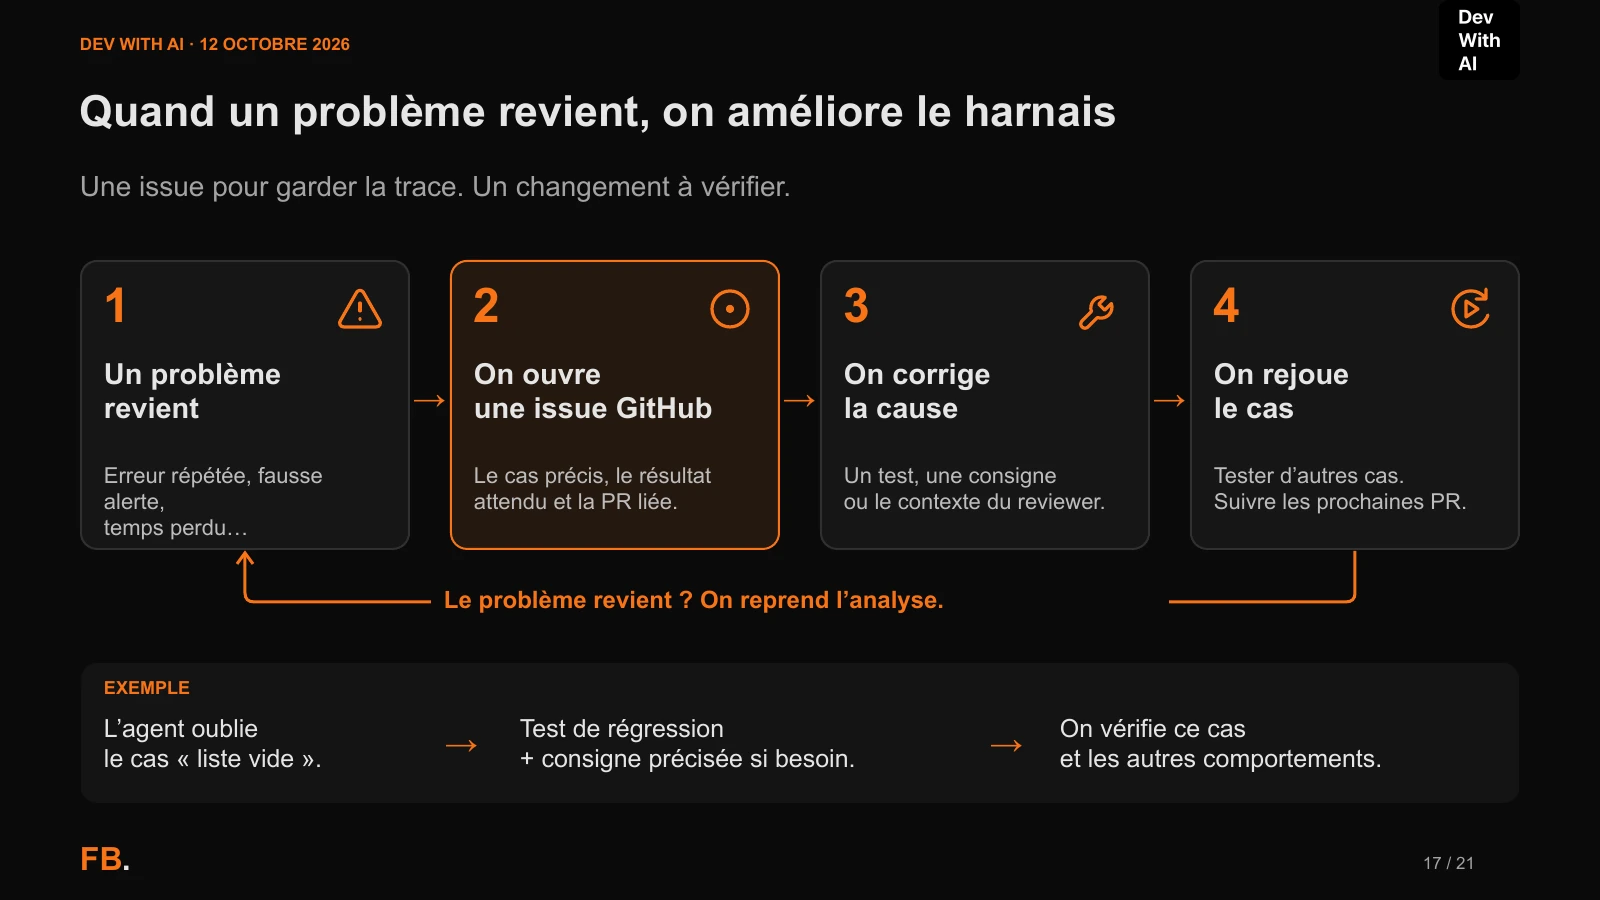
Corriger une PR règle le cas présent. Quand la même erreur, la même fausse alerte ou la même perte de temps revient, il faut aussi regarder ce qui l’a produite.
J’ouvre une issue avec le cas précis, le résultat attendu et la PR liée. Selon la cause, la réponse peut être un test de régression manquant, une instruction moins ambiguë ou du contexte supplémentaire pour le reviewer. Une nouvelle consigne n’est pas toujours la meilleure réponse.
L’exemple du talk est une liste vide mal gérée : on corrige le code, on ajoute un test pour ce cas et on précise la consigne si elle a contribué au problème. Ensuite, on rejoue le cas et les autres comportements concernés. Une correction qui traite la liste vide mais casse la liste non vide n’a pas résolu le besoin.
La suite se vérifie sur les PR suivantes. Le problème revient-il ? La nouvelle règle produit-elle des fausses alertes ou du travail supplémentaire ? Il faut pouvoir la reprendre, la raccourcir ou la retirer si elle n’aide pas.
Installer une règle ne démontre pas un gain. Le harnais évolue avec le code, les outils et l’équipe. Ses contrôles ont eux-mêmes besoin de cas de vérification et d’une personne capable de les maintenir.
L’article Diagnose and repair context drift (🇬🇧 EN), deuxième volet de ma série Context Engineering, détaille la boucle observer, localiser la cause, réparer la source, rejouer le cas. Il sépare la preuve de chargement d’une instruction de son respect dans le comportement de l’agent. C’est un prolongement de cette maintenance, sans établir qu’une boucle auto-apprenante complète a été testée.
Turn recurring review comments into tested controls (🇬🇧 EN) examine ensuite le choix du contrôle, ses cas positifs et négatifs réservés, son responsable et sa suppression. Le texte sépare l’amélioration du harnais de l’auteur de celle du reviewer.
Mon outil ctxharness aborde une partie de cette maintenance : repérer les faits devenus faux entre le code et les instructions, comme une version ou un chemin de fichier obsolète. Ces contrôles statiques complètent les cas de comportement. L’article sur la configuration portable des agents, en anglais, explique pourquoi une instruction présente, installée, chargée ou invoquée n’est pas encore une instruction dont l’efficacité a été démontrée.
7. Mesurer ce que l’équipe gagne et choisir l’amélioration suivante
Je rapporte une accélération chez Aristote sans mesure isolant l’effet du harnais. Pour choisir la suite, je regarde le temps humain, l’attente, les reprises, la qualité après livraison et le coût des tentatives ratées.
Lire le détail, les exemples et les slides
Chez Aristote, je constate une nette accélération de la livraison. Dans le talk, je décris notre rythme : une feature en quelques heures, une épique en quelques jours. C’est mon retour de praticien sur notre équipe. Le talk ne fournit pas une comparaison contrôlée permettant d’attribuer un gain chiffré au trio de reviewers ou à l’ensemble du harnais.
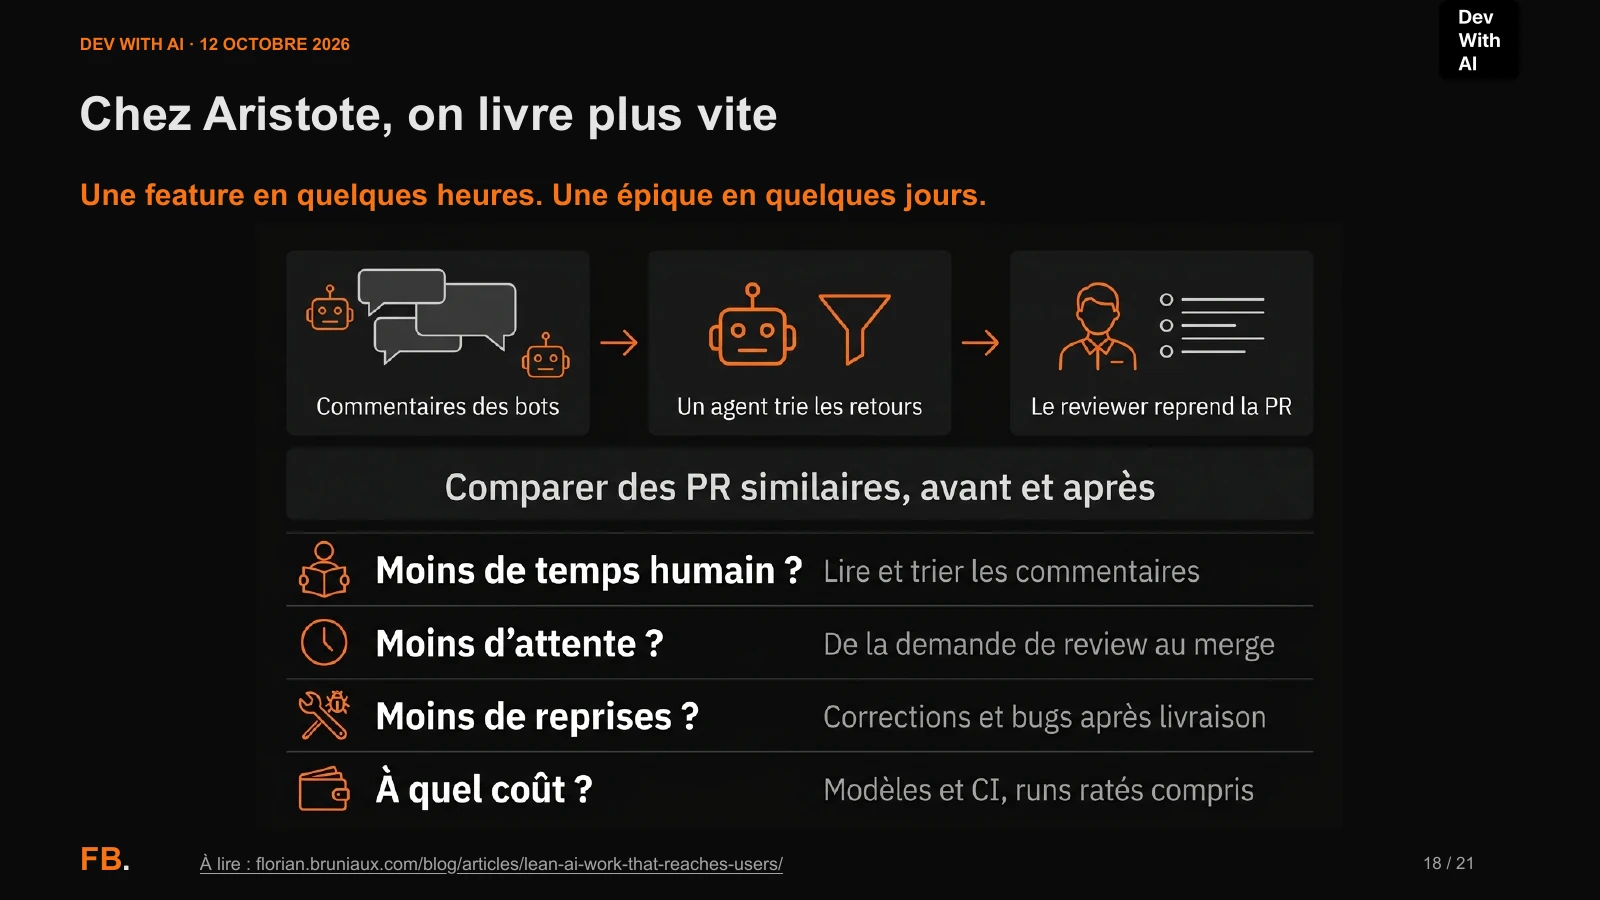
La question est maintenant où gagner encore du temps, avec quelle qualité et à quel coût. Prenons la consolidation des commentaires des bots avant la reprise de la PR par l’humain :
| Ce qu’on observe | Ce qu’on cherche à comprendre |
|---|---|
| Temps humain de lecture, tri et arbitrage | L’agent réduit-il le travail ou le déplace-t-il ? |
| Délai entre demande de review et merge | Combien vient du travail, combien de l’attente ? |
| Corrections et bugs après livraison | Réduit-on les reprises sans laisser passer davantage de défauts ? |
| Coûts des modèles et de la CI | Quel est le coût total, tentatives ratées comprises ? |
Pour observer les sessions Claude Code, je développe ccboard, un tableau de bord local. Les compteurs demandent toutefois une lecture critique : mon article sur les trois façons de mesurer son usage IA examine leurs périmètres, les doublons possibles et la différence entre coût équivalent API et facture. Un tableau de bord de sessions ne mesure pas à lui seul la qualité du travail livré.
L’article sur le coût par tâche acceptée complète ce point : les tentatives ratées et les corrections humaines comptent aussi. Ces deux articles sont en anglais.
Deux volets de la série review précisent ce qu’on peut mesurer : 5 AI code reviewers, 1 repository, and what developers did next analyse un export historique clos au 28 septembre ; Testing Opus 5.5 as the code-review baseline propose la comparaison suivante. Les articles sont en anglais. Le premier décrit des actions visibles sans classement de qualité ; le second ne publie pas de nouvel essai.
Attendre un runner et lire des commentaires sont deux choses à suivre séparément. Pour comparer avant et après, il faut des PR similaires : une grosse évolution fonctionnelle et une minuscule correction mécanique ne donnent pas une comparaison utile. Des résultats différents peuvent aussi venir d’un changement de périmètre ou des personnes disponibles.
Quand le harnais ajoute du coût sans améliorer le résultat
Complément du 14 octobre 2026, après le talk.
Dans Are Harnesses Worth the Cost?, Naresh Jain (13 octobre 2026) compare Sol et Luna avec un effort de raisonnement faible, sur un service Java neuf, 10 essais par condition et 178 tests externes identiques. Les deux conditions reçoivent le brief et les instructions de base du dépôt : « sans harnais » ne signifie pas sans contexte.
| Modèle | Sans harnais | Avec harnais |
|---|---|---|
| GPT-6 Sol | 10/10 acceptés ; ~0,406 $/essai | 10/10 ; ~2,679 $/essai |
| GPT-6 Luna | 3/10 ; ~0,086 $/essai | 10/10 ; ~0,273 $/essai |
Ces estimations équivalentes API excluent création, maintenance et réparation. Petit échantillon, brief très détaillé, résultats non généralisables à nos PR. Le contrôle final seul reste à tester.
Mon article How to read a token-compression benchmark (🇬🇧 EN) fournit une grille de lecture applicable ici : mêmes tâches, versions et critères d’acceptation, tentatives ratées comprises. Il explique aussi pourquoi comparer deux configurations complètes ne permet pas d’attribuer leur différence à un seul composant. Ses exemples portent sur la réduction de tokens ; ils ne constituent pas une reproduction de l’étude de Jain.
Pour le workflow de ce guide, je retiens une question à vérifier sur nos changements : quels contrôles évitent assez de défauts ou de reprises pour justifier leur coût ? Une review supplémentaire ou un test relancé après chaque modification mérite une mesure de ce qu’il apporte. La fréquence des vérifications et les contrôles requis pour accepter la PR restent deux décisions à distinguer.
Le harnais étudié fournit du feedback pendant la construction d’un service ; le dispositif du talk organise aussi les reviews, les responsabilités et le merge dans une équipe. Les résultats de Jain ne mesurent donc ni notre trio de reviewers ni notre rythme de livraison. Pour tester notre organisation, il faudrait comparer des PR similaires avec les mêmes critères d’acceptation, comptabiliser les reprises et le temps humain, et attribuer chaque résultat au commit effectivement contrôlé. Je n’ai pas exécuté cette comparaison dans le cadre du talk.
Le pilote Luna/Astra préparé sans modèles
État de notre préparation au 14 octobre 2026. Un pilote distinct prévoit 12 essais sur 3 tâches figées : gpt-6-luna et gpt-6-astra, chacun à medium et xhigh. Ces identifiants proviennent du catalogue du client Codex installé. Les 31 tests locaux et 6 contrôles d’isolation passent. Quatre sessions du client utilisent des réponses fixes d’un serveur local ; 12 évaluations confinées utilisent des soumissions de contrôle écrites par l’opérateur. L’interruption coupe le flux local et empêche sa poursuite.
Aucun modèle du benchmark n’a été lancé ; le budget reste à décider. L’accès réel, l’effort appliqué par le fournisseur, la consommation, les compteurs finaux après interruption, un plafond dur pendant la réponse et une limite mémoire restent à vérifier. Cette préparation ne reproduit pas l’étude Sol/Luna de Jain et ne mesure pas les gains de notre workflow de review. Un essai par tâche et configuration servira à qualifier le pilote, pas à établir un classement.
Essayer un changement sur la prochaine PR
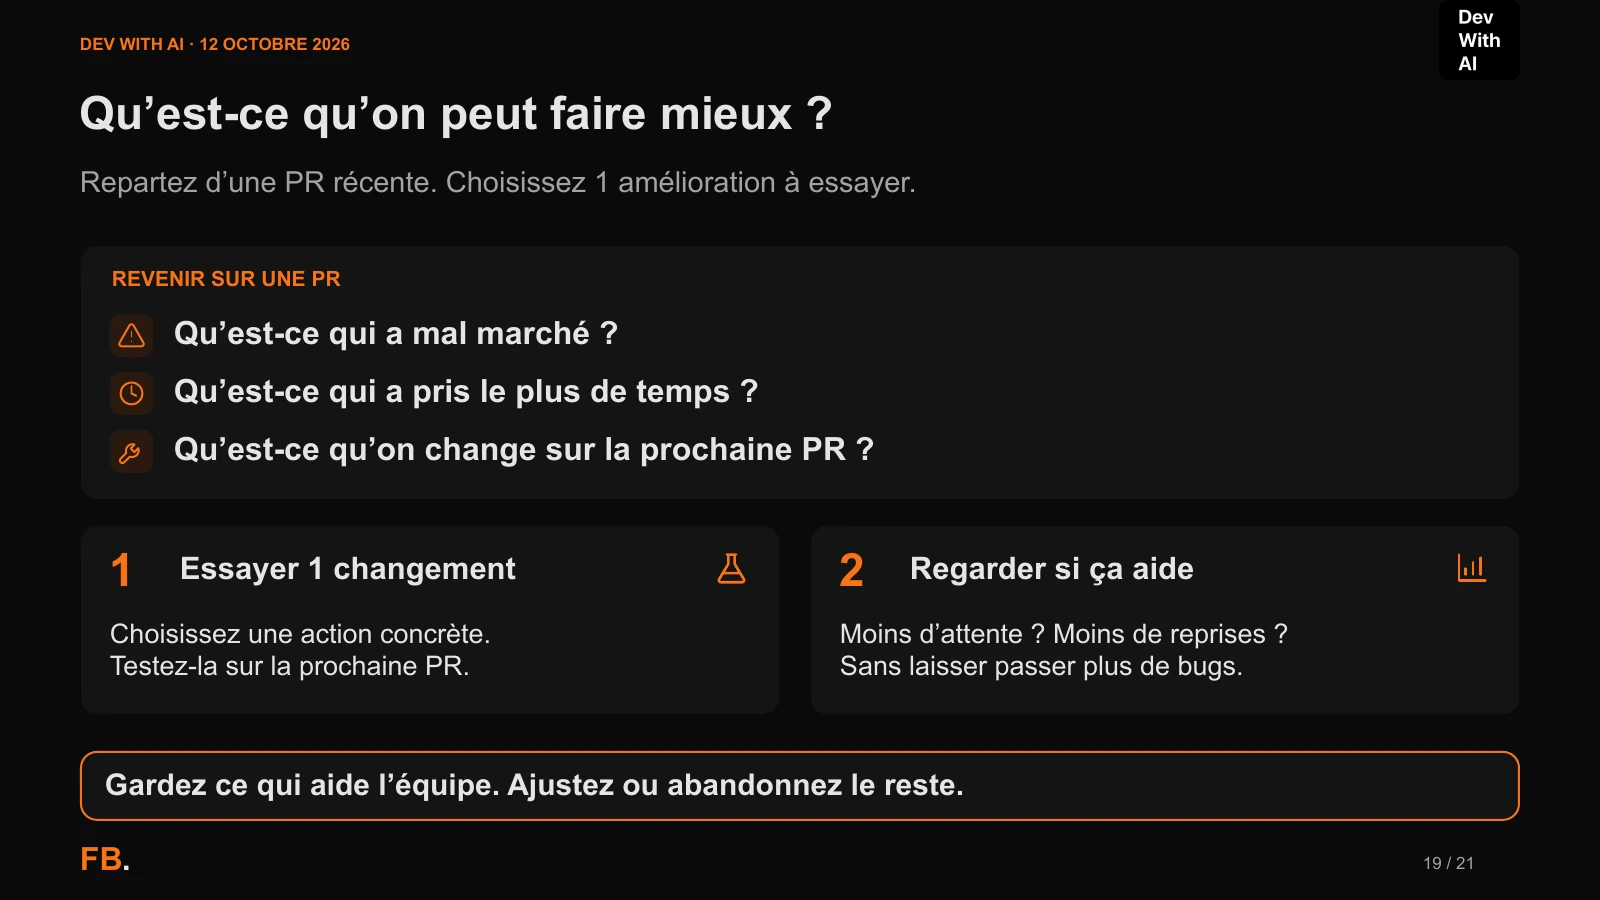
Je propose de repartir d’une PR récente avec trois questions : qu’est-ce qui a mal marché, qu’est-ce qui a pris le plus de temps et qu’est-ce qu’on change sur la prochaine PR ?
Choisissez une action et la personne qui peut agir. Si l’équipe demande toujours « qu’est-ce que tu as testé ? », faites renseigner les contrôles lancés, leurs résultats et les limites par l’agent qui prépare la PR. Sur les prochaines PR du même type, regardez si cela réduit les questions, l’attente et les reprises sans augmenter les bugs.
Gardez ce qui aide, ajustez ou abandonnez le reste. Si la description devient un pavé, raccourcissez-la. Si une review supplémentaire n’apporte rien d’utilisable, examinez sa couverture et le travail qu’elle ajoute. Faire disparaître un contrôle requis pour améliorer le délai ne démontre pas une meilleure livraison.
Relier le merge à la livraison et à l’usage
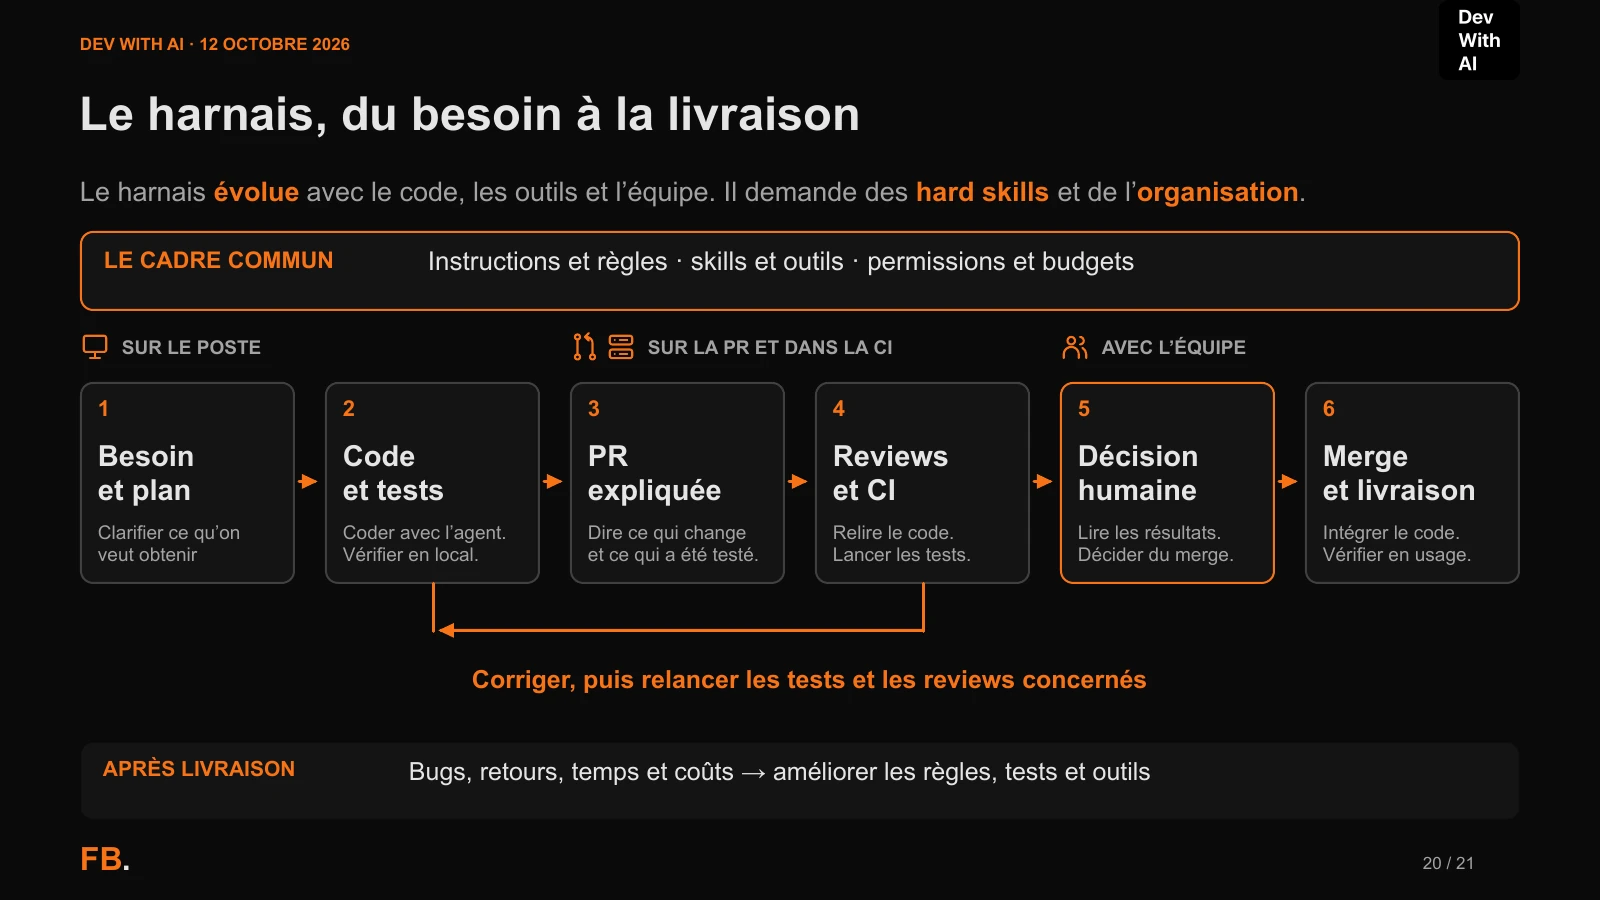
Le parcours commence par un besoin clarifié et un plan, puis le code et les tests locaux. La PR rend le changement compréhensible ; reviews et CI apportent leurs résultats ; l’équipe décide du merge. Il reste ensuite à livrer et à vérifier en usage. Merger ne signifie pas que le code est déjà déployé et vérifié en production.
Les bugs, les retours, le temps et les coûts alimentent l’itération suivante. C’est ce lien avec le travail de toute l’équipe que je développe dans Lean et IA : du travail qui atteint les utilisateurs. Le harnais demande des compétences techniques pour configurer, tester et automatiser, et de l’organisation pour répartir le travail, relire et décider.
Questions après le talk
Je distingue la coordination des retours des tâches de correction. Une boucle auto-apprenante complète n’a pas encore été testée ; les pistes décrites restent à évaluer.
Lire le détail, les exemples et les slides
Complément du 14 octobre 2026, à partir des questions reçues après le talk.
Un seul agent ou des responsabilités séparées pour traiter les feedbacks ?
Le dispositif présenté distingue le rôle de coordination des tâches de correction. Un agent coordinateur rassemble les retours, vérifie les remarques dans le code actuel et garde la vue d’ensemble. Les correctifs retenus peuvent être confiés à plusieurs agents ou modèles selon les besoins. Cela n’impose pas un nouvel agent pour chaque commentaire ou chaque étape.
Le découpage dépend des liens entre les corrections. Des problèmes indépendants peuvent être répartis ; des changements qui touchent les mêmes fichiers ou la même règle métier demandent une coordination plus serrée. Une tâche déléguée doit préciser le problème confirmé, son périmètre et le résultat à vérifier. Le coordinateur relit ensuite l’ensemble du diff et les résultats pour contrôler la cohérence des modifications.
Le nom /tech:pr-feedbacks est celui employé dans le support. Dans mes instructions Aristote actuelles, /tech:pr-feedback assure la collecte et le rapport en lecture seule, tandis que /tech:pr-reconcile encadre les corrections autorisées dans un cycle borné. La séparation de ces fonctions n’impose pas un agent différent à chaque étape. La partie sur la consolidation des reviews explique les contrôles communs à ces rôles.
As-tu testé une boucle auto-apprenante pour les problèmes qui reviennent ?
Je n’ai pas encore testé de boucle auto-apprenante complète. Le mécanisme présenté au talk consiste à conserver le cas dans une issue, corriger sa cause, rejouer les tests concernés et regarder ce qui se passe sur les PR suivantes. Il améliore le code, les tests ou les instructions du harnais ; il ne décrit pas un réentraînement du modèle.
Une automatisation pourrait proposer un test de régression ou une évolution de consigne à partir d’un problème observé. Il faudrait alors comparer l’ancienne et la nouvelle version sur ce cas et sur d’autres comportements, puis vérifier si la modification réduit les erreurs sans créer de fausses alertes. La modification devrait rester versionnée, révisable et réversible. Cette piste ne constitue pas une boucle complète déjà expérimentée.
Le chapitre sur les problèmes récurrents détaille cette démarche. Mon article sur le système d’instructions IA de l’équipe, en anglais, développe la maintenance des instructions partagées et les contrôles de dérive.
YSNK
- La capacité de vérification compte. Plus de PR produites peut signifier plus d’attente.
- Les reviews sont à vérifier. Confirmez le diagnostic et le correctif dans le code actuel.
- La correction a une limite. Fixez objectif, tentatives et budget, puis passez la main avec les faits utiles.
- Les résultats concernent un commit. Après un push, relisez le diff et reprenez les contrôles nécessaires.
- Le gain se juge sur le travail complet. Suivez le temps humain, l’attente, les reprises, la qualité et les coûts.
Sources et ressources
Lectures ajoutées le 14 octobre 2026 après recherche documentaire :
-
SWR-Bench, version du 5 juin 2026 : comparaison de reviews sur des PR annotées, avec contexte de dépôt et évaluation assistée par modèle. Ce benchmark ne mesure pas les gains de notre équipe.
-
Étude qualitative chez WirelessCar, mai 2025 : préférences et difficultés de dix participants face à deux modes de review assistée. Elle complète les mesures de commentaires, sans établir un gain de livraison.
-
Are Harnesses Worth the Cost?, Naresh Jain, 13 octobre 2026 : comparaison externe discutée dans le complément après le talk.
-
Programme de Dev With AI, 12 octobre 2026 : événement et titre du talk.
-
Slides du talk, 21 pages sans notes présentateur (PDF) : exemples et schémas d’origine. Les 18 slides de contenu intégrées à ce guide proviennent de ce PDF ; la présentation personnelle est omise dans le guide.
-
Lean and AI: work that reaches users : raisonnement sur le travail jusqu’à l’usage, en anglais.
Séries pour approfondir
- Engineering the Review Loop, 8 volets (🇬🇧 EN) : files d’attente, review indépendante, corrections bornées, décision de merge et évaluation des reviewers.
- Context Engineering, 6 articles (🇬🇧 EN) : diagnostic du contexte, outils, responsabilités, système partagé et portabilité.
- The Real Cost of AI, 9 articles (🇬🇧 EN) : productivité, coût par tâche acceptée et mesure de l’usage, avec des chiffres datés et leurs limites.
Outils et guides présentés dans le talk
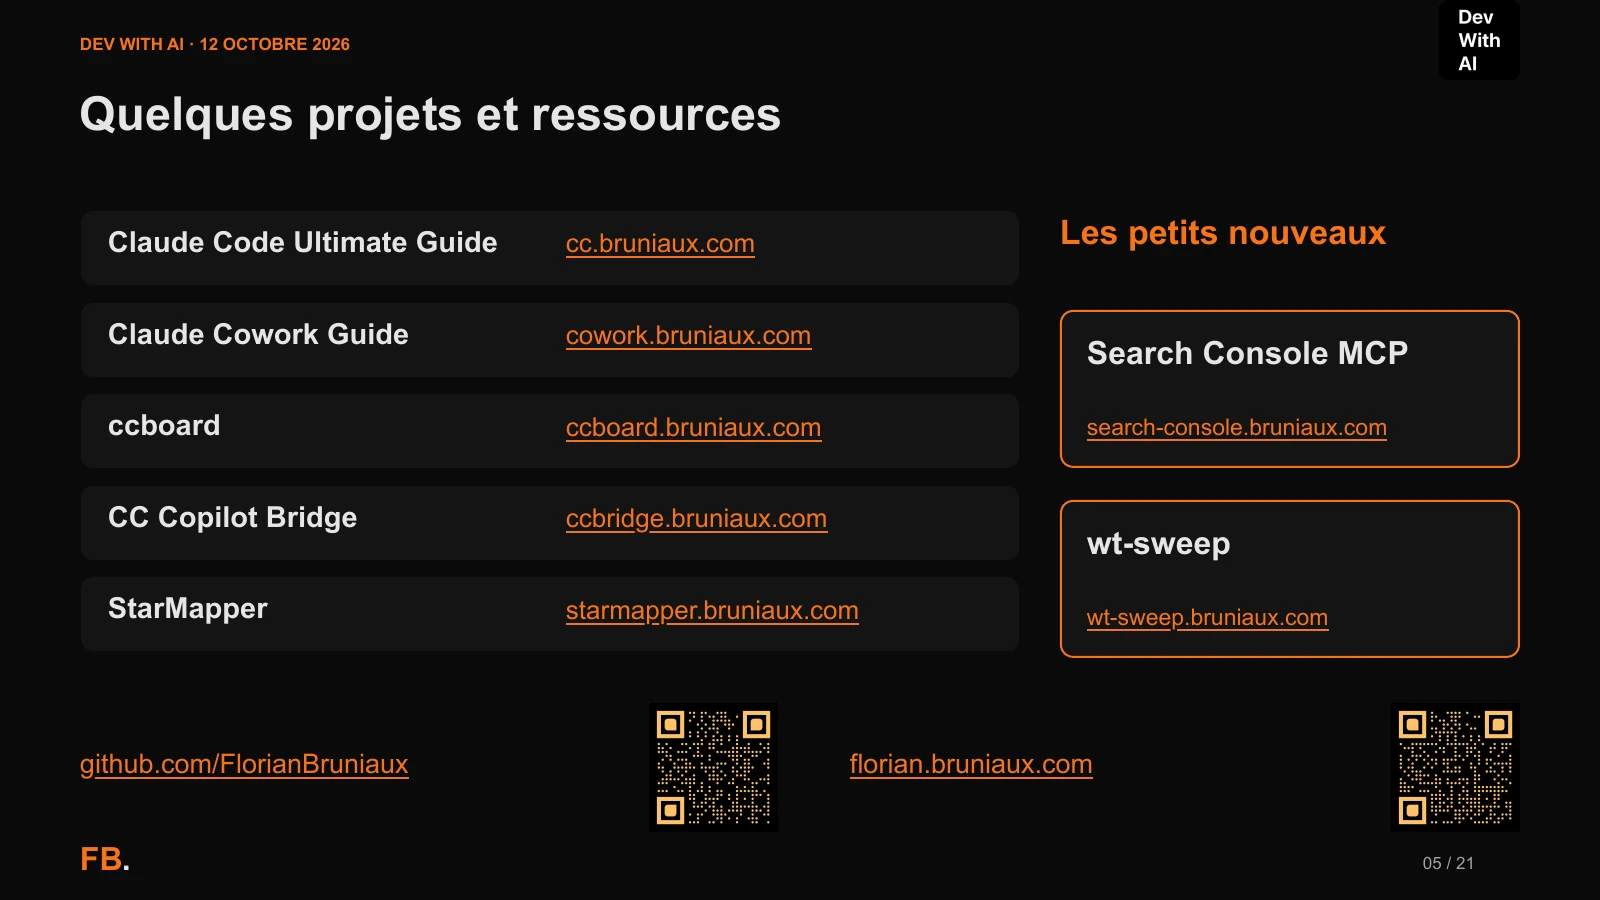
- Claude Code Ultimate Guide
- Claude Cowork Guide
- ccboard
- CC Copilot Bridge
- StarMapper
- Search Console MCP
- Worktree Sweep (wt-sweep)
Les explications sont rédigées à partir du talk et de mes notes présentateur. Les notes brutes et le HTML de travail ne sont pas distribués. Les exemples simplifiés restent identifiés ; les pratiques et la cible du dispositif restent distinctes des résultats mesurés.
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Open-source galaxy
Projects used in this path
ctxharness
Detect drift between code, instructions, and assembled agent context.
- Context Engineering
- Harness
- Validation
claude-code-plugins
Install focused Claude Code plugins built from reusable guide templates.
- Agent Extensions
- Workflow Automation
- Harness
CCBoard
Monitor Claude Code sessions through a local TUI and web dashboard.
- Observability
- Session Analytics
- Monitoring
Pourquoi ça compte
Les recherches et le raisonnement derrière ce guide.
5/6 · The AI instruction system is a product, not a config file
Personal CLAUDE.md to team AI instruction system for six engineers. How Méthode Aristote separates sources, shares modules, and catches behavioral drift in CI.
Testing Opus 5.5 as the code-review baseline
Opus 5.5 is the next reviewer baseline to test: set effort explicitly, update the API adapter, and keep a second reviewer only when it catches verified defects.
A green review is not a merge gate
A review signal matters only when its provider, commit SHA, coverage, execution state, publication, and place in branch policy are explicit.
Related guides
Dev With AI 2026 : ce qui change dans le travail des développeurs
Review, contexte métier, coûts et création de produits : ma synthèse de Dev With AI du 12 octobre 2026, avec le compte rendu illustré complet.
Designing a bounded review loop
Build a bounded review loop with frozen inputs, separate execution and outcome fields, retry limits, evidence handoffs and human escalation.