2/6 · Diagnostiquer et réparer la dérive du contexte
Utiliser L0 à L5 pour diagnostiquer la dérive du contexte, puis maintenir l'adhérence par observation, réparation et répétition plutôt que de considérer la configuration comme terminée.
Aller au résumé ↓ Florian Bruniaux
Context Engineering · Partie 2/6
TL;DR
Je pense que le plus difficile avec un CLAUDE.md est de le garder vrai, pas de l’écrire, et qu’un score structurel ne prouve rien sur le comportement : l’audit Walkinglabs a renvoyé 100/100 pour un repository synthétique dont la vérification échouait. Mon impression est que beaucoup d’équipes sont à L0 ou L1 et quelques-unes à L2. L’action utile est donc de rejouer un échec, pas de viser une étiquette supérieure. Je m’attends à ce que la discipline du contexte soit absorbée par le harness engineering.
| Le piège | Un CLAUDE.md qui fonctionne au premier jour se dégrade silencieusement. L’adhérence passe de quasi totale à médiocre au fil des mois |
| La mesure | L’adhérence est réelle et observable. Elle baisse avec la taille du fichier et le nombre de règles |
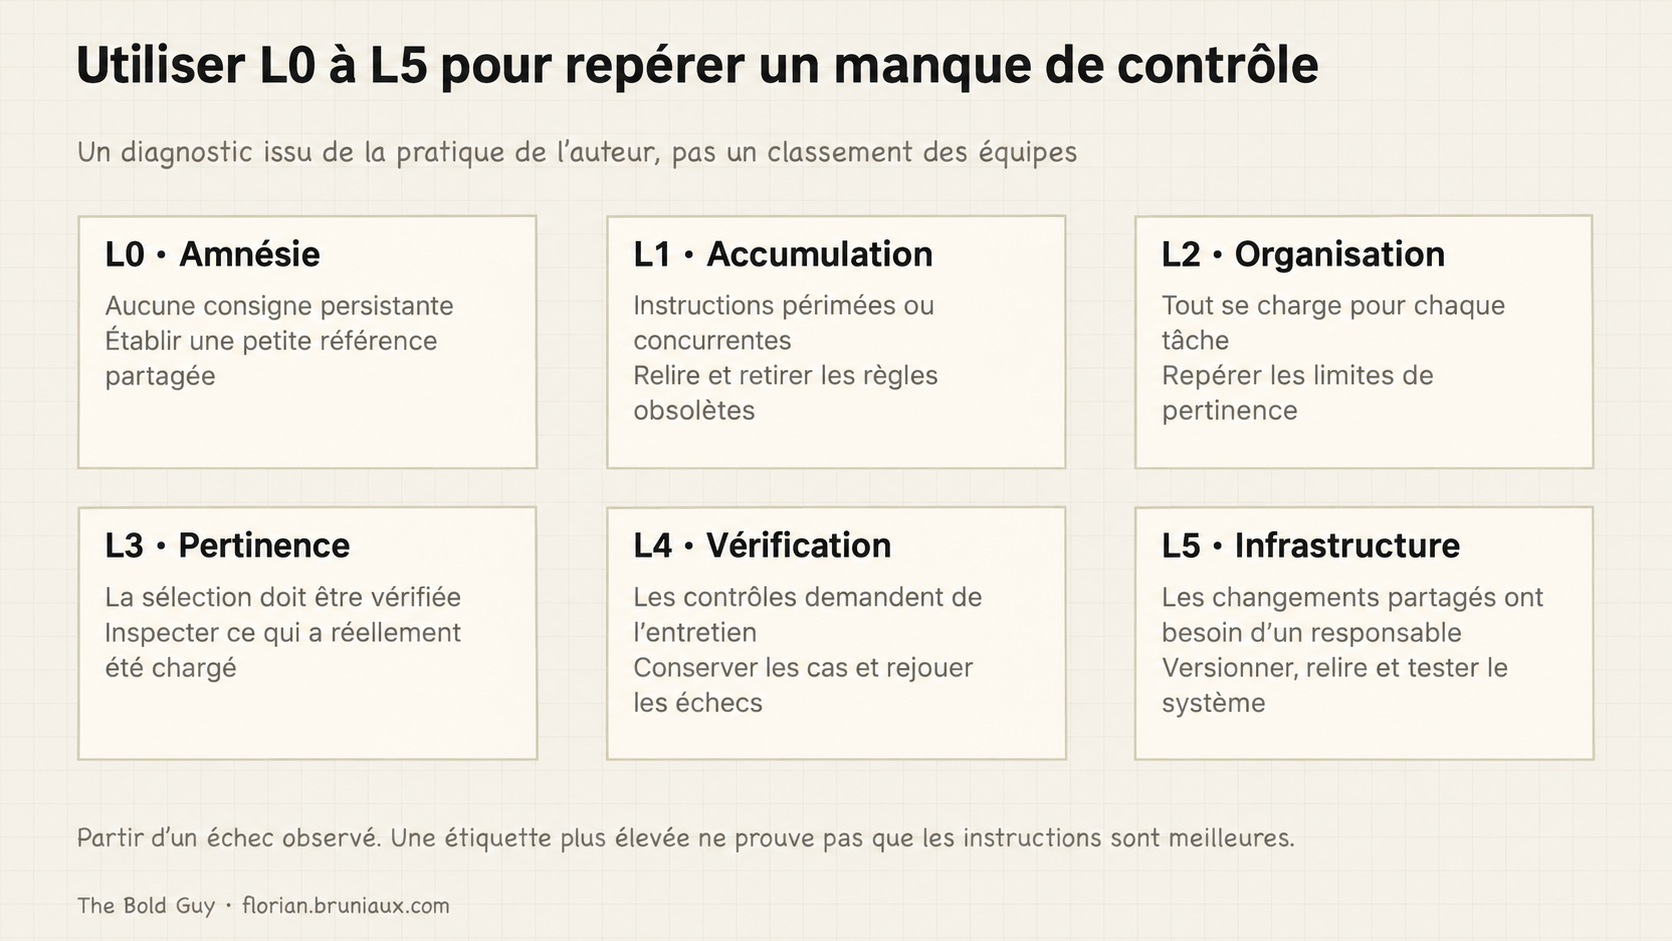
| Le diagnostic | Six états d’échec, de l’amnésie L0 à l’infrastructure L5. Ils localisent un contrôle manquant plutôt que d’attribuer un score |
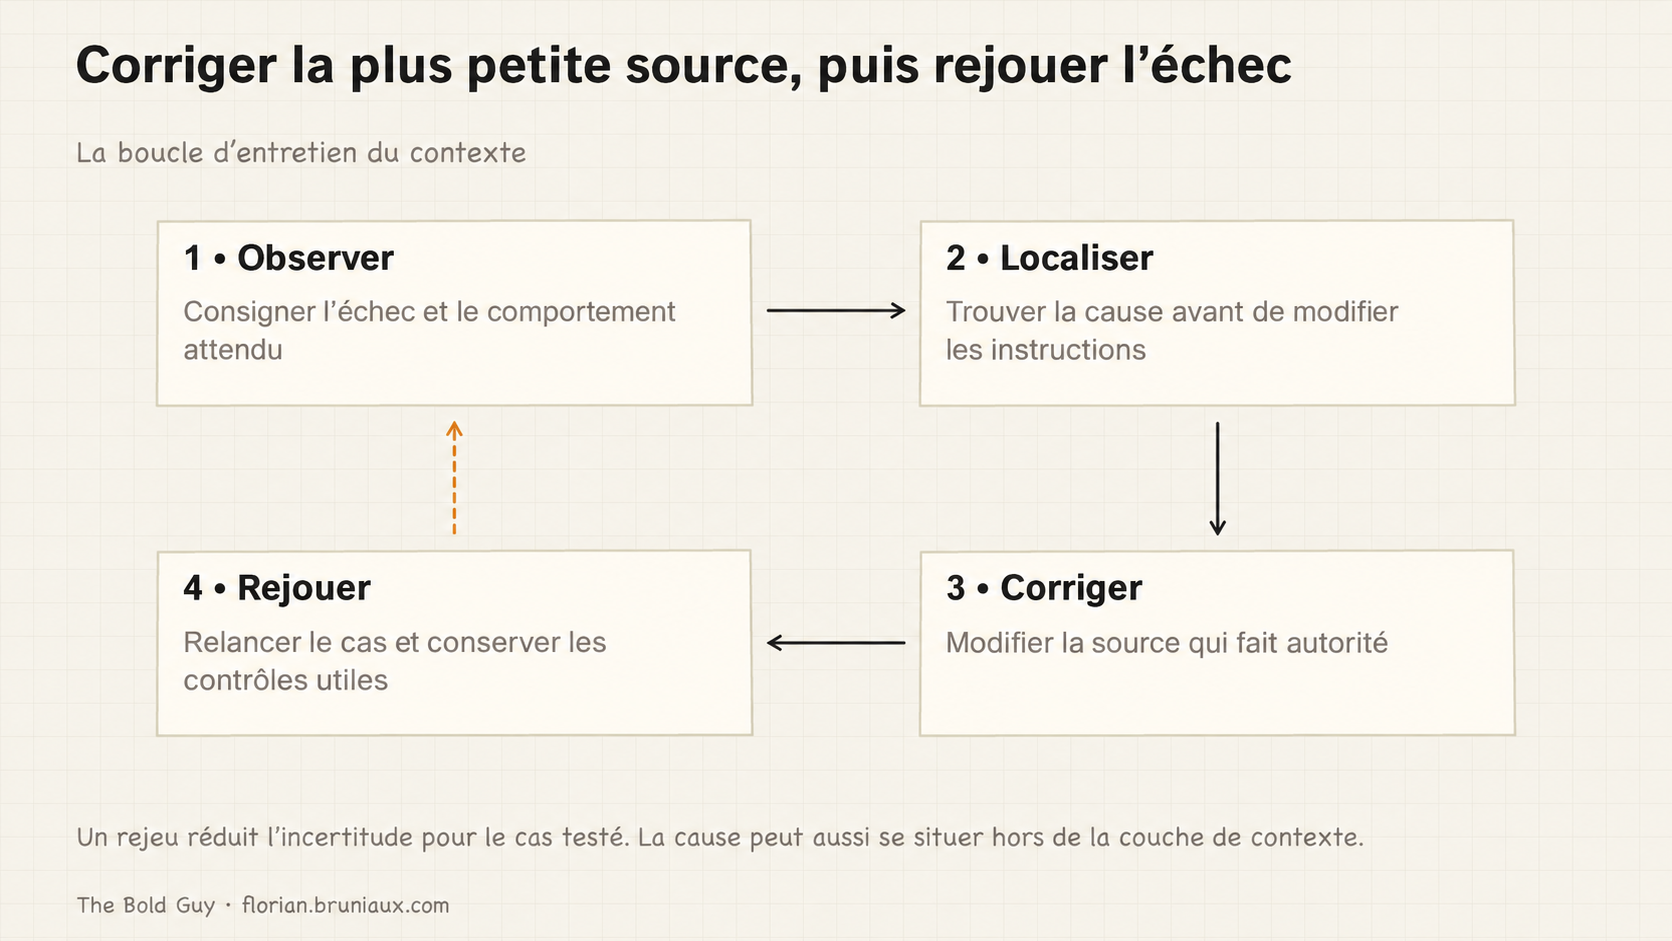
| La boucle | Observer un échec, localiser sa cause contextuelle, réparer la source, puis rejouer le scénario |
| La preuve | Un signal de chargement et des contrôles comportementaux répétés montrent si la réparation a tenu |
Trois symptômes reviennent dans les équipes qui utilisent un agent de développement IA depuis plus de quelques semaines.
Après une longue session, Claude commence à halluciner des imports et les gens accusent le modèle d’avoir un mauvais jour. Les sorties d’outils accumulées, la compaction, les faits périmés ou une faible adhérence sont des causes possibles. Le temps écoulé seul ne montre pas quelles instructions ont été chargées ou sont restées effectives.
Trois sprints après une migration d’API, Claude génère encore du code pour l’ancienne API. CLAUDE.md ment sur l’état actuel du projet parce que personne ne l’a mis à jour, et le modèle suit fidèlement ce mensonge.
Le respect des règles peut passer de quasi total à moyen en quelques mois, sans signal, alerte ou rupture bruyante. Il se dégrade un peu chaque semaine jusqu’à ce que quelqu’un remarque que la sortie est médiocre depuis un moment.
Un bon CLAUDE.md au premier jour est facile. L’empêcher de mentir sur le projet trois mois plus tard exige un travail continu. La première partie de cette série (pourquoi le contexte se dégrade, côté recherche) expliquait la pression. Cet article est la couche de diagnostic : il identifie la dérive, localise le contrôle manquant et définit la boucle de maintenance. Le guide L0 à L5 reste le manuel d’implémentation pour modifier les fichiers, ajouter des contrôles et passer entre niveaux.
L’adhérence se mesure
La qualité de CLAUDE.md est observable, et les résultats ne ménagent pas l’approche « dump every rule you can think of » (traduction : « empiler toutes les règles qui vous viennent à l’esprit »).
HumanLayer, qui fait tourner des agents en production, a tiré une règle nette de l’observation de la dégradation de l’adhérence : garder des fichiers d’instructions courts, quelques centaines de lignes au maximum et idéalement bien moins. C’est un phénomène que tout le monde ressent. Les instructions d’un fichier court sont suivies fidèlement. Plus il grandit, plus le modèle abandonne silencieusement des règles, et vous ne choisissez pas lesquelles. Le mécanisme est la même dégradation du contexte que dans la première partie : un modèle qui répartit son attention entre des centaines de contraintes vaguement pertinentes consacre davantage de capacité à filtrer qu’à raisonner. Cet article n’établit pas de seuil universel de nombre de règles ; mesurez l’adhérence sur les tâches et les modèles que vous utilisez réellement.
La position mérite aussi un test. Lost in the middle invite à vérifier où apparaît le contexte important ; testez-le sur vos propres fichiers.
L’origine du fichier compte plus qu’on ne le pense. Gloaguen et ses collègues de l’ETH Zürich (2026, sur 138 benchmarks et 12 repos) ont comparé des fichiers de configuration d’agents écrits à la main à ceux générés par un LLM. Les fichiers manuels amélioraient la réussite des tâches d’environ 4 %. Ceux générés par LLM la réduisaient d’environ 2 % tout en ajoutant environ 20 % au coût d’inférence. Ces résultats concernent les configurations et tâches testées dans cette étude ; ils n’établissent pas que tout fichier d’instructions généré est pire que l’absence de fichier.
L0 à L5 est un diagnostic, pas une destination
Après dix mois à construire un SaaS de production avec Claude Code dans une équipe de quatre à l’époque (six développeurs en octobre 2026), les mêmes états d’échec revenaient. Sur cette période, 445 commits hors merges sur 2 811 au total touchaient des fichiers de configuration IA, soit environ 16 % de l’activité. Quand un commit sur six touche cette configuration, la couche de contexte est une infrastructure maintenue. L0 à L5 nomme le contrôle présent dans chaque état. La référence de context engineering du guide donne le détail opérationnel de chaque transition.
- L0, amnésie.
- Pas de CLAUDE.md. Claude repart de zéro à chaque session, réapprend le projet chaque matin et l’oublie chaque soir.
- C’est un scénario de diagnostic. L’expérience de METR de début 2025 n’établissait pas que ses agents partaient d’un contexte projet vide à chaque fois ; la première partie garde cette distinction explicite.
- L1, accumulation.
- Un CLAUDE.md existe et grandit. C’est le wiki d’équipe où chacun ajoute une règle et personne n’en retire.
- Utile et bien intentionné, mais vulnérable aux règles obsolètes ou contradictoires.
- L2, organisation.
- Des sections apparaissent. Les règles globales sont séparées de celles du projet. Le fichier est lisible.
- Mais cela reste une configuration indifférenciée, chargée en entier pour chaque tâche, que vous touchiez à la base de données ou au CSS.
- L3, pertinence.
- La portée par chemin arrive. Les règles s’activent seulement lorsque les fichiers de leur domaine sont concernés. Les règles backend n’existent pas dans la fenêtre lorsque vous travaillez sur le frontend.
- L4, vérification.
- Vous cessez de supposer que la configuration s’est chargée et commencez à le prouver.
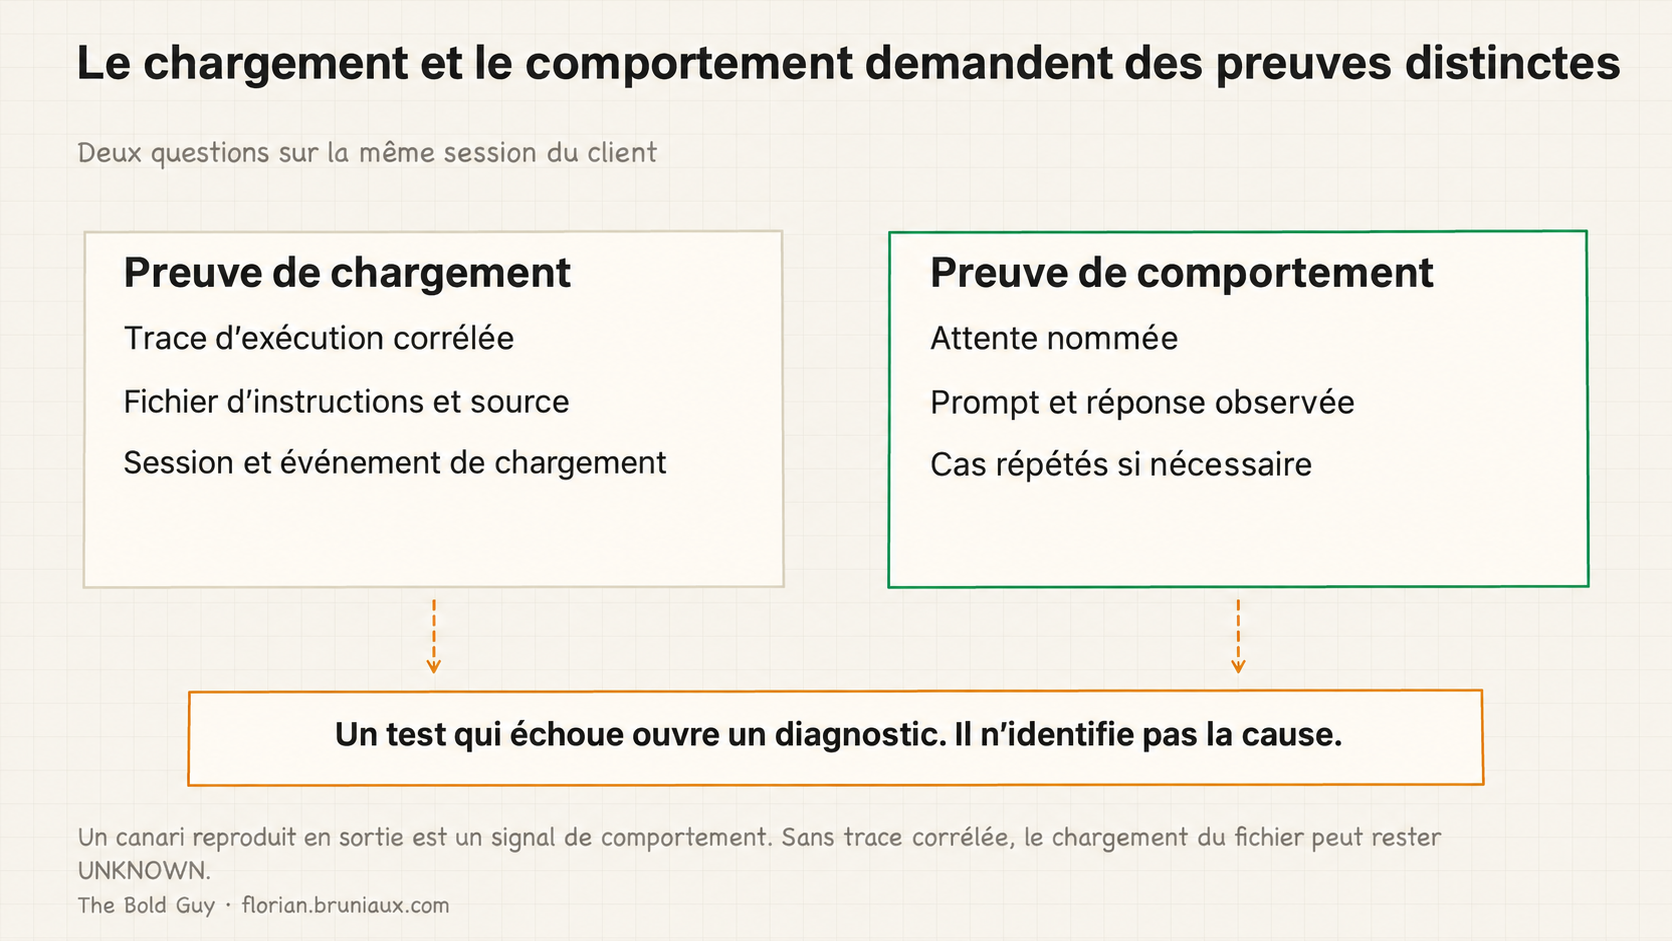
- Une trace de chargement et des sondes comportementales apportent des preuves différentes sur les instructions actives.
- L5, infrastructure.
- Les profils YAML génèrent les configurations. Une commande de synchronisation les aligne entre outils.
- La CI échoue si elles dérivent. La configuration du contexte est maintenant versionnée, revue et imposée comme toute autre partie de la codebase.
Appliquez l’échelle à un échec concret. Une référence API périmée pointe vers une dette de maintenance à L1 ou L2. Des règles backend inutiles chargées pendant le travail frontend indiquent des contrôles de pertinence manquants à L2. Une règle qui ne s’est peut-être pas chargée indique une vérification manquante à L3. Mon impression est que beaucoup d’équipes fonctionnent à L0 ou L1 et quelques-unes à L2, mais c’est une observation, pas une distribution mesurée de population. L’intérêt pour des fichiers d’instructions concis comme claude-token-efficient n’établit pas où se situent les équipes.
Quatre signaux localisent la dérive
Un fichier racine trop gros signale des contrôles de pertinence manquants. Chez Méthode Aristote, la portée par chemin a réduit le contexte toujours actif d’environ 8 000 à 4 000 tokens, soit 40 à 50 % de réduction sans perte de couverture dans cette installation. L’arborescence opérationnelle et les étapes de migration figurent dans le guide L0 à L5.
Une procédure dans CLAUDE.md signale une erreur de catégorie. Les contraintes toujours actives vont dans les règles, les procédures occasionnelles dans les skills ou un autre mécanisme à la demande. Une séquence d’onboarding de 50 lignes chargée pendant chaque tâche CSS ajoute du contexte sans aider la tâche.
Des implémentations contradictoires entre sessions peuvent signaler que les décisions architecturales sont stockées au mauvais endroit. CLAUDE.md porte les contraintes récurrentes. Les systèmes de stockage des décisions conservent les choix et leurs raisons. Les outils de récupération comme Serena, grepai et Context7 fournissent code ou documentation lorsque la tâche en a besoin. La référence des systèmes de mémoire décrit cette séparation.
Une règle correcte mais ignorée peut signaler un échec de chargement ou d’adhérence. Ce cas exige une observation avant une nouvelle réécriture : confirmez quelles instructions ont été chargées, reproduisez le comportement et comparez le résultat à une attente nommée.
La preuve de chargement n’est pas une preuve de comportement
À L4, cela cesse d’être de la configuration et devient de l’ingénierie, parce que la preuve entre en jeu.
Un contrôle canari demande une réponse exacte lorsqu’une instruction précise s’applique. Un écho est un comportement observé dans cette session. S’il est absent, examinez le chargement, les instructions concurrentes et la réponse elle-même ; le silence n’établit pas que le fichier ne s’est jamais chargé.
Je vois L3 comme le geste d’attacher sa ceinture et L4 comme le voyant du tableau de bord confirmant qu’elle est bouclée. L4 donne un signal.
Quand les règles limitées par chemin, les configurations de sous-répertoires ou les @imports en chaîne rendent le chargement difficile à inspecter, un hook InstructionsLoaded configuré peut consigner les événements de chargement d’instructions. Corrélez fichier, source et session, y compris les chargements après le démarrage. La trace étaye une affirmation de chargement ; le canari sonde le comportement.
L5 rend la boucle de maintenance partagée. Un échec observé devient un cas reproductible. Cherchez si sa cause réside dans le contexte, puis réparez la source faisant autorité lorsque c’est pertinent et rejouez le cas. Les profils permettent de passer à l’échelle. Un fichier YAML par rôle ou développeur (le guide détaille le contenu de ces profils de rôles), et une commande de synchronisation (pnpm ai:sync) régénèrent CLAUDE.md, les règles Cursor et les instructions Copilot depuis cette source unique. La convention réside à un seul endroit. Les trois configurations se régénèrent en quelques secondes. La CI fait échouer le build si elles divergent.
Le bénéfice est concret. Lorsque cette boucle a mené un nettoyage délibéré du contexte en production, un processus que nous avons appelé Context Diet, la configuration toujours active est passée de 2 518 à 646 lignes, soit 74 % de réduction, et notre score interne de qualité du contexte (grille sur 120) est passé de 90 à 100. La configuration plus courte obtenait un meilleur score sur cette grille locale ; cette observation avant/après n’établit pas la cause de chaque amélioration.
Le guide Plan-Execute esquisse une migration React de 243 fichiers avec 24 missions de workers, environ dix fichiers chacune, et 3 exceptions pour review humaine. C’est un exemple illustratif, pas une exécution que je peux documenter : je n’ai ni log, ni taux d’exception mesuré, ni durée calibrée derrière. Un planificateur Opus en lecture seule produit un brief.md avant le démarrage des workers Sonnet. Les worktrees Git distincts réduisent les collisions ordinaires de checkout, mais les permissions des processus peuvent encore permettre un accès entre worktrees. Le client et les limites de ressources déterminent combien de missions peuvent tourner ensemble ; l’exemple ne recommande pas d’en lancer 24 simultanément.
Là où la discipline du contexte cesse d’aider
Cette discipline a des modes d’échec, et prétendre le contraire mène à la suringénierie.
La suringénierie est un vrai mode d’échec. Un développeur solo sur un petit projet peut s’arrêter à L2 avec un peu de portée par chemin. Profils, synchronisation et contrôles en CI créent leur propre gaspillage lorsqu’ils arrivent trop tôt.
L’empoisonnement du contexte est le plus subtil. Une petite hallucination entre dans CLAUDE.md, une fausse convention ou une référence erronée, puis fait dériver silencieusement chaque session. C’est plus insidieux que la dégradation ordinaire du contexte parce que la sortie semble correcte. Les instructions générées exigent une review à partir des preuves sources. Sinon une hallucination peut devenir une instruction persistante.
Distinguez l’adhérence des limites de chargement. La référence sur la mémoire décrit le chargement de CLAUDE.md séparément de la limite de démarrage de l’index de mémoire automatique : 200 lignes ou 25 Ko, selon la première limite atteinte. Une instruction manquante exige d’examiner la source réelle et le chemin de chargement ; ni un long fichier ni un canari silencieux n’identifient seuls la cause.
Et l’ensemble a un plafond. Comme Birgitta Böckeler l’a formulé dans son article sur le context engineering pour les agents de développement sur martinfowler.com, il n’y a pas de tests unitaires pour le context engineering. On peut mesurer l’adhérence, lancer des contrôles canaris et noter sa configuration, mais on ne peut pas prouver sa justesse comme celle d’une fonction. Cette discipline réduit l’incertitude sans l’éliminer, et la traiter comme exacte est un piège en soi.
Pour la couche factuelle de cet écart, la détection automatisée de dérive fait une partie du chemin. ctxharness scanne CLAUDE.md pour trouver des affirmations vérifiables (chemins, scripts npm, numéros de version) et confronte chacune à la codebase réelle. Il ne détectera pas une convention hallucinée, mais repérera le chemin déplacé et le script renommé, deux classes de dérive qui s’accumulent silencieusement dans tout projet durable.
Maintenir l’adhérence en boucle
Le diagnostic devient utile lorsque chaque échec observé alimente la même boucle de maintenance.
- Observer : consigner le comportement en échec, les fichiers affectés, la tâche active et l’instruction que vous vous attendiez à voir l’agent suivre.
- Localiser : distinguer un fait périmé, un contexte inutile, une instruction manquante, un échec de chargement ou un comportement que la couche de contexte ne peut pas garantir.
- Réparer : changer la plus petite source faisant autorité. Ne pas ajouter de règle globale pour une exception locale.
- Rejouer : relancer le même scénario, puis garder le cas comme contrôle de régression lorsque l’échec compte.
Un log InstructionsLoaded corrélé peut établir un événement de chargement de fichier. Il ne peut pas établir que chaque instruction du fichier sera suivie. Les contrôles comportementaux couvrent la seconde affirmation, et les cas non déterministes exigent des exécutions répétées avec un seuil de taux de réussite. Zineb Bendhiba décrivait des tests continus de non-régression avec seuils de réussite explicites (IFTTD, épisode 326), tandis que Frédéric Barthelet décrivait le fait de rejouer les scénarios clés dix à cent fois plutôt que de traiter une exécution comme concluante (épisode 329).
Le guide de context engineering à six niveaux transforme chaque diagnostic en modifications de fichiers et contrôles concrets. Cet article définit quoi chercher et comment éviter qu’une réparation se dégrade à nouveau.
Le troisième article de cette série quitte la configuration pour s’attaquer au coût : la carte des mécanismes de réduction de tokens et les outils derrière chacun. Il couvre la même discipline côté coût, une fois le côté qualité traité ici.
Retours de terrain via les transcriptions d’épisodes IFTTD : Zineb Bendhiba, ép. 326 sur les tests de non-régression comportementale ; Frédéric Barthelet, ép. 329 sur la CI/CD statistique des systèmes non déterministes.
Si votre CLAUDE.md vous a déjà menti sur l’état de votre propre projet, j’aimerais savoir comment vous l’avez repéré, et combien de temps cela a pris.
Rejouer le scénario doit mettre à l’épreuve la mesure elle-même. L’audit structurel Walkinglabs a renvoyé 100/100 pour un repository synthétique dont la vérification échouait. Dans la boucle observer/réparer/rejouer, consignez le comportement en échec à côté du verdict structurel ; ne faites pas progresser une étiquette de maturité parce que les fichiers attendus sont présents.
YSNK
(Vous devriez maintenant savoir)
- Aucun seuil universel de nombre de règles n’est établi ici ; utilisez des cas nommés pour mesurer l’adhérence
- L’étude citée compare des fichiers d’instructions et des tâches précis ; le contenu généré exige toujours preuves, review et évaluation comportementale
- L0 à L5 localise un contrôle de contexte manquant ; ce n’est pas un score et tous les repositories n’ont pas besoin de L5
- L’empoisonnement du contexte est plus dangereux que la dégradation simple : une convention hallucinée inscrite dans CLAUDE.md fait dériver chaque session et la sortie semble toujours correcte
- Une réparation est incomplète tant que le scénario en échec n’a pas été rejoué et conservé comme contrôle de régression lorsque son impact le justifie
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source