Context engineering et code review avec Bruno Soulez
Avec Bruno Soulez, je parle de context engineering, de harnais et de code review : ce que je délègue aux agents et ce que je continue à vérifier.
 Florian Bruniaux 36 min de lecture
En bref
| Question de l’échange | Ma position |
|---|---|
| Que met-on dans le harnais ? | Le contexte, les outils et les contrôles doivent correspondre à la tâche, à la personne qui pilote et au workflow |
| Qui le construit ? | L’expertise technique reste nécessaire, tandis que les collègues côté produit apportent le sens métier |
| Peut-on arrêter de relire le code ? | Je relis moins systématiquement le code ligne par ligne sur un produit web, en restant attentif aux changements sensibles ; Bruno interroge les limites de cette pratique |
| Que doit changer un bug ? | Rétablir le service si nécessaire, puis comprendre ce qui a laissé passer le bug et tester le harnais corrigé |
| Des modèles plus capables feront-ils disparaître les contrôles ? | Certains deviendront peut-être inutiles, mais il faudra toujours fournir le contexte produit, décider de ce qui part en prod et regarder le coût |
Context engineering, harnais et CI
Avec Bruno Soulez, dans l’épisode 383 d’IFTTD publié le 4 novembre 2026, on part du context engineering. Puis on parle de harnais, d’organisation d’équipe, de code review et de bugs. La question de savoir si je relis encore le code généré arrive au milieu, une fois qu’on a posé ce qu’il y a autour.
L’échange complet est sur YouTube. Les passages en italique viennent de la transcription française. J’ai harmonisé la ponctuation et corrigé l’orthographe de « context engineering ». Je reprends le fil de la discussion, avec des explications et quelques prolongements entre les citations.
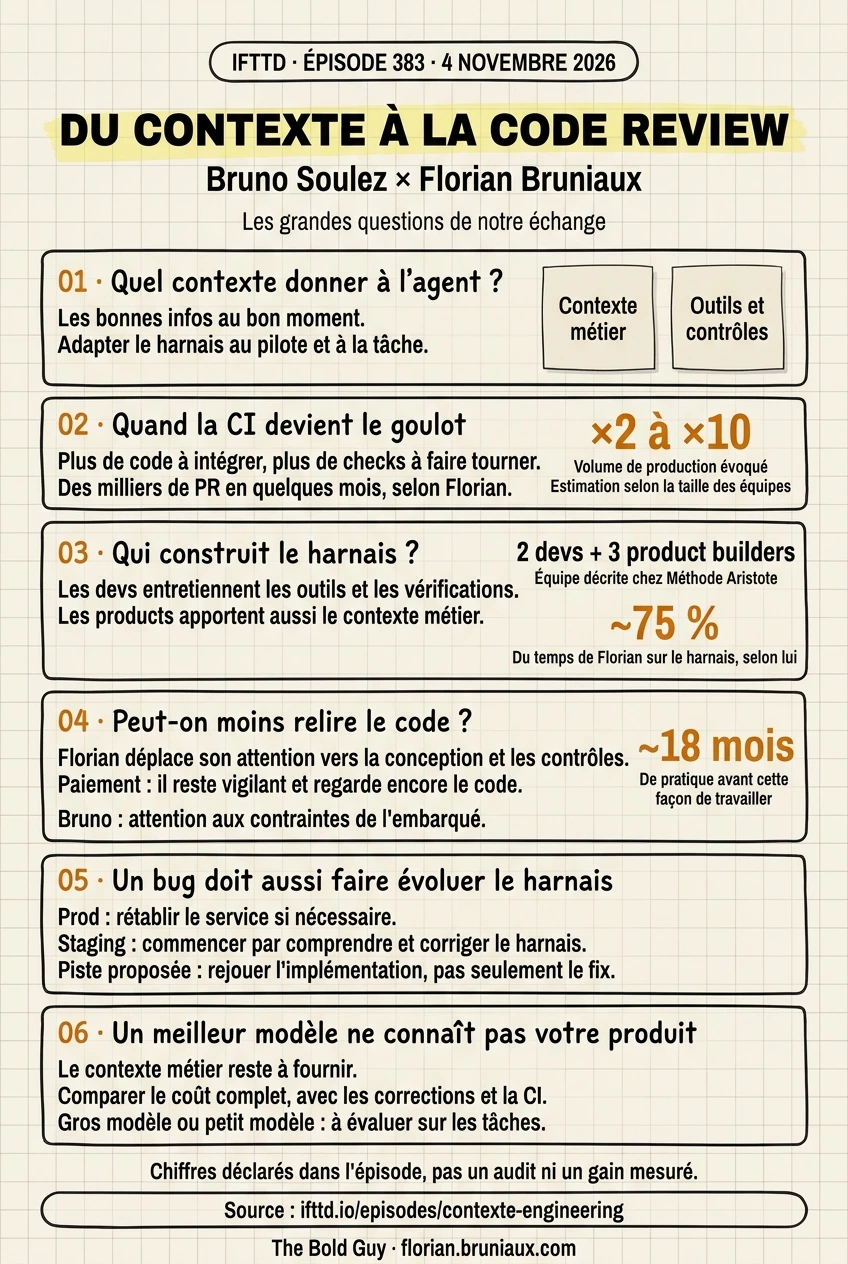
Bruno demande : « Très concrètement, comment est-ce qu’on pourrait faire la distinction entre le context engineering et le harness engineering ? »
Dans l’épisode, je place le context engineering au niveau le plus large : donner à l’agent les bonnes informations au bon moment. Le harness engineering concerne les outils et les systèmes qui permettent d’obtenir une qualité technique et métier acceptable. Dans d’autres textes, je place plutôt le contexte à l’intérieur du harnais. Les définitions bougent encore. Ce qui m’intéresse, c’est le contexte, les outils et les contrôles effectivement disponibles pour une tâche. Mon guide Claude Code distingue le modèle, le runtime harness, le repository harness et l’orchestrateur selon ce que chacun prend en charge.
Comme je le formule dans l’épisode : « Le harnais va pouvoir en fait générer dynamiquement un contexte adapté au pilote et à la tâche en cours. »
Un product, un dev front et un dev back peuvent travailler dans le même repository sans avoir besoin du même contexte ni des mêmes permissions. Sélectionner le bon contexte pour un profil ne l’autorise pas à agir sur une base de données ou à déployer. Le guide L0 à L5 détaille comment cibler les règles, vérifier leur chargement et partager la config.
Bruno me demande si l’évolution de la CI fait aussi partie du harnais. Pour moi, oui. Une fois que le code quitte la machine du dev, les tests, les reviews et l’intégration doivent encore vérifier comment il s’insère dans le travail du reste de l’équipe. Si on génère davantage de changements, on peut déplacer le goulot vers la CI et faire exploser sa consommation de ressources. L’épisode ne fournit pas de mesure d’un gain de débit ou d’une baisse des coûts.
Un exemple concret dans Build Evals That Actually Matter, à 35:46 sur la chaîne AI Engineer : Nick Ung et Akshay Sharma, de Lyft, décrivent une même suite d’evals qu’on peut rejouer en local, après un changement de prompt ou dans un hook de pre-commit. Ils évoquent aussi la CI/CD comme une piste qu’ils explorent. Ce retour d’expérience montre comment partager les vérifications à plusieurs endroits du workflow, sans donner de mesure d’un gain de livraison.
On revient ensuite sur le déterminisme. Un linter peut bloquer une violation mécanique, un test vérifier un comportement défini et une permission empêcher un effet externe. C’est une partie de ce qui rend l’agent utile. Ces checks ne rendent pas toutes les réponses du modèle déterministes.
En relisant nos notes internes sur le harnais et nos process, j’ai retrouvé une distinction utile. Un contrôle peut être présent dans le repository, avoir une config générée pour le client, être chargé, tourner lors d’une action et produire l’effet attendu. Il faut vérifier chaque affirmation. La génération ne concerne que les setups qui distribuent des configs dérivées : aucun besoin d’ajouter un générateur partout.
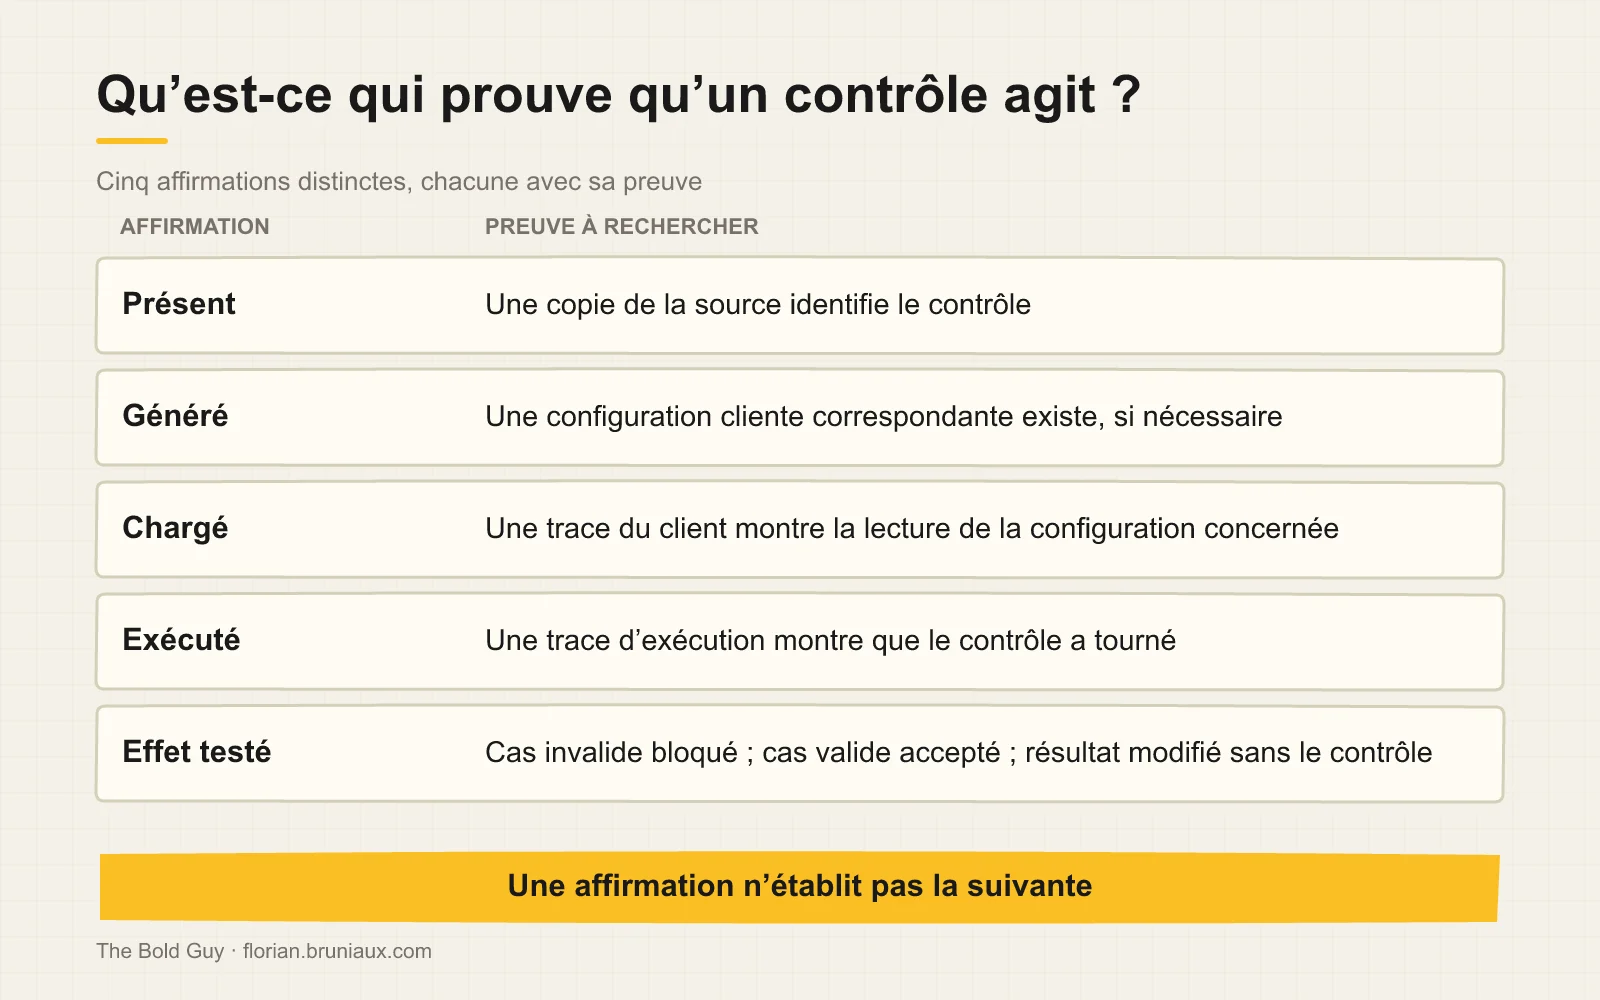
Un fichier de hook peut exister sans que le client actif le charge. Et un hook chargé peut afficher un warning tout en laissant l’action passer. Pour tester le contrôle et le chemin autorisé, je lancerais un cas volontairement invalide, vérifierais qu’il est bloqué, puis qu’un cas valide passe. Retirer le contrôle devrait changer le résultat du cas invalide. Le test ne couvre que la limite qu’on a effectivement exercée.
Autre exemple, tiré des notes de déploiement : un build peut passer, le healthcheck répondre, et une feature attendue rester désactivée par la config. Il faut donc tester cette feature sur la bonne version et le bon environnement, avec ses préconditions. L’article sur les merge gates détaille la différence entre un check qui passe et l’autorisation de merger.
C’est aussi le sujet de mon compilé DevSecOps du 30 octobre avec Bruno Soulez, où l’on débriefe l’épisode de Tugdual Grall, Pourquoi l’automatisation ne sauvera pas (toute seule) la sécu. La question vaut pour le harnais : vérifier le code produit et limiter les accès de l’agent ne couvrent pas la même chose.
Il faut aussi regarder les scripts et les outils connectés au modèle : ce qu’ils peuvent exécuter, les credentials qu’ils reçoivent et les ressources auxquelles ils ont accès. Mon guide des surfaces d’exécution de Claude Code développe ce point. Ajouter un outil de vérification, c’est aussi décider des droits qu’on lui donne.
Le papier AgentDojo, de Debenedetti et ses coauteurs, distingue justement ces mesures. Dans cet environnement de test publié en 2024, des instructions malveillantes sont placées dans les réponses d’outils. Les auteurs évaluent séparément la réussite des tâches ordinaires, leur réussite sous attaque et l’exécution de l’objectif de l’attaquant. Ce benchmark porte sur des assistants outillés, pas sur notre harnais de code. Il donne une façon de tester les accès et les effets indésirables en plus du comportement attendu.
Construire le harnais, puis le partager avec l’équipe
Bruno évoque un onboarding où chaque dev commence par reconstruire son propre harnais d’agent de code pour comprendre comment il fonctionne. Il me demande : « Est-ce que ça te semble devenir un peu une nécessité dans notre métier ? »
Ce qui m’intéresse, c’est ce que le dev comprend en le construisant. Je réponds : « En fait, pour surveiller quelque chose, par définition, il faut savoir quoi surveiller. »
On peut utiliser un workflow préparé sans savoir en construire toutes les pièces. Le créer et le maintenir demande de comprendre ce qui peut casser, où mettre les checks et ce que les outils ne savent pas vérifier. Un dev plus expert que moi dans un langage ou dans les tests pourrait améliorer des contrôles que je ne saurais pas concevoir.
Bruno demande ensuite si les équipes DevEx vont grossir ou si chacun devra entretenir ces outils. Je ne sais pas quelle taille elles auront. Je m’attends plutôt à voir travailler ensemble des spécialistes techniques et des personnes qui connaissent le métier, sur des parties différentes du système.
Bruno le formule ainsi : « On ne construit pas le code, mais on construit ce qui permet de construire le code. »
Je retrouve là une partie de mon ancien boulot de manager : donner un cadre aux personnes qui produisent, expliciter les attentes et comprendre pourquoi ça bloque ou ça dérape. Je suis revenu au développement, mais cette responsabilité reste là. Ceux qui font tourner le système restent responsables de ce qui en sort.
Chez nous, le changement est devenu concret quand un product m’a dit qu’il perdait du temps à m’expliquer des changements qu’il pourrait faire lui-même. Mon harnais personnel est devenu celui de l’équipe. Il a fallu décider du contexte à lui donner, de son autonomie et de qui traiterait les problèmes qu’il ne saurait pas diagnostiquer.
Ce product apporte aussi une connaissance métier que je n’ai pas forcément, même s’il ne maintient pas les checks techniques. Une implémentation et ses tests peuvent parfaitement s’accorder sur une mauvaise spec. Améliorer la génération ne règle pas ce qu’on voulait vraiment construire.
À cette période, je passais une grande partie de mon temps sur le harnais. Je n’ai ni relevé de temps ni étude d’effectifs derrière ce constat. Quelqu’un doit entretenir le système pendant que les autres l’utilisent, mais mon cas ne donne pas un pourcentage d’équipe à appliquer ailleurs. L’article sur le système d’instructions d’équipe détaille la config et sa distribution.
Ça passe aussi par des choix de config qu’on oublie. Dans l’épisode, je raconte avoir verrouillé une ancienne version de modèle. Quelques semaines plus tard, tout le monde était content des nouveaux résultats et je ne comprenais pas pourquoi je ne ressentais pas la même chose. J’ai fini par regarder ma propre config. Moi qui ai le FOMO, j’avais raté quelque chose que j’avais configuré moi-même. Il faut quelqu’un pour suivre ces évolutions, faire les mises à jour utiles et les partager sans défocus toute l’équipe à chaque release.
Les rôles qui se dessinent autour des agents
Bruno pousse l’analogie de l’usine : « Est-ce que ça veut dire que toi, tu vois le harness engineering devenir l’avenir du software engineering ? »
Je vois plusieurs directions possibles, comme dans ma carte des rôles autour du context engineering. Des software engineers pourraient se spécialiser dans les outils qui produisent et vérifient le code. D’autres se rapprocheraient du produit, où comprendre le métier compte davantage quand l’implémentation devient plus facile à obtenir. Travailler en greenfield ou reprendre du legacy demande aussi des compétences différentes.
On parle ensuite des langages de programmation et de ce qu’ils pourraient devenir. Bruno revient sur un problème qu’on a déjà avec les specs : le langage naturel laisse de la place à l’interprétation. Comme il le dit : « Un mot, en fonction des gens, n’aura pas forcément le même sens. »
Dans une EdTech, avec des gens passionnés de langue française, ce sujet me parle. Les mots ont un sens, parfois plusieurs. Une instruction peut sembler précise à celui qui l’écrit tout en laissant une décision produit ouverte. Avoir confiance dans le code généré ne résout pas ce désaccord : quelqu’un doit encore définir le comportement attendu et vérifier qu’il est bien implémenté.
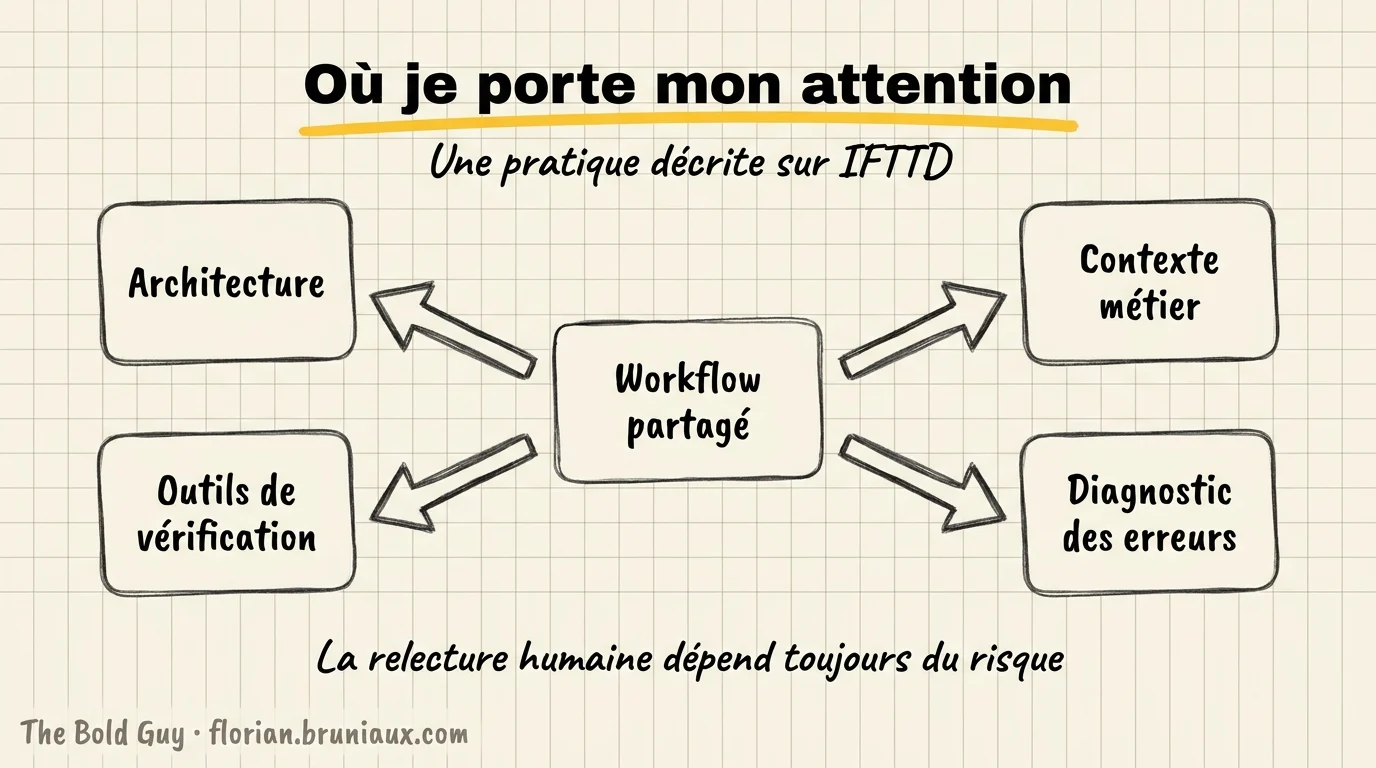
Dans l’épisode, on imagine de futurs langages et d’autres façons d’exprimer la logique. Ça reste de la spéculation. Je n’ai pas de remplacement démontré des langages à présenter ici. Ce que je peux décrire aujourd’hui, c’est où je porte mon attention et ce que je dois encore comprendre du produit pour décider.
Je dis : « Mon égo n’est pas dans le code. » Ça explique pourquoi je peux m’éloigner de l’écriture de chaque implémentation. Ça ne fait pas disparaître l’expertise : il faut encore juger l’architecture, le métier, les vérifications et les conséquences d’une erreur. Bruno passe alors à la question de la code review.
Le code que je ne relis plus, et les limites que pose Bruno
Bruno demande : « Est-ce que donc, pour toi, l’idée du harnais, c’est de faire en sorte qu’on ait plus besoin de relire le code ? »
Sa question va jusqu’à demander si l’on pourrait générer le code et le pousser directement en prod sans le regarder. Je lui réponds à partir de ce qu’on fait déjà, avec les limites qui vont avec.
Je réponds : « Moi, à l’heure actuelle, on pousse du code en prod que je ne relis pas parce que je déporte mon attention. Mais attention, qu’on soit clair, je n’ai pas fait ça day one. »
J’en suis arrivé là après environ dix-huit mois de développement assisté par IA, avec beaucoup d’allers-retours et de bêtises en chemin. Je regarde la conception, l’architecture, l’organisation des fichiers et les contrôles. Sur le paiement ou un changement qui me met en stress, je reste vigilant et je regarde encore le code. En revanche, je n’ouvre plus systématiquement chaque diff pour le relire ligne par ligne.
Bruno me rejoint sur une partie du raisonnement, puis pose une limite. Sur une application web familière, plusieurs implémentations peuvent convenir dès lors qu’elles font ce qui est demandé. Dans l’embarqué, les contraintes de mémoire, de calcul ou de sûreté peuvent rendre le choix d’implémentation déterminant.
Bruno objecte : « En revanche, il y a des contextes où le choix d’implémentation a une conséquence qui peut être plus ou moins délétère. »
Cette objection compte. Le fait de travailler sur un produit web ne donne pas les mêmes conséquences à tous les changements d’un repository. Un lien public, une permission sur un compte ou un changement dans le paiement demandent des décisions différentes.
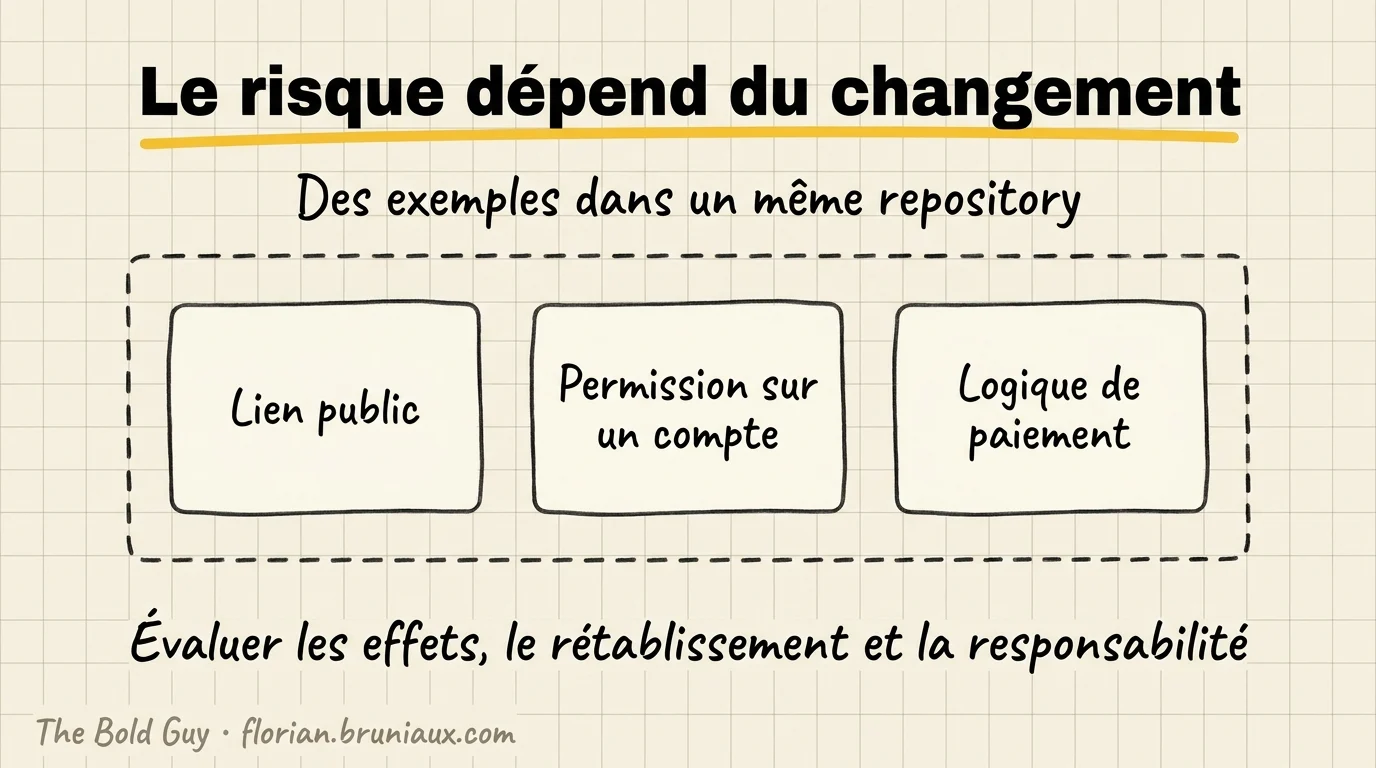
Même dans le front, les conséquences varient. Une retouche visuelle peut être facile à annuler ; un formulaire peut collecter des données sensibles, déclencher un paiement ou changer une autorisation. Dans l’épisode, je prends l’exemple d’un formulaire qui bug et qu’on peut corriger vite sur le web. Il faut regarder ce qu’il a déjà fait : redéployer vite n’annule pas toutes ses actions.
Je dis aussi, de façon plus large, que ceux qui inspectent encore tout n’ont peut-être pas assez travaillé leur harnais. Mon exemple ne suffit pas à établir ça. Une équipe peut avoir beaucoup de vérifications et garder une code review humaine détaillée à cause des conséquences de ses changements ou de ce qu’elle ne sait pas encore vérifier. Mon expérience ne permet pas d’expliquer son choix à sa place.
Bruno décrit une autonomie qu’on accorde progressivement sur des périmètres suffisamment safe. Je rendrais le transfert explicite : quelle décision on délègue, quels contrôles la couvrent, ce qu’on fait s’ils ne tournent pas et qui accepte l’incertitude qui reste. Avoir confiance dans le pilote, disposer de preuves sur le code et autoriser un déploiement sont des décisions différentes. L’épisode ne fournit pas de comparaison contrôlée avant et après sur les bugs passés en prod. Mon protocole UVAL et sa politique de review expliquent la compréhension que je garde sur les chemins sensibles tout en déléguant les reviews courantes.
Matt Pocock propose un point d’entrée utile dans son walkthrough de workflow IA, à 1:11:06 sur AI Engineer. Face à un service et à ses tests, il explique qu’il commencerait la code review par les tests pour vérifier qu’ils testent des choses pertinentes, puis regarderait le code. Cette approche conserve une review humaine et met l’attention sur ce que les tests vérifient, une question que je garde même en déléguant davantage.
Corriger le bug et le harnais
Bruno me demande alors si, quand un bug arrive en prod, je commence par réparer l’usine avant de lui demander de corriger le code. Ou si je corrige d’abord le bug : « Ou est-ce que tu commences d’abord par corriger le problème avant de corriger ce qui a causé le problème ? »
Je réponds : « Globalement, déjà, il faut faire les deux. »
Ça dépend de ce que coûte l’attente. En staging, quand je peux prendre le temps, je commence par le harnais : pourquoi ça a merdé, quel contexte manquait, quel skill ou quel check il faut modifier. En prod, si le service doit être rétabli, je corrige d’abord. Et si je sais exactement où est le problème, je peux coder la correction moi-même. L’enquête sur le process ne doit pas retarder le rétablissement du service.
Après, il faut comprendre ce qui s’est passé. L’agent a pu recevoir une info périmée, manquer une instruction ou un outil, ou suivre une spec incomplète. Le test a peut-être vérifié le mauvais comportement. Ajouter le même warning aux prochaines tâches revient à traiter toutes ces causes comme un seul problème.
Avant de modifier le harnais partagé, je garderais la spec, la version en échec, le contexte et le résultat observé. Un invariant mécanique peut aller dans un test ou un linter. Une décision produit non tranchée demande toujours quelqu’un qui connaisse le métier. L’agent peut aider à trouver une explication, mais il faut la confronter aux traces.
Nos notes internes de code review ajoutent une contrainte : les preuves portent sur une version précise du code. Après un fix, la review du commit précédent ne dit pas si le nouveau code est correct. Pour réutiliser un résultat, il faut vérifier qu’il s’applique toujours au bon périmètre, à la config et aux versions d’outils concernées.
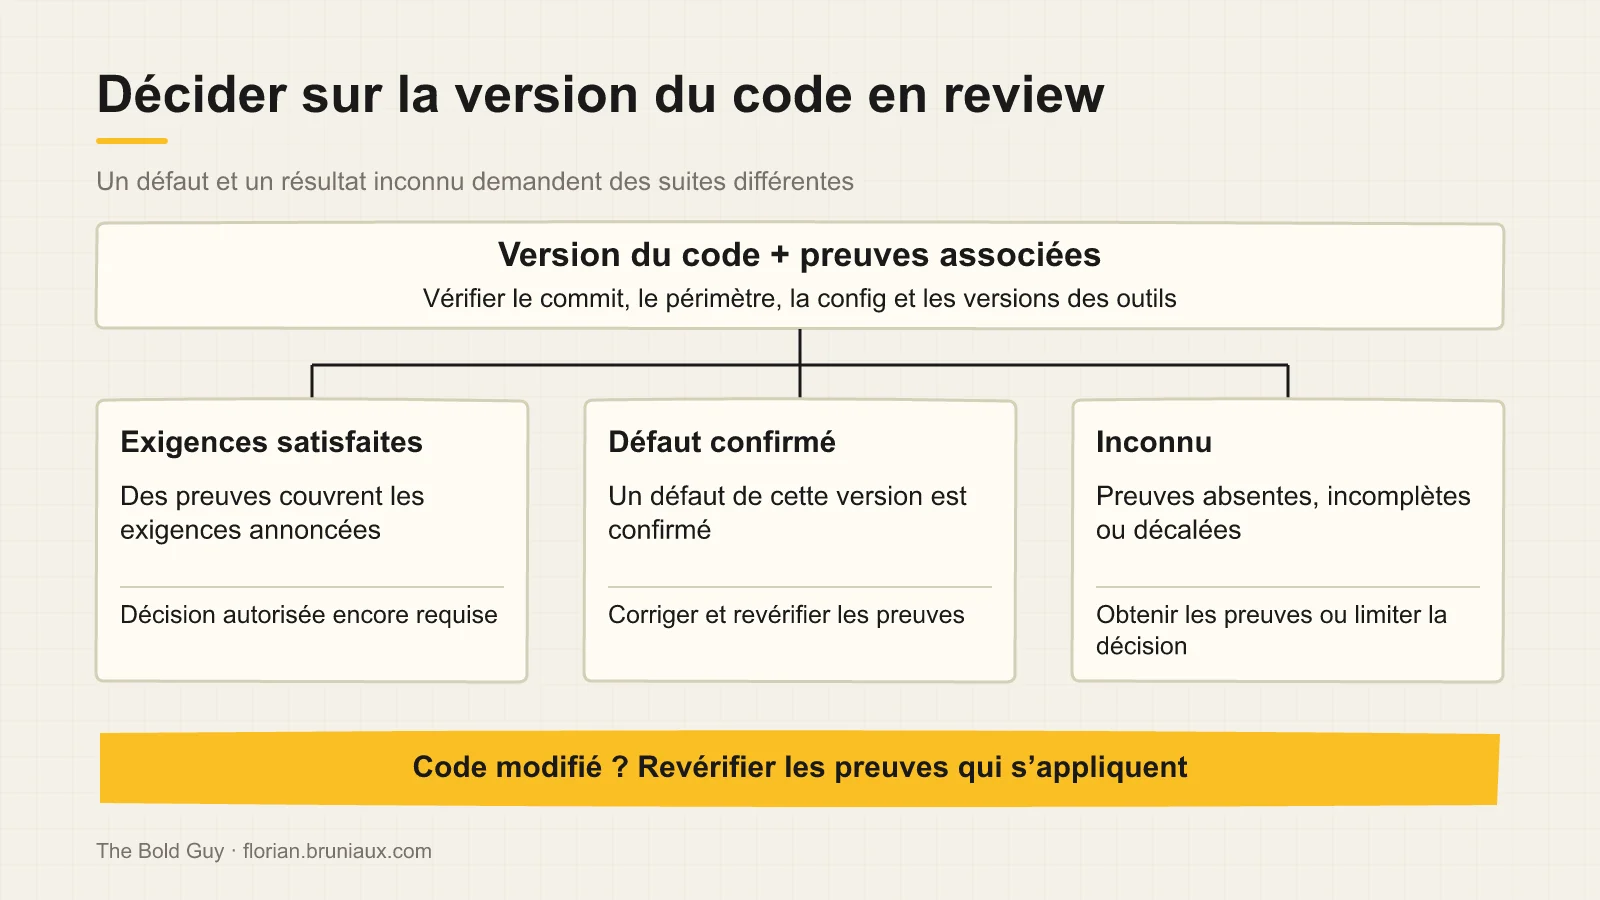
Je ferais la différence entre un bug confirmé et un résultat qu’on ne sait pas établir. Une assertion qui échoue peut montrer ce qu’il faut corriger. Un reviewer indisponible, un rapport de tests incomplet ou un résultat lié au mauvais commit laissent la conclusion inconnue. La personne qui décide de la suite doit voir cette différence, obtenir ce qui manque ou prendre une décision plus limitée avec l’autorité pour le faire.
Je propose aussi quelque chose que je n’ai pas évalué dans une étude avant et après : une fois le harnais corrigé, lui faire rejouer toute l’implémentation d’origine. Je fais le parallèle avec mes enfants qui apprennent l’orthographe. Leur indiquer le mot qui contient une faute les aide davantage que leur demander de réécrire toute la phrase.
Je formule cette proposition ainsi : « On lui fait limite rejouer l’intégralité de l’implémentation et pas juste la correction. »
Une correction guidée vérifie s’il sait réparer avec un indice. Refaire l’implémentation vérifie si le harnais corrigé évite l’erreur connue, dans les conditions choisies. Dès qu’on ajuste les instructions sur cette tâche, elle devient un cas de régression. Il faut d’autres tâches, gardées de côté, et des alternatives valides pour voir si la correction aide plus largement. La section du guide sur les cas de référence et la règle de décision à figer détaille comment séparer ces critères du système qu’on cherche à améliorer.
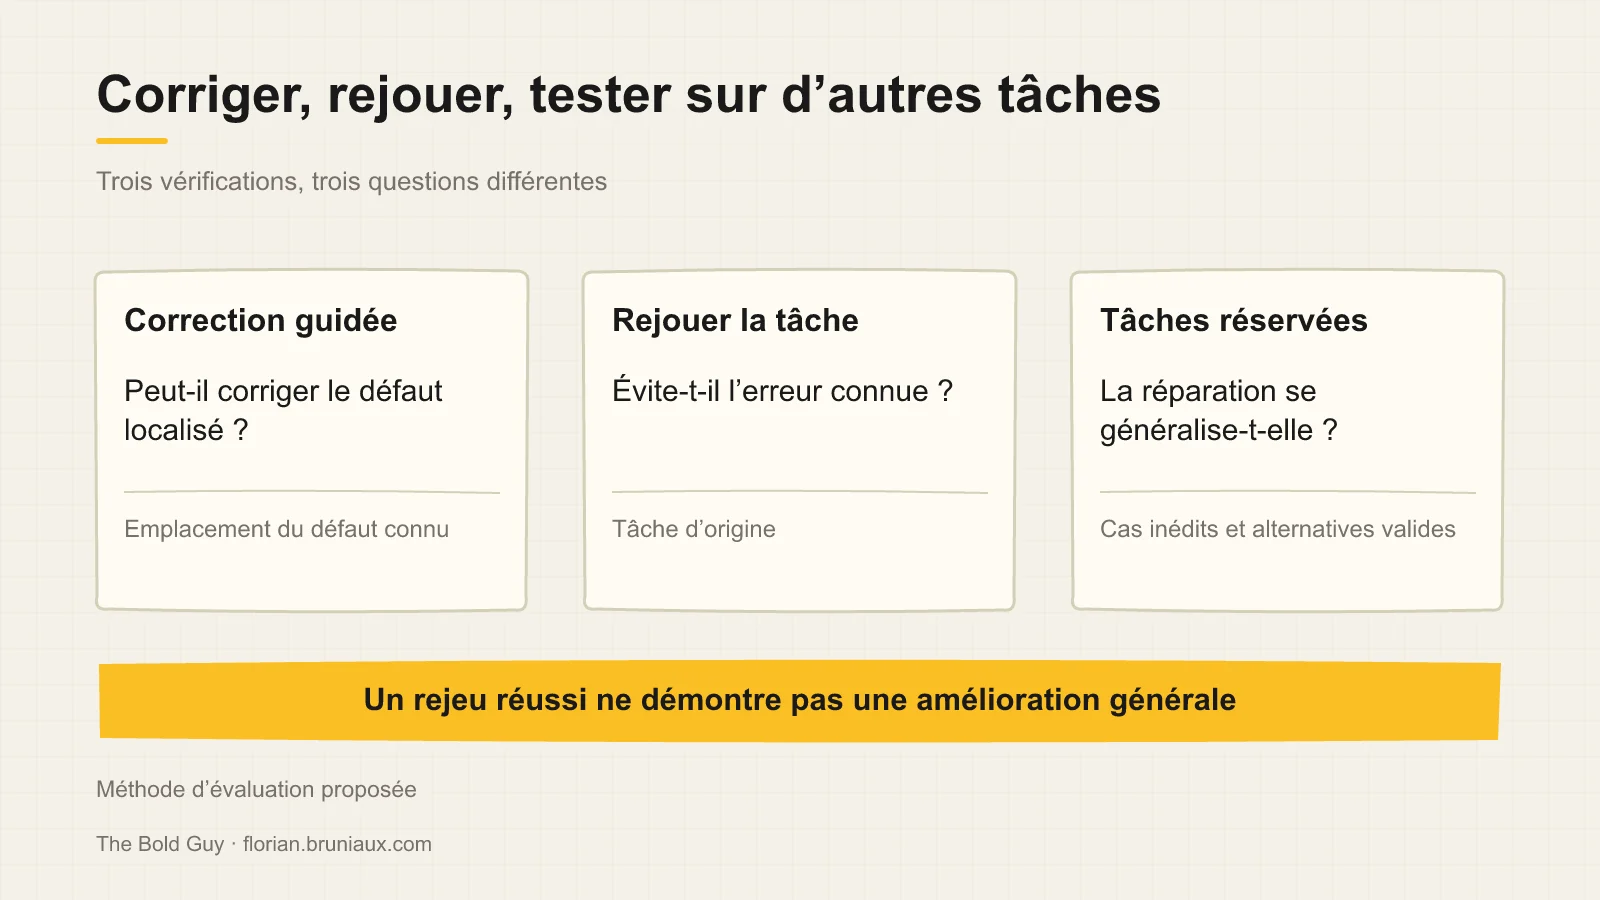
L’article sur les remarques de review récurrentes à transformer en contrôles testés développe cette méthode. Tracer un fix, reproduire un bug et démontrer une amélioration demandent des observations différentes. Même si l’explication du bug semble convaincante, il reste à la tester.
De meilleurs modèles, et le coût complet pour shipper
Vers la fin, Bruno me demande si l’amélioration des LLM finira par nous faire retirer une partie des outils : « Est-ce que ça veut dire que là, on est dans une phase où on ajoute de plus en plus d’outils sur nos harnais, mais qu’il y a un moment, on va en fait retirer de plus en plus d’outils parce qu’en fait nos LLM seront capables de faire sans qu’on ait besoin de les maîtriser ? »
Je pense que certains contrôles techniques pourront disparaître ou changer quand les modèles progresseront. Mais un modèle généraliste ne connaît pas d’emblée le produit qu’on a choisi de construire.
J’explique pourquoi : « Surtout quand on innove, on est une boîte tech qui fait un nouveau truc, un produit, par définition, il le connaît pas, ce produit. »
Il faut toujours lui donner le contexte métier. Et les personnes qui exploitent le système doivent encore décider de ce qui peut partir en prod. Un meilleur modèle donne une raison de retester les comportements concernés après une mise à jour. Ça ne prouve pas qu’on peut retirer un contrôle sans perdre ce qu’il apportait.
On discute aussi du choix entre un gros modèle avec davantage de thinking et un plus petit qui demande plus d’allers-retours. Une réponse plus lente peut éviter des corrections. Une réponse rapide peut provoquer plus d’interruptions et de tentatives en CI. Dans l’épisode, j’explique ce que je voudrais mesurer, sans avoir comparé ces modèles sur les mêmes tâches pour voir lequel s’en sort le mieux. Mon article sur le coût d’une tâche acceptée plutôt que d’un token détaille comment faire ce calcul.
La prépublication Tokenomics, de Salim et ses coauteurs, donne un exemple de ce découpage. Sur 30 tâches exécutées avec ChatDev et GPT-5 reasoning, la phase de code review entre agents consomme en moyenne 59,4 % des tokens. Le résultat reste limité à ce framework et à ce modèle. Il porte sur des tokens, dont le prix varie selon le type, et ne permet pas de reprendre cette proportion pour notre facture. Il justifie de regarder où part la consommation après la première génération.
Les rapports sur les contributions et les coûts que j’ai repris aident à préciser ce qu’on mesure. Une trace montre une opération, pas qui a conçu, relu et vérifié tout le changement. Une remarque de bot doit être confirmée. Une attribution manquante peut venir d’une instrumentation manquante. Compter les commits ou les lignes générées ne donne pas la comparaison de qualité qui manque.
| Quantité | Périmètre de comparaison |
|---|---|
| Temps écoulé pour shipper | Comprend l’attente, la review et le rétablissement ; additionner les durées des jobs parallèles ne donne pas ce temps |
| Consommation de calcul et de modèles | Comprend les tentatives échouées, annulées et répétées, avec leurs configurations enregistrées |
| Montant facturé | Demande de rattacher les charges à la bonne période et au bon usage ; acheter des crédits ne dit pas combien on en a consommé |
| Travail humain | Comprend l’enquête, les corrections et l’entretien des contrôles, même lorsque moins de lignes sont relues manuellement |
Un job CI peut coûter moins cher alors que le total augmente, parce qu’on lance davantage de jobs ou de tentatives. À l’inverse, consommer moins dans un abonnement fixe peut libérer de la capacité sans changer la facture. Je séparerais cette capacité d’une économie financière et garderais les charges non attribuées visibles. Je reprends cette façon de compter dans nos anciennes analyses de coûts, sans leurs montants. Elle ne permet pas d’annoncer une nouvelle économie ici.
L’article sur le goulot de vérification détaille la mesure par étape. Le guide d’une boucle de review bornée précise quand s’arrêter et quelles preuves attendre. Pour faire l’essai chez nous, je choisirais une catégorie de changements, avec les mêmes critères d’acceptation. Je garderais les tentatives échouées et les interventions humaines. Il faudrait aussi décider avant de commencer quels éléments manquants ou quels bugs passés au travers mettraient fin à l’essai.
L’étude randomisée de METR publiée en 2025 rappelle pourquoi je voudrais faire cette mesure. Sur 246 tâches confiées à 16 devs expérimentés dans des repositories qu’ils connaissaient bien, l’accès aux outils IA allonge le temps de réalisation de 19 %, alors que les participants pensent avoir gagné du temps. Ils utilisent surtout Cursor Pro et Claude 3.5/3.7. Ce résultat concerne ces outils et ce contexte de début 2025 ; il ne tranche pas pour notre harnais ou les modèles actuels. Mon impression de travailler mieux ne suffit donc pas à annoncer un gain mesuré.
Bruno termine avec la question rituelle du podcast : espaces ou tabulations ? Là, ma réponse est plus courte : espaces. Pour le reste, j’aimerais discuter avec des gens qui ont réduit une étape précise de code review : ce qui les a convaincus, et ce qui leur a fait garder, rétablir ou limiter cette décision ensuite.
À retenir
(Ce que vous savez maintenant)
- Les questions de Bruno passent du context engineering et des outils aux personnes chargées de les construire et de les faire fonctionner
- Ma réduction de la relecture ligne par ligne décrit une pratique limitée à un périmètre, avec les objections de Bruno et les conséquences propres à chaque changement
- Un contrôle présent, chargé, exécuté ou testé : ce sont quatre affirmations à vérifier séparément
- Corriger un bug, rejouer la tâche et tester sur d’autres cas répondent à des questions différentes
- Comparer des modèles demande d’observer le travail accepté, les tentatives échouées, la CI et les interventions humaines selon les mêmes critères
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Related appearances
Live appearances and podcast episodes about this article.