Le prix par token est incomplet : pourquoi des modèles moins chers ne font pas des factures moins chères
Opus 5.5 change l’économie des entrées, sorties et du cache. Chiffrez la tâche acceptée, nouvelles tentatives et review comprises, avant de choisir un modèle moins cher.
Aller au résumé ↓ Florian Bruniaux
The Real Cost of AI · Partie 5/9
TL;DR
Je pense que le prix affiché par un fournisseur décrit imparfaitement une facture : cache, répartition entrée-sortie et travail nécessaire pour terminer la font tous varier. Je chiffre donc la tâche acceptée, pas le token. Avec Opus 5.5, je pense toujours qu’un petit modèle devant le grand vaut la peine, mais comme pari à mesurer, pas comme acquis. C’est l’hypothèse derrière Agent Router, dont le code est public. L’exemple de coût ci-dessous reste un calcul illustratif. Pour 2027, je m’attends à la poursuite de la baisse des prix par token tandis que les abonnements donnent moins de quota au même prix : la facture augmente donc quand même.
| Décision | À mesurer |
|---|---|
| Référence actuelle | Opus 5.5, modèle recommandé par défaut par Anthropic pour la plupart des charges, avec grille tarifaire datée et effort explicite ; Fable 5.2 (8 $ / 40 $) est le niveau supérieur |
| Comptabilité des tokens | Séparer entrées nouvelles, création de cache, lectures de cache et sorties |
| Comptabilité du workflow | Inclure tentatives échouées, nouvelles tentatives et corrections humaines |
| Décision d’adoption | Coût par tâche acceptée à la qualité requise |
Les changements économiques apportés par Opus 5.5 méritent d’être testés dès maintenant. Une mise à niveau de modèle peut réduire le prix des tokens et le nombre de tours nécessaires pour terminer.
C’est une raison de remplacer une ancienne référence de coût, y compris l’hypothèse selon laquelle envoyer toute tâche facile à un plus petit modèle doit économiser de l’argent.
Chiffrer une tâche Opus 5.5 à partir de son usage réel
Les tarifs standard de l’API Claude, revérifiés le 10 novembre 2026, donnent les prix Opus 5.5 suivants en USD par million de tokens.
Ce sont les tarifs standard, hors Fast Mode, remises par lots, ajustements régionaux et frais d’outils.
| Catégorie de tokens | USD par million de tokens |
|---|---|
| Entrée hors cache | 4,00 |
| Création de cache de cinq minutes | 5,00 |
| Création de cache d’une heure | 8,00 |
| Lecture de cache | 0,20 |
| Sortie | 20,00 |
À titre d’illustration, une tâche avec 100 000 tokens d’entrée hors cache, 50 000 tokens de création de cache de cinq minutes, 900 000 tokens de lecture de cache et 20 000 tokens de sortie coûte 1,23 $ en tokens de modèle à ces tarifs.
Les catégories sont disjointes dans cet exemple construit. Ce n’est pas une exécution de review mesurée. Les nouvelles tentatives et une autre passe de review ajoutent leur propre usage.
Les décomptes de tokens ne se transfèrent pas non plus entre générations de modèles. La page tarifaire Anthropic indique que le tokenizer Claude 4.7+ produit environ 30 % de tokens en plus pour le même texte que les modèles Claude précédents. Une comparaison de prix par token entre générations doit donc être refaite sur le même texte.
Pour les candidats hébergés plus petits, la grille du 10 novembre liste Sonnet 5.5 à 2 $/10 $ en entrée/sortie par million de tokens. Haiku 5.5 a deux paliers de taille de prompt : 0,10 $/0,50 $ jusqu’à 100 000 tokens, puis 0,50 $/2,50 $ au-delà. Spécifications Haiku 5.5
Les fiches OpenAI vérifiées le même jour donnent les tarifs standard suivants en USD par million de tokens pour un prompt d’au plus 272 000 tokens d’entrée.
| Modèle | Entrée hors cache | Lecture de cache | Sortie |
|---|---|---|---|
| GPT-6 Luna | 0,10 | 0,01 | 0,50 |
| GPT-6.1 Terra | 1,00 | 0,05 | 5,00 |
| GPT-6.1 Sol | 2,00 | 0,10 | 10,00 |
| GPT-6 Astra | 10,00 | 1,00 | 50,00 |
Au-delà de ce seuil, les prix d’entrée et de cache doublent et celui de sortie est multiplié par 1,5 pour toute la requête. Création de cache, modes de vitesse, outils et résidence peuvent modifier la facture. L’usage Codex inclus dans un abonnement suit le barème de l’offre.
L’explication du coût d’une tâche par Addy Osmani sur claude.dev, datée du 25 septembre 2026, relie les prix des tokens aux tours, à la réutilisation du cache et au travail terminé.
Pour la code review, le calcul suivant est la dépense totale de campagne divisée par les tâches de review acceptées, en conservant les tentatives échouées et partielles au numérateur. Rapportez séparément le triage humain au lieu de le cacher dans un chiffre API séduisant.
Ma discussion avec Bruno Soulez revient sur cette comparaison : un plus grand modèle peut nécessiter moins de corrections, tandis qu’une réponse plus rapide peut créer davantage de travail humain et CI.
Un abonnement ajoute une autre mesure : le quota consommé pour terminer la même tâche. Une estimation en équivalent API est utile pour comparer, mais ce n’est pas la facture d’abonnement. La neuvième partie garde ces compteurs séparés.
Les observations de coût antérieures expliquent les mécanismes
Les retours de conférences ci-dessous expliquent pourquoi le prix du token ne suffisait déjà pas. Leurs tarifs et noms de modèles appartiennent à la période décrite. Opus 5.5, recommandé par Anthropic pour la plupart des charges, est ici le candidat à évaluer, avec Fable 5.2 réservé aux raisonnements exigeants ; ces retours fournissent des mécanismes à examiner, pas une sélection de modèles.
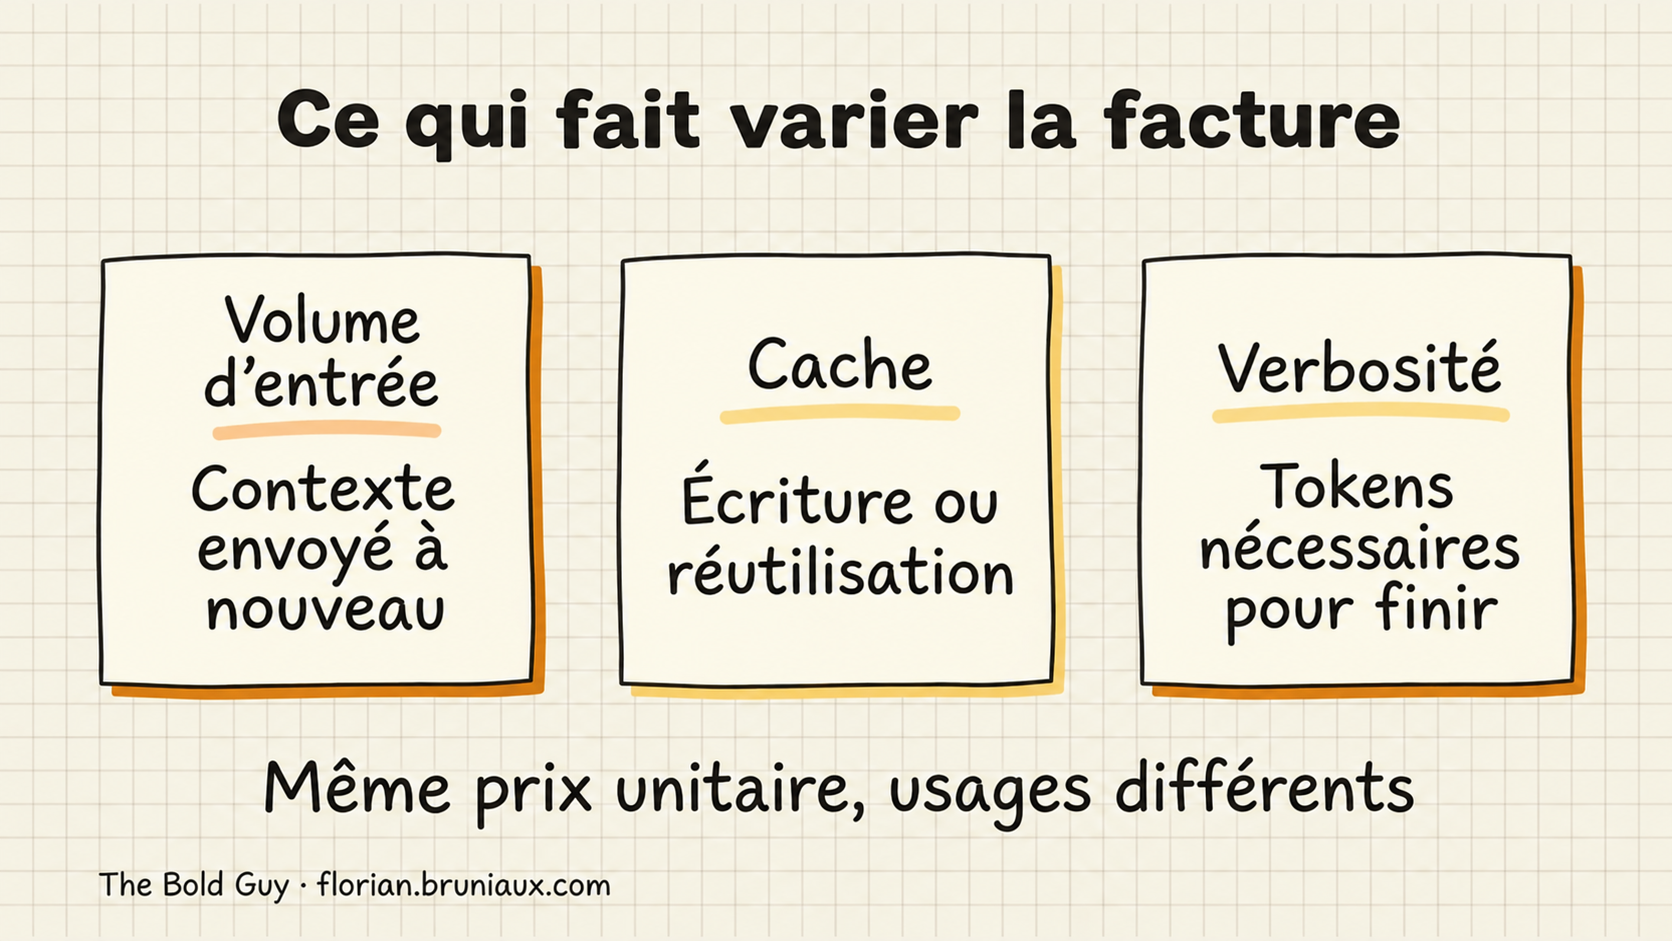
Le prix catalogue masque trois multiplicateurs
Le premier est la répartition entrée-sortie. Les données d’usage de Cursor, citées par Martignole sans qu’il garantisse entièrement la théorie sous-jacente, situent 90 % des tokens consommés par un agent de code côté entrée : fichiers lus, historique de conversation renvoyé à chaque tour, descriptions d’outils transportées.
Seuls 10 % correspondent au code réellement généré.
Les fournisseurs facturent le token de sortie plusieurs fois plus cher que l’entrée, ce qui laisse penser à la lecture de la grille que la sortie doit dominer la facture. En pratique, le côté moins cher à l’unité est celui qui apparaît neuf fois sur dix, et c’est lui qui pilote le total.
Le second multiplicateur est le cache. Dans le retour de Martignole de juillet 2026, une lecture de cache coûtait environ un dixième d’une entrée nouvelle ; les tarifs Opus 5.5 ci-dessus ramènent ce ratio à un vingtième, après qu’Anthropic a baissé le prix de lecture du cache Opus 5.5 à 0,20 $, contre 0,50 $ pour son prédécesseur, le 22 septembre 2026.
Aucun ratio ne s’applique à la facture de la tâche entière.
Un modèle n’a pas de mémoire entre les tours : chaque message renvoie toute la conversation, prompt système, définitions d’outils et contexte de codebase compris. Sans cache, cette répétition est facturée plein tarif à chaque fois.
Avec le cache activé, écrire un nouveau tour coûte environ 1,25 fois le prix d’entrée, mais relire un préfixe en cache au tour suivant en coûte une fraction (un dixième dans le retour de Martignole, un vingtième sur Opus 5.5).
Sur l’API brute d’Anthropic, le cache est optionnel via un champ cache_control ; Claude Code l’active automatiquement, et les autres agents construits sur l’API peuvent le faire ou non.
Martignole l’a appris à ses dépens sur un projet personnel, un jeu de rôle construit sur l’API Claude : sans cache activé, une session lui coûtait trente à quarante dollars.
Le troisième multiplicateur est le travail nécessaire pour terminer. Son retour de juillet décrivait un modèle moins cher consommant assez de tokens supplémentaires pour coûter plus, et un autre harnais de code modifiant encore la dépense.
Ces exemples motivent un test actuel : garder tâche et critères d’acceptation fixes, puis mesurer Opus 5.5 avec les outils et l’effort réels prévus pour le déploiement.
Une exécution réussie plus courte et un arrêt prématuré incomplet peuvent tous deux sembler peu coûteux tant que le résultat n’est pas vérifié.
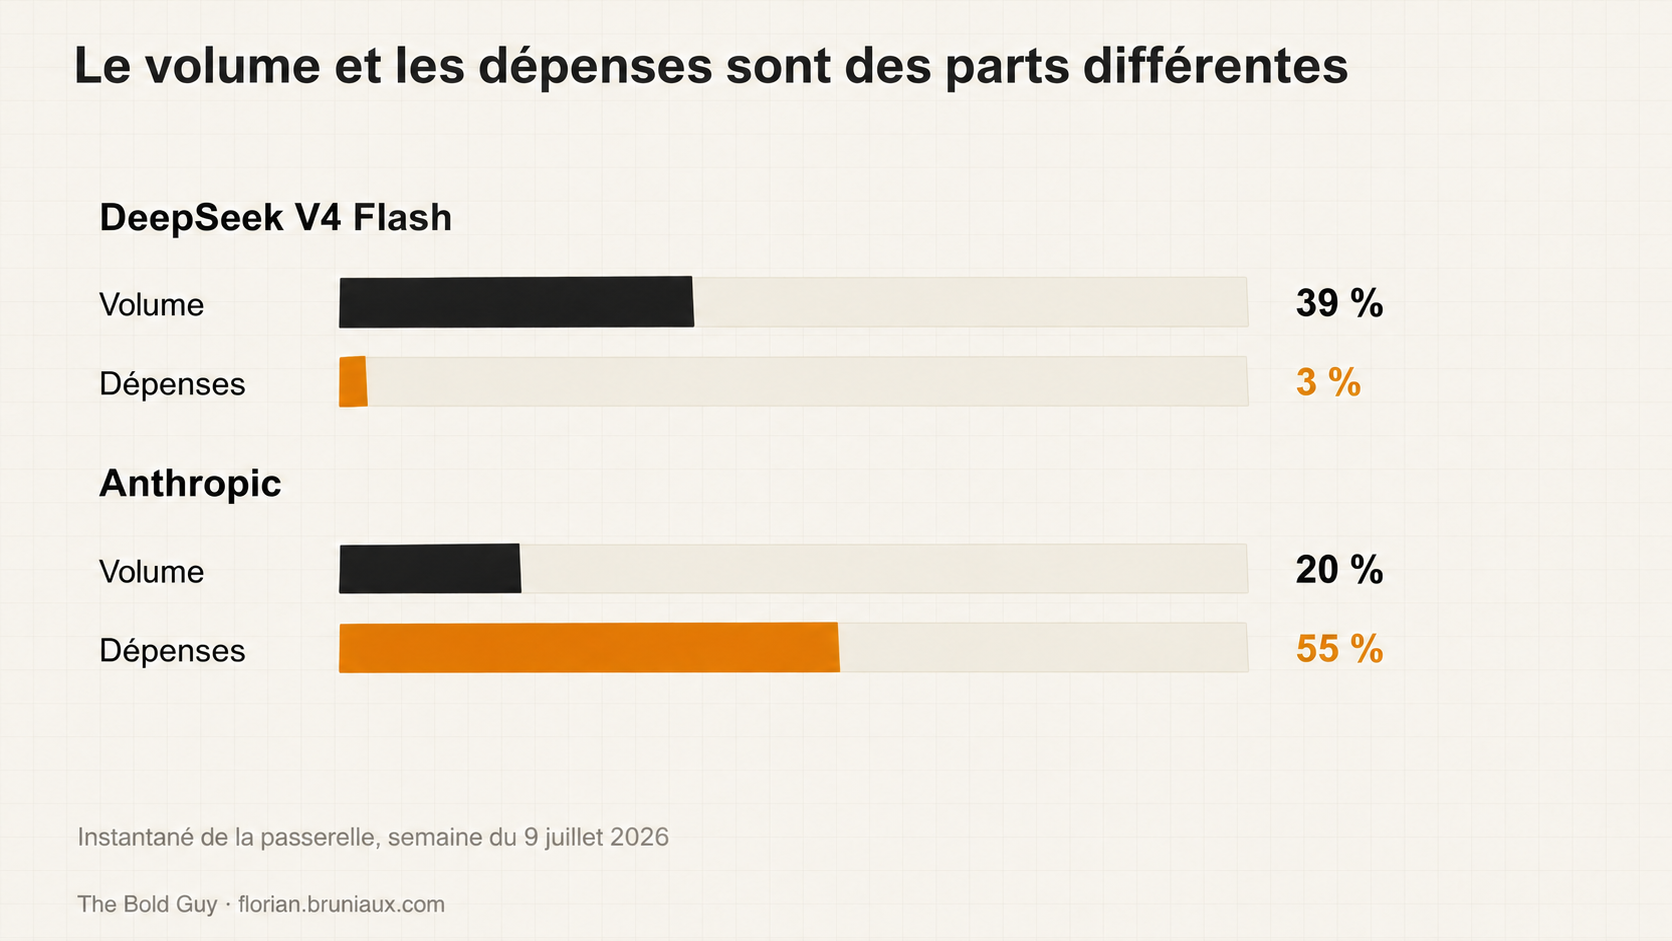
Le volume ne dit rien de la dépense
Les modèles Anthropic, avec environ 20 % du même volume, représentaient 55 % de la dépense. Presque deux fois le trafic Anthropic sur DeepSeek se traduisait par 3 % de la facture, tandis que la part d’Anthropic, un cinquième du trafic, représentait l’essentiel du budget.
La grille a changé depuis : DeepSeek a supprimé ses remises hors pointe le 5 septembre 2025, puis V4-Pro a rétabli le demi-tarif hors pointe le 16 août 2026, après la semaine ci-dessus. Une part mesurée sur une semaine dépend donc des conditions de cette semaine.
Lire le volume comme indicateur de coût, comme le ferait une adoption guidée par les classements, donne une vision inversée des coûts.
L’inférence est le coût qui revient sans cesse
Percy Liang, professeur d’informatique à Stanford, enseigne la même distorsion côté infrastructure dans son cours CS336, « Language Modeling from Scratch » (traduction : « Construire des modèles de langage à partir de zéro »).
La leçon 10 traite de l’inférence. Liang en résume l’économie en une phrase à laquelle la conférence de Martignole arrive indépendamment, sous un tout autre angle : l’entraînement est un coût ponctuel, aussi élevé soit-il ; l’inférence est un coût engagé chaque jour.
Pour concrétiser l’échelle, Liang cite l’API d’OpenAI, estimée à environ 8 600 milliards de tokens générés par jour (chiffre cohérent avec le suivi du volume de l’API OpenAI par a16z pour octobre 2025). Face à un entraînement de la taille de GPT-4, que Liang situe autour de 32 000 milliards de tokens, OpenAI régénère donc un volume comparable en moins de quatre jours de service ordinaire.
Pour qui veut maîtriser une facture, Liang conclut que le chiffre à suivre se situe en aval du prix catalogue, dans le coût effectif par token effectivement généré en production, après cache, nouvelles tentatives et verbosité.
La conférence de Martignole reconstitue ce même chiffre depuis les données de routage Vercel et OpenRouter plutôt que depuis des diapositives de cours à Stanford.
Les modèles de pointe captent encore la majeure partie de l’argent
Tuhin Srivastava, CEO et cofondateur de la plateforme d’inférence Baseten, a formulé le point correspondant côté offre lors d’une intervention en juin 2026 pour le cours MS&E435 de Stanford, « Economics of the AI Supercycle » (traduction : « Économie du supercycle de l’IA ») : à cette date, environ 90 % ou 95 % des dépenses d’inférence allaient encore aux modèles de pointe, même si les alternatives à poids ouverts réduisaient l’écart de capacité.
Interrogé sur la destination de cette dépense, Srivastava évoquait davantage d’applications agentiques et de plus grands modèles, deux facteurs impliquant davantage d’inférence et de calcul. Cette croissance concerne la part récurrente des dépenses, tarifée par token et facturée chaque jour.
Ce qu’il en reste
Mettez les reçus de Martignole face au cours de Liang et aux chiffres de Srivastava : le même écart apparaît partout. Le prix unitaire d’une page fournisseur ne décrit pas le coût d’une charge de travail, et la plupart des dépenses sont dans l’inférence récurrente masquée par ce prix.
La quatrième partie de cette série nommait déjà la réponse organisationnelle : une fonction FinOps, un rôle nommé, quelqu’un responsable du chiffre réel plutôt que du catalogue.
Mais un rôle ne fonctionne que s’il a une référence à laquelle comparer ses mesures, et la deuxième partie montrait à quel point cette visibilité manque souvent dans une offre forfaitaire sans facture par appel pour vérifier le calcul.
Pour Opus 5.5, utilisez les tarifs publiés et les catégories de tokens mesurées, puis examinez les tentatives échouées et les reprises humaines.
Réexaminez le routage si le modèle plus puissant, utilisé seul, coûte moins cher par tâche acceptée à qualité égale.
Gardez les changements de prix fournisseurs dans les scénarios budgétaires, car une grille peut bouger dans les deux sens : la hausse de Sonnet 5 à 3 $ / 15 $ prévue le 1er septembre 2026 a été annulée, tandis que le prix de lecture du cache Opus 5.5 a baissé.
Mon attente pour 2027 reste une hausse de facture : les prix par token peuvent continuer de baisser tandis que les abonnements donnent moins de quota au même prix.
YSNK
(Ce que vous devriez maintenant savoir)
- Opus 5.5 nécessite une nouvelle référence de coût séparant entrées hors cache, création de cache, lectures de cache, sorties et nouvelles tentatives
- Les données de passerelle Vercel concrétisent le décalage : DeepSeek V4 Flash portait 39 % du volume routé, mais seulement 3 % des dépenses, tandis que les 20 % de volume d’Anthropic représentaient 55 %
- Percy Liang de Stanford présente la même distorsion côté infrastructure : entraînement ponctuel, inférence quotidienne, et selon son estimation l’API OpenAI régénère le volume de tokens d’un entraînement de taille GPT-4 en moins de quatre jours
- Tuhin Srivastava de Baseten disait en juin 2026 qu’environ 90 à 95 % des dépenses d’inférence allaient encore aux modèles de pointe, avec un usage allant vers l’inférence agentique exigeante en calcul
- Un budget construit sur la grille d’un seul fournisseur est fragile par construction. La sixième partie couvre la dépendance à un fournisseur unique
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.