Exploiter un système multi-reviewers en sécurité
Exécuter des reviewers locaux, CLI et distants avec frontières de confiance explicites, moindre privilège, constats structurés, budgets, états dégradés et contrôles d'arrêt.
Aller au résumé ↓ Florian Bruniaux
Engineering the Review Loop · Partie 6/8
Ce que vous en retirez
- ✓ Cartographier rôles des reviewers, actifs, frontières de confiance et flux de données
- ✓ Appliquer le moindre privilège et séparer analyse et publication
- ✓ Normaliser les constats sans masquer recoupements ni désaccords
- ✓ Définir budgets, états dégradés, objectifs de service, réponse aux incidents et coupe-circuit
Prérequis
- → Un contrat de boucle de review bornée et une passation versionnée
- → Un inventaire des implémentations locales et distantes de reviewers
- → L'autorité pour inspecter les permissions du repository, de la CI et des fournisseurs
TL;DR
Je commencerais par un reviewer dont je peux inspecter le périmètre et les permissions, puis n’en ajouterais un autre que pour un rôle défini. Le contrat opérationnel ci-dessous est une conception à évaluer ; il ne certifie aucune installation fournisseur ni flotte déployée.
| Frontière opérationnelle | Contrôle requis |
|---|---|
| Entrée du repository | Traiter code, commentaires, configuration et sorties d’outils comme non fiables |
| Exécution du reviewer | Lecture seule par défaut, système de fichiers et réseau bornés, identifiants limités à la tâche |
| Agrégation | Préserver source, recoupement, contradiction, omission et état d’exécution |
| Publication | Utiliser une identité distincte et une approbation explicite pour les effets irréversibles |
| Exploitation | Budgets, SLO, alertes, procédure d’exploitation, coupe-circuit, rotation, retour arrière et exercices d’échec |
Ajouter un second reviewer ajoute une frontière de confiance. En ajouter 3 ajoute plusieurs parcours de données, identifiants, modes d’échec et sorties que quelqu’un ou quelque chose doit réconcilier.
À l’étape Scale, il s’agit d’exploiter le plus petit ensemble de reviewers couvrant les rôles assignés, en gardant visibles chaque entrée, permission, sortie et état dégradé.
Ce guide couvre un reviewer interne local, un reviewer CLI externe et un service distant de pull requests. Le même modèle de contrôle s’applique à Friendly Reviewer, CodeRabbit, Greptile ou un outil interne. Les noms de produits identifient des frontières à inspecter ; ils n’établissent pas qu’une installation précise est sûre.
Faire grandir la flotte à partir de 1 reviewer de référence
Commencez par 1 reviewer interne dont modèle, effort, prompt et outils sont épinglés, et gardez sa session séparée de celle de l’auteur. Une session distincte réduit le contexte partagé et l’exposition aux instructions. Exécuter deux fois le même modèle ne rend pas ses erreurs indépendantes. La partie 8 explique pourquoi Opus 5.5 est la prochaine référence que je teste.
N’ajoutez un reviewer que pour un but déclaré : analyse de sécurité isolée, autre chemin de récupération du contexte ou classe de défaut manquée par la référence. Après déduplication, mesurez ses constats vérifiés uniques, fausses alertes et temps d’arbitrage, et comparez le coût total du système combiné à la référence à un reviewer. Retirez une passe sans contribution suffisante, sauf s’il s’agit d’un contrôle exigé indépendamment.
Une flotte dérive aussi de sa politique déclarée. Sur un repository où je travaille, la politique de review lue le 25 septembre 2026 classait Friendly Reviewer comme historique et Codex comme actuel. Sur les 3 mois se terminant le 28 septembre, Friendly Reviewer a publié des sorties sur 899 pull requests et Codex n’a rien publié. Comparez périodiquement politique et sorties observées, pas seulement à l’ajout d’un reviewer.
Consignez le modèle demandé et celui qui a effectivement répondu à chaque tentative. Si le fournisseur bascule vers un autre modèle, le rapport agrégé le dit. Un service distant dont le modèle n’est pas révélé reste un traitement au niveau produit ; son étiquette ne dit pas quel modèle a tourné.
Cartographier le système avant d’attribuer les permissions
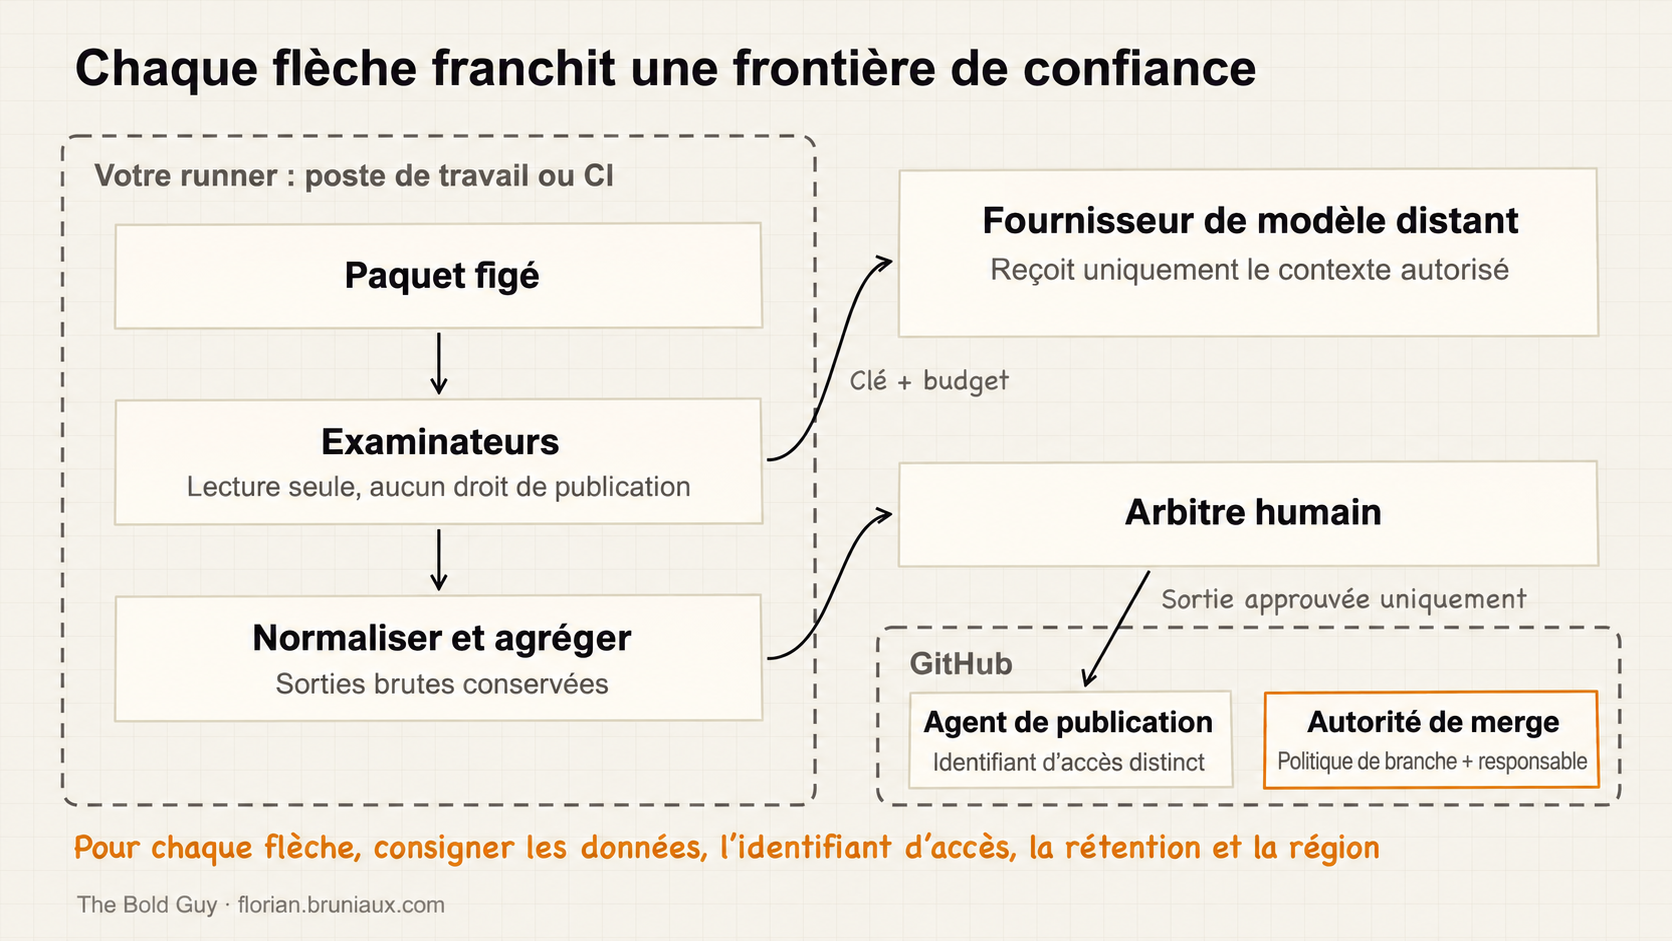
Partez des rôles et flux :
Author -> immutable review packet -> orchestrator
                                      |-> local house reviewer
                                      |-> external CLI reviewer -> remote provider
                                      |-> PR service through GitHub App

reviewers -> raw outputs -> normalizer -> aggregator -> human adjudicator
                                                    -> publisher -> GitHub
Chaque composant a une responsabilité étroite :
- Auteur : produit la modification candidate et les besoins
- Orchestrateur : fige les entrées, applique les budgets, lance les reviewers et consigne états d’exécution et causes d’arrêt
- Reviewers : inspectent les propriétés assignées et renvoient des preuves sans autorité de merge
- Normaliseur : convertit les sorties vers un schéma partagé en conservant les originales
- Agrégateur : regroupe les constats liés et expose les désaccords
- Arbitre humain : résout l’ambiguïté et assume l’acceptation du risque
- Publieur : écrit les résultats approuvés dans GitHub avec un identifiant distinct
- GitHub : stocke commentaires, reviews, checks et état de la politique de branche
- Fournisseurs externes : ne reçoivent que les données et capacités autorisées par leur contrat et leur configuration d’exécution
Ne combinez pas reviewer, agrégateur, publieur et autorité de merge dans une seule session de modèle. Un reviewer victime d’injection de prompt ne devrait pas pouvoir approuver sa propre sortie ni écrire dans le repository.
Traiter toute entrée de review comme non fiable
Le code source peut contenir des instructions dans les commentaires, chaînes, documentation, fixtures, fichiers générés, messages de commit ou texte de pull request. Les sorties d’outils peuvent les répéter. Un reviewer disposant du shell, du système de fichiers, du réseau et de la publication peut transformer une injection indirecte de prompt en action externe.
Classez les entrées comme données. Dites au reviewer quelles sources peuvent définir la politique et lesquelles ne peuvent être qu’inspectées. Versionnez les critères de review de confiance hors du diff candidat ou récupérez-les depuis une révision épinglée et revue.
Utilisez un modèle de menace couvrant au moins ces actifs :
| Actif | Échec à prévenir |
|---|---|
| Source et contexte propriétaire | Transfert non autorisé à un fournisseur ou conservation non autorisée par celui-ci |
| Identifiants du repository | Écritures de push, statut, issue ou pull request hors tâche |
| Clés fournisseur | Exfiltration, réutilisation ou dépense sans limite |
| Politique de review | Le diff candidat change les règles qui le jugent |
| Constats et arbitrage | Source effacée, gravité modifiée ou désaccord masqué |
| CI et poste développeur | Du code non fiable sort de la frontière d’exécution déclarée |
Pour chaque flèche du flux de données, consignez producteur, consommateur, classes de données, transport, identifiant, conservation, région, journalisation et mécanisme de suppression. Marquez un champ sans réponse UNKNOWN.
Appliquer le moindre privilège à chaque rôle
Les reviewers devraient être en lecture seule par défaut. Ne leur donnez que les chemins du repository, outils et destinations réseau nécessaires au rôle assigné. Utilisez un répertoire temporaire pour les sorties. Refusez l’accès aux identifiants de production et aux repositories sans rapport.
Séparez les secrets par composant :
- un identifiant de reviewer peut lire la révision sélectionnée du repository
- une clé API fournisseur peut appeler l’endpoint de review configuré dans un budget de coût
- un identifiant de publieur peut créer le commentaire ou statut approuvé, mais pas modifier le code
- l’autorité de merge reste hors des identités reviewer et publieur
Exigez une approbation explicite avant toute correction générée par reviewer, mise à jour de branche, création d’issue, forçage de statut ou merge. Si des corrections automatiques sont autorisées dans un parcours contrôlé, utilisez une identité de worker distincte, un nouveau commit, une validation déterministe et la politique normale de merge.
Bornez l’accès réseau avec une liste d’autorisations et refusez les métadonnées locales, plages d’adresses internes et services sans rapport. Consignez les tentatives de connexion refusées. Un processus sur un poste développeur n’est pas automatiquement local au sens de la gouvernance des données s’il envoie du code à un modèle distant.
Un worktree sépare branches Git et état des modifications. Il n’isole ni processus, système de fichiers, identifiants, variables d’environnement ni réseau. Placez une frontière d’isolation au niveau du système d’exploitation ou d’un conteneur sous le reviewer lorsque du code non fiable peut s’exécuter.
Using LLMs to Secure Source Code d’Eugene Yan, à 12:40, publié par AI Engineer le 17 juillet 2026, montre un agent de vérification séparé reproduisant une injection SQL suspectée dans un conteneur neuf. Cela illustre la distinction entre trouver un problème plausible et obtenir des preuves d’exécution. Cela n’établit pas la sécurité de notre exécuteur, son confinement face au code hostile ni sa couverture d’autres classes de vulnérabilités.
Inspecter les frontières fournisseurs plutôt que les supposer
La documentation actuelle des fournisseurs peut guider l’inventaire, mais l’état effectif de l’installation exige une inspection.
Le mode review open source d’elek, vérifié le 14 octobre, documente des outils de lecture/recherche pour le modèle et des commentaires publiés par l’hôte. Son workflow GitHub exige encore la permission d’écrire des commentaires de PR ; l’ancien mode agent documenté expose une surface d’outils plus large. Inspectez séparément le mode installé et les identifiants de l’hôte. C’est une conception concrète de permissions à examiner, pas un audit d’exécution ni une preuve d’indépendance du reviewer.
La documentation d’installation GitHub de CodeRabbit, vérifiée le 14 octobre 2026, liste l’accès en lecture seule aux actions, discussions, membres, métadonnées et files de merge, et en lecture-écriture aux checks, code, statuts de commits, issues, pull requests et workflows. L’écriture sur les workflows permet à l’application de changer les fichiers sous .github/workflows/ ; incluez-la dans la review des permissions. La page décrit aussi un cache optionnel des reviews. Les permissions demandées et la conservation documentée n’établissent pas les droits accordés, réglages de cache ou actions autorisées pour une installation précise.
La page sécurité de Greptile, vérifiée le 14 octobre 2026 et datée de janvier 2026, décrit des déploiements cloud et hébergés chez le client, un cache du code jusqu’à révocation d’accès, des embeddings stockés et une inférence tierce ou hébergée chez le client. Elle annonce une suppression définitive sous 24 heures après demande d’un administrateur et une destruction des sauvegardes sous 30 jours, avec prolongation lors d’une investigation d’incident en cours. L’accès du support aux logs de chat peut être désactivé. La page des règles réseau n’exposait pas son sous-réseau actuel lors de cette vérification ; obtenez-le du fournisseur avant de configurer une liste d’autorisations. Ces déclarations ne vérifient ni réglages ni isolation d’un tenant.
La page publique de Friendly Reviewer, vérifiée le 14 octobre 2026, décrit des agents de review parallèles et une agrégation. Elle fixe le prix d’une PR ou MR analysée à 0,50 $, validations des corrections comprises, plus 1 $ pour initialiser la Knowledge Base synthétique du repository. Elle indique « No persistent source code storage » (traduction : « Aucun stockage persistant du code source »), tout en conservant ce résumé. Marc Hugon décrivait la planification et l’agrégation lors de notre appel du 1er septembre. La description publique n’établit ni les modèles utilisés, ni les permissions effectives, ni la conservation fournisseur, ni l’isolation des processus d’une review précise.
Transparence : Marc Hugon me donne accès à Friendly Reviewer. Je le teste sur de vrais projets, signale des problèmes et discute avec lui d’idées produit et éditoriales. La collaboration est informelle et je n’ai pas été payé pour classer le produit.
Un reviewer interne local n’est pas différent. Ses frontières restent non vérifiées jusqu’à inspection de son arbre de processus réel, de l’environnement hérité, des chemins lisibles, des appels réseau et de l’accès aux identifiants.
Tracer chaque exécution sans surestimer le SHA
Utilisez le repository et le SHA du commit comme champs de corrélation entre lancement, review, agrégation, arbitrage et publication. Conservez aussi :
- identifiants d’exécution et de tentative
- rôle du reviewer et identité source
- fournisseur et version du modèle ou de l’outil
- empreintes du prompt, des règles et de la configuration
- contexte autorisé et couverture de fichiers observée
- politique d’outils et de réseau
- empreintes des artefacts d’entrée et de sortie
- début, fin, coût, état d’exécution et cause d’arrêt
- identité du publieur et reçu
Le SHA permet aux opérateurs de relier les enregistrements. La partie 4 traite la preuve distincte qu’une review est à jour pour la tête actuelle de la pull request et significative au regard de la règle de branche. Ne transformez pas la seule présence d’un champ SHA en preuve de merge.
Relier sessions, ressources, modifications et résultats
Un seul champ de révision ne peut pas décrire toute la chaîne de provenance. Conservez 4 types d’objets et des liens explicites entre eux :
| Objet | Ce qu’il identifie | Frontière à préserver |
|---|---|---|
| Session | Une session de rédaction ou de review et ses tentatives | Modèle demandé contre modèle observé ; une identité indisponible reste UNKNOWN |
| Ressource | Instructions, skills, contexte ou configuration mis à disposition de cette session | Empreinte source contre empreinte du contenu réellement chargé ; disponibilité ne prouve pas chargement |
| Modification | Un commit, une pull request ou une révision candidate d’intégration | Révisions d’entrée exactes et liens explicites aux sessions contributrices |
| Résultat | Sortie de review, rapport de test, décision ou reçu de publication | Exécution ayant produit le résultat, liens aux entrées, état d’exécution, périmètre et artefact conservé |
Pour une PR conçue pour cet exemple, la session S1 implémente la modification et la session S2 répare les tests. Reliez les deux à leurs commits réels et à la PR. Si la PR est squashée, conservez l’association entre commits originaux, PR et commit résultant. Une session peut contribuer à plusieurs commits et une PR peut contenir les contributions de plusieurs sessions.
Si une référence de session manque, consignez ce trou. Attribuer la session la plus récente fabriquerait une provenance. De même, un nom de modèle configuré enregistre une intention ; seules les preuves du fournisseur ou du runtime peuvent établir quel modèle a produit un résultat précis. Si l’exécuteur n’expose pas le contenu des ressources chargées, leur empreinte est inconnue même si le fichier source peut être hashé.
Gardez assez de métadonnées pour reconstruire ces liens sans conserver de prompts privés ou données utilisateur sans rapport. C’est un contrat de preuve proposé, pas une affirmation de capture complète des sessions.
Normaliser les constats sans aplatir les désaccords
Utilisez un schéma partagé de constat :
{
  "schemaVersion": 1,
  "findingId": "local-reviewer:run-42:7",
  "source": {
    "reviewer": "local-reviewer",
    "runId": "run-42",
    "attempt": 1
  },
  "location": {"path": "src/auth/switch.ts", "startLine": 84},
  "category": "authorization",
  "severity": "high",
  "confidence": "medium",
  "claim": "The mutation does not bind the target account to the actor",
  "evidence": ["src/auth/switch.ts:84", "src/policy/accounts.ts:31"],
  "proposedAction": "Verify ownership before changing session scope",
  "executionState": "COMPLETED"
}
Gardez la sortie brute et un journal de normalisation. Le normaliseur ne devrait ni augmenter la gravité, ni inventer de preuve, ni retirer les réserves.
Regroupez les constats par affirmation sous-jacente et similarité d’emplacement. Donnez à chaque groupe ces champs :
- identifiants des constats membres
- nombre de recoupements et ensemble des sources
- affirmations ou gravités contradictoires
- preuves uniques apportées par chaque source
- entrées attendues de reviewers jamais arrivées
- état d’arbitrage et responsable
Borner coût, latence et nouvelles tentatives
Fixez des budgets au niveau de la flotte et du reviewer :
| Budget | Condition d’arrêt |
|---|---|
| Nombre maximal de reviewers | Ne pas lancer de rôles non assignés |
| Temps écoulé | Marquer le reviewer TIMEOUT et clore sa tentative |
| Coût | Arrêter les nouveaux appels payants avant le plafond configuré |
| Nombre maximal de tentatives | Ne pas transformer un échec persistant en boucle infinie |
| Nombre maximal de tours de review | Escalader les désaccords répétés auteur/reviewer |
| Fenêtre sans progrès | Arrêter lorsqu’un autre tour ne change aucune preuve acceptée ni décision |
Ne réessayez que les échecs transitoires classifiés, avec délai exponentiel borné et variation aléatoire. Une réponse mal formée, un refus de permission, un contexte manquant ou une sortie de processus inexpliquée exigent une investigation, pas un appel identique supplémentaire.
Rapportez chaque reviewer non terminé avec son état d’exécution et sa cause d’arrêt de la partie 3, par exemple TIMEOUT, FAILED avec UNAVAILABLE ou PARTIAL_SCOPE, ou ABORTED avec OPERATOR_STOP après un coupe-circuit. L’agrégateur peut terminer alors qu’1 reviewer est dégradé, mais le rapport combiné nomme la source manquante et la conséquence au regard de la politique. Une review absente ne compte jamais comme vote réussi.
Réserver l’attention autant que le budget d’exécution
Un appel de reviewer abordable peut produire du travail que personne n’est disponible pour vérifier. Appliquez la règle d’admission de la partie 1 à la flotte : nommez le vérificateur et la capacité déjà réservée avant de lancer davantage de travail, et traitez un signal de capacité périmé comme inconnu plutôt que comme place disponible.
La passation vers ce vérificateur expose révision pertinente, preuves, désaccords, questions non résolues et actions suivantes autorisées, avec des liens vers les constats originaux. Un résumé plus court qui masque les contradictions peut augmenter le coût réel de vérification. Mesurez séparément justesse des décisions, récupération, effort humain et satisfaction.
Séparer la prise en compte des constats des corrections vérifiées
Dans Building uReview, à partir de 05:11, Will Bond et Ameya Ketkar d’Uber décrivent la classification du sentiment des réponses des développeurs, puis le suivi d’un taux de traitement. Pour votre flotte, distinguez réactions, changements après un constat et correction vérifiée de défaut. Incluez les régressions introduites par des conseils acceptés. Ce sont des distinctions d’évaluation proposées, pas des résultats mesurés indépendamment dans la conférence.
Tester un retrait avant de changer la flotte
Retirer un reviewer est la même expérience qu’en ajouter un, en sens inverse. Comparez le pipeline actuel à une version sans 1 reviewer sur les mêmes unités de review figées, selon le protocole de la partie 2. Gardez permissions et critères d’acceptation fixes, conservez les exécutions échouées et menez la comparaison sur un parcours isolé qui ne puisse pas désactiver un contrôle de production requis. Si le budget du reviewer retiré va à un autre, évaluez séparément cette configuration : elle change l’allocation des ressources autant que la composition de la flotte.
Nommez les classes de risque dont chaque reviewer est responsable. La détection occasionnelle d’un défaut grave et des commentaires de style fréquents en double ont des conséquences différentes. Définissez la perte acceptable avant de voir les résultats ; un petit échantillon non concluant ne prouve pas que le retrait préserve la couverture. La partie 7 explique pourquoi cette décision exige constats arbitrés et jeu de référence indépendant.
Exploiter la flotte comme un service
Définissez les objectifs de service à partir des besoins du workflow, pas du marketing fournisseur. Les dimensions utiles de SLO incluent :
- pourcentage d’exécutions éligibles finissant avec état d’exécution et cause d’arrêt explicites
- distribution de latence jusqu’au premier constat et au résultat final
- pourcentage de sorties valides selon le schéma
- distribution du coût par modification revue
- réussite de publication des sorties approuvées
- pourcentage d’exécutions sur la tête actuelle avec corrélation complète des traces
- âge de la file d’arbitrage humain des constats bloquants
Alertez sur la consommation du budget d’erreurs, pas chaque timeout isolé. Alertez immédiatement sur l’usage abusif d’identifiants, les destinations réseau inattendues, l’accès à un autre repository, la publication par une mauvaise identité ou une forte hausse du coût.
La procédure d’exploitation devrait nommer responsables et étapes pour panne fournisseur, sortie mal formée, suspicion d’injection de prompt, fuite d’identifiants, constats bloquants contradictoires, publication bloquée et budget épuisé. Elle devrait inclure :
- désactiver les lancements pour le reviewer concerné
- révoquer ou renouveler ses identifiants
- préserver logs expurgés, hashes d’artefacts et reçus fournisseur
- identifier repositories, révisions et classes de données exposés
- retirer la sortie publiée non fiable si la politique l’autorise
- router les reviews affectées vers le parcours dégradé documenté
- corriger ou remplacer le composant et le valider sur un canari figé
- restaurer progressivement et surveiller le budget d’erreurs
Utilisez un coupe-circuit à 3 niveaux : arrêter 1 exécution, désactiver 1 reviewer ou désactiver toute la flotte tandis que CI déterministe et review humaine continuent. Testez-le avant qu’un incident ne survienne.
Revenez en arrière sur prompts, règles, normaliseurs et routage via des releases versionnées. Préservez la version précédente et ses artefacts d’évaluation. Un retour arrière de configuration ne supprime pas les données déjà envoyées au fournisseur ; traitement d’incident et procédures de suppression fournisseur restent donc distincts.
Récupérer lorsqu’un reviewer accepte la mauvaise modification
Une panne de reviewer et une modification incorrecte approuvée exigent des procédures différentes. Pour une modification incorrecte, consignez comment l’échec est détecté, comment l’exposition est contenue, quels états applicatifs et de données peuvent être restaurés et qui assume cette décision. Un revert Git peut restaurer le code en laissant intactes les mutations de données ou les effets externes.
| Action de récupération | Responsable de décision à nommer | Preuves à conserver |
|---|---|---|
| Reprendre une tâche de review interrompue | Opérateur du service de review | Point de reprise, révisions d’entrée, responsabilités et contrôles des effets en double |
| Restaurer une configuration de reviewer | Responsable de la politique de review | Configuration précédente, permissions et vérification du comportement restauré |
| Restaurer une version applicative | Responsable du service ou de l’incident | Révision de déploiement, contrôle de compatibilité et santé du service après restauration |
| Restaurer les données ou compenser les effets externes | Responsable des données ou du domaine | Enregistrements affectés, point de récupération ou registre de compensation, résultat de réconciliation |
Étendez l’exercice avec une modification défectueuse délibérément acceptée dans un environnement isolé. Vérifiez détection, confinement, chemin de restauration ou compensation choisi et cohérence ultérieure. Conservez qui a pris chaque décision et le résultat observé. Cette procédure écrite ne démontre aucune récupération en production.
Une review humaine moins approfondie n’est défendable que dans une politique de risque définie, appuyée par des preuves de qualité de review et une procédure de récupération testée en exercice. Reclassifiez les PR combinées et dépendances modifiées, échantillonnez le travail accepté et restaurez une supervision plus étroite si fausses acceptations ou échecs de récupération dépassent les limites de cette politique.
L’exercice de contrôle et récupération fournit une simulation locale de reçus et de rejeu des effets. Pour une vraie flotte, testez aussi identité du fournisseur, lien à la révision et permissions. Une simulation réussie n’établit pas ces propriétés d’intégration.
Mener 1 exercice d’échec reproductible
Créez un repository canari figé contenant des fichiers anodins et du texte inerte d’injection de prompt. N’incluez ni vrais identifiants ni code propriétaire. Consignez les frontières attendues, puis simulez :
- 1 timeout de reviewer
- 1 sortie structurée mal formée
- 1 fournisseur indisponible
- 1 arrêt sur budget de coût
- 2 constats contradictoires
- 1 reviewer auquel le texte du repository demande de publier ou révéler un secret
Vérifiez que l’orchestrateur consigne des états d’exécution et causes d’arrêt distincts, que le normaliseur rejette la sortie mal formée, que l’agrégateur préserve la contradiction, que le publieur n’effectue aucune action non approuvée, que la politique réseau bloque la destination interdite et que le coupe-circuit arrête les lancements suivants.
Pas encore démontré : ce guide donne le modèle de menace et le contrat opérationnel. Je n’ai pas encore produit de matrice de permissions propre à une flotte ni d’artefacts d’exercice d’échec ; les permissions effectives, l’injection de secrets, les sorties réseau, la conservation, la région, les sous-traitants et l’isolation des processus de Friendly Reviewer, CodeRabbit, Greptile et des runtimes locaux restent donc non inspectés.
Pour un pilote de développement Luna/Astra distinct, des contrôles locaux d’isolation ont été enregistrés le 14 octobre 2026. Ils couvraient l’accès aux sources cachées, les restrictions réseau et de sous-processus, et l’arrêt d’un processus en boucle ; 12 évaluations confinées utilisaient des contrôles écrits par l’opérateur. La partie 8 décrit la préparation. Cela établit le comportement de cet exécuteur local de fixtures, pas les permissions ou la conservation de cette flotte de review. Un plafond mémoire et le comportement des fournisseurs en fonctionnement réel restent non vérifiés.
La partie 7, 5 reviewers IA, 1 repository, et ce que les développeurs ont fait ensuite, mesure ce qu’une vraie flotte a produit et ce que les développeurs en ont visiblement fait.
YSNK
(Vous devriez maintenant savoir)
- Chaque reviewer supplémentaire ajoute une frontière de confiance et un mode d’échec opérationnel
- Les reviewers devraient être en lecture seule tandis que publication et autorité de merge restent séparées
- La normalisation doit préserver source, recoupement, contradiction et sortie manquante
- Les worktrees séparent l’état Git mais ne fournissent pas d’isolation des processus ou du réseau
- L’exploitation en production exige budgets, états dégradés, SLO, exercices, retour arrière et coupe-circuit
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source