5 reviewers de code IA, 1 repository, et ce que les développeurs ont fait ensuite
Trois mois, 1 011 pull requests et 8 728 commentaires inline de review IA : 4,5 % ont reçu une réponse humaine visible. Ce que montrent les données et ce qu’elles ne peuvent pas dire.
Aller au résumé ↓ Florian Bruniaux
Engineering the Review Loop · Partie 7/8
TL;DR
Je vois une question d’engagement dans cet export, pas un classement de modèles. Avant de payer un autre réviseur, je vérifierais qui lit les constats et ce qu’ils modifient, en gardant les corrections silencieuses et la qualité non résolue en dehors des compteurs que je peux observer.
| Question | Ce que 3 mois de données montrent |
|---|---|
| Combien de réviseurs IA ont tourné sur le même code ? | 5 ont produit du contenu de review. Sur 506 des 1 011 pull requests, au moins 2 d’entre eux ont signalé un constat |
| Quelle part de leur sortie était un constat ? | Loin de la totalité : la plupart des commentaires de Friendly Reviewer étaient des notifications de statut, et le corps de chaque review Greptile était vide ou contenait une notification liée à la période d’essai |
| Qu’ont fait les développeurs des commentaires inline ? | 392 des 8 728 (4,5 %) ont reçu une réponse ou une résolution du fil par une personne |
| « resolved » (traduction : « résolu ») signifie-t-il que quelqu’un a agi ? | Pas ici : 3 746 des 3 946 fils résolus de CodeRabbit ont été résolus par CodeRabbit lui-même |
| Quel réviseur trouve le plus de défauts réels ? | Inconnu : aucun commentaire dans cet ensemble de données n’a encore été jugé par rapport au code |
Entre le 28 juin et le 28 septembre 2026, un repository d’application en prod sur lequel je travaille a reçu des commentaires de revue de 5 réviseurs IA sur les mêmes pull requests. J’ai exporté tout ce qu’ils ont posté via l’API GitHub et j’ai compté ce qui s’est passé ensuite.
Le résultat principal est inconfortable. Sur 8 728 commentaires de revue inline, 392 ont reçu une réponse d’une personne ou une résolution de fil par une personne. Les 95,5 % restants ne montrent aucune réponse humaine visible. Certains ont probablement été corrigés silencieusement, et d’autres étaient probablement erronés, mais l’export seul ne permet pas de dire lesquels.
Cette partie rapporte l’export historique du repository à la place du benchmark de réviseurs initialement prévu pour la série. Un corpus figé avec un ensemble de référence indépendant reste la bonne façon de classer les réviseurs, et la dernière section explique ce que cela nécessiterait. Un pilote de développement Luna/Astra distinct est maintenant préparé sans appels à des modèles, comme l’explique la mise à jour de préparation du 14 octobre dans la partie 8. Il n’ajoute aucune nouvelle observation à cet export. Ce qui suit est plus restreint : ce que les réviseurs ont produit, à quelle vitesse, et ce que l’équipe en a visiblement fait.
Le dataset et ses limites
J’ai exporté les données le 28 septembre 2026, entre 06:20 et 07:45 UTC, avec des appels en lecture seule à l’API GitHub. La fenêtre couvre les 1 011 pull requests créées du 28 juin au 28 septembre inclus, et les sorties créées dans la même fenêtre. Les scripts, le manifeste SHA-256 par fichier, et les exports bruts restent privés, car le texte des commentaires peut contenir des données personnelles. Cet article publie uniquement des agrégats.
Quatre limites s’appliquent à chaque chiffre ci-dessous :
- 1 repository, 1 équipe. Rien ici ne se généralise à d’autres bases de code ou cultures de revue.
- Configurations changeantes. Le 25 septembre, le workflow de revue Claude exécutait
claude-opus-4-8avec un niveau d’efforthigh, et le fichier du workflow a changé dans 14 commits pendant la fenêtre. Greptile a cessé de poster le 4 août, quand son essai a pris fin, et Copilot le 16 juillet. Les réviseurs n’ont pas vu les mêmes pull requests pendant la même période. - État instantané. La résolution des fils et les réactions reflètent le moment de l’export, pas le moment de la revue, et le dernier jour est partiel.
- Actions visibles uniquement. Un développeur qui corrige un problème sans répondre ou résoudre le fil ne laisse aucune trace dans ces compteurs.
C’est une fenêtre historique fermée, conservée telle qu’exportée. La publication du 14 octobre ne rafraîchit pas les compteurs ni ne décrit la configuration actuelle des réviseurs du repository.
Déclaration d’intérêts : Marc Hugon me donne accès à Friendly Reviewer. Je le teste sur des projets réels, je signale des problèmes, et je discute d’idées produit et éditoriales avec lui. La collaboration est informelle, et je n’ai pas été payé pour classer le produit.
5 réviseurs, dont plusieurs interviennent sur la moitié des pull requests
7 comptes de bots sont apparus sur le repository. 5 ont produit une sortie de revue : Claude via un workflow GitHub Actions, CodeRabbit, Friendly Reviewer et Greptile via leurs GitHub Apps, et Copilot via l’intégration native de GitHub. Codex était configuré mais n’a rien posté, et Cursor Bugbot n’a posté que des avis « not enabled » (traduction : « non activé ») sur 13 pull requests.
| Réviseur | Pull requests avec au moins 1 constat | Période active dans la fenêtre |
|---|---|---|
| Friendly Reviewer | 539 | 29 juin au 28 septembre |
| CodeRabbit | 531 | 29 juin au 28 septembre |
| Claude | 336 | 29 juin au 28 septembre |
| Greptile | 136 | 28 juin au 4 août |
| Copilot | 52 | 29 juin au 16 juillet |
Sur 506 des 1 011 pull requests, au moins 2 réviseurs ont signalé un constat. Sur 277, au moins 3 l’ont fait, et sur 66, au moins 4. Aucun rôle distinct n’avait été attribué aux réviseurs. La politique de revue du repository classait chacun uniquement comme courant, optionnel, canary ou historique.
La plupart des sorties n’étaient pas un constat
Compter les commentaires surestime ce que les réviseurs ont dit. J’ai classé chaque sortie avec une règle écrite pour le format de chaque réviseur, comme un tableau de sévérité avec au moins 1 entrée ou un nombre de commentaires actionnables d’au moins 1. Tout le reste compte comme un résumé, un avis de statut, ou un support vide pour les commentaires inline.
- Friendly Reviewer : 1 078 de ses 4 380 commentaires contenaient un constat. 3 055 étaient des avis de statut comme « Started » (traduction : « Démarré »), « Aborted » (traduction : « Abandonné ») ou « Complete » (traduction : « Terminé »), car le service poste un accusé de réception puis le modifie.
- Claude : 917 de ses 2 374 revues formelles contenaient un constat ; 1 031 disaient qu’il n’y avait rien à signaler et 400 ne portaient que des commentaires inline.
- CodeRabbit : 1 376 des 1 573 revues formelles ont signalé des commentaires actionnables ou nitpick, et ses 1 025 commentaires généraux étaient des résumés de type walkthrough et des notifications.
- Greptile : aucune de ses 149 revues formelles ne portait un constat dans le corps, car 136 étaient des supports vides et 13 disaient que l’essai avait pris fin. Ses constats se trouvent dans 248 commentaires inline.
Un lecteur qui parcourt une pull request voit tout cela comme une activité de review. Un développeur qui a appris que la plupart des commentaires de bots sont des notifications a une raison de ne plus les lire.
Ce que les développeurs ont visiblement fait
Les commentaires inline sont la seule sortie pour laquelle on peut compter une réponse par constat, à travers les réponses et la résolution des fils. Friendly Reviewer publie des commentaires généraux sans fils et n’entre donc pas dans cette mesure.
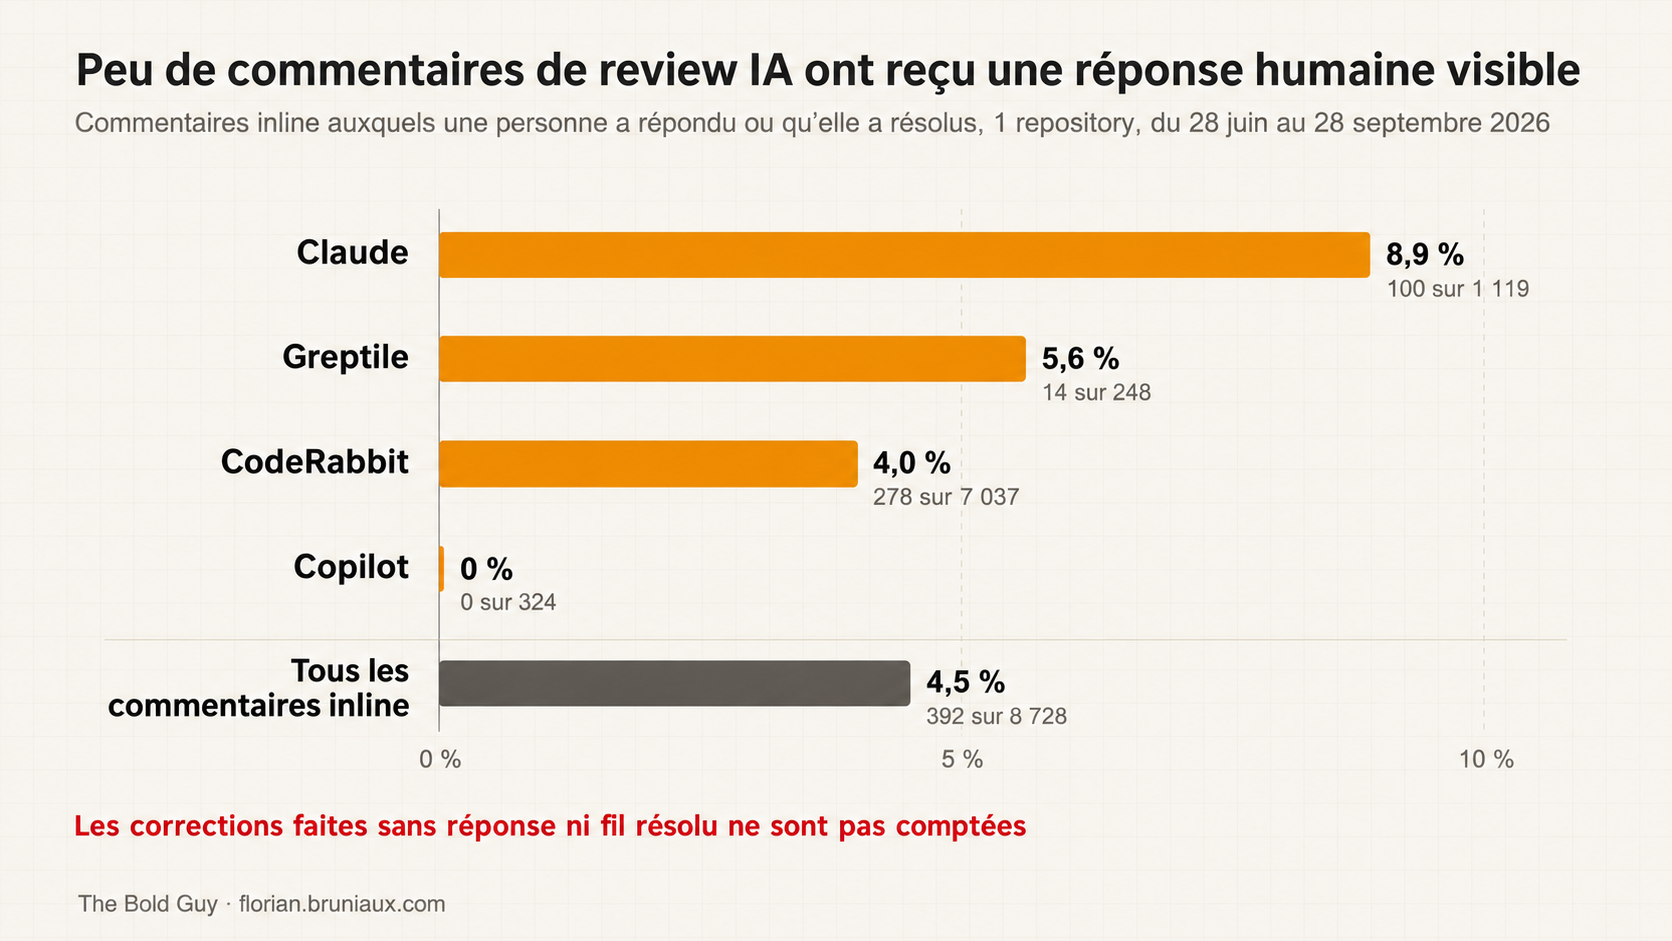
| Reviewer | Commentaires inline | Réponse humaine | Résolu par une personne | L’un ou l’autre |
|---|---|---|---|---|
| Claude | 1 119 | 63 (5,6 %) | 98 (8,8 %) | 100 (8,9 %) |
| CodeRabbit | 7 037 | 142 (2,0 %) | 182 (2,6 %) | 278 (4,0 %) |
| Greptile | 248 | 2 (0,8 %) | 13 (5,2 %) | 14 (5,6 %) |
| Copilot | 324 | 0 (0 %) | 0 (0 %) | 0 (0 %) |
| Tous | 8 728 | 207 (2,4 %) | 293 (3,4 %) | 392 (4,5 %) |
Les réactions vont dans le même sens. Sur 17 443 commentaires inline et généraux de tous les bots, 8 ont reçu une réaction, et aucun n’a reçu de pouce levé ou baissé.
Environ 40 % des fils de Claude, CodeRabbit et Greptile sont devenus obsolètes, ce qui signifie que le code à cet emplacement a changé ensuite. C’est compatible avec une correction, tout autant qu’avec une modification sans rapport : cela ne compte donc pas comme une réponse.
Un fil résolu n’est pas une décision humaine
Le retour d’Uber sur uReview du 12 août 2025 utilise d’autres définitions : des notes d’utilité données par les ingénieurs qui interagissent, et un taux de traitement automatisé obtenu en relançant le reviewer 5 fois sur le dernier commit. Un commentaire compte comme traité si aucune relance ne reproduit un problème similaire. C’est un indicateur indirect fondé sur un modèle, pas une confirmation indépendante d’une correction valide, et aucune de ces deux mesures n’a le dénominateur de notre taux de réponse visible. Uber décrit aussi le filtrage des catégories peu utiles et des doublons avant publication. Ces comparaisons opérationnelles sont utiles, mais ses gains déclarés et cet export ne permettent pas d’établir un classement comme si les deux mesuraient la détection de défauts.
La première version de cette analyse indiquait que 56,1 % des fils de CodeRabbit étaient résolus, contre 8,8 % pour Claude. Cette comparaison aurait fait paraître CodeRabbit 6 fois plus suivi d’action, « acted on » dans la formulation originale. Vérifier qui avait résolu chaque fil a changé le tableau :
| Reviewer | Fils résolus | Par une personne | Par le reviewer lui-même | Par un autre bot |
|---|---|---|---|---|
| CodeRabbit | 3 946 | 182 | 3 746 | 18 |
| Claude | 98 | 98 | 0 | 0 |
| Greptile | 18 | 13 | 0 | 5 |
| Copilot | 16 | 0 | 16 | 0 |
CodeRabbit et Copilot résolvent leurs propres fils, selon des règles que je n’ai pas examinées. Quelles que soient ces règles, un fil autorésolu consigne le jugement du reviewer, pas celui d’un développeur. Tout tableau de bord qui compare les « resolved threads » (traduction : « fils résolus ») entre reviewers doit afficher l’identité de celui qui résout à côté du total.
Temps de réponse dans l’export
La latence est la seule dimension sur laquelle les reviewers se ressemblaient. Je l’ai mesurée depuis chaque push, identifié par la première exécution du workflow de review pour une pull request et un commit, jusqu’à la première sortie substantielle du reviewer, sur 4 110 pushs concernant 964 pull requests.
| Reviewer | Pushs avec une sortie | Médiane | 90e percentile |
|---|---|---|---|
| Copilot | 102 | 4 min 04 s | 6 min 47 s |
| CodeRabbit | 1 818 | 4 min 18 s | 13 min 54 s |
| Claude | 2 261 | 5 min 11 s | 25 min 31 s |
| Greptile | 123 | 5 min 16 s | 47 min 21 s |
La latence de Friendly Reviewer reste entre 2 bornes. Son accusé de réception apparaît après un délai médian de 5 min 58 s. La modification qui contient la review porte un horodatage de dernière mise à jour, avec un délai médian de 25 min 01 s. Cet horodatage peut aussi refléter des modifications ultérieures. Ces horodatages décrivent les délais de réponse, sans expliquer causalement les taux d’engagement. Tester si le délai influe sur l’engagement demanderait de relier chaque constat au moment où il est devenu disponible, à l’activité ultérieure de la PR et à la réponse du développeur.
Ce que ces données ne permettent pas de dire
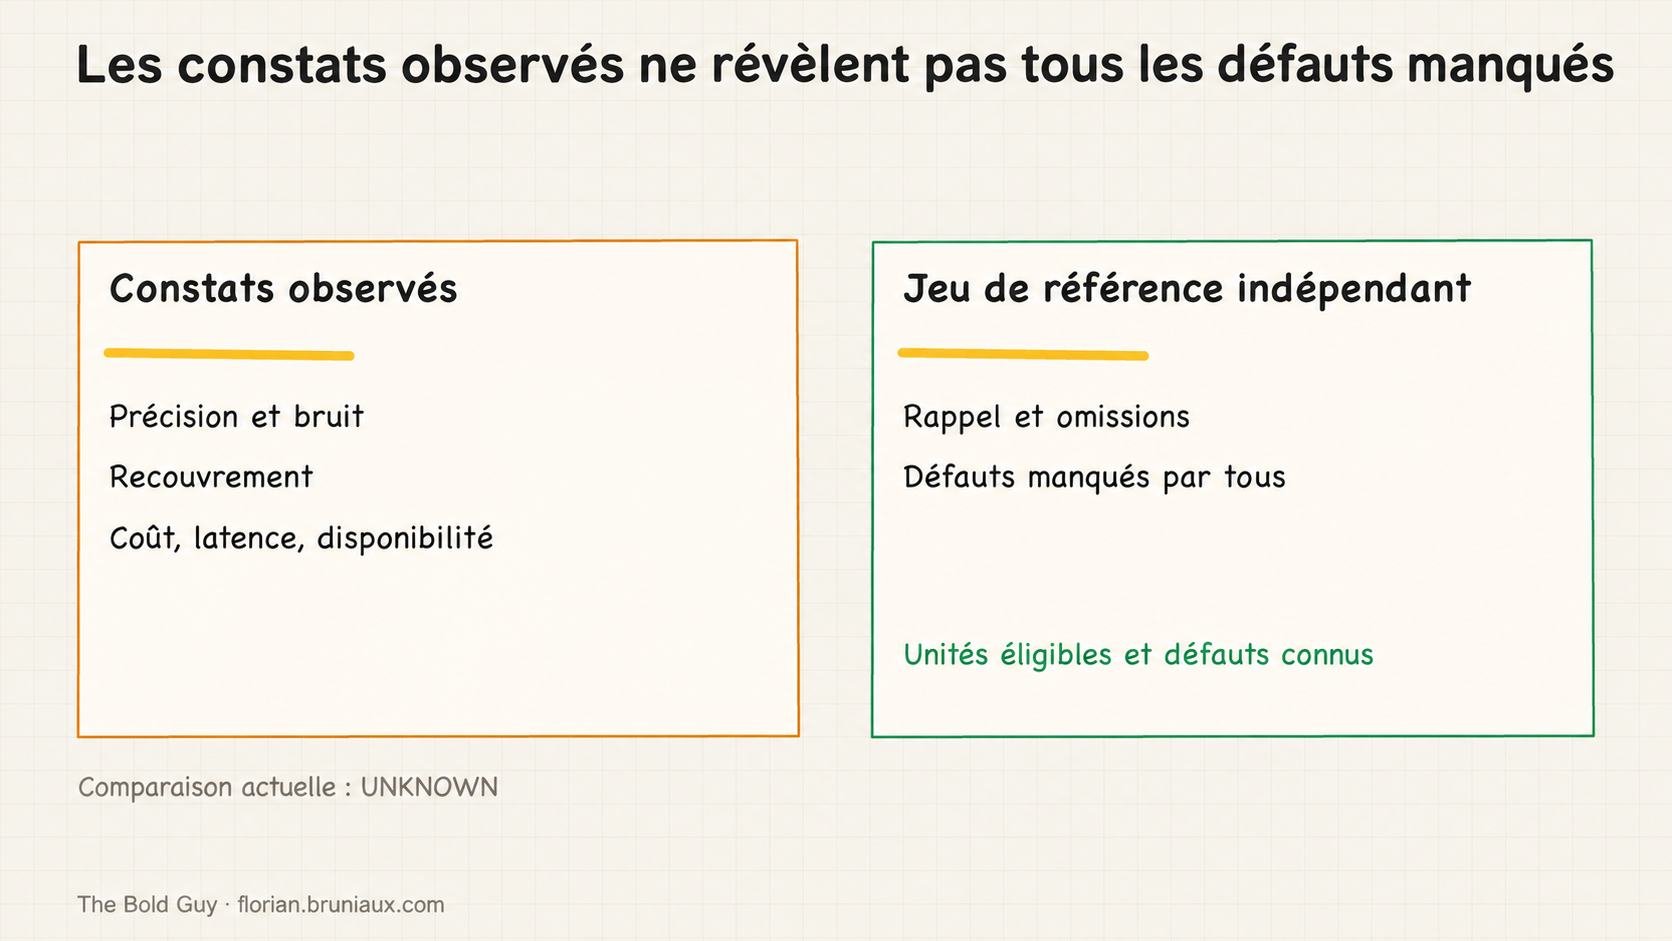
Elles ne permettent pas de classer les reviewers sur leur qualité. Un faible taux de réponse peut signifier que les commentaires étaient faux, triviaux ou déjà couverts par un autre reviewer, ou que les développeurs ont corrigé les problèmes sans le dire. Les décomptes ne distinguent pas ces cas.
Elles ne donnent pas le rappel. La branche principale ne comporte aucun commit de revert dans la période, et aucun dossier d’incident trouvé dans le repository ne relie un défaut de production à un commentaire de reviewer. Sans référence de ce type, les défauts manqués par tous restent invisibles.
Elles ne donnent pas le coût par reviewer. Les abonnements sont facturés par siège ou par mois, et les runners CI sont partagés avec tous les autres jobs : les données disponibles ne permettent donc pas d’isoler le coût d’un reviewer.
Ce qu’ajouterait une comparaison de qualité
Le plus petit pas vers la qualité est l’arbitrage des constats. Pour les 10 pull requests où 3 ou 4 reviewers étaient actifs en même temps, l’export recense 320 sorties comportant un constat. Évaluer chacune comme vraie, fausse, non exploitable ou doublon, sans connaître le nom du reviewer, permettrait de mesurer la précision et le recouvrement sur un petit échantillon. Cela ne donnerait toujours pas le rappel.
Le rappel nécessite un jeu de référence construit avant de lire les sorties des reviewers : défauts trouvés par une review humaine exhaustive, défauts reconstitués à partir de corrections ultérieures et défauts injectés avec un oracle exécutable. ReviewBench de LangChain et c-CRAB montrent 2 façons de construire cette référence ; tous deux montrent aussi le travail de curation nécessaire. Lorsqu’un reviewer trouve un défaut réel absent de la référence, celle-ci reçoit une nouvelle version, et les anciens résultats ne sont jamais recalculés silencieusement.
D’ici là, le résultat exploitable est opérationnel. Avant d’ajouter un reviewer, vérifiez si quelqu’un lit les sorties de vos reviewers actuels. La partie 6 montre que la politique de review du même repository classait un reviewer comme historique alors qu’il était le plus actif, et la partie 8 commence l’évaluation suivante avec 1 reviewer au lieu de 5.
L’étude WirelessCar d’Aðalsteinsson et ses collègues, soumise le 22 mai 2025, pose une autre question. Dix participants ont évalué des assistants de review proactifs et à la demande, avec des entretiens qualitatifs sur la confiance, le contexte et l’interaction préférée. Elle apporte des éléments sur les préférences de workflow dans cette organisation, plutôt qu’une mesure comparative du rappel ou de la vitesse de livraison. Un prolongement de cet export devrait recueillir directement ces raisons au lieu d’interpréter le silence comme une approbation ou un rejet.
YSNK
(Ce que vous devriez maintenant savoir)
- Sur ce repository, 392 des 8 728 commentaires inline de review IA (4,5 %) ont reçu une réponse humaine visible
- Les notifications de statut et les résumés formaient une grande part des sorties des reviewers : les décomptes bruts surestiment donc les constats
- Un fil résolu doit être associé à son auteur de résolution : CodeRabbit a résolu lui-même la plupart de ses fils
- Les délais de réponse sont observables, mais leur effet sur l’engagement humain reste non mesuré
- Classer les reviewers sur leur qualité nécessite encore des constats arbitrés et un jeu de référence indépendant
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.