Concevoir une boucle de review bornée
Construisez une boucle de review bornée avec entrées figées, champs d’exécution et de résultat séparés, limites de tentatives, transmission de preuves et escalade humaine.
Aller au résumé ↓ Florian Bruniaux
Engineering the Review Loop · Partie 3/8
Ce que vous en retirez
- ✓ Définir les entrées de review, états d’exécution, résultats et causes d’arrêt
- ✓ Borner les cycles de correction par des politiques de tentatives, progression, coût et durée
- ✓ Émettre une transmission versionnée validable par la CI sans en faire une preuve de merge
- ✓ Tester les parcours d’échec, timeout, sortie mal formée et état inconnu
Prérequis
- → Un repository avec au moins 1 commande de validation déterministe
- → Un reviewer local ou une CLI de review renvoyant des constats structurés
- → Un workflow CI capable de conserver un artefact versionné
TL;DR
Je placerais la décision d’arrêt dans un contrôleur conservant entrées, compteurs et résultats. Le modèle peut proposer une correction, mais ne doit pas réinitialiser son budget ni transformer un résultat manquant en review terminée.
| Élément du contrat | Décision requise |
|---|---|
| Entrées | Figer repository, base, head, diff, critères et budget |
| État d’exécution | Terminer en COMPLETED, FAILED, ABORTED, TIMEOUT ou UNKNOWN |
| Résultat | Consigner CLEAR ou FINDINGS seulement pour une exécution COMPLETED |
| Cause d’arrêt | Nommer la raison de fin, distincte de l’état |
| Reprise | Plafonner les corrections et arrêter en l’absence de progression démontrée |
| Transmission | Conserver entrées versionnées, configuration, constats, état et cause d’arrêt |
Une boucle demandant à l’agent de lire et corriger jusqu’à satisfaction n’a pas de condition de fin. Ce guide définit ce qui peut s’exécuter, ce qui compte comme progrès, ce qui arrête l’exécution et qui décide de la suite.
Le contrat couvre une passe locale et une étape CI ultérieure. La boucle locale détecte les échecs peu coûteux avant push et émet des preuves. La CI les consomme et exécute ses propres contrôles. La transmission n’autorise pas un merge : identité du fournisseur, preuve du SHA actuel, contrôles requis, politique de branche et autorité de merge relèvent de la partie 4.
Le workflow est indépendant du fournisseur. Reviewer interne, service CLI ou autre vérificateur borné peuvent implémenter la même interface. La partie 8 y associe le comportement de l’API d’Opus 5.5.
Admettre le travail récurrent avant de figer une exécution
Un contrôle planifié peut choisir des candidats. Dans Practical Loop Engineering, Addy Osmani décrit un contrôle horaire résumant les nouvelles issues, puis une tâche bornée. La politique d’admission ci-dessous applique ce schéma aux reviews. Elle ne suppose pas que l’imbrication d’une commande native d’objectif dans un prompt planifié est prise en charge.
Avant de créer une exécution, vérifiez que le candidat satisfait au critère d’éligibilité de la file, que sa révision actuelle n’a pas déjà été traitée et qu’aucun exécutant actif n’a la charge de ce candidat. N’admettez le travail que si la file partagée et le budget total le permettent. Consignez identifiant, responsable, révision d’entrée et budget réservé, puis figez les entrées. Si un autre contrôle voit le même candidat actif, il rapporte l’exécution existante au lieu d’en lancer une autre.
Par exemple, 2 contrôles consécutifs peuvent voir la même PR ouverte. Le deuxième rapporte l’exécution couvrant déjà cette révision head. Un nouveau head exige de nouvelles preuves, et l’admission décide encore de la capacité disponible. Testez les deux cas avant d’activer le dispatch automatique.
Geler les entrées avant le premier passage
Chaque exécution commence par un paquet immuable. Enregistrer au minimum :
- l’identité du repository
- les SHAs des commits base et head
- un digest du diff
- la version ou le digest de l’exigence
- les critères de code review et leur version
- le contexte autorisé et exclu
- les commandes déterministes à exécuter
- les budgets d’itérations, de temps et de coût
- la personne ou le rôle responsable de l’escalade
Si le diff change, créer une nouvelle exécution ou une nouvelle itération numérotée. Ne pas remplacer l’entrée précédente en place. Un constat rattaché à une révision antérieure reste un historique utile, mais il ne dit rien sur le nouveau head.
L’exigence fait partie du paquet car un relecteur peut inspecter le code parfaitement selon un critère d’acceptation incomplet et approuver quand même un comportement erroné.
Réviser des critères incomplets sans déplacer les bornes
Prenons un exemple construit : une exportation doit contenir toutes les lignes visibles. Les premiers tests vérifient les noms de colonnes et une seule page. Le travail révèle ensuite que l’exportation omet silencieusement les pages suivantes. Réussir les vérifications d’origine ne permet pas de déterminer si la tâche est terminée.
Enregistrer une nouvelle révision de l’exigence, la découverte qui la motive, la personne qui a autorisé le changement, et les tâches et tests affectés. Invalider l’acceptation basée sur les critères obsolètes et relancer la vérification affectée sur la nouvelle entrée gelée. Les budgets, les limites de rôle et l’autorité de fusion restent fixes sauf si leur propriétaire les modifie. Un agent peut découvrir du travail manquant dans le cadre de cette politique. Il ne peut pas affaiblir l’exigence pour transformer un échec en réussite.
Séparer exécution, résultat et cause d’arrêt
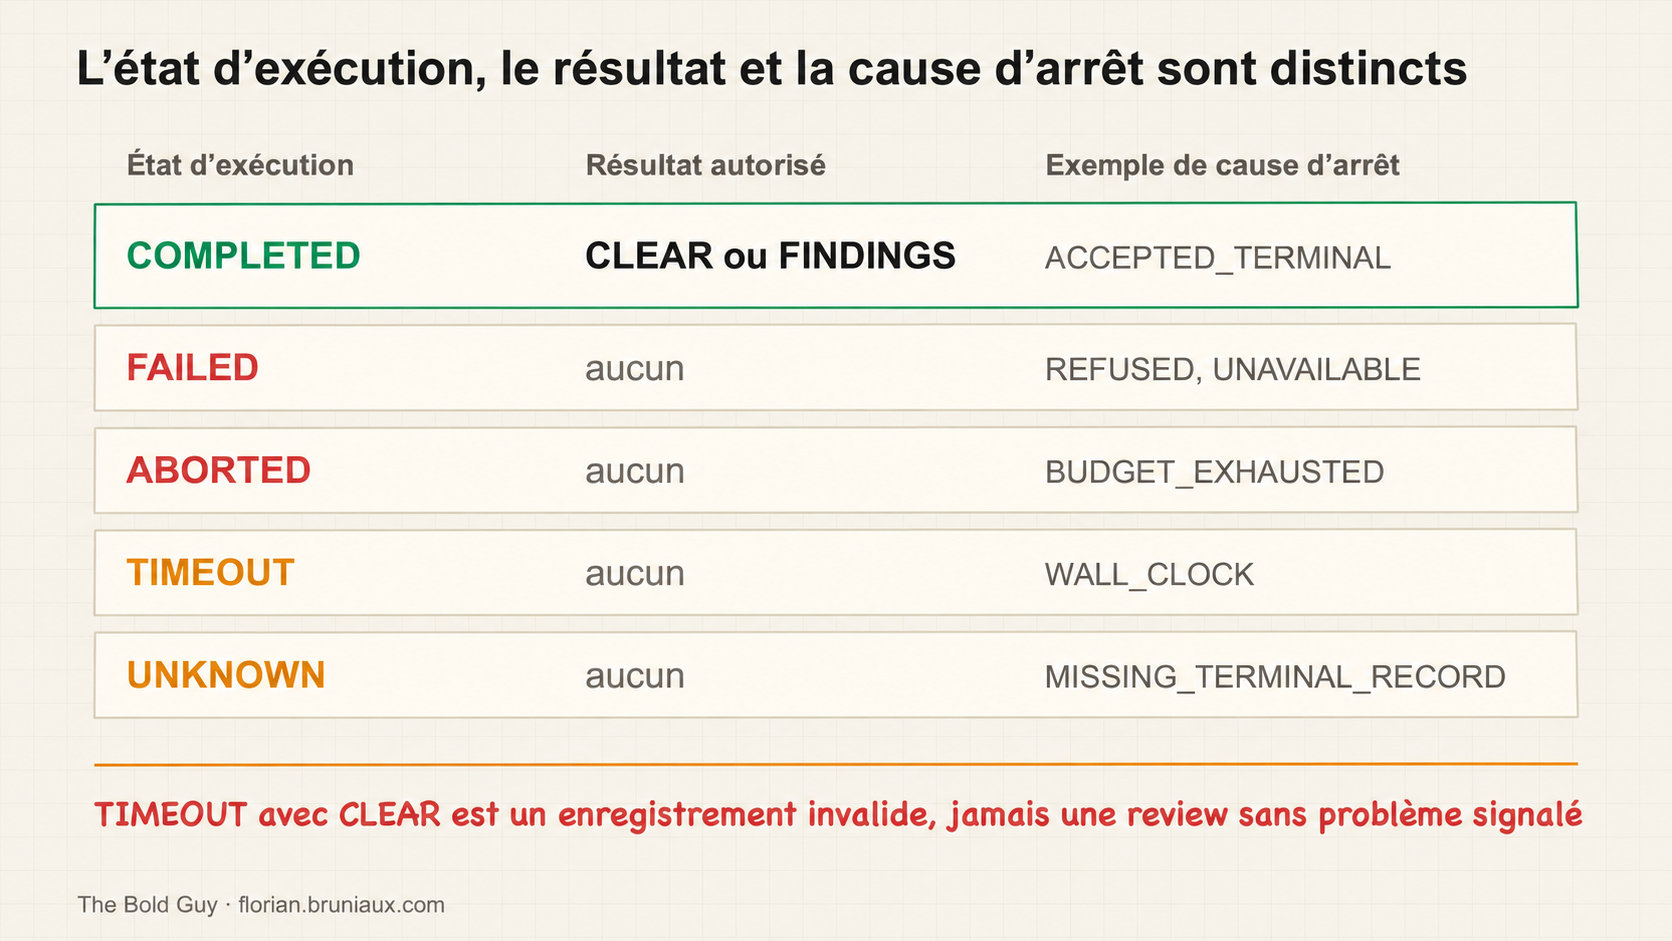
Un seul champ de statut ne peut pas dire à la fois ce que le relecteur a trouvé et s’il a terminé. Cette série utilise 3 champs et ne les fusionne jamais. Les parties 4 et 6 réutilisent les mêmes valeurs.
État d’exécution indique si la procédure déclarée est terminée :
COMPLETED: la procédure a atteint sa sortie terminaleFAILED: la procédure s’est terminée par un échec technique, de validation ou de politique connuABORTED: le contrôleur ou une personne autorisée l’a arrêtée selon la politiqueTIMEOUT: la limite de temps écoulé a expiréUNKNOWN: les preuves conservées ne permettent pas d’établir un autre état
Résultat n’existe que pour une exécution COMPLETED :
CLEAR: le relecteur a retourné 0 constat dans son périmètre déclaréFINDINGS: le relecteur a retourné 1 constat ou plus
Cause d’arrêt explique pourquoi l’exécution s’est terminée. Les valeurs utilisées dans cette série sont :
| Cause d’arrêt | État d’exécution typique | Signification |
|---|---|---|
ACCEPTED_TERMINAL | COMPLETED | Un enregistrement terminal valide a été accepté |
NO_PROGRESS | ABORTED | 2 itérations consécutives n’ont pas satisfait la condition de progression |
BUDGET_EXHAUSTED | ABORTED | Les itérations, le temps écoulé ou le coût ont atteint le plafond |
OPERATOR_STOP | ABORTED | Une personne ou un interrupteur d’arrêt a stoppé l’exécution |
UNAVAILABLE | FAILED | Le fournisseur était indisponible ou en limitation de débit |
REFUSED | FAILED | Le modèle a refusé la requête |
MALFORMED_OUTPUT | FAILED | La sortie a échoué à la validation du schéma |
CONTEXT_DENIED | FAILED | Le contexte ou les permissions requis n’étaient pas disponibles |
PARTIAL_SCOPE | FAILED | Le relecteur n’a couvert qu’une partie du périmètre déclaré |
WALL_CLOCK | TIMEOUT | La limite de temps a expiré |
MISSING_TERMINAL_RECORD | UNKNOWN | Le processus s’est terminé sans preuve terminale exploitable |
Un code de sortie 0 ne remplace pas un enregistrement terminal manquant ou malformé. Un relecteur peut sortir avec 0 après que son wrapper a avalé un timeout ; sans enregistrement de complétion valide, le contrôleur maintient TIMEOUT ou UNKNOWN. CLEAR signifie 0 constat dans le périmètre déclaré. Cela ne signifie pas que le changement est correct. Un périmètre partiel conserve ses constats comme preuve, mais il ne porte aucun résultat.
Modéliser la boucle comme des transitions explicites
Utiliser une petite machine à états :
PREPARED
  -> CHECKING
  -> REVIEWING
  -> RECONCILING
  -> COMPLETED

CHECKING | REVIEWING | RECONCILING
  -> FAILED | ABORTED | TIMEOUT | UNKNOWN

RECONCILING
  -> CHECKING, only when budget remains and progress is demonstrated
Les étapes ont des responsabilités distinctes :
- Produire. L’auteur ou l’agent crée une révision candidate.
- Vérifier. Des commandes déterministes évaluent des propriétés explicites de syntaxe, de type, de test, de sécurité ou de politique.
- Relire. Un relecteur évalue le changement gelé selon les critères dans son contexte déclaré.
- Réconcilier. L’auteur accepte un constat, le rejette avec preuve, ou escalade la décision.
- Arrêter ou répéter. Le contrôleur évalue le budget et la progression avant d’autoriser une nouvelle révision.
Seul le contrôleur de transition modifie le compteur d’itérations. Le relecteur ne peut pas s’octroyer une nouvelle tentative, et l’auteur ne peut pas transformer une vérification échouée en COMPLETED en modifiant le rapport.
Définir la progression avant le lancement de la boucle
Garder 3 compteurs séparés. Une itération de correction est une nouvelle révision candidate après une relecture. Un réessai répète une opération technique échouée sur la même révision. Une continuation demande au même modèle de reprendre dans 1 passage de relecture ; les règles spécifiques au fournisseur pour cela appartiennent à l’adaptateur. L’exemple de transfert ci-dessous définit maxIterations: 3, ce qui autorise la première relecture plus 2 itérations de correction.
Plus d’activité n’est pas de la progression. Une itération de correction est qualifiée seulement si au moins 1 de ces conditions est remplie :
- une vérification déterministe qui échouait auparavant passe sans nouvel échec d’un contrôle requis
- un constat accepté est corrigé et sa preuve de vérification est conservée
- un constat contesté est résolu par le propriétaire humain nommé avec une raison enregistrée
- le diff est réduit ou scindé selon une règle de complexité prédéfinie
Des commentaires réécrits, une autre explication du modèle, ou une sévérité auto-déclarée plus basse ne comptent pas.
Quand 2 itérations consécutives ne satisfont aucune de ces conditions, le contrôleur s’arrête avec NO_PROGRESS. Au maximum d’itérations, de durée ou de coût, il s’arrête avec BUDGET_EXHAUSTED. Dans les deux cas, les dernières preuves accompagnent l’escalade au lieu de demander au même reviewer de réessayer.
La démonstration Harnesses in AI de Tejas Kumar à 13:21, publiée par AI Engineer le 17 mai 2026, montre une limite sous le contrôle de la boucle externe : au plus 3 tentatives, avec un vérificateur déterministe séparé de la tentative de l’agent. Petite démonstration sur un vote positif, pas benchmark de review ni preuve de l’optimalité de 3.
Budget demandé et limite imposée nécessitent des preuves distinctes. Le contrôleur doit garder les compteurs entre redémarrages, imposer le délai du processus et arrêter le dispatch avant épuisement du budget d’appels. Si usage fournisseur ou tarifs sont indisponibles, ne prétendez pas avoir imposé le plafond monétaire ; conservez cette lacune et les limites réellement appliquées. Une clause de durée dans une condition d’achèvement évaluée par le modèle n’est pas un timeout de processus.
Live AIDD : l’activité nocturne n’était pas l’achèvement
À 28:00 du live AIDD du 16 octobre 2026, je décris une session de correction laissée toute la nuit et encore active le matin après une consommation importante de tokens. Je demande un objectif, un budget de tokens ou d’itérations et un passage de relais explicite si l’agent ne parvient pas à trouver la réponse. L’anecdote motive une règle d’arrêt ; elle ne démontre pas l’application du contrat de contrôleur de ce guide.
À 30:00, je donne un repère personnel d’environ 30 à 50 fichiers concernés pour borner le contexte de review. Ce n’est ni une limite universelle de fournisseur ni une preuve de couverture complète. Consignez les fichiers réellement examinés avant de considérer une PR plus petite comme une review terminée.
À 50:00, je décris aussi le remplacement d’une PR surchargée par une nouvelle avec résumé de la discussion précédente. Cela peut restaurer la lisibilité, mais le contrôleur proposé doit conserver historique de la tâche logique et budget restant. Un nouvel identifiant de PR ne doit pas permettre une succession illimitée de nouvelles tentatives. C’est une implication de conception, pas une application démontrée par le live. La source utilise des sous-titres automatiques et il lui manque quelques minutes au début. Elle reste distincte de la conférence Dev With AI du 12 octobre.
Limiter les nouvelles tentatives plus strictement que les reprises
Une reprise modifie le code candidat ou son traitement ; une nouvelle tentative ne le fait pas.
Ne retentez que les échecs transitoires classifiés, comme un endpoint indisponible ou une réponse de limite de débit donnant une borne de reprise. Plafonnez les tentatives, ajoutez une attente progressive et conservez chaque essai. Ne retentez pas automatiquement une sortie mal formée, un contexte insuffisant, une authentification échouée, un refus ou un état inconnu. Ces cas demandent une correction de config ou une personne.
Le TDD avec Claude Code montre le coût d’une limite sans arrêt visible. Sa boucle de tests automatique plafonnait à 10 itérations et abandonnait silencieusement, jusqu’à l’ajout d’un second hook Stop avec condition d’échappement et notification.
| Échec | État d’exécution et cause d’arrêt | Nouvelle tentative automatique |
|---|---|---|
| Timeout du reviewer | TIMEOUT, WALL_CLOCK | Non, sauf politique réservant 1 tentative bornée |
| Sortie structurée mal formée | FAILED, MALFORMED_OUTPUT | Non |
| Service temporairement indisponible | FAILED, UNAVAILABLE | Au plus le nombre configuré de tentatives transitoires |
| Contexte requis inaccessible | FAILED, CONTEXT_DENIED | Non |
| Refus du modèle | FAILED, REFUSED | Non |
| Budget de coût dépassé | ABORTED, BUDGET_EXHAUSTED | Non |
| Processus terminé sans preuve terminale | UNKNOWN, MISSING_TERMINAL_RECORD | Non |
L’absence de résultat ne devient jamais CLEAR. Si un reviewer consultatif échoue, la livraison peut continuer sous une politique dégradée documentée, et l’état de review reste affiché comme échoué ou inconnu.
Reprendre une exécution interrompue sans répéter ses effets
Après interruption, chargez le dernier checkpoint durable et confirmez repository, base, head, critères et révisions de politique. Vérifiez qu’aucun ancien exécutant ne possède encore la tâche. Conservez l’identifiant de l’exécution et le budget restant. Un déclenchement de planificateur ne doit pas les réinitialiser silencieusement. Si l’attribution de la tâche ou le résultat ne peuvent être établis, consignez UNKNOWN et escaladez.
Les écritures externes demandent plus de soin. Si un commentaire a été publié mais son accusé perdu, la boucle ne peut déduire un échec d’un reçu local vide. Gardez un identifiant d’effet stable, réconciliez-le avec la destination avant de retenter et laissez la publication non résolue si la destination ne peut confirmer. Renommer un fichier ne suffit pas à garantir un comportement exactement une fois entre services.
Les règles d’interruption LangGraph, vérifiées le 14 octobre 2026, donnent un risque concret de rejeu : la reprise redémarre le nœud interrompu, donc une écriture externe antérieure peut se reproduire. La documentation recommande des opérations idempotentes ou une séparation des effets de bord et de l’interruption. Un checkpoint durable conserve l’état du graphe ; il ne déduplique pas seul un commentaire déjà publié ailleurs. Ce guide n’a pas testé cette intégration.
Les erreurs doivent aider cette reprise. La conférence Chrome DevTools de Michael Hablich à 13:14 décrit la réécriture des erreurs d’outils pour permettre à l’agent de se rétablir seul. Ici, un timeout de publication devrait indiquer si l’effet a pu se produire et quelle réconciliation est autorisée.
Le retour d’Anthropic sur les agents longue durée reconstitue le travail entre sessions avec script d’initialisation, fichier de progression et historique Git. Conception documentée, pas preuve d’indépendance d’un reviewer en nouveau contexte ni de rejeu sûr des écritures externes.
L’exercice de contrôle local teste transitions permises et refusées, budgets durables, appels concurrents et perte de réponse contre un service d’effets simulé. Il démontre uniquement le respect de son propre contrat. Il ne valide ni politique GitHub de merge ni comportement de nouvelle tentative d’un fournisseur.
Mapper les réponses fournisseur dans l’adaptateur
Chaque fournisseur a ses propres formats de réponse, que l’adaptateur traduit dans les champs précédents avant de les transmettre au contrôleur. Une fin de tour textuelle n’est pas une review terminée ; un refus HTTP 200 est FAILED avec REFUSED ; des constats valides à périmètre incomplet sont FAILED avec PARTIAL_SCOPE ; lorsqu’un modèle de repli configuré produit le résultat, ce modèle est consigné. La partie 8 liste ces mappings pour Opus 5.5. Testez chacun avec une fixture conservée avant toute connexion à la publication.
Émettre une transmission portable
L’étape locale écrit un manifeste versionné dans une enveloppe authentifiée. La CI valide enveloppe, manifeste et artefacts avant d’utiliser tout champ.
schemaVersion: 1
runId: review-20260902-0042
producer:
  identity: "urn:example:workstation:review-runner-042"
  authentication:
    method: organization-keyless-dsse
    issuer: "https://identity.example.dev"
    subject: "urn:example:workstation:review-runner-042"
binding:
  repository: example/service
  baseSha: 71d4c9a
  headSha: c30f610
  criteriaVersion: review-criteria-v3
  producerIdentity: "urn:example:workstation:review-runner-042"
inputs:
  diffSha256: "<sha256>"
  requirementsSha256: "<sha256>"
configuration:
  loopPolicy: bounded-review-v1
  reviewer:
    kind: external-cli
    provider: example-reviewer
    version: "2026-09-02"
  budgets:
    maxIterations: 3
    maxWallClockSeconds: 900
    maxCostUsd: 2.00
execution:
  iteration: 2
  state: COMPLETED
  startedAt: "2026-09-02T08:40:00Z"
  endedAt: "2026-09-02T08:47:12Z"
  stopCause: ACCEPTED_TERMINAL
result:
  outcome: FINDINGS
  accepted: 2
  rejected: 1
  escalated: 0
artifacts:
  findings:
    path: findings-v1.json
    sha256: "<sha256>"
  deterministicChecks:
    path: checks-v1.json
    sha256: "<sha256>"
  rawReview:
    path: reviewer-output.txt
    sha256: "<sha256>"
Une signature DSSE couvre le manifeste canonique, liaison, empreintes d’entrées et de chaque artefact comprises. La CI vérifie l’enveloppe d’abord, puis la liaison signée face au repository attendu et à la révision actuelle, puis recalcule toutes les empreintes. Elle rejette une combinaison impossible comme state: TIMEOUT avec outcome: CLEAR. Gardez la sortie brute, la normalisation pouvant perdre réserves ou détails de localisation.
La confiance dans le producteur vient d’une politique extérieure au changement candidat, par exemple la révision de base protégée. Dans ce modèle de poste de travail, un service d’identité contrôlé par l’organisation authentifie un appareil enrôlé avant d’émettre une identité de signature éphémère ; la CI exige la correspondance exacte du sujet authentifié, de producer.identity et de binding.producerIdentity. Une allowlist ajoutée par le head candidat ne peut pas autoriser ce candidat. La partie 6 couvre les identifiants concernés.
La rétention demande aussi une décision. Dans le repository mesuré en partie 7, le workflow garde les artefacts CI 1, 7 ou 14 jours. Une transmission nécessaire à un audit ou incident ultérieur doit être copiée vers un stockage à rétention choisie.
Un manifeste fourni par soi-même ou non authentifié n’est pas fiable. Une personne peut le lire comme contexte, mais il ne peut sauter une nouvelle review, satisfaire une politique requise, effacer des constats ou autoriser un merge. Si la CI ne peut authentifier le producteur, elle relance la review sur un runner fiable ou consigne l’absence de transmission fiable. Un artefact authentifié dont tous les éléments correspondent peut épargner à la CI une passe optionnelle identique ou afficher des constats antérieurs. L’authentification établit provenance et intégrité, pas qualité de review.
Instrumenter la boucle avant de l’optimiser
Conservez ces signaux pour chaque exécution :
| Signal | Objectif |
|---|---|
| Durée totale et par étape | Séparer latence du reviewer, contrôles locaux et attente humaine |
| Coût par tentative | Trouver les tentatives ou reviewers qui consomment le budget sans progresser |
| Nombre d’itérations | Détecter exigences instables et corrections répétées |
| Constats acceptés | Montrer les commentaires ayant affecté le changement candidat |
| Constats rejetés | Examiner bruit et critères disputés sans appeler tout rejet faux |
| Escalades | Identifier les décisions non automatisables sans risque par la boucle |
| État d’exécution et cause d’arrêt | Distinguer achèvement, échec, timeout, inconnu et arrêt de politique |
Un constat accepté n’est pas automatiquement un vrai défaut : l’auteur peut accepter une suggestion inoffensive pour clore une discussion. Les affirmations sur la qualité demandent un arbitrage au regard du code et de l’exigence.
Exécuter certaines reviews avant CI est une hypothèse de workflow. Toute réduction d’exécutions distantes, latence ou coût reste non mesurée tant qu’une comparaison ne relie pas des changements équivalents aux traces locales et distantes, tentatives échouées comprises.
Poser 4 questions différentes à la vérification
Les tests alimentant le contrôleur nécessitent aussi une évaluation. Distinguez comportement vérifié et preuves de capacité des contrôles à détecter un défaut :
| Méthode de vérification | Question | Preuves utiles à conserver |
|---|---|---|
| Exemples approuvés indépendamment | L’implémentation respecte-t-elle l’exigence sur ces cas ? | Entrées et résultats attendus approuvés sans copier la réponse de l’implémentation candidate |
| Propriétés sur entrées générées | Un invariant tient-il au-delà des exemples choisis ? | Propriété, limites du générateur, entrée en échec et graine rejouables |
| Tests de mutation | Les tests détectent-ils une faute introduite pour la bonne raison ? | Référence, mutation, tests exécutés et assertion échouée ou autre résultat classifié |
| Fixtures du contrôleur | Le harnais interprète-t-il le rapport et prend-il la bonne action ? | Rapport valide sans constat, constat confirmé, sortie vide, révision périmée, 0 test et panne d’infrastructure |
Dans un exemple construit de mise à jour de compte, les cas approuvés couvrent propriétaire et autre acteur. Les cas générés varient les identités tout en conservant l’interdiction de modification par un non-propriétaire. Retirer le contrôle qui vérifie que l’acteur est propriétaire est une mutation candidate. Les fixtures vérifient ensuite qu’un rapport de tests vide ne peut autoriser le changement. Ce sont 4 contrôles de frontières différentes, pas 4 votes attestant que le code est correct.
Pour évaluer les mutations, partez d’un état de référence où les tests passent et d’un ensemble non vide de tests pertinents, puis comparez les candidats sur les mêmes frontières de code, mutations et exclusions. Un timeout ou environnement cassé n’a pas détecté la faute visée ; classez-le séparément. Une mutation survivante demande une enquête : la faute peut être équivalente, hors du périmètre revendiqué ou manquée par les tests.
Gardez aussi une fixture positive : un changement inoffensif valide avec preuves utilisables doit pouvoir avancer. Un harnais qui bloque tout et une exécution avec 0 test pertinent ne démontrent ni l’un ni l’autre une vérification utile.
Un contrôle applicatif nécessite aussi un moyen reproductible d’atteindre le comportement examiné. Lauren Tan décrit une carte de fonctionnalités à 10:16-11:38 dans sa conférence sur la livraison assistée par agents. Le create-verification-skill de Pstack consigne le lancement, l’état de santé de l’instance, les instructions de pilotage, les preuves et le nettoyage, avec une carte des points d’entrée et des résultats attendus. Ce contrat d’exécution complète le paquet de review figé ; une procédure générée ne devient preuve qu’après exécution du parcours utilisateur pertinent.
Le maintain-verification-skill associé exige inspection des sources et couverture réelle, puis distingue documentation périmée, lacune de pilotage et régression produit. Une maintenance peut réparer le skill de vérification, mais doit rapporter un défaut produit plutôt que réécrire le comportement attendu pour réussir. Procédures documentées, pas résultats d’exécution enregistrés pour ce guide.
Tester les échecs avant de faire confiance à la boucle
Passez le même changement figé dans ces scénarios :
- Achèvement nominal avec
CLEAR - Achèvement nominal avec
FINDINGSstructuré - Sortie non nulle du reviewer et erreur conservée
- Dépassement du budget de durée
- Sortie 0 sans manifeste terminal
- Constats mal formés
- Refus ou verdict contenant
not approveddans son texte - 2 corrections sans progrès défini
- Budget de coût épuisé avant achèvement
- Reçu d’une ancienne révision présenté pour le head actuel
- Changement inoffensif valide atteignant son résultat terminal prévu sans blocage
- Publication interrompue réconciliée sans duplication de son effet externe
Vérifiez dans chaque cas état d’exécution, cause d’arrêt, artefacts conservés, nombre de tentatives et cible d’escalade. Confirmez qu’aucune preuve manquante ne devient CLEAR, qu’un verdict est lu dans un champ structuré plutôt que déduit d’une sous-chaîne et que la CI ultérieure rejette une transmission mal formée.
Pas encore démontré : ce guide spécifie le contrat. Les exercices nominal,
FAILED,TIMEOUTetUNKNOWNn’ont pas encore été enregistrés sur 1 entrée figée. Traitez donc tout comportement d’exécution décrit comme une conception à tester dans votre repository.
Un exercice de préparation du 14 octobre 2026 pour un pilote de code Luna/Astra séparé a vérifié une interruption via le client Codex installé avec un serveur local à réponse fixe : déconnexion du flux TCP maintenu ouvert et refus de continuation. La partie 8 consigne périmètre et inconnues. Ce contrôle local ne valide ni ce contrôleur de review, ni les compteurs finaux d’usage d’un fournisseur réel, ni un plafond strict de dépense.
Un worktree sépare les changements Git d’un autre checkout. Il n’isole ni processus, ni secrets, ni système de fichiers, ni réseau. Appliquez les contrôles de la partie 6 si le reviewer exécute du code non fiable ou envoie des données à un autre fournisseur.
La partie 4, Une review verte n’est pas un contrôle de merge, explique ce que CI et GitHub doivent établir avant qu’un signal de review influence l’autorité de merge.
YSNK
(Ce que vous devriez maintenant savoir)
- Figez diff, exigence, critères, contexte et budgets avant la boucle de review
- Gardez état d’exécution, résultat et cause d’arrêt dans des champs distincts
- Retentez les opérations transitoires ; escaladez les exécutions mal formées, refusées, inconnues ou stagnantes
- Préservez une transmission versionnée sans la traiter comme une autorisation de merge
- Testez les échecs et un parcours autorisé avant d’affirmer que la boucle fonctionne
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source