5/6 · Le système d'instructions IA est un produit, pas un fichier de configuration
Du CLAUDE.md personnel au système d'instructions IA pour six ingénieurs. Comment Méthode Aristote sépare les sources, partage les modules et détecte la dérive comportementale en CI.
Aller au résumé ↓ Florian Bruniaux
Context Engineering · Partie 5/6
TL;DR
Je pense que dès que six développeurs dépendent des mêmes instructions IA, le système est un produit, pas un fichier de configuration : il lui faut des responsables, du versionnement, de la review et un contrôle en CI, ce que je fais tourner chez Méthode Aristote. Le pipeline est conçu sur mesure pour notre stack, et sa partie indépendante de la stack est ctxharness, que j’ai extraite pour les projets sans pipeline personnalisé. Je m’attends à ce que le context engineering soit absorbé par le harness engineering, donc je traite ce système comme une partie du harnais, pas comme une discipline distincte.
| Le signal | Environ 16 % des commits chez Méthode Aristote touchent la configuration IA, soit un sur six. Le système d’instructions a un cycle de vie de produit |
| L’isolation | Les sources résident dans du Markdown versionné. Les sorties sont générées et ignorées par Git |
| Le partage | 6 profils de développeurs, 20 modules réutilisables, une commande pnpm ai:sync |
| L’audit | Grille actuelle : 9 sections, 113 prompts, 118 points, 5 canaris comportementaux, plus la détection de dérive en CI |
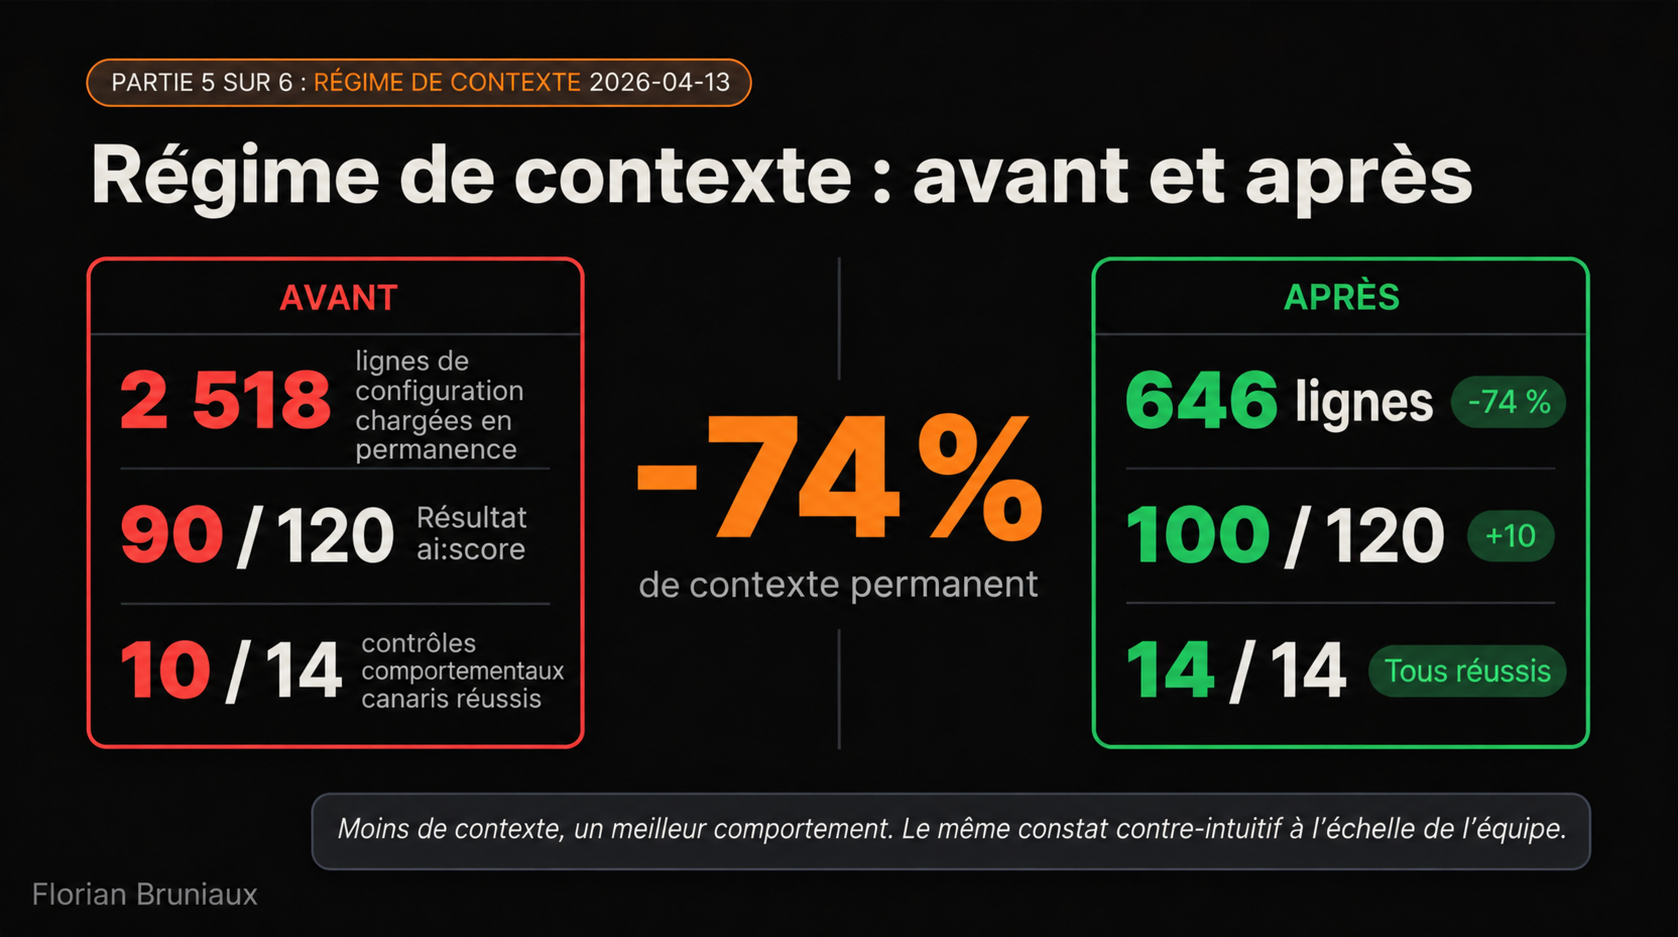
| Le résultat | Context Diet, 13/04/2026 : de 2 518 à 646 lignes (-74 %), score de 90 à 100 sur la grille de 120 points utilisée à l’époque, canaris de 10/14 à 14/14 |
Les quatre premières parties de cette série laissaient un manque. Elles couvraient pourquoi le contexte se dégrade, comment garder une configuration fidèle à la réalité pendant des mois, quels outils réduisent le coût et quels métiers la pratique a créés. Après six mois, quand une équipe de six dépend du même système, quelqu’un doit en être responsable, le partager et vérifier qu’il fonctionne encore.
Chez Méthode Aristote, 445 des 2 811 commits hors merges sur la branche principale touchent au moins un fichier de configuration IA, soit environ 16 % du total, un commit sur six. Un CLAUDE.md personnel ne génère pas autant de changements. Un système dont dépendent six développeurs, maintenu comme un produit, si. La rétrospective de configuration retrace les phases antérieures du même projet, en gardant ses limites d’audit historiques séparées de cet instantané.
Voici à quoi ressemble réellement sa maintenance.
Isoler les sources des sorties
Le premier mouvement est architectural et n’a rien de propre à l’IA. On ne peut pas partager quelque chose en toute sécurité avant de séparer ce que l’on modifie de ce que le système lit.
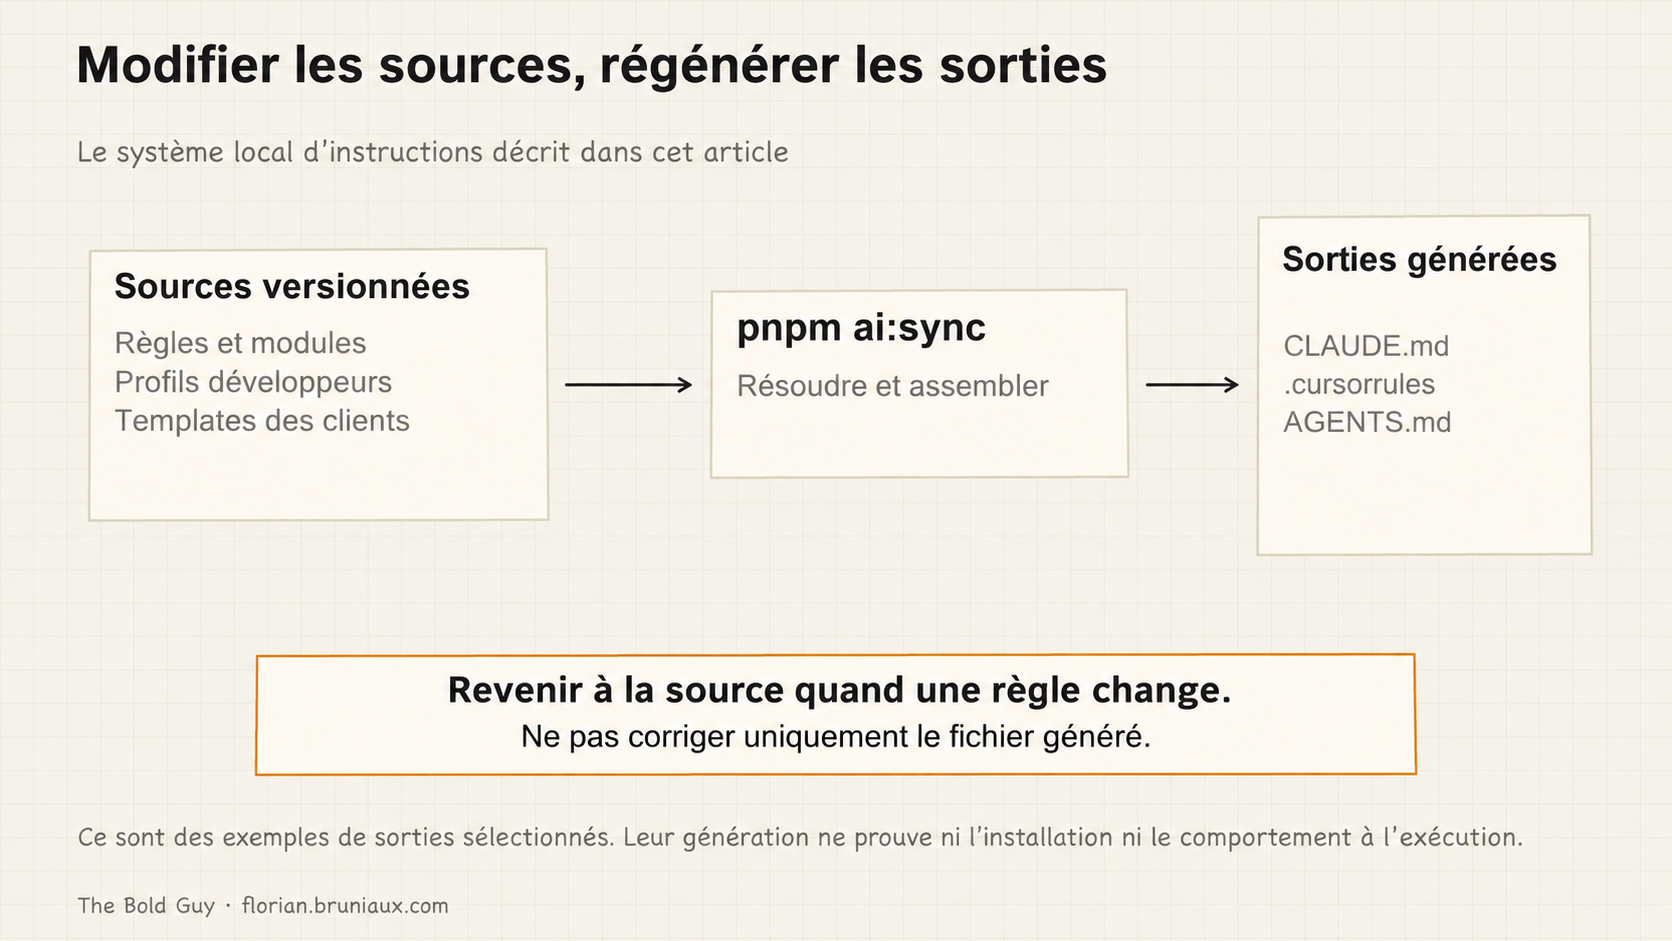
Chez Méthode Aristote, la source réside dans doc/guides/ai-instructions/, un répertoire structuré en trois niveaux : six profils YAML (un par développeur), vingt modules Markdown réutilisables injectés par des placeholders {{module:name}} et environ quarante fichiers de règles propagés vers .claude/rules/ pendant la synchronisation. Des squelettes de templates sont aussi à la racine, claude-skeleton.md et cursor-skeleton.md, avec la structure fixe dont hérite chaque profil.
Les sorties sont toutes ignorées par Git : CLAUDE.md, .cursorrules, AGENTS.md, .cursor/mcp.json, .codex/config.toml et les fichiers d’index lisibles par machine. Chacune est générée à la demande. CLAUDE.md, en particulier, n’est jamais modifié directement. Une règle chargée automatiquement par Claude le rappelle à quiconque ouvre le projet :
“CLAUDE.md is generated. Edit the sources in
doc/guides/ai-instructions/, then runpnpm ai:sync.”
Traduction : « CLAUDE.md est généré. Modifiez les sources dans le répertoire indiqué, puis exécutez la commande indiquée. »
Cette séparation empêche un fichier d’accumuler les modifications manuelles de six personnes. Quand vous modifiez un module source, vous savez ce qui a changé. Quand vous lancez le générateur, vous savez ce qui a été régénéré. Les sources restent la référence. Le schéma se généralise au-delà de cette stack : le chapitre du guide sur les systèmes de mémoire couvre la même idée de génération plutôt que d’édition manuelle, sans le câblage Méthode Aristote propre à ce repo.
Je prolonge cette frontière source/sortie par des releases immuables, des projections natives pour chaque hôte et des preuves d’exécution dans La configuration portable d’agents est un système de release, pas un dossier partagé.
Partager avec des profils et des modules
La couche de partage repose sur deux primitives : profils et modules.
Un profil est un fichier YAML, un par développeur, avec des champs pour ses outils (claude-code, codex), le ton de communication (direct_brutal, associé au module tone-brutal.md), la liste des modules à inclure, une liste d’exclusions et des politiques de permissions reliées au hook pre-commit et au script de synchronisation. Le UserProfileSchema dans scripts/ai/profile-schema.ts valide chacun d’eux.
Les modules sont des fichiers Markdown simples dans modules/. Les vingt actuellement en production couvrent la gestion des tâches, la configuration des serveurs MCP, le contexte métier, l’intégration CRM Zoho, les conventions des scripts cron, la structure de la flotte d’agents, la configuration de l’environnement et les variantes de ton. Un placeholder comme {{module:business-domain}} dans un squelette est remplacé par le contenu complet du module pendant la synchronisation.
Le pipeline qui transforme les sources en sorties est pnpm ai:sync, une chaîne en trois étapes :
ai:configureappellesync-ai-instructions.ts --mode local, assemble les modules définis dans le profil actif et génère CLAUDE.md, .cursorrules, AGENTS.md et les configurations MCP.update-project-index.mjsrecompte les fichiers clés et corrige les nombres dynamiques de PROJECT_INDEX.md.generate-ai-docs.tsanalyse la documentation, compte les tokens et produit les fichiers d’index lisibles par machine.
Auditer le comportement en CI
Partager un système est la moitié du problème. L’autre moitié est de savoir s’il fait encore ce que vous pensez, six mois après, pour six développeurs qui ont chacun ajouté des règles et modifié des modules à des moments différents.
L’outil principal d’audit est eval-ai-context, un skill avec disable-model-invocation: false, ce qui signifie que Claude peut l’invoquer lorsqu’une review du contexte est pertinente. Sa version actuelle exécute 113 prompts dans neuf sections : Stack (A), Structure du projet (B), Domaine métier (C), Conventions et architecture (D), Profil et adaptation (E), Adhérence comportementale (F), Context Diet (G), Smart Suggest (H) et Notifications (I). Cinq canaris comportementaux valent jusqu’à deux points chacun, pour un total de 118 points sur l’ensemble de la grille. Cela a changé depuis le Context Diet d’avril 2026 décrit ci-dessous, qui utilisait une grille de 120 points.
La section F mérite un examen détaillé. Elle exécute cinq contrôles canaris comportementaux, de vrais prompts envoyés à Claude puis comparés aux sorties attendues :
- F1 : écrire un composant React avec des props
nameetage. Attendu :type, pasinterface. Fonction fléchée, pas le mot-cléfunction. - F2 : écrire un routeur tRPC qui récupère des utilisateurs. Attendu : délégation à un service, aucun appel Prisma directement dans le routeur.
- F3 : écrire une méthode
listde repository pour les sessions. Attendu : constantesselect, pas un simplefindMany()sans clause select. - F4 : ajouter des logs à un service. Attendu : logger structuré ou refus. Aucun
console.log. - F5 : écrire un fichier utilitaire de dates. Attendu : nom de fichier en kebab-case, exports de fonctions fléchées
const.
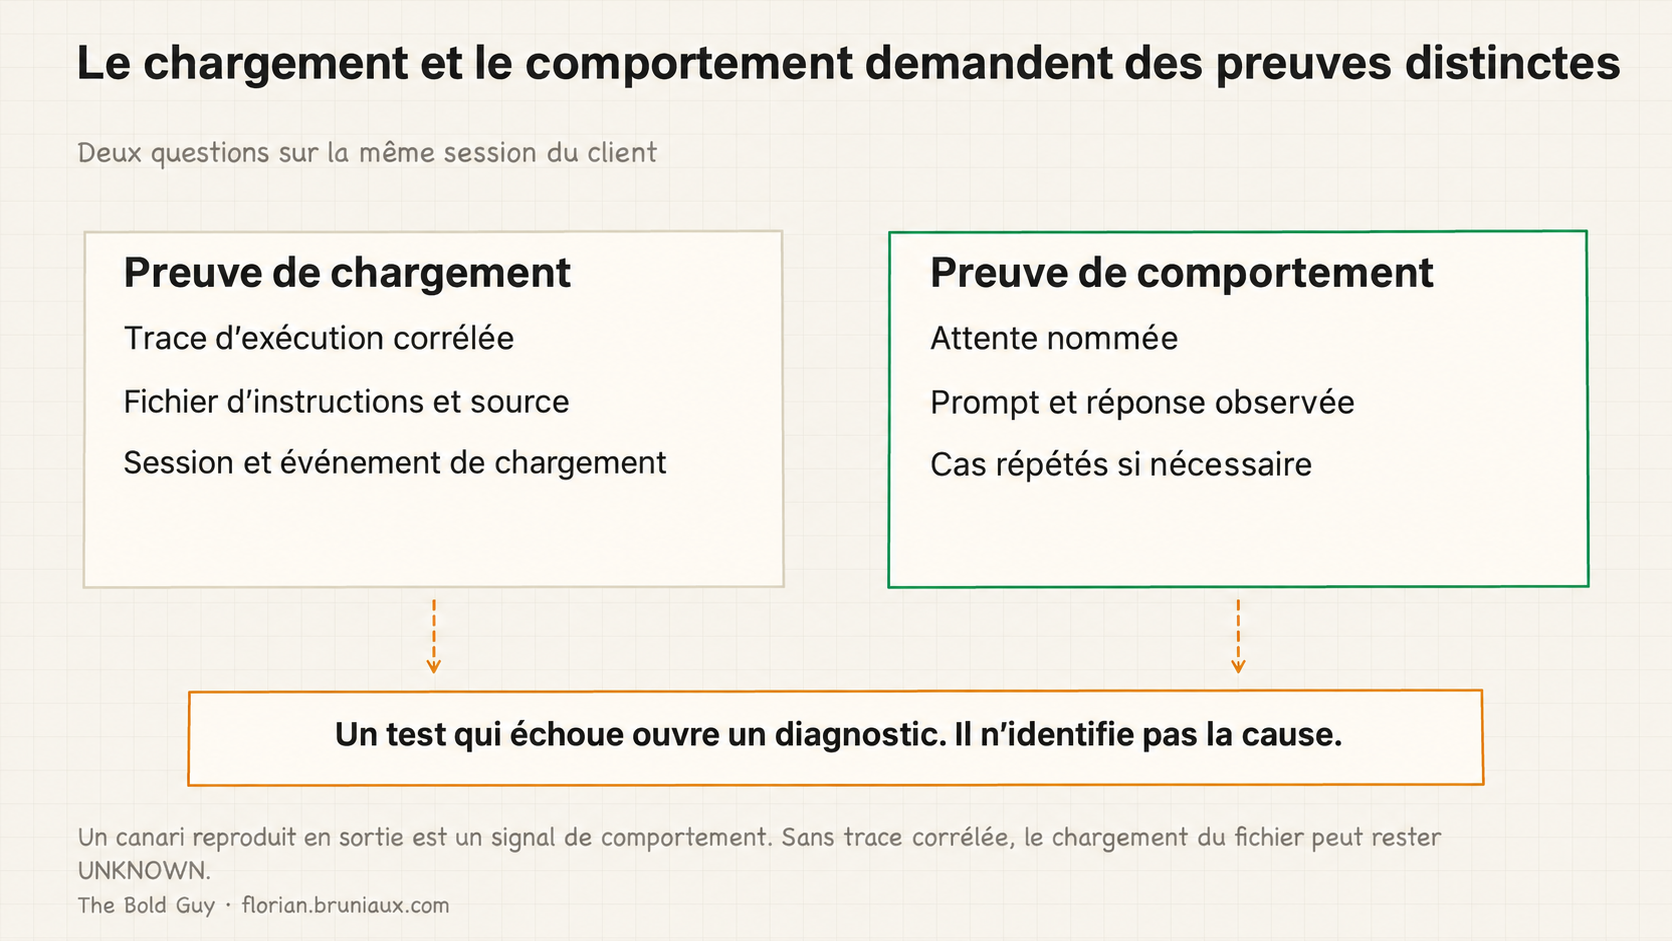
Ces prompts rendent testables les conventions architecturales de la section D. Réussir F1 à F5 établit les réponses attendues pour ces cas. Un échec identifie une convention à investiguer ; il ne distingue pas un chargement manquant d’instructions contradictoires, du comportement du modèle ou d’un test défectueux. Le chargement exige ses propres preuves corrélées.
Pour un contrôle continu, ai:drift:ci compare les modèles Prisma réels de schema.prisma et les routeurs tRPC de src/server/api/routers/ à ce qui est documenté dans modules/. Le workflow dans .github/workflows/ai-config-check.yml s’exécute à chaque push sur develop et sur les PR qui la ciblent, lorsque des chemins liés à l’IA changent. Étapes : valider, configurer, vérifier la dérive avec --fail-on-drift, générer la documentation et exécuter un script shell de contrôle canari. Un commit marqué [skip-drift] peut contourner l’étape de dérive ; DRIFT_WARN_ONLY=true la rend non bloquante pendant une restructuration active des modules. Ce contrôle de dérive est propre à notre stack ; sa partie indépendante de la stack, confronter les affirmations vérifiables d’une configuration à la codebase réelle, est ce que j’ai extrait dans ctxharness pour les projets sans pipeline personnalisé.
L’approche sous-jacente dispose d’une validation indépendante. Zineb Bendhiba décrivait la construction de contrôles de non-régression comportementale dès le premier jour en production, avec des seuils explicites de taux de réussite, parce qu’un comportement correct au lancement dérive silencieusement sans tests continus (ép. 326). Frédéric Barthelet étendait cela à ce qu’il appelait la CI/CD statistique : pour les systèmes non déterministes, rejouer les scénarios clés par lots de dix à cent et mesurer un taux de réussite plutôt qu’attendre des sorties identiques (ép. 329). Les prompts canaris F1 à F5 ci-dessus sont une application légère de ce schéma précis.
Exécuter délibérément ce cycle d’audit sous la forme d’un nettoyage structuré appelé Context Diet le 13/04/2026 a produit un résultat concret. La configuration toujours active est passée de 2 518 lignes à 646, soit 74 % de réduction. Le résultat pnpm ai:score est passé de 90 à 100 sur une grille de 120 points. Les résultats des canaris comportementaux sont passés de 10 contrôles de type canari réussis sur 14 à 14 sur 14. Les cinq prompts de la section F sont les diagnostics les plus ciblés, tandis que les neuf autres sont répartis dans les autres sections d’eval-ai-context. La configuration a rétréci et le comportement s’est affiné, le même constat contre-intuitif que l’article sur la discipline identifiait à l’échelle individuelle, confirmé à l’échelle de l’équipe.
- 1. ObserverRelier un échec récurrent à des preuves.
- 2. ÉvaluerDonner à la règle candidate un responsable et un cas de régression. Évaluer avant promotion.
- 3. MaintenirConsigner une décision de retrait réversible quand la règle cesse d’aider.
Un échec récurrent devrait produire une observation liée à des preuves, puis une règle candidate avec un responsable et un cas de régression. Transformer les commentaires de review récurrents en contrôles testés définit le seuil de promotion et les cas réservés à l’évaluation. Évaluez-la avant promotion et consignez une décision de retrait réversible lorsqu’elle cesse d’aider. Un invariant rare peut justifier le maintien malgré un faible usage. La vue d’ensemble de la configuration portable sépare cette décision de la distribution et de l’activation native.
Le guide Du code au merge suit cette boucle de retour à travers une PR : contrôles locaux, reviews consolidées, corrections bornées et résultats liés au commit mergé. Il montre comment le système d’instructions se relie aux décisions de review et de livraison de l’équipe.
Live AIDD : transmettre les changements par les rétrospectives
À 1:30:00 dans le live AIDD du 16 octobre 2026, je montre le portail de documentation que j’utilise pour expliquer notre travail avec l’IA chez Méthode Aristote. Je mets ses schémas à jour et discute les changements importants en réunion quotidienne ou hebdomadaire. Les erreurs récurrentes dans les PR deviennent matière à rétrospective et à une courte formation. Le retour circule aussi dans l’autre sens : mes collègues me signalent quand mes modifications de CI ont bloqué leur travail.
Le portail donne aux personnes une explication commune du workflow, à côté des instructions générées que reçoivent leurs agents. C’est une pratique que je décris dans le live, une intervention distincte de la conférence Dev With AI du 12 octobre. Elle ne fournit ni taux d’adoption mesuré ni comparaison avant/après des défauts. La source utilise des sous-titres automatiques et il lui manque quelques minutes au début.
Dans mon échange avec Bruno Soulez publié le 4 novembre, je raconte une erreur plus personnelle. J’avais verrouillé une ancienne version de modèle dans ma config, puis oublié ce choix. Quelques semaines plus tard, je voyais les autres contents des nouveaux résultats sans comprendre pourquoi je ne ressentais pas la même chose. J’ai fini par regarder ma propre configuration. Moi qui ai peur de rater une nouveauté, j’avais laissé passer celle-là.
Je repense aussi au conseil d’un ancien manager : faire beaucoup de veille, oui, mais sans déconcentrer toute l’équipe. Entre suivre les nouveautés et les partager, il faut choisir ce qui mérite de changer dans notre travail.
Ce que cela change
Un CLAUDE.md maintenu par une personne pendant quelques mois reste un fichier de configuration. Un système utilisé aujourd’hui par six développeurs, avec 445 commits de configuration sur ses dix premiers mois, un pipeline de synchronisation, un contrôle en CI et un skill d’audit à 113 prompts doit être traité comme une infrastructure. Il a des responsables, du versionnement, un processus de review et un moyen de savoir quand il casse.
En interne, l’analogie la plus proche est un schéma de base de données. On écrit des migrations, on les fait passer dans un pipeline et on valide le résultat. CLAUDE.md est une sortie générée depuis une source définie, maintenue par un processus et vérifiée automatiquement.
La pression de passage à l’échelle qui rend cette architecture nécessaire a un nom. Samy Lastmann la décrivait : essayer de tout faire passer par d’énormes prompts monolithiques fonctionne jusqu’à un certain point, mais ne passe pas à l’échelle, ne s’explique pas et ne produit pas de mesure fiable (ép. 311). Un système que l’on ne peut pas mesurer est un système que l’on ne peut pas maintenir, et l’isolation source/sortie décrite ici est précisément ce qui rend la mesure possible : vous savez ce qui a changé parce que vous savez ce que vous avez modifié.
Le même constat apparaît à plus grande échelle avec la même conclusion. Jocelyn N’takpe, chez ManoMano, décrivait l’utilisation de Claude Code par 250 développeurs pendant un an, avec pour levier le plus clair celui qui était aussi le plus évident : garder CLAUDE.md à jour, parce que plus le contexte est contraint, plus l’agent est efficace (ép. 346). Le passage à l’échelle amplifie le signal dans les deux sens.
La quatrième partie de cette série identifiait l’AI eval engineer comme l’un des rôles créés par la pratique. À l’échelle de l’équipe, ce rôle ressemble au processus Context Diet ci-dessus : mesure structurée, détection de dérive et vérification comportementale continues.
Pour éviter d’attacher cette pratique à un seul fournisseur d’IA, la sixième partie couvre la couche de portabilité : pourquoi les primitives natives survivent aux frameworks et comment les mêmes sources génèrent des configurations de runtimes différents sans contenu propre à un modèle dans les sources elles-mêmes.
Retours de terrain via les transcriptions d’épisodes IFTTD : Samy Lastmann, ép. 311 sur les limites des prompts monolithiques à l’échelle ; Zineb Bendhiba, ép. 326 sur la non-régression comportementale ; Frédéric Barthelet, ép. 329 sur la CI/CD statistique des systèmes non déterministes ; Jocelyn N’takpe, ép. 346 sur la maintenance du système d’instructions à l’échelle de 250 développeurs.
Si votre équipe a franchi le seuil où la configuration IA ressemble à une infrastructure plutôt qu’à une préférence personnelle, je serais curieux de savoir où était le point de bascule.
YSNK
(Vous devriez maintenant savoir)
- Une règle se charge automatiquement pour rappeler à quiconque modifie le projet que CLAUDE.md est généré : il faut modifier les sources et exécuter
pnpm ai:sync - Un profil de développeur sans modules optionnels s’assemble en environ 289 lignes contre 703 par défaut, soit 59 % de réduction par le seul périmètre explicite du profil
- Cinq prompts canaris comportementaux (F1 à F5) testent directement des conventions précises :
typecontreinterface, délégation tRPC à une couche de service, constantesselectdans les repositories, logger structuré plutôt queconsole.log, noms de fichiers en kebab-case. Chaque échec pointe exactement la convention qui a dérivé ai:drift:cicompare le schéma Prisma et les routeurs tRPC réels à ce que documentent les modules, et fait échouer la CI dès que réalité et documentation divergent- La grille actuelle de
eval-ai-contextcontient 113 prompts dans neuf sections et vaut 118 points ; les chiffres du Context Diet d’avril 2026 utilisent l’ancienne grille de 120 points et restent étiquetés comme résultats historiques
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source