Coder plus vite déplace le coût vers la vérification
L'IA peut raccourcir l'implémentation tandis que spécification, review, CI et reprises absorbent le temps gagné. Instrumenter le flux complet avant d'ajouter de la génération.
Aller au résumé ↓ Florian Bruniaux
Engineering the Review Loop · Partie 1/8
TL;DR
Je mesurerais où une modification attend et revient en correction avant d’ajouter un agent auteur supplémentaire. Une génération de code plus rapide n’aide la livraison que si vérification et release peuvent traiter le résultat avec une qualité et un coût total acceptables.
| Décision | Points à inspecter |
|---|---|
| Traiter une écriture du code plus rapide comme une accélération locale | Suivre spécification, review, CI et déploiement, puis mesurer séparément stabilité opérationnelle et résultat produit visé |
| Trouver la file, pas la personne la plus occupée | Répartir le temps écoulé par étape et séparer travail actif et attente |
| Garder DORA comme couche de résultats de livraison | Ajouter des signaux de review, CI et reprises pour expliquer les changements de débit ou d’instabilité du service |
| Traiter l’exemple de workflow comme une hypothèse | Un scénario construit explique quoi mesurer ; il ne fournit aucun volume, économie ou résultat avant/après observé |
| Décider à l’étape Build sur des preuves | Instrumenter 1 service avant d’ajouter un agent auteur supplémentaire ou une couche de review supplémentaire |
Une génération de code plus rapide est une accélération locale. La livraison est une propriété de tout le système.
L’IA peut raccourcir la rédaction sans changer le rythme auquel une équipe spécifie, vérifie, revoit, intègre et livre les modifications. Si le code généré atteint ces étapes plus vite qu’elles ne le traitent, le temps gagné réapparaît en file d’attente : l’équipe produit plus de modifications candidates tandis que le délai reste stable, les exécutions CI se multiplient ou les reviewers absorbent la différence.
DORA a publié des preuves directes de ce schéma le 10 mars 2026. Ses chercheurs ont mené une analyse thématique de 1 110 réponses ouvertes d’ingénieurs logiciels Google, collectées au troisième trimestre 2025, sur l’effet des outils IA sur leur workflow pendant les 3 mois précédents. Les répondants décrivaient souvent du temps gagné à la création puis dépensé à nouveau en vérification et prompts. DORA note que les questions précédentes ont pu les orienter vers la génération de code. La source montre que des ingénieurs d’une entreprise ont rapporté ce déplacement de coût. Elle ne montre pas que toute équipe assistée par IA a le même goulot.
Le code peut encore être la contrainte. Un développeur qui découvre un système, implémente un algorithme difficile ou travaille sans automatisation utile peut consacrer l’essentiel du cycle à produire la modification. Une fois la rédaction accélérée, il faut trouver l’étape qui contrôle désormais la livraison. Lean et IA suit cette question au-delà de la livraison logicielle, jusqu’au résultat utilisateur ou service.
Comment lire les preuves de cette série. Chaque affirmation porte 1 de ces étiquettes, en mots ou dans une colonne de statut. Documenté signifie qu’une source primaire le déclare. Preuves bornées signifie qu’une étude ou enquête l’étaye dans son propre protocole. Déclaration de l’auteur signifie qu’une personne décrit sa conception ou son expérience. Déclaration du fournisseur signifie qu’une entreprise décrit son produit. Exemple construit signifie un scénario conçu pour expliquer quoi mesurer. Protocole proposé signifie une méthode recommandée par la série mais non encore exécutée. Non mesuré signifie qu’aucun enregistrement n’existe encore.
Une pull request ne couvre qu’une partie du flux de livraison
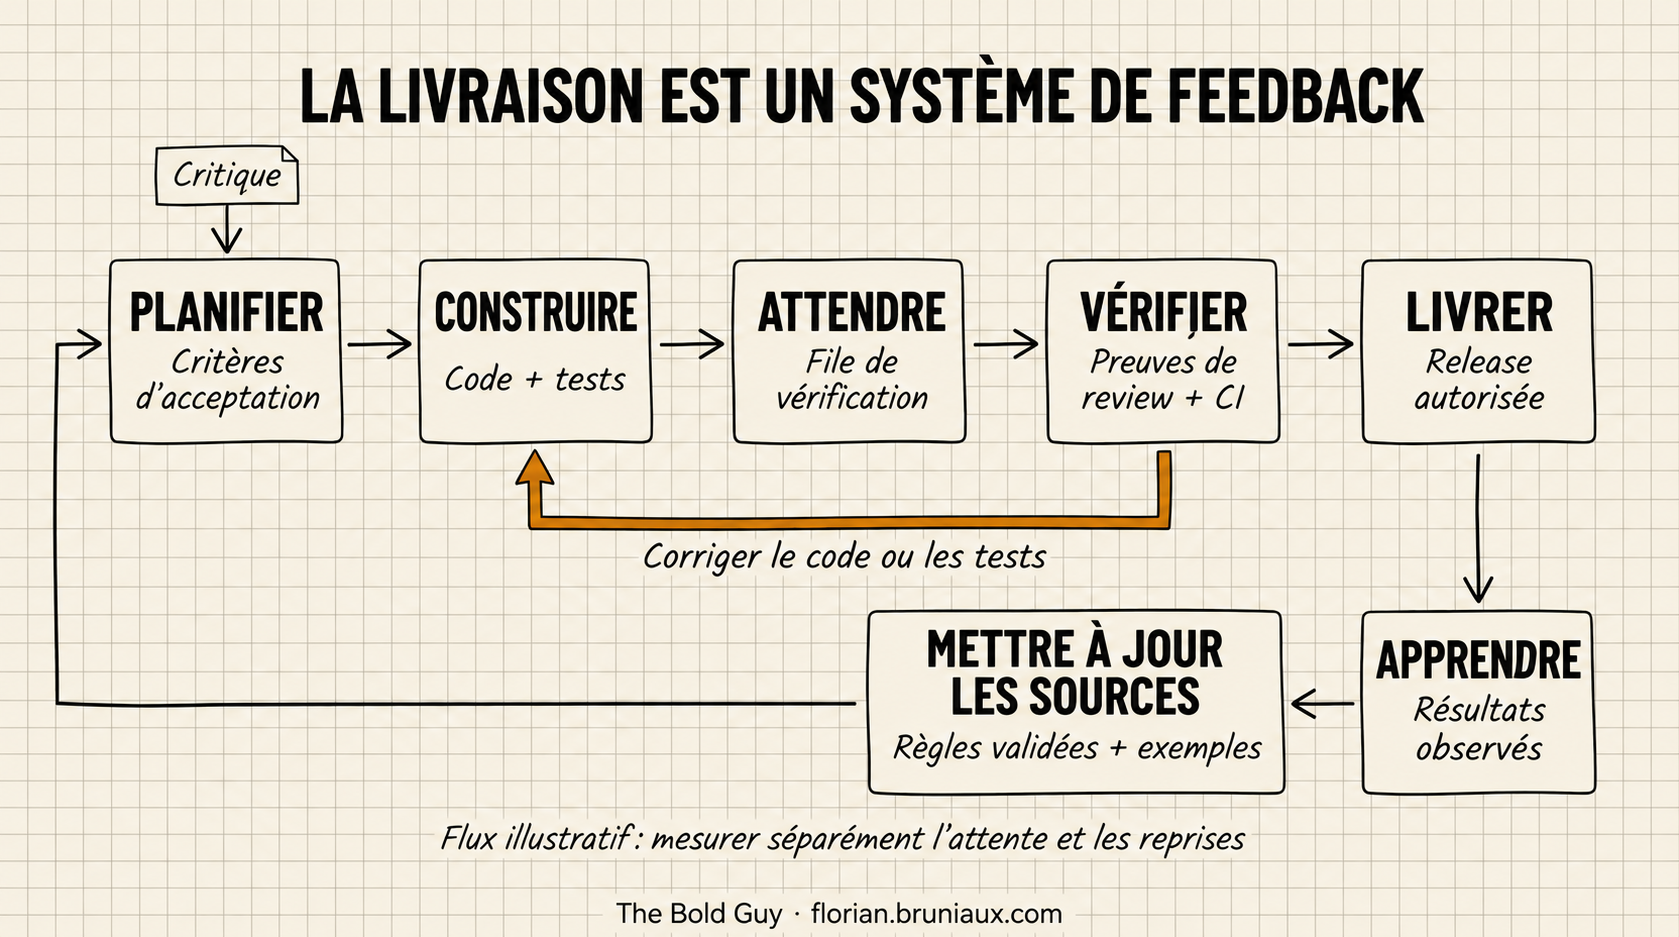
Une modification franchit plusieurs frontières avant de pouvoir juger ses effets opérationnels et produit :
- L’équipe s’accorde sur l’intention et les critères d’acceptation
- L’auteur ou l’agent produit une modification candidate
- Les contrôles locaux testent syntaxe, types, comportement et politique
- L’auteur déclare la modification prête pour review
- Un reviewer comprend l’intention et évalue le diff
- La CI exécute les contrôles qui relèvent d’un environnement reproductible
- Une personne ou politique autorisée permet merge et déploiement
- Les preuves de production révèlent si la modification a causé des corrections
- L’équipe observe le résultat utilisateur, service ou métier prédéfini pendant la fenêtre déclarée
Chaque frontière peut contenir travail actif et attente. Une review peut être brève après une bien plus longue file, et un job CI peut attendre un exécuteur plus longtemps qu’il ne tourne. Réduire les deux intervalles à « PR time » (traduction : « temps de PR ») indique une livraison lente mais cache ce qu’il faut changer.
La rédaction a la même ambiguïté. Un agent peut produire vite un diff, puis passer plusieurs cycles à réparer des tests, résoudre des commentaires ou réconcilier un besoin vague. Compter seulement le premier diff récompense la sortie précoce et omet le travail pour la rendre acceptable.
Chaque passage devrait laisser un artefact inspectable par l’acteur suivant : critères d’acceptation, plan avec questions non résolues, code et tests, enregistrement de review et preuves de release. Les flèches reviennent aussi en arrière. La critique révise le plan, un constat confirmé change code ou tests et une leçon arbitrée propose une mise à jour des instructions ou exemples de la tâche suivante, validée avant distribution.
DORA donne la couche de résultats, pas tout le diagnostic
Les métriques DORA actuelles de livraison logicielle, mises à jour par DORA le 5 janvier 2026, utilisent 5 mesures pour 1 application ou service :
- Délai des changements, fréquence de déploiement et délai de rétablissement après l’échec d’un déploiement décrivent le débit
- Taux d’échec des changements et taux de reprises de déploiement décrivent l’instabilité
Ces mesures restent utiles avec l’IA. Le délai des changements va du commit à la production : il capture donc les délais de review, CI et déploiement après commit. Le taux de reprises compte les déploiements non planifiés causés par des incidents de production. Ensemble, les 5 mesures montrent si le service livre les modifications vite et sûrement.
Elles ne montrent pas quelle étape avant déploiement a absorbé le temps. Le délai des changements exclut la spécification et tout travail avant le premier commit. Une fréquence de déploiement stable peut cacher une file de review grandissante, et un merge rapide peut cacher une review superficielle. Les consignes d’implémentation DORA recommandent de cartographier le processus de livraison et d’ajouter des indicateurs avancés, comme la durée de code review ou la qualité des tests, pour diagnostiquer la contrainte principale.
Utilisez DORA comme couche de résultats, puis ajoutez des signaux de workflow expliquant leurs mouvements, sans remplacer un indicateur indirect par un autre. Une cible de temps de review peut être contournée en approuvant plus vite, comme une cible de lignes de code en produisant de plus gros diffs.
| Affirmation | Statut | Périmètre |
|---|---|---|
| DORA définit actuellement 5 métriques de livraison au niveau service | Documenté | Guide officiel mis à jour le 5 janvier 2026 |
| Des ingénieurs rapportaient un transfert du temps de création vers vérification et prompts | Preuves bornées | 1 110 réponses ouvertes d’ingénieurs Google, qualitatives |
| Une rédaction plus rapide peut augmenter la file de vérification | Exemple construit | Le scénario ci-dessous n’est pas un résultat d’équipe observé |
| Déplacer une partie de la review avant la CI distante réduit le coût total de livraison | Non mesuré | Exige des enregistrements locaux, distants et de reprises liés sous une règle d’acceptation comparable |
Tester l’hypothèse sur un seul flux de livraison
Prenons un exemple construit : un agent prépare les modifications plus vite, tandis que disponibilité des reviewers et capacité CI restent fixes. L’équipe corrige certains défauts seulement après push, et chaque révision déclenche une nouvelle exécution distante des tests.
L’exemple suggère 2 hypothèses. Une rédaction plus rapide peut augmenter le taux d’arrivée en vérification, et déplacer certains contrôles avant push peut réduire les exécutions distantes évitables. Aucune n’établit un coût total inférieur. Les contrôles locaux consomment aussi des ressources, et moins d’exécutions distantes n’est pas un gain si des défauts échappent aux contrôles ou si rédaction et review humaine coûtent plus cher.
Preuves requises pour un cas mesuré : définir période d’observation, modifications et contributeurs uniques, distribution des tailles, délais par étape, coûts d’exécution locaux et distants, et règle d’attribution des reprises après merge. Comparer le même service avec les mêmes critères d’acceptation et déclarer les changements concomitants de workflow.
Le scénario aide à choisir les enregistrements à collecter. Eux seuls peuvent étayer une affirmation sur le goulot ou les économies d’une équipe.
Live AIDD : une facture CI et une limite de concurrence
Dans le live AIDD du 16 octobre 2026, à 02:00, je rapporte environ 2 000 $ par mois de CI et des attentes approchant parfois 30 minutes avec notre limite de concurrence. L’équipe décrite compte deux développeurs seniors et trois product builders. À 09:00, j’explique que le compte de PR inclut dépendances et maintenance, et reconnais un mauvais réglage du parallélisme des tests. Volume et configuration contribuent tous deux au cas. Ce sont mes chiffres déclarés, sans factures, historique de jobs ou comparaison contrôlée joints ; ils n’établissent pas d’économie due aux contrôles locaux.
La discussion à 31:00 expose un autre coût : corriger un petit constat de qualité peut relancer tout le pipeline. Je discute dette acceptée et relances ciblées, puis rapporte la réintroduction de problèmes après réduction des contrôles à 34:00. La sélection reste un travail en cours. Classez cause et comportement affecté avant de compter une relance comme évitable.
La discussion produit à 38:00 ajoute une limite distincte : préparation des PRD et livraison accélérées ont laissé des expériences peu utilisées dans le produit. La capacité de livraison exige toujours sélection, retours utilisateurs et nettoyage. Ces ajouts viennent de la session AIDD, distincte de ma conférence Dev With AI du 12 octobre. Ses sous-titres automatiques et son début incomplet limitent la source ; le guide bilingue de la conférence conserve la discussion plus large.
Utiliser les échecs de review pour changer le travail en amont
Dans l’épisode 362 d’IFTTD, Yacine Hmito décrit l’implémentation accélérée déplaçant la pression sur le contrôle qualité. Son cadre Lean traite la review comme un moyen de comprendre pourquoi le travail défectueux apparaît et de changer sa production, plutôt que de laisser le code s’accumuler en attente d’inspection. Dex Horthy, vers 6:20, dit que la code review agentique et les tests de régression accélèrent cette étape tout en la laissant probablement comme goulot. Les deux sont des témoignages de praticiens, pas des mesures de débit.
La description du système de production de Toyota précise l’analogie. Le Just-in-Time ne produit que ce dont le processus suivant a besoin, au moment nécessaire. Le jidoka détecte une anomalie, arrête le travail affecté et change le processus pour éviter sa réapparition. Dans cette adaptation, l’équipe limite la nouvelle rédaction à ce que reviewers et CI peuvent vérifier, suspend les nouvelles entrées lorsque cette capacité est épuisée et transforme les défauts récurrents confirmés en contrôles testés. Une alerte sans règle d’arrêt rend seulement la file visible. C’est une adaptation logicielle proposée, pas un résultat mesuré équivalent à Toyota.
Une étude longitudinale d’une obligation de coder avec l’IA en entreprise ajoute une observation utile sans fournir de ratio universel de capacité. Sur 802 développeurs et 196 212 pull requests, le débit de PR mergées par personne a atteint 2,09 fois le niveau antérieur à la consigne en avril 2026, tandis que la charge par reviewer doublait à peu près. Les auteurs rapportent des taux stables de merge et revert, mais ne revendiquent pas d’attribution causale exacte à l’adoption de l’IA et ne mesurent pas la valeur livrée par ces PR.
La conclusion de saison IFTTD de Bruno Soulez (archivée le 13 septembre 2026) propose de commencer par la validation avant d’étendre la génération, et présente cet ordre comme sa propre lecture. La version opérationnelle est plus étroite : suspendre la rédaction nouvelle lorsque la file de vérification partagée dépasse sa capacité convenue, laisser avancer reviews et corrections existantes, et reprendre sous une condition déclarée. Un budget par exécution d’agent ne borne pas la file totale.
La partie 5, Transformer les commentaires de review récurrents en contrôles testés, couvre la réponse en amont : les corrections acceptées qui reviennent deviennent candidates à des tests, exemples ou règles, chacun avec sa propre validation.
Mesurer la file et les cycles de correction
Un premier tableau de bord utile est assez petit pour être maintenu et assez détaillé pour localiser l’attente. Définissez chaque horodatage avant collecte. En particulier, « ready for review » (traduction : « prêt pour review ») devrait être un événement explicite, pas la création de la branche ou de la pull request.
| Signal | Définition | Ce qu’il peut révéler | Ce qu’il ne peut pas prouver |
|---|---|---|---|
| Temps de spécification | Critères d’acceptation convenus moins demande de travail | Ambiguïté ou délai de décision avant implémentation | Qualité de la spécification |
| Temps de rédaction | Prêt pour review moins début d’implémentation | Effort actif et écoulé avant review | Valeur livrée ou justesse |
| Attente de review | Première review substantielle moins prêt pour review | Profondeur de file et disponibilité des reviewers | Qualité de review |
| Cycles de review | Nombre de demandes de changements suivies d’une nouvelle révision | Charge de réconciliation et besoins instables | Qui a causé les reprises |
| File et exécution CI | Début de l’exécuteur moins demande, puis fin moins début | Attente de capacité et durée de calcul réelle | Couverture des bons comportements |
| Relances CI par modification | Exécutions terminées liées à la même pull request et à l’historique de révisions | Cycles répétés de retours distants | Relances évitables sans classification |
| Coût CI par modification | Frais fournisseur ou temps d’exécuteur facturé attribué à la pull request et au SHA du commit, avec workflow et classe d’exécuteur | Dépense de chaque candidat livré | Dépense évitable avant classement des relances par cause |
| Fraîcheur des données de sélection de tests | Disponibilité du résultat pour le service de sélection moins fin d’exécution CI | Décisions de sélection fondées sur un historique périmé | Couverture du bon comportement par les tests sélectionnés |
| Attente de merge et déploiement | Merge ou déploiement moins disponibilité de toutes les preuves requises | Délai d’approbation, de fenêtre de release ou d’environnement | Valeur produit |
| Taux de reprises de déploiement | Ratio DORA des déploiements non planifiés dus aux incidents de production | Travail correctif après échec de production | Cause racine sans lien à l’incident |
| Résultat produit visé | 1 mesure utilisateur, service ou métier définie avant le changement pour une population et une fenêtre nommées | Évolution du résultat visé pendant cette fenêtre | Causalité sans comparaison adaptée |
Pour les durées, inspectez la médiane et un percentile de la queue de distribution plutôt que la seule moyenne. Quelques modifications bloquées peuvent dominer une moyenne, tandis que la médiane seule peut cacher la file qui nuit au travail le plus risqué. Segmentez par taille et classe de risque. Si l’attribution IA est disponible, publiez sa définition et sa couverture avant de comparer modifications assistées et non assistées : une étiquette incohérente crée un faux groupe témoin.
Les cycles de review exigent une classification, pas des accusations. Séparez au moins les corrections de spécification, les défauts d’implémentation, les échecs de tests ou les manquements aux règles et les désaccords entre reviewers. Ces catégories indiquent s’il faut améliorer l’entrée, ajouter un contrôle déterministe, clarifier les responsabilités ou changer le contrat de review.
Le coût CI exige la même discipline. Reliez chaque exécution à une pull request, un SHA, un workflow, une classe d’exécuteur et un état final. Un job vert prouve que ses contrôles déclarés passent sur ce SHA. Il ne prouve pas que la review a couvert toute la modification, que le job était requis pour merger ou que le comportement produit était correct.
Quand la CI est contrainte, la sélection de tests peut réduire le travail répété. Le récit d’Anthropic du 14 septembre 2026 décrit un collecteur enregistrant les résultats et un sélecteur utilisant cet historique. Doubler les cœurs a tenu 70 jours, le découpage en shards 29, et les redémarrages moins d’un jour. Un retard de 20 minutes du collecteur pouvait laisser des dizaines de milliers de mises à jour non appliquées, y compris des tests nouveaux ou corrigés. Cela motive d’enregistrer la fraîcheur des données de sélection séparément du fait que la CI ait tourné.
Son graphique montre la stabilisation du retard de résultats en file après bascule. L’auteur décrit la nouvelle architecture comme plus chère à exploiter et rapporte 3 semaines de travail par 1 ingénieur, sans comparaison numérique du coût de livraison. Le graphique ne mesure pas une livraison plus rapide ou moins chère.
N’admettre le travail que s’il peut être vérifié
Le récit de Johan Martinsson sur la review de PR écrites par IA relie une file grandissante à une perte de travail créatif. Il n’établit pas une perte générale de productivité, mais pose une question de capacité : qui peut vérifier le prochain résultat, avec quelles preuves et dans quel délai ?
Avant d’augmenter la rédaction parallèle, nommez ce vérificateur et utilisez sa disponibilité déclarée. Admettez, réduisez ou reportez la tâche. Un report exige responsable, raison et condition de reprise, et un travail reporté plusieurs fois exige une décision explicite.
Lauren Tan décrit un transfert concret de ce travail dans sa conférence sur la livraison assistée par agents, à 04:47 : « I am the bottleneck. »1 Traduction : « Je suis le goulot d’étranglement. » À 09:19, elle décrit une CLI réutilisable permettant aux agents de lancer l’application et collecter les preuves plutôt que de créer un autre script de vérification à chaque session. Le skill create-verification-skill de Pstack en fait une procédure propre au projet avec instructions de pilotage et preuves conservées. Son récit illustre le transfert possible de la vérification dans les outils ; il n’établit pas de réduction mesurée du coût total de livraison.
Inclure les tentatives échouées dans le coût du travail accepté
Are Harnesses Worth the Cost?, expérience de Naresh Jain du 13 octobre 2026, rend ce problème comptable concret. Sur un service Java, dix exécutions par condition, effort de raisonnement faible et tests externes d’acceptation identiques, un harnais comportemental a fait passer l’acceptation de Luna de 3/10 à 10/10. Sol obtenait 10/10 avec ou sans, tout en consommant davantage de ressources avec. Les coûts de génération rapportés excluent installation, maintenance et réparations. Ce sont des preuves pour ces conditions, pas une mesure de notre workflow de review.
The Scaffold Effect exécute 2 modèles, Qwen 3.6 Plus et MiniMax M2.5, dans 3 harnais sur 50 tâches Terminal-Bench Pro et trouve jusqu’à un facteur 40 de différence en tokens par tâche résolue selon le harnais. C’est un résultat d’efficience dans son protocole, pas une économie de facture ou de temps de review pour une équipe.
Définissez la fenêtre comptable avant de calculer le coût par modification acceptée. Incluez tentatives échouées et abandonnées au numérateur et comptez chaque modification acceptée une fois au dénominateur. Gardez séparés les frais d’inférence, la CI et l’infrastructure, la review humaine et les reprises tant qu’une règle de conversion déclarée ne les rend pas comparables, et rapportez la règle d’acceptation et la taille d’échantillon avec le résultat. Si aucune modification n’est acceptée, rapportez ce résultat et les ressources dépensées plutôt que de masquer l’exécution par un coût moyen faible par appel.
Comparer un service à sa propre référence
La mesure peut changer les personnes et les éléments inclus dans la comparaison. Dans sa mise à jour expérimentale du 24 février 2026, METR rapporte que les développeurs refusaient de plus en plus les tâches à tenter sans IA, tandis que le travail parallèle d’agents compliquait le relevé du temps. Il traite les données récentes comme preuves faibles de l’ampleur de l’accélération à cause de ces effets de sélection. Le ralentissement antérieur de 19 % reste un résultat concernant les outils de début 2025 et la population étudiée. Ma comparaison des résultats d’Anthropic et METR garde leurs résultats différents séparés. Pour une expérience de boucle de review, consignez tâches exclues et travail humain superposé avant d’interpréter la durée.
Partez de 1 application ou service, selon le périmètre DORA. Capturez le flux actuel avant de changer le workflow, puis introduisez 1 intervention bornée : contrôle local déterministe avant premier push ou limite de taille des lots revus, par exemple.
Comparez les distributions, pas un chiffre principal isolé. Un résultat utile précise fenêtres d’observation, nombre et taille des changements, événements manquants, évolutions de composition d’équipe ou de politique et définition de chaque étape. Si l’attente de review baisse tandis que la rédaction augmente légèrement, le total peut encore s’améliorer. Si la dépense CI baisse mais les reprises de déploiement augmentent, l’équipe a retiré du coût au mauvais endroit.
Comptez les frictions ajoutées par le harnais dans la même comparaison :
| Coût ajouté | Éléments à conserver |
|---|---|
| Faux blocages | Modifications valides arrêtées, contrôle responsable et temps de résolution |
| Approbations redondantes | Confirmation répétée d’une action inchangée sans nouvelle preuve ni frontière d’autorité |
| Surcoût de contexte | Instructions chargées, contenu inutile et tout effet observable sur l’accomplissement de la tâche |
| Maintenance | Temps passé à mettre à jour, diagnostiquer, évaluer et retirer les contrôles |
Utilisez les mêmes critères d’acceptation pour la référence et le workflow candidat. Une protection rarement invoquée peut encore imposer un invariant nécessaire ; gardez donc ses exemples autorisés et interdits et son responsable. Un faible nombre d’invocations seul ne justifie pas le retrait.
La corrélation suffit à localiser une contrainte candidate, pas à attribuer la cause. Un nouveau reviewer, un gel de release, moins de contributeurs, des PR plus petites ou un changement de CI peuvent tous déplacer la même mesure. Consignez ces changements à côté du graphique plutôt que d’écrire après coup un récit causal.
Cette comparaison donne aussi la règle d’arrêt de l’ajout de génération. Si la file de rédaction est vide tandis qu’attente de review, cycles de correction ou relances CI augmentent, un autre agent auteur ne fait qu’augmenter le taux d’arrivée à l’étape contrainte ; améliorez ou bornez donc la vérification d’abord. Si la rédaction domine encore le temps de bout en bout et que les signaux en aval restent stables, davantage de capacité de rédaction peut aider.
Décider quel jugement déléguer
Une fois la file visible, la question suivante est qui juge quoi. Tangi Vass, créateur de Liza, donne la réponse du projet dans son README : la délibération d’agents est abondante tandis que l’attention humaine est rare ; le contrat de Liza « relocates that work into agent reasoning and review, so human attention can go to direction and domain decisions. » Traduction : « déplace ce travail vers le raisonnement et la review des agents, pour que l’attention humaine puisse aller à la direction et aux décisions de domaine ». Dans un post LinkedIn, il décrit une première passe comme 1 exécution autonome de livraison incluant ses cycles internes de correction. Les deux décrivent sa conception. Aucun ne compare les défauts ayant échappé aux contrôles ou le coût de review.
Toute répartition exige une politique des changements pouvant avancer et des preuves de ce qu’elle accepte. Un petit diff peut changer une autorisation ou interagir avec une autre petite PR ; classez donc le changement combiné et son chemin de récupération plutôt que le nombre de lignes. Gardez l’attention humaine sur les décisions de domaine et les conséquences que les tests et reviewers actuels n’ont pas montré pouvoir couvrir. La section du guide sur la répartition explicite du jugement développe cette frontière.
L’acceptation produit est distincte de la review technique. Dans Practical Loop Engineering, Addy Osmani raconte avoir demandé aux agents d’étudier les concurrents et préparer des changements candidats, puis jugé que la complexité ajoutée pour les utilisateurs dépassait le gain. Une modification implémentable exige encore que quelqu’un décide de sa place dans le produit, avant de compter les tâches d’agents terminées comme production utile.
Les fabriques logicielles héritent de la même contrainte
Une fabrique logicielle peut coordonner beaucoup d’exécutions de rédaction, mais son débit dépend encore de ce qui accepte ou rejette leurs sorties. Plus d’agents augmentent les modifications candidates. Ils n’ajoutent ni attention de reviewer, ni spécifications exécutables, ni capacité d’exécuteurs, ni autorité de release.
Le même récit rapporte 10 fois plus de tests et 25 fois plus de jobs CI en 6 mois, avec une croissance limitée des effectifs. Tous les tests ne tournent pas sur chaque PR ; ces chiffres ne se multiplient donc pas. L’activité nocturne des agents augmentait aussi la charge de fond. Le récit ne fournit aucun ratio de capacité applicable à une autre équipe.
La vérification appartient donc à la conception du système, à 3 horizons utilisés dans la suite de la série. La boucle interne détecte les échecs bon marché pendant le travail de l’agent. La boucle externe évalue le changement à la frontière de la tâche ou de la pull request. La méta-boucle transforme les échecs récurrents en tests, règles ou autres contrôles durables. Ces horizons aident à placer les retours ; ils ne garantissent pas leur justesse.
Le récit de fabrique logicielle d’Uber Engineering décrit aussi le transfert du travail répété du cycle de développement vers des agents gérés, chacun avec métriques de résultats et benchmark d’évaluation. Pour ce flux, l’unité testable serait 1 tâche répétée avec autorité d’acceptation nommée, parcours d’escalade et échecs conservés. Comparez ses résultats acceptés et le coût total de vérification avant d’augmenter le nombre de tâches exécutées en parallèle. C’est un test local proposé ; le récit d’Uber ne valide pas la capacité de cette équipe et ne supprime pas sa décision de release.
La décision à l’étape Build est d’instrumenter le flux avant d’étendre la production : trouver où le travail attend, mesurer ce qui revient en correction et définir les preuves permettant à une modification d’avancer. La partie 2, Quand un reviewer indépendant justifie sa place, examine 1 frontière de vérification de ce système sans traiter un second modèle comme preuve de justesse.
YSNK
(Vous devriez maintenant savoir)
- Une rédaction plus rapide peut déplacer le coût de livraison vers spécification, review, CI et reprises
- Les 5 métriques DORA montrent débit et instabilité au niveau service mais exigent des signaux de workflow pour le diagnostic
- Production candidate, modification livrée, stabilité opérationnelle et résultat produit exigent des mesures séparées
- Scénarios construits et contrôles installés n’établissent pas un goulot ou une économie mesurés
- Instrumenter 1 service et ses cycles de correction avant d’ajouter de la capacité de rédaction
Footnotes
-
La citation suit les sous-titres anglais automatiques originaux de la vidéo, vérifiés le 3 novembre 2026 par comparaison avec l’archive du 15 octobre. Le repère temporel localise le passage ; c’est un témoignage attribué de praticienne, pas un résultat mesuré indépendamment. ↩
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.