Context engineering : le playbook de L0 à L5
Choisissez les contrôles de contexte de L0 à L5 selon l’échec observé, de la documentation projet aux règles à portée limitée, contrôles comportementaux et configuration partagée.
Aller au résumé ↓ Florian Bruniaux
Ce que vous en retirez
- ✓ Identifier la capacité de contexte manquante et l’échec qu’elle peut aider à traiter
- ✓ Distinguer les recommandations de taille de fichier du respect mesuré des instructions
- ✓ Appliquer la portée par chemins et mesurer la réduction de contexte dans votre projet
- ✓ Mettre en place un contrôle canari et une boucle ACE avec preuves séparées de chargement et de comportement
- ✓ Disposer d’une règle de décision entre règles et skills
Prérequis
- → Claude Code installé (niveau 1 du guide de configuration)
- → Un fichier CLAUDE.md, même basique
TL;DR
Je recommande de corriger l’échec observable avant d’ajouter de la structure : si votre CLAUDE.md fait moins de 100 lignes et que vous corrigez toujours des conventions de base, ajoutez du contenu ; au-delà de 200 lignes et s’il continue de grandir, ajoutez la portée par chemins (L3) avant toute règle, sauf si une configuration partagée entre plusieurs personnes impose déjà L5. Beaucoup d’équipes que je vois sont à L0-L1, quelques-unes à L2 : pour beaucoup de lecteurs, la suite est un meilleur CLAUDE.md ou des règles à portée limitée, pas de l’infrastructure. Je m’attends à voir le context engineering absorbé comme discipline par le harness engineering, tandis que « context engineer » deviendra un véritable titre de poste dans les deux ans pour ceux qui le portent.
Un CLAUDE.md existe dans la plupart des installations Claude Code après la première semaine. Les gens y notent gestionnaire de packages, commande de test, quelques conventions et pensent la configuration réglée. Trois mois après, les sorties sont médiocres sans cause claire. Claude continue de proposer npm install plutôt que pnpm, génère pour une API dépréciée au huitième sprint ou suit une règle de façon variable selon l’avancement de la session.
Ces symptômes n’établissent ni cause unique ni seuil de taille. Les conventions peuvent être périmées, sans rapport avec la tâche, absentes du contexte chargé ou présentes mais non suivies. Examinez ces possibilités séparément.
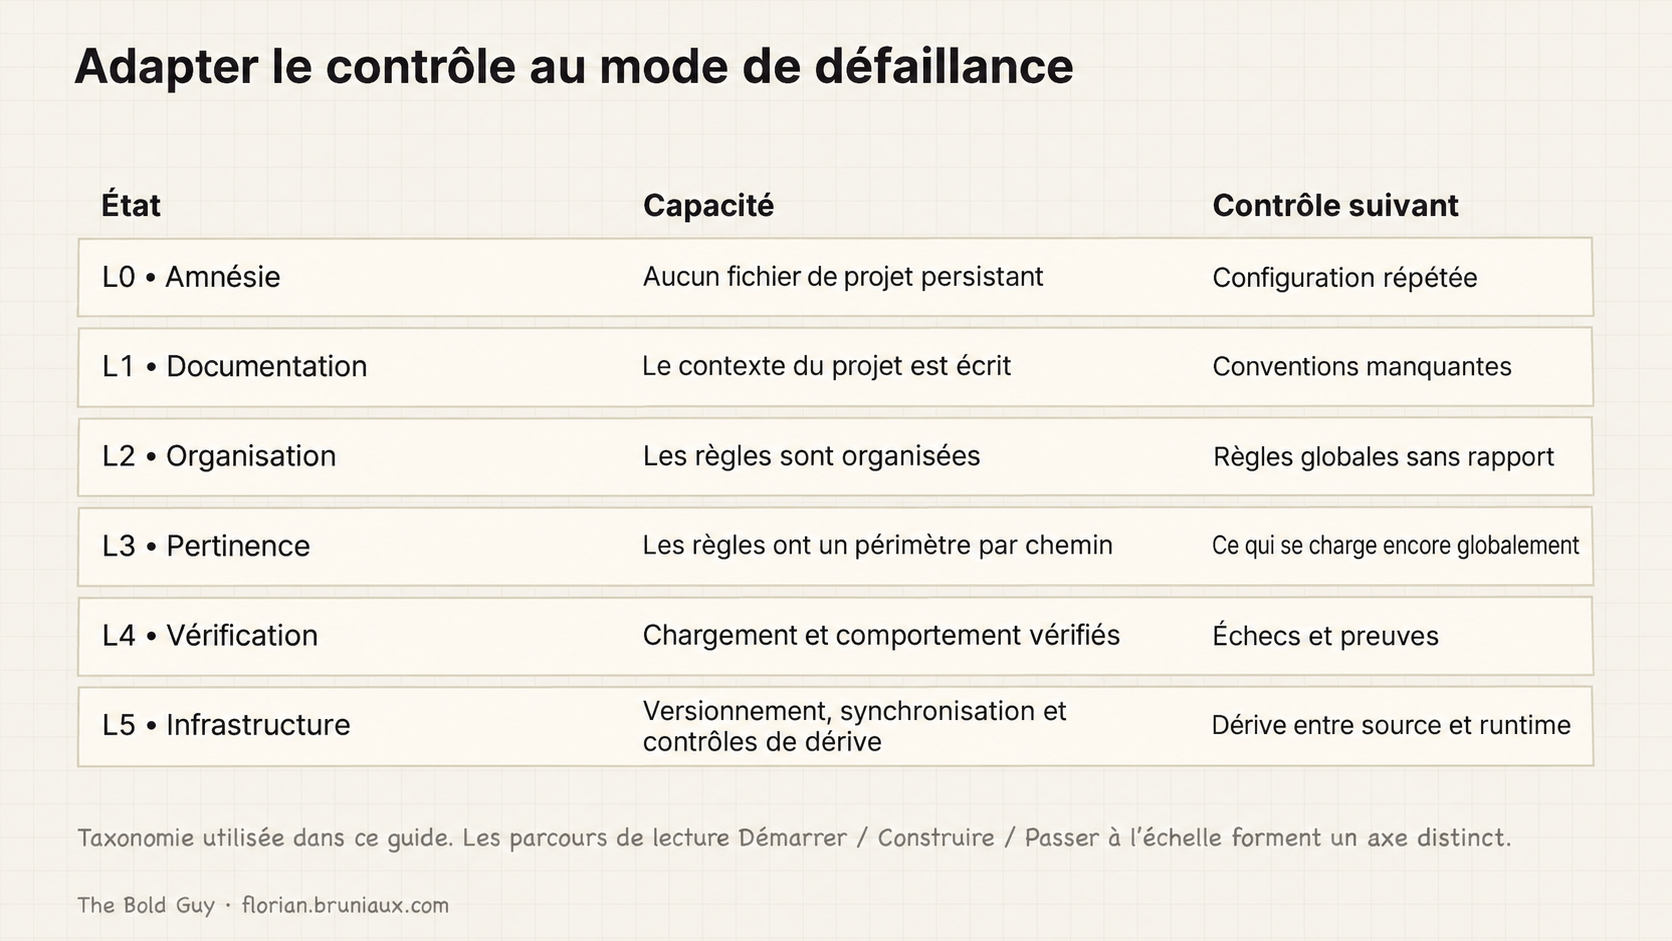
Les six états ci-dessous nomment des capacités de contexte et les échecs qu’elles peuvent aider à examiner. L3 traite la pertinence. L4 vérifie séparément chargement de configuration et comportement observé. L5 ajoute versionnement, synchronisation et CI quand plusieurs personnes ou outils partagent la configuration. Ce guide est le playbook d’exécution : aspect concret de chaque état, échecs associés et étape changeant la condition opérationnelle. Pour la recherche sur la dégradation du respect des règles et la mesure de dérive, voir le diagnostic de dérive de CLAUDE.md.
L0 à L5 décrit les capacités internes du système de contexte. Les parcours Start, Build et Scale répondent à une autre question : le besoin du lecteur dans ses conditions d’adoption actuelles. Les axes sont indépendants. Un lecteur Start peut avoir besoin de L3 pour garder une tâche compréhensible. Une équipe Scale peut conserver une configuration L2 contrainte et y ajouter responsabilité et audit.
Les recommandations de taille ne sont pas un seuil universel
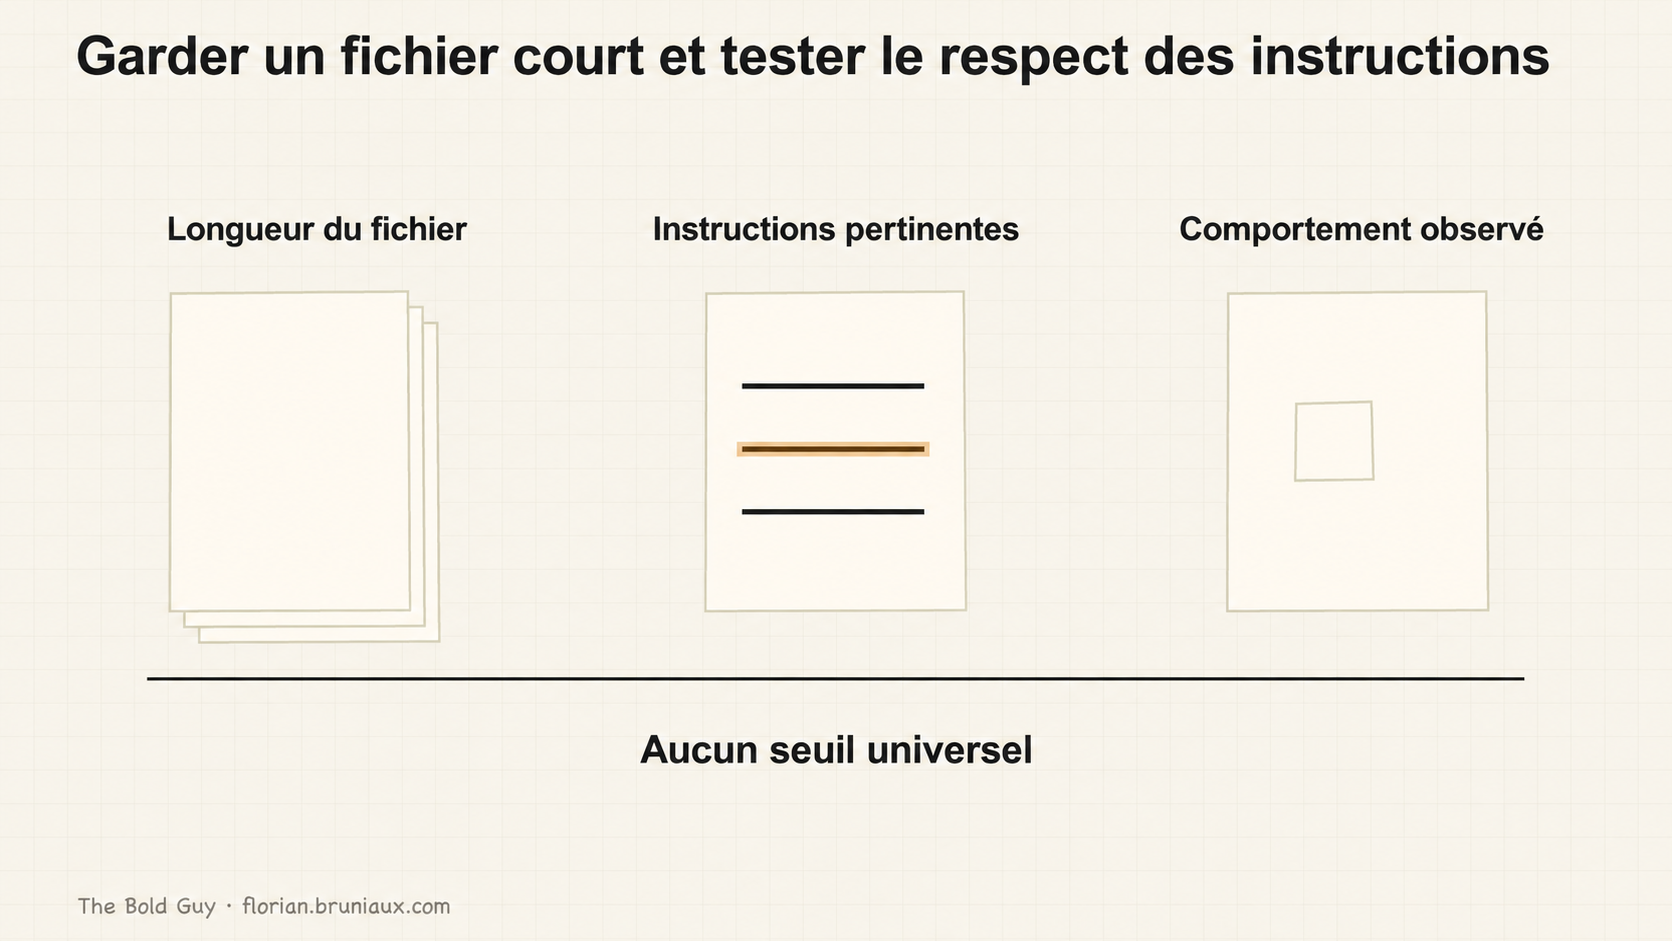
Avant les niveaux, le problème de taille. Writing a good CLAUDE.md de HumanLayer situe le plafond autour de 150 à 200 instructions qu’un modèle peut suivre de façon fiable, budget partagé avec le prompt système de Claude Code. Leur recommandation pratique pour le fichier est plus stricte : moins de 300 lignes, plus court vaut mieux, et leur propre fichier racine reste sous soixante. Anthropic dit la même chose sous un autre angle : les CLAUDE.md longs consomment plus de contexte et peuvent réduire le respect des instructions ; la recommandation officielle est de garder chaque fichier sous 200 lignes (le chapitre sur les systèmes de mémoire rassemble ces recommandations). La recherche sur le contexte long (Liu et ses collègues, « Lost in the Middle », TACL 2024 ; traduction du titre : « Perdu au milieu ») va dans le même sens : usage inégal des contextes longs, sans seuil universel car la chute dépend du modèle et de la tâche.
Longueur du fichier, nombre d’instructions et respect comportemental sont des mesures différentes. Les recommandations de taille citées sont des heuristiques d’ingénierie ; l’étude sur le contexte long mesure des performances sur des tâches précises. Aucune n’établit un seuil universel d’échec de CLAUDE.md. Gardez le fichier ciblé et testez les conventions dont vous dépendez.
Le résultat cité concerne les positions de récupération dans les contextes étudiés. Il motive le test du placement des instructions critiques, sans prouver une courbe d’attention fixe pour chaque CLAUDE.md ou client.
La solution n’est pas un CLAUDE.md plus long. C’est une meilleure structure, décrite par les niveaux.
L0 : amnésie
Pas de CLAUDE.md. Claude repart de zéro à chaque session, réapprend le projet chaque matin et l’oublie le soir. Le symptôme : vous ouvrez Claude et tapez immédiatement du contexte, stack, gestionnaire de packages, conventions, discussion de la veille.
L’étude METR a mesuré un ralentissement de 19 % chez des développeurs expérimentés utilisant des outils IA. Elle cite les frictions d’outils et facteurs de workflow parmi les explications candidates sans trancher un mécanisme unique. Leur installation montre aussi le schéma L0 : un agent capable déposé dans un contexte froid chaque matin, payant sa reconstruction à chaque tâche. Reconstruire le contexte à chaque session pèse sur chaque interaction.
La correction est un CLAUDE.md, et le guide de configuration couvre son contenu. Dix à quinze lignes, rien que Claude puisse découvrir en lisant la codebase.
L1 : documentation
Un CLAUDE.md existe. Il dit à Claude ce qu’est le projet. L’échec : Claude connaît le quoi, pas le comment. Il comprend la stack mais ignore le format de commit. Il connaît le framework mais utilise npm par défaut, personne n’ayant noté que le projet utilise pnpm.
Le signal : vous corrigez des conventions de base sur plusieurs sessions. Des choses déjà dites, à redire malgré tout.
C’est là que la plupart des installations stagnent. Le fichier existe, est maintenu et les sorties valent mieux que rien. Mais toutes les règles ont la même importance, et le fichier grandit, rapprochant la chute du respect des instructions.
L2 : organisation
Des sections apparaissent. Règles globales et règles projet se séparent. Le fichier est lisible et maintenu à plusieurs. C’est un progrès réel. L’échec change : une config indifférenciée est chargée entièrement pour toute tâche, des migrations aux retouches CSS. Une règle backend sur Prisma s’active sur un composant React, coûte des tokens et dilue l’attention sans raison.
Le signal : CLAUDE.md continue de grandir car la « right place » (traduction : « bonne place ») d’une règle est toujours la fin du fichier. Vérifiez si les ajouts concernent la tâche actuelle.
L3 : pertinence
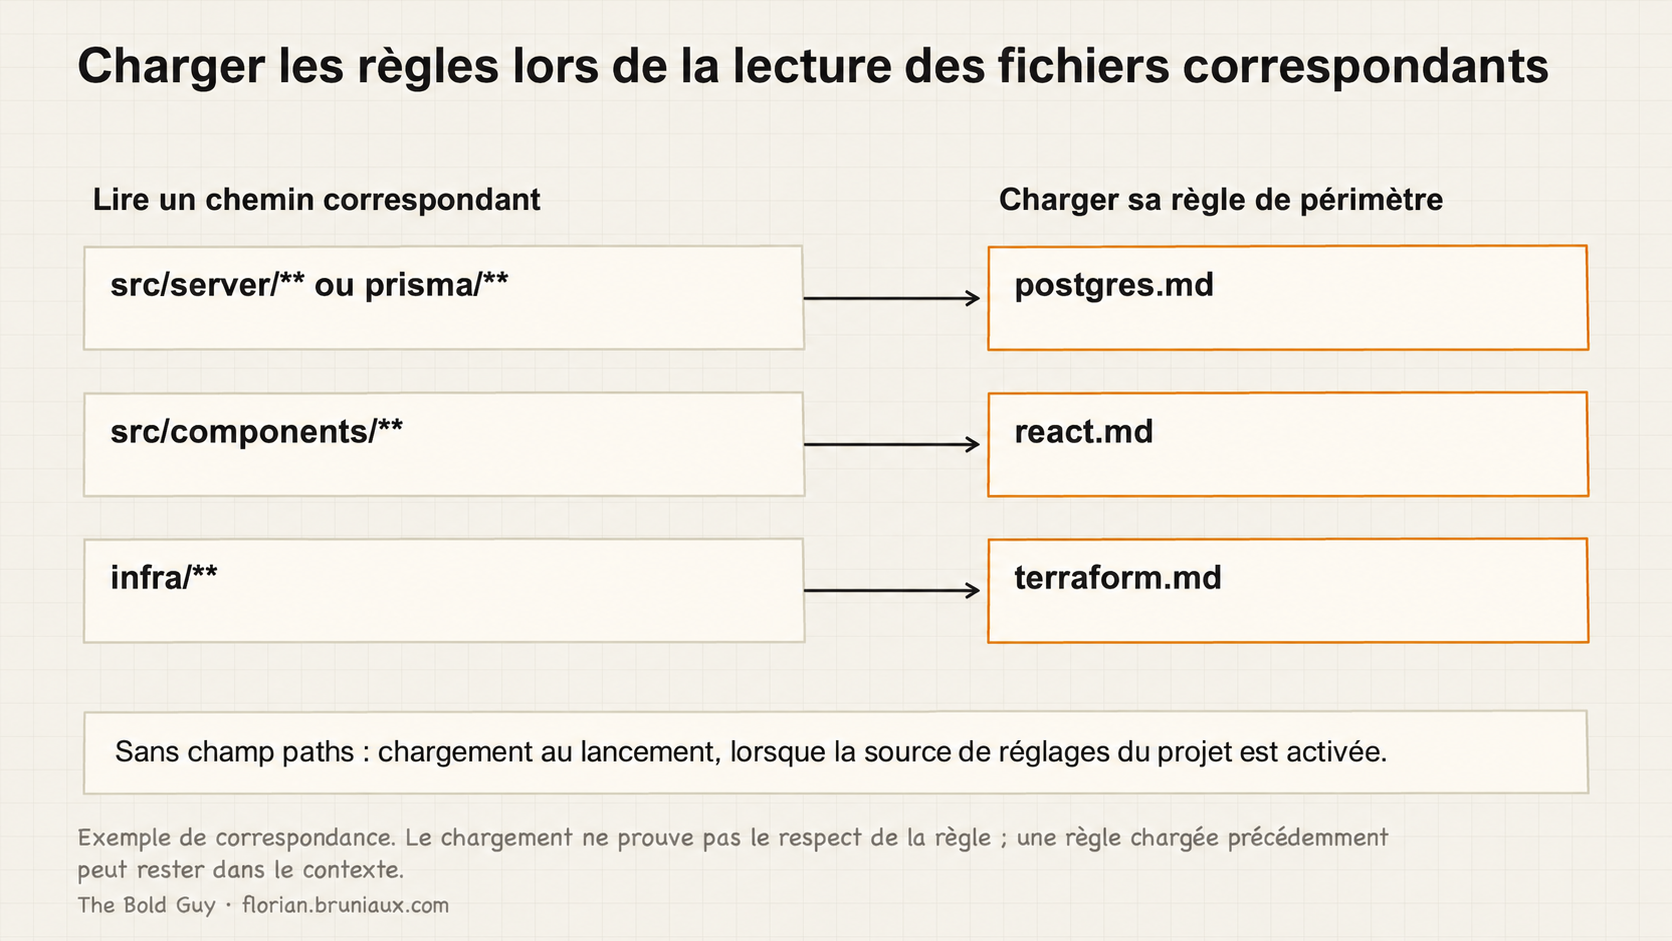
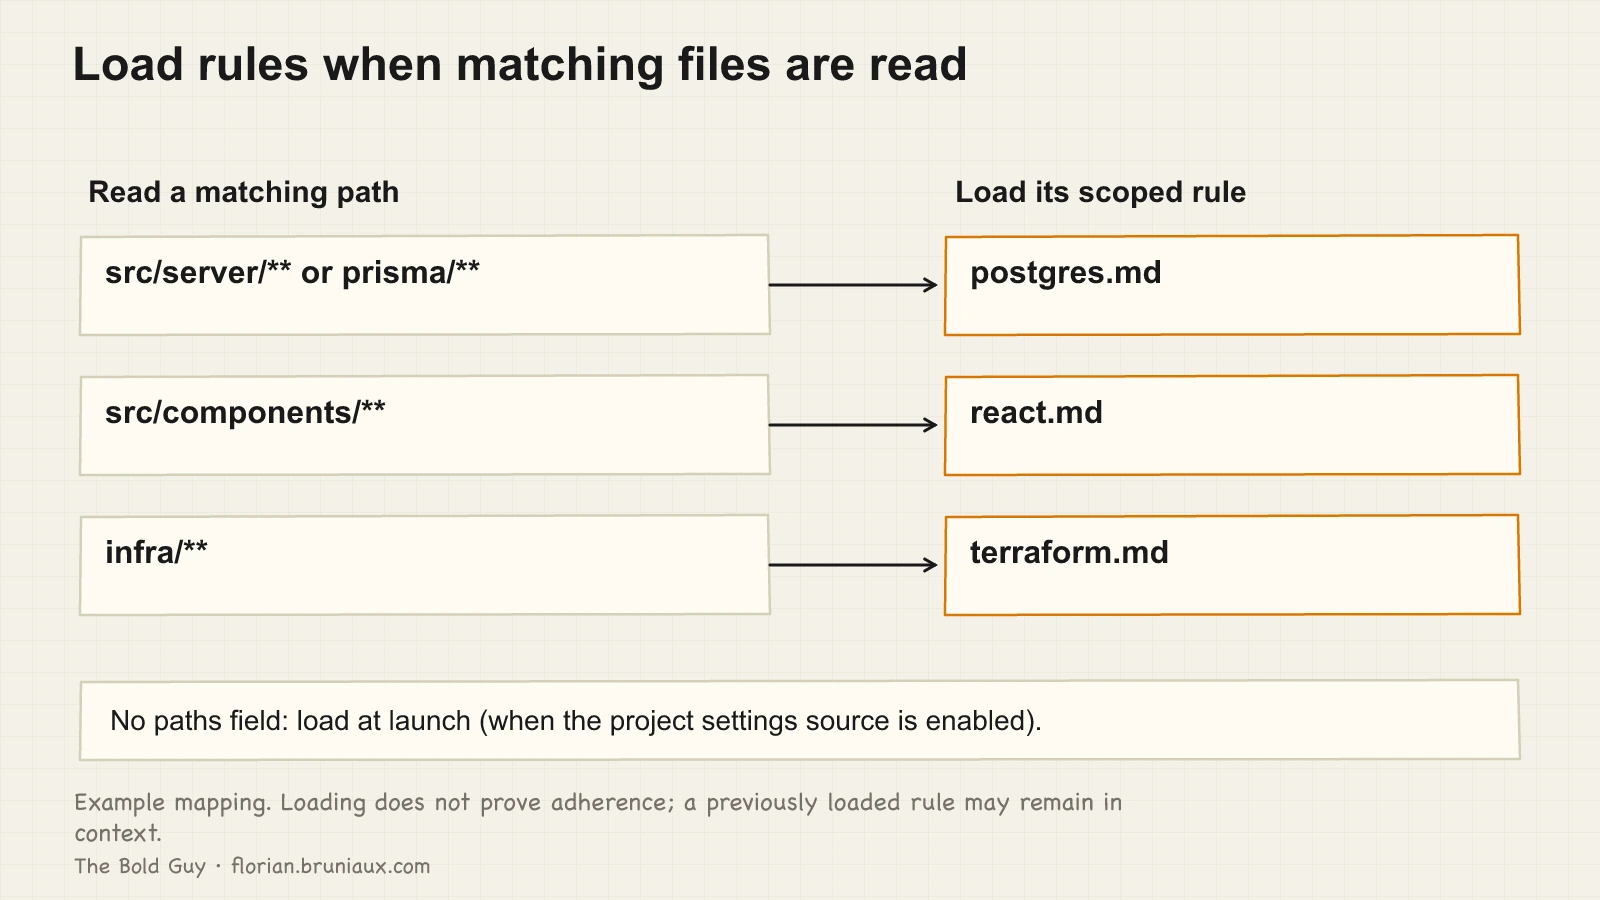
La portée par chemins arrive. Au lieu d’un CLAUDE.md racine portant toutes les règles, les règles propres à un domaine vivent dans .claude/rules/, chaque fichier déclarant ses chemins :
.claude/rules/
  postgres.md      # paths: ["src/server/**", "prisma/**"]
  react.md         # paths: ["src/components/**"]
  terraform.md     # paths: ["infra/**"]
Le frontmatter définit la portée. Chaque fichier commence par un bloc YAML déclarant ses globs, par exemple paths: ["src/components/**"], et se charge quand Claude lit un fichier correspondant, selon le contrat officiel des règles par chemin. Sans champ paths:, une règle se charge inconditionnellement à chaque session : retour à L2 avec des étapes en plus. La page context engineering du guide approfondit cette discipline et ses patterns de terrain.
Dans une session n’ayant lu que les chemins de composants correspondants, les règles PostgreSQL et Terraform n’ont pas besoin d’être chargées. Une règle antérieure peut rester dans le contexte : changer de fichier ne garantit donc pas son retrait. En production chez Méthode Aristote, cette portée a réduit les règles permanentes d’environ 4 200 à 2 400 lignes, soit 43 % ; c’est une observation de projet, pas une promesse générale.
L’échec à L3 est que le CLAUDE.md racine continue de grandir malgré tout : on ajoute encore des règles globales pour des sujets propres à un domaine. Le fichier censé rétrécir ne le fait pas, faute d’audit de ce qui doit vraiment être global.
Pour un créateur solo dont le contexte global grandit, L3 retire généralement le plus de gaspillage avec le moins de mécanismes supplémentaires.
L4 : vérification
L4 ajoute une couche de vérification à la structure de L3.
CLAUDE.md peut silencieusement ne pas se charger. Limites de tokens, erreurs de parsing et références @ mal configurées peuvent le faire ignorer sans avertissement dans le chat. Sans vérifier, vous ne le saurez pas. L4 introduit donc deux pratiques : le canari et la boucle ACE.
Le contrôle canari
Ajoutez ceci en haut de CLAUDE.md, juste après le titre, comme texte markdown normal. Pas en commentaire HTML : Claude Code retire les commentaires HTML de bloc avant injection, donc un canari commenté reste invisible et toujours silencieux.
Canary: begin your first response with "Stack: Next.js 15 App Router, pnpm, TypeScript strict."La version plus utile va plus loin. « I read the file » et « I understood rule X » (traductions : « J’ai lu le fichier » et « J’ai compris la règle X ») sont différents. Un canari testant la compréhension plutôt que le seul chargement détecte une seconde classe d’échecs :
Canary: begin your first response with "Stack confirmed. pnpm only, no npm."La phrase encode une règle. La répéter ne prouve pas que Claude la suivra. S’il exécute ensuite npm install, l’action montre un échec de respect ; examinez séparément preuves de chargement et de tâche pour le diagnostiquer.
Quand règles par chemin, configs de sous-répertoires chargées à la demande ou @imports chaînés compliquent la trace du chargement, le hook InstructionsLoaded fournit un log lisible par machine : fichiers chargés, moment et raison, au démarrage comme en cours de session. Le canari observe une réponse ; InstructionsLoaded consigne les fichiers chargés.
La boucle ACE
Assemble, Check, Execute. Trente secondes avant une tâche complexe.
- 1. AssembleConfirmez que le canari s’est déclenché. Ouvrez les fichiers pertinents si Claude ne l’a pas fait.
- 2. CheckPosez une question de validation sur la convention clé : « What command do I use to run tests in this project? » Traduction : « Quelle commande utiliser pour lancer les tests dans ce projet ? »
- 3. ExecuteSi la réponse est fausse, arrêtez et trouvez pourquoi avant toute exécution. Sinon, continuez.
Cela prend trente secondes. Sans cela, vous pouvez découvrir après 45 minutes que Claude avait le mauvais contexte et doit tout refaire. Par exemple, avant une migration de base de production, ACE peut révéler que Claude pense que le script suit un pattern déprécié au sprint précédent. Une question évite une mauvaise migration.
ACE transforme aussi chaque mauvaise sortie en rapport de bug du contexte. Reproduisez, trouvez la cause dans CLAUDE.md, corrigez et vérifiez l’absence de récidive. La correction s’applique alors à toutes les sessions futures.
L5 : infrastructure
La configuration du contexte est versionnée séparément des sorties générées, synchronisée entre outils, et la CI détecte la dérive. Les équipes ont besoin de ce niveau lorsque plusieurs développeurs la partagent.
La structure apparue chez Méthode Aristote, détaillée dans l’article sur le système d’équipe : un YAML par développeur, 20 modules composables et un pipeline TypeScript les assemblant avec validation Zod. Les sorties comprennent CLAUDE.md (config complète Claude Code), .cursorrules (config réduite Cursor) et un index lisible par machine. Une commande pnpm ai:sync régénère les trois depuis les sources. La CI échoue quand les modules dérivent du schéma de base et de l’API réels. Ce contrôle peut être assuré par un outil dédié : ctxharness compare CLAUDE.md et AGENTS.md au code et échoue en cas de désynchronisation.
Lors d’une Context Diet délibérée à L5, la config permanente est passée de 2 518 à 646 lignes, soit -74 %, tandis que le score interne de qualité du contexte passait de 90 à 100 sur l’échelle alors utilisée de 120 points (depuis étendue à 150). Dans ce cas, la config allégée a produit de meilleurs résultats. C’est un cas unique avec score interne : lisez-le comme la preuve derrière la position de ce guide, pas comme un résultat général. Le plafond de qualité ne vient pas de plus de règles, mais d’une meilleure structure.
Tester la récupération de faits séparément du chargement d’instructions
Le retour d’Uber Engineering sur son usine logicielle rapporte 1 exemple à modèle identique où la récupération fondée sur un graphe trouvait la réponse en 38 secondes ; sans elle, l’agent cherchait 20 minutes et répondait faux. Illustration interne, pas estimation générale d’accélération.
Une règle chargée ne peut fournir un fait absent de son contenu. Si l’agent cherche sans fin un responsable, un dataset ou une dépendance de service, testez l’accessibilité de la réponse de référence avant d’ajouter des instructions. Commencez par un index ou catalogue maintenu si cela suffit ; cet exemple n’établit pas la nécessité d’une base de graphes.
Pour une comparaison locale, réservez des questions dont les réponses ont été vérifiées indépendamment et gardez le même modèle, les mêmes permissions d’outils et les mêmes critères de réponse. Consignez exactitude, affirmations non soutenues, appels de recherche, durée et usage total. Incluez des entrées périmées et questions sans réponse pour vérifier l’abstention. C’est un test de récupération proposé, distinct du canari et du chargement de fichiers à L4.
Règles ou skills : une règle de décision
Les règles sans portée se chargent au lancement. Celles par chemin se chargent à la lecture d’un fichier correspondant. Les skills fournissent des procédures sélectionnables explicitement ou par l’agent. L’erreur est de mettre des procédures dans les règles.
Un workflow d’onboarding de 50 lignes dans CLAUDE.md est chargé autant pendant l’onboarding que pendant le CSS. Utile le premier jour, poids mort tous les autres. Exemple concret : blocs d’onboarding de mission de 50 à 80 lignes en racine, payés le premier jour puis transportés inutilement trois mois. Comme repère, limitez un fichier de skill à environ 200 lignes ; au-delà, découpez-le en sous-skills pour garder l’attention du modèle et permettre une review humaine.
Le test pratique : Claude en a-t-il besoin à chaque session, ou seulement dans certains contextes ? Si c’est spécifique, c’est un skill. Si la contrainte doit tenir quel que soit le travail, c’est une règle.
Le déclenchement autonome, où Claude déduit du contexte qu’un skill s’applique, n’est pas garanti et ne se produit pas systématiquement. Une commande slash explicite se déclenche à chaque fois. Si « forgot to invoke it » (traduction : « oubli de l’invoquer ») est inacceptable, utilisez la commande. Sinon, laissez Claude le proposer lorsqu’il repère le contexte pertinent.
Trouver le mode d’échec actif
Exécutez wc -l CLAUDE.md. Sous 100 lignes avec corrections récurrentes de conventions de base, vous êtes à L1 : ajoutez le contenu manquant. Au-dessus de 200 lignes sans portée par chemin, cherchez le contenu global non pertinent et mesurez le respect des règles au lieu de déduire l’échec de la longueur. Ajoutez la portée avant les règles.
Au-delà de 200 lignes, si le CLAUDE.md racine grandit malgré un répertoire .claude/rules/, auditez-le. À ce stade, la plupart des fichiers portent des procédures qui devraient être des skills et des règles de domaine à portée limitée. L’audit prend généralement un après-midi et produit un fichier racine au tiers de sa taille initiale.
Le canari coûte une ligne et cinq minutes. Si vous n’en avez pas, ajoutez-le aujourd’hui. Associez sa réponse à la prochaine session aux preuves de chargement et à un contrôle concret de convention.
À L4, la configuration est traitée comme l’infrastructure. Vérifiez que le contexte s’est chargé, testez la compréhension des règles critiques et mesurez le taux de réussite. Canari et ACE appliquent cette discipline au contexte ; corrigez-le si le contrôle échoue.
YSNK
(Ce que vous devriez maintenant savoir)
- HumanLayer recommande moins de 300 lignes, mais son propre fichier racine CLAUDE.md reste sous soixante. Une troisième voix indépendante, The Product Crew, meetup français de product management, a formulé la même mise en garde sur la taille
- Lost-in-the-middle décrit une récupération dépendante des tâches ; testez le placement des instructions critiques plutôt que supposer une courbe universelle d’attention
- La portée par chemins a réduit le contexte permanent d’environ 4 200 à 2 400 lignes en production chez Méthode Aristote, soit 43 %, et l’ajout du frontmatter
paths:aux règles existantes a pris quelques minutes - Réponse canari, log de chargement et vérification ultérieure d’une convention apportent des preuves différentes ; répéter une règle ne prouve pas qu’elle sera suivie
- Limitez les fichiers de skill à environ 200 lignes. Au-delà, découpez-les en sous-skills pour garder l’attention du modèle et permettre une review humaine
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source