Comment lire un benchmark de compression de tokens
Lire les affirmations sur la compression de tokens à travers leurs dénominateurs, tâches appariées, coûts de cache et critères de succès, avec Tokenade face à RTK comme exemple détaillé.
Aller au résumé ↓ Florian Bruniaux
Un outil de réduction de tokens peut raccourcir chaque réponse et rendre la tâche terminée plus coûteuse. L’agent peut avoir besoin d’appels supplémentaires, ne plus bénéficier d’un cache hit ou réessayer après la disparition d’un détail. Un benchmark utile suit ces conséquences jusqu’au résultat accepté.
Transparence : j’ai contribué à RTK. Cet article applique le même standard de mesure à RTK et aux outils concurrents. Les résultats des fournisseurs ci-dessous n’ont pas été reproduits indépendamment ici.
Mise à jour du 6 novembre 2026. Je ne contribue plus activement au code de RTK, mais je suis toujours le projet de près. Pour les politiques d’usage et la visibilité à l’échelle d’une équipe, vous pouvez découvrir RTK Pro. Cette offre est distincte du CLI mesuré ici. Ces mesures n’évaluent pas Pro et ne démontrent pas d’économies liées à cette offre.
TL;DR
Je ne crois un chiffre de compression de tokens qu’une fois ses effets suivis jusqu’au coût d’une tâche acceptée. RTK est très efficace sur les sorties CLI : sur ma machine, rtk gain indique entre 48 % et 81 % de tokens de sortie CLI économisés par mois complet de juillet à septembre 2026 (lecture du 2 octobre 2026), mais ce sont les tokens de sortie CLI tels que RTK les compte, pas ma facture totale.
| Question | Preuve à demander |
|---|---|
| Qu’a-t-on mesuré ? | Taille du contenu, usage de toute la session ou coût par tâche acceptée |
| Les mêmes tâches ? | Entrées identiques, versions épinglées et exécutions répétées |
| Quelle incertitude ? | Distribution par tâche, intervalles de confiance et unité d’échantillonnage |
| Quels tokens ? | Entrées nouvelles, écritures de cache, lectures de cache et sorties |
| Qu’est-ce qui a réussi ? | Vérificateurs, seuils, scores et échecs |
| Qu’est-ce qui a changé ? | Tous les hooks, prompts, modèles et services externes activés |
Apparier les tâches pour ne pas laisser l’échantillon décider
Exécutez les deux configurations sur les mêmes tâches. Sinon, un ensemble de corrections faciles peut sembler moins cher qu’un ensemble de migrations difficiles pour des raisons sans rapport avec la compression.
L’appariement contrôle la composition des tâches ; il ne supprime ni la variance d’échantillonnage du modèle ni un effet d’ordre d’exécution. Les répétitions et une politique de cache explicite traitent d’autres sources de bruit.
Consignez l’identifiant du modèle, la version de l’agent, celle de l’outil de réduction et, si possible, l’empreinte du binaire. Si un binaire recompilé garde sa chaîne de version, cette chaîne seule ne permet pas de reproduire le traitement.
Le manifeste Tokenade de THOL consigne explicitement une telle recompilation. Configuration du benchmark Tokenade
Le piège du n=6
Pour un test exact des signes bilatéral avec six paires indépendantes sans égalité, six effets dans le même sens donnent p = 2/64 = 0,03125. Six victoires comme six défaites atteignent cette valeur.
Cinq victoires et une défaite donnent p = 0,21875. Le test ignore l’ampleur de l’effet ; il n’établit pas combien d’argent a été économisé.
| Paires sans égalité | Plus petite valeur p bilatérale | Condition |
|---|---|---|
| 6 | 0,03125 | Tous les effets ont le même signe |
| 8 | 0,0078125 | Tous les effets ont le même signe |
| 10 | 0,001953125 | Tous les effets ont le même signe |
Un résultat significatif sur six tâches est une preuve, avec une couverture limitée et une résolution grossière. Il n’est pas dépourvu de sens.
Les répétitions améliorent les estimations au sein de chaque tâche, mais ne deviennent pas des tâches indépendantes supplémentaires. Les égalités changent la taille effective de l’échantillon.
Rapportez les tailles d’effet et les intervalles avec le test, puis testez d’autres familles de tâches avant de généraliser.
Le chiffre cité
L’économie médiane par tâche, la moyenne arithmétique des économies, la moyenne géométrique des ratios de coût et le ratio des coûts totaux répondent à des questions différentes.
Un ratio de coût agrégé donne plus de poids aux tâches coûteuses. Une moyenne géométrique par tâche donne à chaque tâche incluse une contribution sur l’échelle logarithmique.
Un écart entre moyenne et médiane ne prouve pas qu’une valeur extrême en est la cause. Examinez la distribution.
Ne combinez pas les résultats de mécanismes testés séparément sans exécuter leur combinaison : ils peuvent retirer le même contenu ou modifier les appels ultérieurs.
La classe de tokens réduite
Utilisez les tarifs du modèle et du circuit de facturation testés. Les entrées nouvelles, écritures de cache, lectures de cache et sorties générées peuvent avoir des prix différents.
Une réduction identique dans deux classes de tokens peut donc produire des économies monétaires différentes. Réécrire un préfixe mis en cache peut aussi créer un nouveau coût d’écriture.
Diviser le nombre de caractères par quatre est une heuristique, pas un tokenizer OpenAI. Son erreur varie avec le code, la prose et la langue ; elle n’est pas toujours optimiste.
Un ratio de compression hors ligne doit nommer son tokenizer ou sa méthode d’estimation. Pour les coûts de session, conservez les données d’usage du fournisseur et distinguez les calculs locaux de prix de la facture faisant autorité. Documentation Claude Code sur l’usage et les coûts
La mesure absente
Comparez les coûts pour un résultat acceptable.
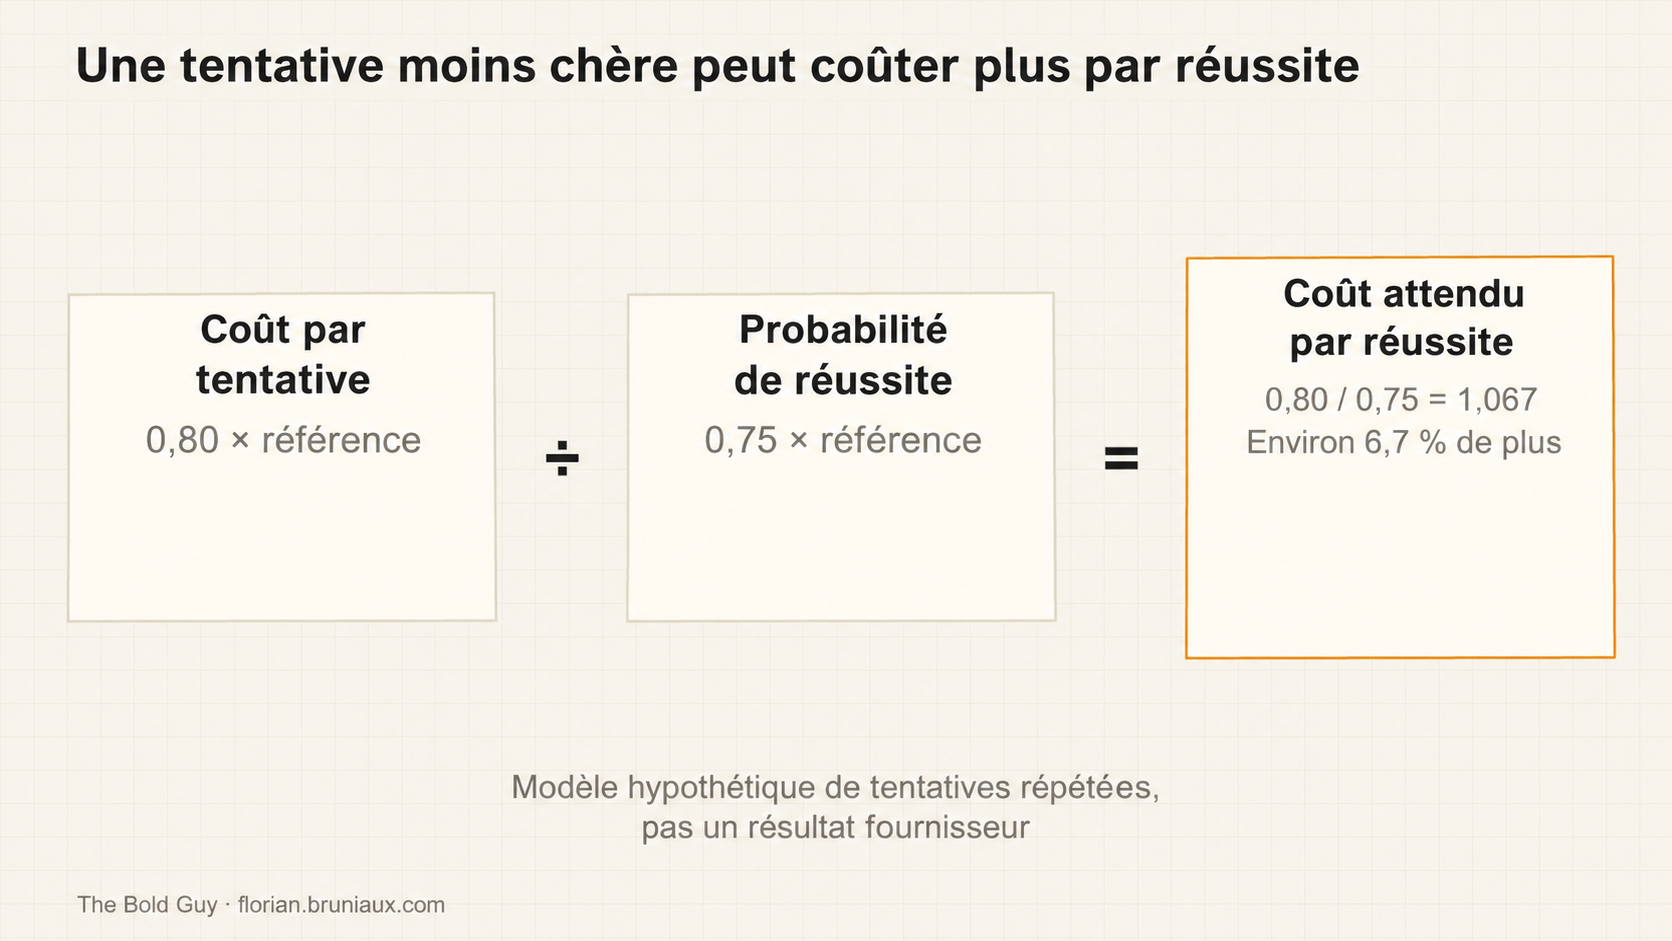
Rapportez à la fois le coût conditionné au succès et la dépense de toutes les tentatives par succès. Ils diffèrent lorsque les échecs consomment des ressources.
Un succès binaire dépend aussi du seuil du vérificateur : conservez les scores continus lorsqu’ils existent et examinez ce qui échappe au test.
Tokenade face à RTK : lire un classement maintenu par un fournisseur
THOL publie son harnais, ses manifestes, fixtures, vérificateurs et données de résultats. Son mainteneur développe aussi Tokenade et déclare ce conflit d’intérêts.
Une méthode publique rend un résultat examinable ; sa reproduction indépendante est une propriété distincte. Méthodologie THOL
La campagne historique ci-dessous utilisait Claude Code 2.1.206 et Sonnet 4.6. Ses résultats restent liés à ces versions, aux versions nommées des outils de réduction et aux hypothèses tarifaires de la campagne. Ils n’ont pas été réexécutés avec les réglages actuels de Claude Code.
La campagne rapporte les moyennes géométriques suivantes des ratios de coût par tâche :
| Configuration | Ratio de coût face au contrôle | Intervalle à 95 % publié | Exécutions réussies |
|---|---|---|---|
| Tokenade 0.8.13 | 0,768 | 0,647–0,900 | 170/170 |
| RTK 0.42.3 | 1,052 | 0,913–1,190 | 170/170 |
Les deux couvrent 17 tâches. La réduction estimée de Tokenade est de 23,2 % ; l’intervalle de RTK couvre à la fois des économies et un surcoût. Cela ne permet pas de conclure à une différence avec le contrôle, sans prouver l’équivalence.
Le sous-ensemble Tokenade de sept tâches en sessions longues rapporte une réduction de 38,9 % ; gardez ce dénominateur séparé de la campagne complète.
Des mesures indépendantes de RTK vont dans le même sens sur le coût total : Dasein rapporte +13 % (54 tâches résolues contre 57 sans RTK), et JetBrains rapporte +7,6 % de coût médian par tâche à faible effort (p=0,004) et +0,1 % à effort élevé (p=0,99).
Je ne considère pas le résultat JetBrains comme tranché : les mainteneurs de RTK ont publié leur lecture de ce que mesure ce benchmark (issue #3157, RTK sur SkillsBench).
Le tableau des benchmarks indépendants du guide liste chaque configuration et ses conflits d’intérêts. Données de la campagne publiées
Le protocole agrège les exécutions réussies. Pour ces deux groupes, toutes les exécutions publiées réussissent : une différence de taux d’échec n’explique donc pas leur classement.
Il reste à examiner les seuils des vérificateurs et la couverture des tâches. Une affirmation large sur la qualité demande plus que les totaux de succès.
Le traitement est aussi plus large que son nom ne le suggère. Tokenade installe des instructions d’output style, encourage le traitement par lots et configure plusieurs hooks et réglages de contexte. Le groupe RTK installe son wrapper de commandes et son hook Bash.
Un avantage pour la configuration Tokenade complète n’identifie pas le mécanisme qui l’a causé. Testez les composants séparément avant d’attribuer tout le résultat à la recherche sémantique, à la compression ou à la gestion du cache.
La reproductibilité a aussi une limite de distribution. L’installateur Tokenade est public, mais sa licence actuelle décrit un moteur propriétaire. La configuration du benchmark et l’implémentation de l’outil de réduction sont des artefacts distincts. Licence de distribution
Le chiffre du laboratoire et la facture
Un benchmark n’est ni une borne supérieure ni une borne inférieure des économies en production. Votre travail peut comporter des logs plus bavards, des sessions plus longues ou des critères d’acceptation plus stricts.
Les coûts d’indexation et de licence peuvent s’amortir différemment. Une baisse de consommation de tokens pour un utilisateur abonné peut libérer de la capacité sans réduire le forfait.
La comparaison à répéter localement utilise votre combinaison de tâches et inclut la préparation, les tentatives échouées, les modèles exécutants et l’effort de review. Conservez les résultats par tâche plutôt que de ne sélectionner que la catégorie la plus favorable.
L’intervalle d’incertitude d’un benchmark ne couvre pas l’incertitude de transfert de son résultat à votre charge de travail.
Les vérifications que je fais avant de croire un chiffre
Consignez le dénominateur, les tâches appariées, les versions, les répétitions, les classes de tokens, la politique de cache, le vérificateur et le coût de toutes les tentatives.
Vérifiez si le sponsor vend le gagnant et si le binaire testé est identifiable. Distinguez les effets de configuration mesurés des explications qui nécessitent encore une expérience par composant.
Pour les mécanismes derrière ces comparaisons, voir la boîte à outils de réduction de tokens. La comptabilité des coûts s’étend à la review et aux reprises dans la référence du guide sur l’économie unitaire. La page sur les économies de tokens compare les affirmations des fournisseurs à six benchmarks publics et précise l’intérêt de chaque éditeur.
YSNK
(Ce que vous devriez maintenant savoir)
- L’appariement contrôle la composition des tâches, pas toutes les sources de variance
- Une petite valeur p au test des signes ne mesure pas la taille d’effet ; une preuve sur six tâches a une couverture limitée
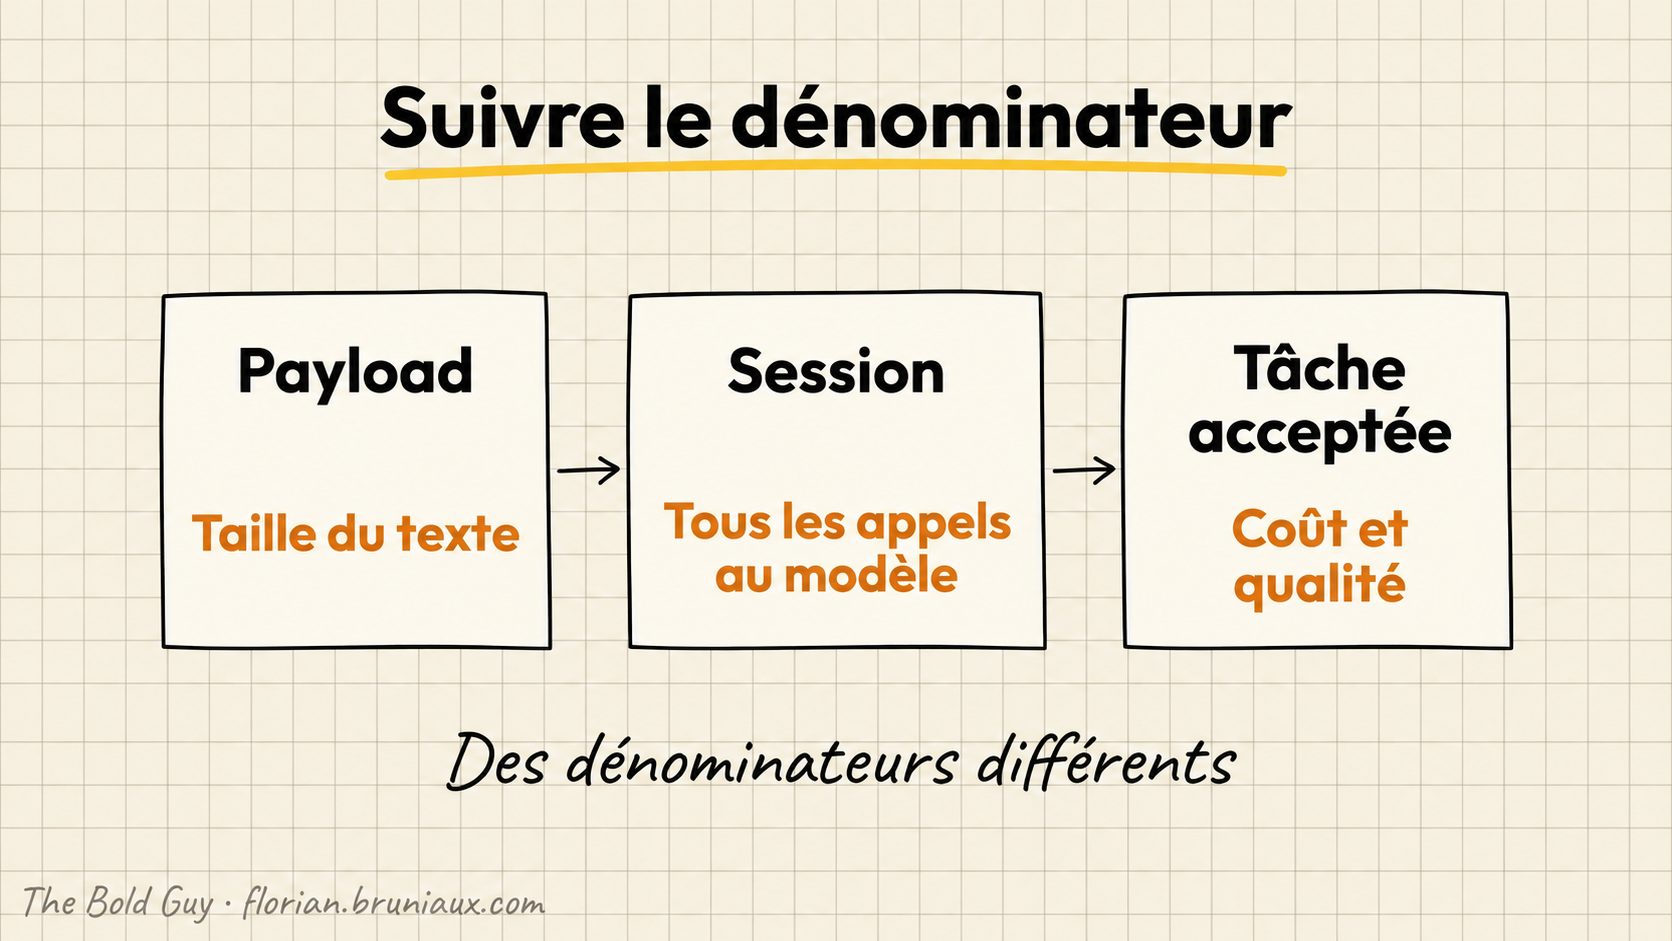
- Une estimation de tokens, un coût de session et un coût par tâche acceptée ont des dénominateurs différents
- THOL favorise Tokenade dans sa campagne publiée, avec une relation fournisseur déclarée et sans reproduction indépendante ici
- Comparer des configurations complètes ne permet pas d’établir la contribution causale de chaque composant
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source