Des tokens à la valeur produit, retour sur le live Insitoo
Avec Thomas Pierrain et Vanessa Gossent, je reviens sur les coûts de l’IA, le recrutement, les agents en parallèle et le travail à reprendre.
 Florian Bruniaux 32 min de lecture
En bref
| Question du live | Ce que j’en retiens |
|---|---|
| Comment apprendre sans vider le quota ? | Partir d’un besoin délimité et partager les essais, y compris ceux qui ont échoué |
| Que met-on derrière « harnais » ? | Le contexte, les outils, les permissions et les vérifications autour de l’agent, avec un entretien régulier |
| Comment reconnaître la maîtrise de l’IA ? | Regarder comment une personne cadre le besoin, vérifie le travail et explique ses décisions |
| Trente ou quarante sessions produisent-elles autant de valeur ? | Je pratique ce mode de travail, mais j’ai aussi perdu le fil et jeté des résultats |
| Comment discuter du gain ? | Relier ce qu’on livre à son effet produit et au travail qu’il faut reprendre |
Le quota est aussi une affaire d’équipe
Chez Vanessa, le support a vite cramé le quota partagé en essayant les outils. Les devs sont venus aider les collègues. C’est un des cas qu’elle raconte pendant le live Insitoo du 5 novembre 2026, avec Thomas Pierrain. Leurs essais avaient fini par bloquer le travail des autres.
Avec Damien Cavaillès à l’animation, on était partis de trois questions : comment apprendre sans devenir « tokenvore », comment reconnaître quelqu’un qui maîtrise l’IA et comment savoir si ce qu’on produit en plus sert à quelque chose. Le chat nous a aussi ramenés sur le vocabulaire, les modèles locaux et ce qu’on devrait arrêter de déléguer.
Profils LinkedIn : Florian Bruniaux · Damien Cavaillès · Thomas Pierrain · Vanessa Gossent
Cet article reprend l’échange et les commentaires, avec des réponses complétées après le live. Les lectures de Thomas, Vanessa et Olivier Bonnefous prolongent la discussion. Les extraits oraux sont ponctués pour la lecture et les infographies ont été créées pour cet article.
Vanessa décrit « l’essai de la semaine » : partager ce qu’on a tenté, ce qui a marché ou raté et ce que ça a coûté. Si le retour reste dans une conversation privée avec l’agent, les collègues risquent de refaire le même essai sans en profiter.
Je commencerais par comprendre ce qu’on utilise et regarder la consommation. Si une petite analyse mange une grosse partie du quota, je veux savoir pourquoi avant de relancer la même chose. Il faut encore pouvoir travailler derrière.
Chez le client de Thomas, les quotas sont individuels. Si une personne épuise le sien, elle attend sans bloquer les autres. La façon de répartir les essais dépend donc aussi du contrat. Tokens consommés, quota restant et montant payé donnent des informations différentes.
Pour une équipe facturée à l’usage, le cas Back Market détaille une autre organisation : budget par personne et choix des fournisseurs.
Vanessa explique avoir commencé avec des formations externes, puis développé des ateliers internes sur des cas réels. C’est ce qui m’intéresse dans l’accompagnement : pouvoir poser une question au moment où ça bloque, puis garder quelque chose qui servira au collègue suivant.
Vanessa et Olivier Bonnefous racontent une autre façon d’apprendre dans leur tutoriel du 26 novembre 2025. Ils ont testé le brief en conversation avant de créer le GPT. Ils ont observé les managers et raccourci le parcours. L’expertise métier servait à décider quelles questions poser et quoi changer.
Le harnais doit pouvoir s’expliquer sans le mot
Dans le chat, Laurence Poussard trouve que « harnais » ajoute du brouillard. Elle demande qu’on parle de contexte, de contrôle, de sécurité et de cadre. Autant repartir de ce qu’on met dedans.
Pour moi, le harnais est le cadre de travail autour de l’agent. Je lui donne des instructions et des références, des outils et des permissions. Je prépare aussi la mémoire, les hooks, ces scripts déclenchés à des moments du travail, et les vérifications. Sur un projet d’équipe, ça va jusqu’à la CI et à l’observation des résultats.
Pour une correction de bug, voilà ce que ça donne. J’ai ajouté cet exemple après le live.
| Élément du cadre | Ce que je prépare |
|---|---|
| Contexte | Le ticket, le code concerné et la règle métier attendue |
| Outils | Lire et modifier le dépôt, lancer les tests utiles |
| Permissions | Préparer une correction, avec une publication soumise à une autorisation distincte |
| Vérification | Reproduire le défaut puis exercer le comportement corrigé et les cas pertinents |
| Arrêt | Demander de l’aide si le besoin reste ambigu ou si les essais n’avancent plus |
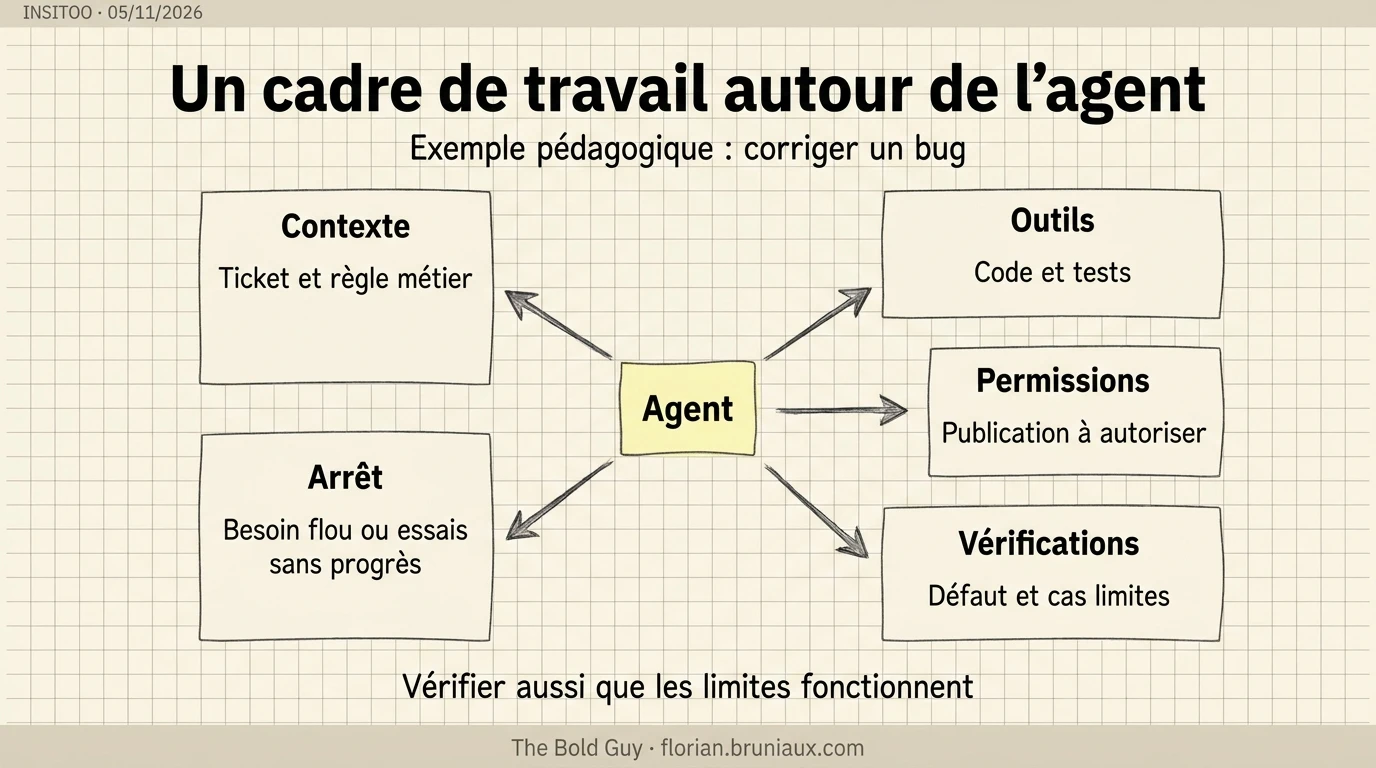
Si j’interdis une publication, je veux vérifier que l’agent n’a pas les accès pour la faire, tout en lui laissant de quoi préparer la correction. Une consigne écrite ne suffit pas. J’en parle plus longuement dans l’article compagnon du podcast IFTTD.
Thomas rappelle qu’on part déjà avec l’environnement fourni par Claude Code, Codex ou Copilot. On ajoute ce qui manque pour son travail. Et quand le logiciel ou le modèle progresse, il faut regarder ce qu’on peut retirer. Une contrainte ajoutée pour combler un manque peut finir par gêner.
J’aime bricoler ces configurations. Ça demande aussi d’accepter d’en enlever. Le nombre de règles ne dit pas si le besoin est compris ou si la correction fonctionne.
Dans leur retour du 27 février 2026, Vanessa et Olivier décrivent un assistant qui inventait des éléments quand le brief était incomplet. Ils séparent alors les questions au manager, l’analyse par le recruteur et la production. Leur prompt demande l’arrêt si des informations manquent. C’est une consigne publiée, dont je n’ai pas testé l’application.
Pour comprendre ce que l’agent propose, je reviens souvent au dessin. Je le dis dans l’échange : « Je suis très diagramme. » Je demande comment les blocs se parlent, puis je fais expliquer celui que je veux challenger. J’essaie de retrouver la discussion qu’on aurait devant un tableau blanc.
Mes trente ou quarante sessions ont aussi produit du travail jeté
Thomas décrit un piège que je connais bien. L’agent travaille, donc on lance autre chose. Puis il propose une amélioration, on la prend, et la journée se remplit de choses qu’on n’avait pas prévu de faire. Thomas garde son objectif sur un petit carnet et met les idées de côté. Il veut préserver l’attention nécessaire pour cadrer le travail.
Moi, je parle plutôt de trente ou quarante sessions. Je prends l’image du chef de brigade qui passe d’un poste à l’autre. Je ne gère pas les quarante en même temps. Je passe d’un plan à une vérification, je fais avancer un sujet pendant qu’un autre travaille. Pour garder le fil, Thomas a son carnet, moi mon reMarkable.
Ça m’est aussi arrivé de perdre le fil et de jeter le travail. Je le dis pendant l’échange : « Donc j’ai gaspillé mon temps et des tokens. » Ces résultats abandonnés font partie du coût de ma façon de travailler.
Dans A good harness makes /clear free, publié le 9 août 2026, Thomas traite un autre coût de reprise. Il propose de garder l’état du travail dans un plan versionné, mis à jour à chaque restitution de contrôle. La conversation peut alors être remplacée. Je pourrais l’essayer pour reprendre mes sessions. Je n’en ai pas mesuré l’économie.
Damien me demande si quarante agents me rendent quarante fois plus rapide. Je réponds que je fais beaucoup plus de choses. J’avance un facteur de deux à quatre sur ma production, et je provoque un peu en disant que je pourrais me comparer à une squad.
Ce facteur reste mon appréciation personnelle. Je n’ai pas présenté de comparaison des tâches, de l’effort humain et de la qualité avant et après. Ça ne permet pas de décider qu’une équipe a moins besoin de développeurs. Et je ne produis pas quarante fois plus de valeur.
Je fais aussi de la R&D, j’expérimente et ça m’amuse de pousser les outils. Sur mes projets perso, je prends davantage de libertés que dans le travail. Cet investissement ne se confond pas avec un engagement de livraison, ni avec le rythme qu’on peut demander à un collègue.
Pour travailler en parallèle, j’ai besoin de savoir ce que j’attends de chaque sujet et ce que je vais devoir décider à son retour. Thomas et moi avons décrit deux façons de faire. On n’a pas trouvé de nombre d’agents à recommander. Je développe le passage des sessions à une PR vérifiée dans Du code au merge.
Au recrutement, regarder les décisions pendant l’exercice
Vanessa a fait évoluer son exercice de recrutement : il se déroule sur place et le candidat peut utiliser un agent. L’équipe observe sa façon de travailler avec lui. Elle regarde le besoin qu’il formule, la découpe du travail, les vérifications et la capacité à expliquer ses choix.
Ce qu’elle veut voir, c’est comment la personne pilote. Est-ce qu’elle précise le besoin avant de lancer son premier prompt ? Est-ce qu’elle relit, teste, refuse une proposition et sait expliquer pourquoi ? Le résultat final laisse une partie de cette démarche invisible.
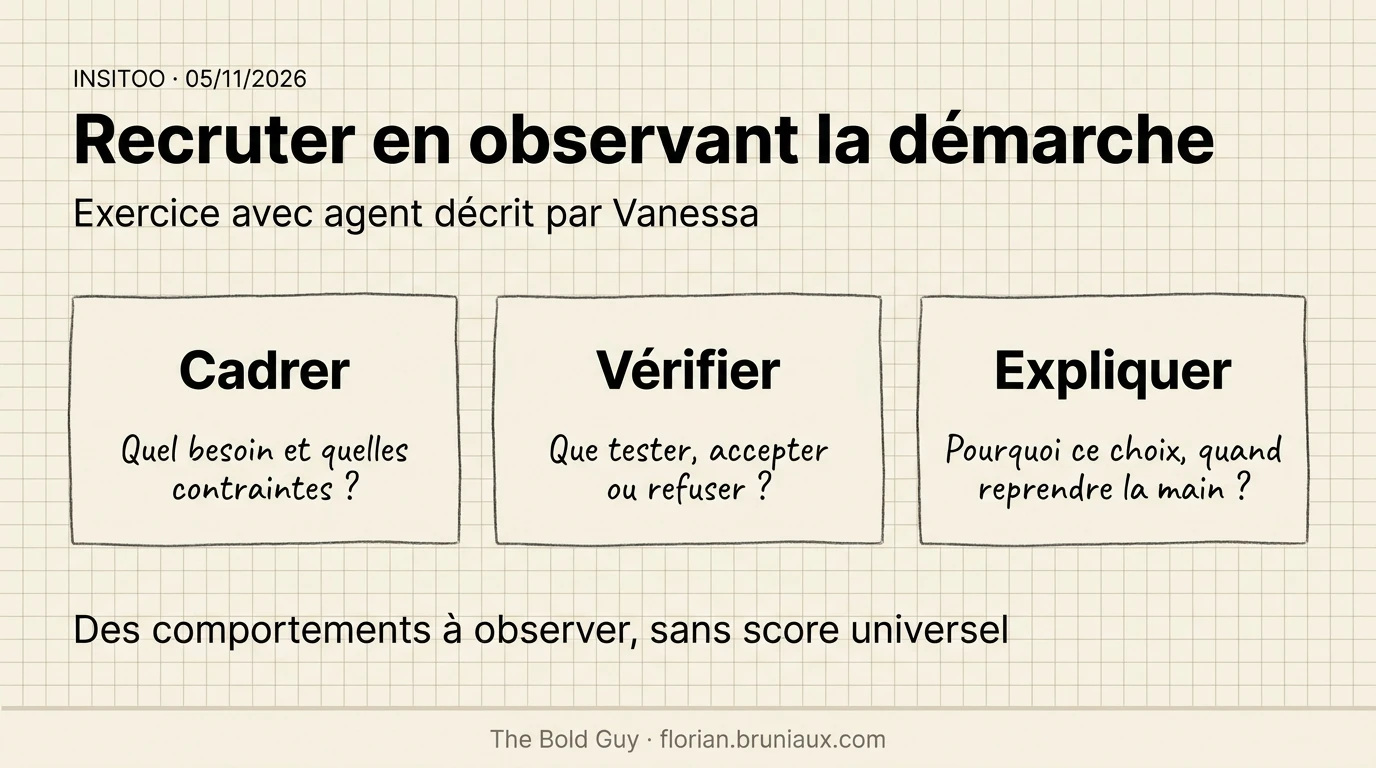
Thomas insiste sur ce qu’on refuse de laisser produire. Quand l’agent travaille bien, on peut s’installer dans un rythme de lecture et de validation. Son avertissement est précis : « On peut livrer une fonctionnalité entière sans l’avoir jamais reformulée. » On a un résultat, sans s’être assuré qu’on parlait du même besoin.
Il évoque aussi Slicer pendant le live. Son article Back in the equation, du 17 octobre 2026, détaille le dispositif : comprendre, concevoir, découper et définir les critères de fin. Au début, l’agent questionne et la personne reformule avec ses mots. Le PM reste dans la discussion.
De mon côté, je fais retirer des choses du diff. L’agent a ajouté une feature, c’est sympa, mais on ne l’avait pas prévue, on n’a pas fait les specs et on ne l’a pas testée. Je lui demande de la remettre au backlog ou sur une branche à part. Je peux aussi lui demander de faire plus simple. Le fait que ce soit déjà codé ne me donne pas une raison de le livrer.
Sébastien demande si le recrutement « AI-friendly » suppose d’être déjà un expert. Dans une réponse écrite dans les commentaires, Vanessa précise que le test ne cherche pas des « gurus ». Elle regarde la compréhension du besoin, la vérification et l’explication des choix. Quelqu’un qui débute avec l’IA peut montrer cette démarche.
En entretien, je demanderais aussi de montrer une décision changée après examen du travail de l’agent, avec la référence utilisée, les vérifications et les doutes qui restent. C’est le complément que je proposerais à cet exercice.
Compter aussi ce qu’il faut refaire après livraison
Thomas pose trois regards : output, outcome, rework. Ce qu’on livre, ce que ça change pour le produit et ce qu’il faut refaire après livraison. Les ventes, l’onboarding, le churn ou les tickets support peuvent donner des informations sur cet effet. Le choix dépend du problème qu’on cherche à résoudre.
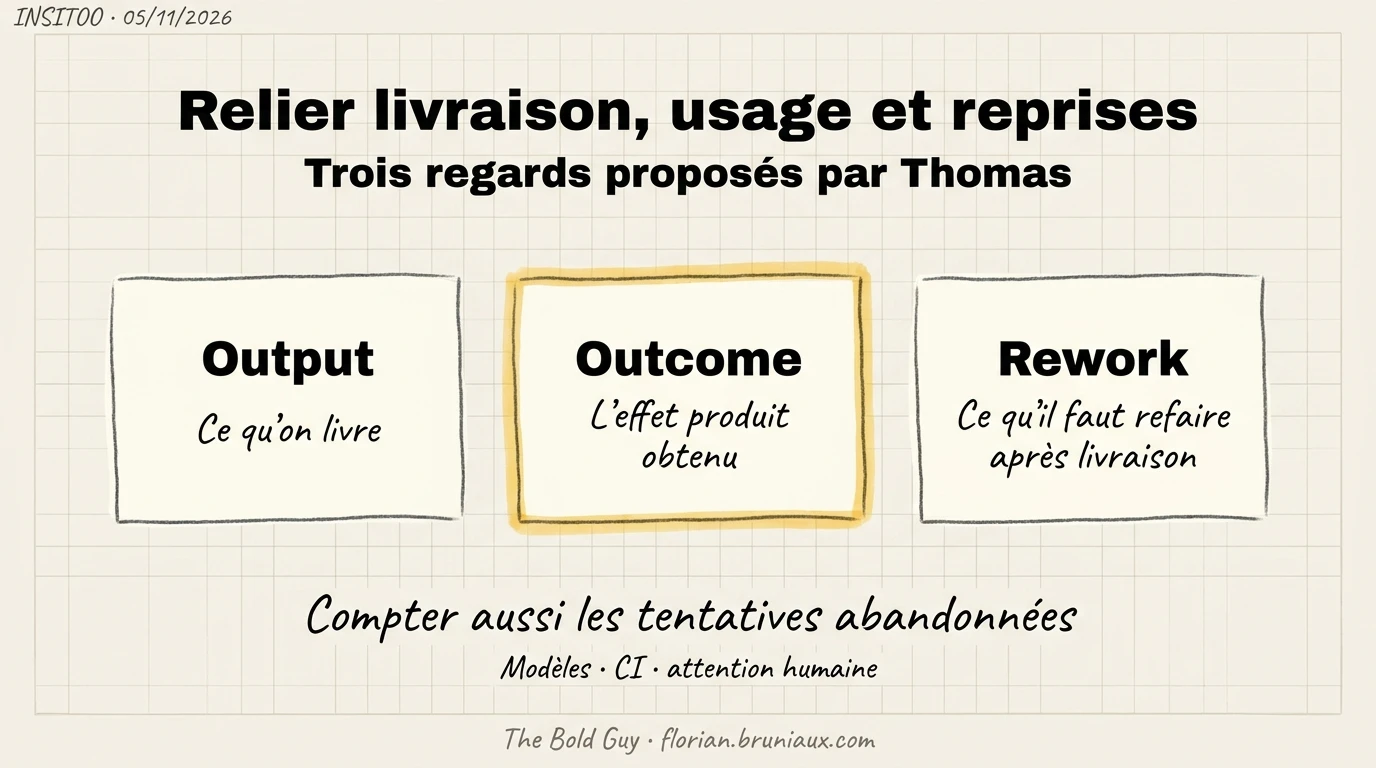
Thomas me demande si je mesure le rework. Je réponds surtout par les coûts à suivre : les tokens, les relances de CI et de déploiement, puis le temps qu’on passe à revenir vérifier. Les nombres de relances que je cite sont des exemples. Je n’ai pas présenté de relevé comparatif.
Pour mesurer ça, je prendrais une catégorie de tâches et je garderais un même relevé jusqu’au résultat accepté et à son usage :
| Regard | Question à examiner |
|---|---|
| Livraison | Combien de temps jusqu’au résultat accepté, attente comprise ? |
| Effet produit | L’utilisateur accomplit-il mieux la tâche visée ? |
| Reprises | Qu’a-t-il fallu corriger après livraison, et pour quelle raison ? |
| Coût complet | Quel effort humain et quelles dépenses pour l’ensemble des tentatives ? |
Je garderais les essais abandonnés dans le compte, y compris avant livraison. Je noterais les changements de modèle et de configuration quand ils aident à comprendre les écarts. Sinon, avec des tâches différentes à chaque fois, je ne sais pas quelle part attribuer à l’outil.
J’ai déjà rencontré ce problème en mesurant ma propre consommation d’IA. Les outils ne comptaient pas la même chose. Cet audit sépare les tokens observés, l’équivalent tarifaire API et le montant payé. Il ne mesure pas le rendement économique de tout mon travail.
Chez Vanessa, le produit doit suivre les nouveaux délais, le support mettre à jour la documentation et les équipes clients expliquer ce qui sort. Les recrutements ont été différés. Ils reprennent pour avancer sur la roadmap technique et la dette accumulée. Le besoin de développeurs n’a donc pas simplement disparu.
Thomas décrit une trajectoire voisine dans The hardest part begins when it works, du 11 octobre 2026 : les blocages passent de la review au support, puis au produit. Il rapporte aussi une perte de compréhension métier dans certaines équipes. Il parle d’autres équipes que celle de Vanessa.
Quand Damien nous demande s’il faut réduire les effectifs, je parle plutôt de rôles qui peuvent bouger. Des personnes côté produit peuvent contribuer à la réalisation. Les développeurs expérimentés gardent du travail pour fiabiliser ce qui sort et entretenir les contrôles. Thomas distingue le product builder venu du produit et le product engineer qui prend davantage de sujets produit. Il décrit une même forge, avec des vérifications et un accompagnement adaptés au travail confié. Un nouveau module et le cœur métier de l’entreprise ne présentent pas les mêmes risques.
J’avais aussi préparé des cas de files d’attente et de fonctionnalités peu utilisées, sans tous les raconter à l’antenne. Je les développe dans l’article sur le travail qui arrive jusqu’aux utilisateurs.
Réponses aux questions du chat
Ces réponses sont rédigées après le live, à partir des échanges et des commentaires. Je complète les points restés ouverts. La capture du chat est partielle, notamment la fin de la réponse de Vanessa.
Qu’avez-vous arrêté de déléguer à l’IA, et pourquoi ?
Maher Jendoubi
Le cas que j’ai raconté, c’est la feature que l’agent ajoute sans qu’on l’ait prévue, spécifiée ou testée. Je la fais retirer du diff, remettre au backlog ou isoler sur une branche. Le code est déjà là, mais ça ne suffit pas pour le livrer.
Je garderais les décisions sur le besoin, le périmètre et l’acceptation chez une personne identifiée. L’agent peut proposer et préparer une livraison. Le droit de publier se décide à part. On n’a pas établi de liste complète de ce qu’on aurait arrêté de déléguer pendant le live.
Comment éviter que chacun produise des choses sans rapport avec la vision produit ?
Simon Chaveneau
Je laisserais de la place aux essais, avec un budget et des accès connus. Avant qu’un prototype devienne un outil de l’entreprise, je demanderais quel problème il résout, pour qui, qui accepte le résultat et qui le maintiendra.
Une idée peut rester une expérience, rejoindre le backlog ou être arrêtée. Si on l’intègre au produit, la vérification, la documentation et la maintenance font partie du travail. Les collègues doivent savoir s’ils reçoivent un prototype ou quelque chose qu’on s’engage à faire vivre.
Le recrutement AI-friendly exige-t-il d’être déjà un expert ? Comment apprend-on ensuite ?
Sébastien Levy
Vanessa précise dans les commentaires que son test ne cherche pas des « gurus ». Elle regarde si la personne comprend le besoin, vérifie les propositions et explique ses choix. Un débutant critique peut avoir un meilleur retour qu’un expert des prompts qui accepte tout.
Elle décrit ensuite l’apprentissage entre collègues et les ateliers internes sur des cas réels. J’ajouterais les accès, du quota et quelqu’un à qui poser ses questions quand ça bloque. En entretien, je demanderais au candidat de montrer une proposition qu’il a refusée et ce qu’il a vérifié avant d’en accepter une autre.
Pour pratiquer sur un même cas du début à la fin, mon parcours Claude Code et son projet compagnon Proofpack proposent des exercices de configuration, de code et de vérification (en anglais).
Est-ce vendeur de recruter pour s’occuper de la dette technique ?
Yann Jahier
Ça peut l’être si on explique le travail et les moyens de le faire. Vanessa préfère être transparente sur la réalité du poste. Elle apprécie qu’un candidat demande où on en est et ce qu’il faudra reprendre.
Je présenterais un problème concret, la marge de décision et le temps prévu pour s’en occuper. Fiabiliser un parcours ou réduire les reprises de livraison peut donner envie, si la personne peut agir dessus. Promettre une refonte sans lui laisser de marge risque surtout de créer un malentendu.
Avec un modèle local, la question des tokens ne se pose-t-elle plus ?
Vincent Royer
Le local peut éviter la facture à l’appel d’un fournisseur. Les tokens restent l’unité du contexte et du calcul. Agrandir le contexte demande aussi plus de mémoire, comme l’explique la documentation Ollama.
Pour comparer, je prendrais la même tâche et les mêmes critères d’acceptation. Je regarderais le résultat, la latence, le temps passé à corriger et le coût de la machine et de son entretien. Pendant le live, on a partagé des essais, dont le modèle lent ou instable décrit par Vincent. On n’a pas fait ce comparatif.
Le cache permet-il d’économiser des tokens ?
Maher Jendoubi
Quand le fournisseur le prend en charge, le cache peut réutiliser un préfixe déjà traité s’il correspond exactement. La génération continue à consommer des tokens. La documentation Claude distingue lectures du cache, écritures et tokens neufs. Sur un abonnement fixe, économiser du quota ne réduit pas forcément la facture.
Le comparatif des mécanismes de réduction des tokens distingue ce cache de la compression et du filtrage des sorties (en anglais).
Quel harnais utilises-tu, concrètement ?
Maher Jendoubi
Je pars de Claude Code ou Codex, puis j’ajoute ce dont j’ai besoin. Pour un mail, ça peut être mon style et quelques règles de formulation. Sur un produit partagé, le processus Aristote documenté va plus loin :
- Le contexte : besoin, règles métier, architecture et conventions du dépôt.
- Des instructions et skills pour chercher, planifier, critiquer, coder et relire.
- Les outils : code, tests et connexions aux données ou tickets autorisés.
- Les contrôles : permissions, hooks, tests, analyse statique et CI.
- De quoi reprendre : décisions, état du plan et points ouverts.
- La livraison : version examinée, résultats des contrôles et autorisation de publier.
Les droits d’accès et l’activation des hooks se vérifient dans l’environnement utilisé. Leur présence dans les fichiers ne suffit pas. Je développe cette organisation dans le système de contexte partagé.
Comment utiliser « livsh » ou OpenCode avec IntelliJ IDEA ?
Vincent Royer
OpenCode peut se lancer dans le terminal d’IntelliJ, depuis le dossier du projet. C’est le mode décrit dans sa documentation IDE. Ça ne lui donne pas automatiquement accès à l’index de l’IDE.
Pour un modèle local, je vérifierais d’abord le serveur d’inférence, puis sa connexion comme fournisseur dans OpenCode. Un serveur MCP qui expose l’index ou les outils d’IntelliJ est une connexion distincte. Je commencerais par lire un fichier, faire une modification délimitée et lancer un test.
Le nom « livsh » reste incertain et je n’ai pas pu consulter le dépôt tide cité dans le chat. Je n’ai donc pas de configuration testée à fournir pour ce montage précis.
Comment savoir quel agent ou quelle tâche consomme le quota partagé ?
Alexandre Mikulaniec
Je relierais chaque exécution à une tâche, un client ou agent, un modèle et une période. Quand les outils le permettent, j’ajouterais les tokens neufs, le cache, les tentatives et leur statut. Les abandons et les relances restent dans le compte.
On peut ensuite rapprocher ce relevé du quota et de la facture. Avec un abonnement, la répartition exacte par tâche peut rester incomplète. Ça permet déjà de savoir quel usage mérite d’être revu.
J’aborde le choix du responsable et du budget dans FinOps appliqué aux tokens (en anglais).
Pourquoi dire « harnais » plutôt que contexte, contrôle, sécurité et cadre ?
Laurence Poussard
On peut très bien l’expliquer sans le mot : les informations données à l’IA, les outils qu’elle peut utiliser, les actions autorisées et les vérifications avant d’accepter son travail. Pour un bug, ça veut dire le comportement attendu, le code utile, les tests et la limite sur la publication.
J’utilise « harnais » pour cet ensemble. Le mot ne désigne ni une norme ni une garantie de sécurité. Si chacun y met des choses différentes, autant commencer par les nommer.
Mon guide sépare aussi modèle, harnais, instructions et permissions (en anglais).
Quel est le projet Kenjaku évoqué par Thomas ?
Maher Jendoubi
Kenjaku est le second cerveau de Thomas, fondé sur ses notes, avec recherche et sources. Son README sépare la recherche locale du raisonnement Claude dans le cloud. Une recherche locale ne veut donc pas dire que tout reste sur la machine. Je n’ai pas audité le projet.
Quel outil affiche les diagrammes Mermaid dans le terminal ?
Précision de Florian après le live
Je parlais de Prismantis, un mod Claude Code qui affiche les tableaux en couleur, le code avec coloration syntaxique et les diagrammes Mermaid dans le terminal.
Guillaume a aussi proposé Termaid dans le chat.
Il ajoute aussi une consigne pour encourager les diagrammes. Dans l’article de Nahum Litvin, l’auteur chiffre cette consigne à environ 630 tokens par prompt dans la version décrite.
Je suis en train de le tester. Le rendu me plaît, mais je ne sais pas encore quel effet il a sur ma consommation de tokens.
Pour les exemples, mes schémas Claude Code couvrent le contexte, les permissions et les workflows multi-agents (en anglais).
Je peux raconter que je produis plus, mais il faut aussi compter le travail jeté. Avant d’en tirer une décision d’organisation, je voudrais suivre ce qui a été accepté, utilisé et repris.
À la fin de l’échange, je me décris comme un peu « chien fou ». J’aime accélérer, tester, voir jusqu’où ça peut aller. J’ai aussi besoin de profils comme Thomas qui me demandent si je suis sûr de mon coup. Je peux faire une connerie, surtout quand je suis déjà tenté de lancer le sujet suivant.
À retenir
(Ce que vous savez maintenant)
- Le harnais se décrit par le contexte, les outils, les permissions et les vérifications qu’on prépare autour de l’agent
- Les essais partagés de Vanessa donnent un exemple d’apprentissage collectif, y compris quand le quota devient une contrainte
- Mes trente ou quarante sessions incluent des résultats abandonnés et ne démontrent aucun multiplicateur de valeur
- L’exercice de recrutement décrit par Vanessa observe le raisonnement, les vérifications et les décisions du candidat
- L’output, l’outcome et le rework permettent de poser des questions distinctes sur la livraison, l’usage et le coût des reprises
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Related appearances
Live appearances and podcast episodes about this article.