Transformer les commentaires de review récurrents en contrôles testés
Quand la même correction acceptée revient, tester si elle relève d'un linter, d'un type, d'un test, d'un exemple, d'une règle de repository, d'une checklist ou d'une décision architecturale.
Aller au résumé ↓ Florian Bruniaux
Engineering the Review Loop · Partie 5/8
TL;DR
Pour traiter un défaut récurrent et confirmé, je choisirais le contrôle le plus ciblé capable de le détecter, puis testerais aussi ce contrôle sur des alternatives valides. Une instruction supplémentaire n’est utile que si le contexte manquant contribue à l’échec.
| Décision | Preuve nécessaire à la promotion |
|---|---|
| Regrouper les commentaires récurrents par cause | Exemples revus par un humain, pas seulement des comptes de mots-clés |
| Choisir le premier contrôle fiable | Lint, type, test, analyse statique, exemple, instruction du repository, checklist ou décision architecturale |
| Ne promouvoir que les corrections stables | Récurrence, impact, stabilité de la correction et risque acceptable de faux positifs |
| Tester avant déploiement | Cas d’entraînement et cas positifs et négatifs réservés à l’évaluation |
| Maintenir la règle | Responsable, raison, télémétrie, date de review et possibilité de retrait |
Si un reviewer écrit chaque semaine la même correction acceptée, l’équipe rachète continuellement la même leçon.
Avant d’allonger le prompt ou d’ajouter un reviewer, demandez-vous si cette classe d’échec peut passer dans le premier contrôle fiable du harnais de développement.
Parfois, la réponse est un linter ou un test. Parfois, le commentaire dépend de l’intention produit et doit rester à la charge d’une personne. Les distinguer exige des preuves, car la répétition seule ne rend pas une règle correcte.
Séparer le symptôme de la cause
Les commentaires de review décrivent des symptômes à différents niveaux :
- « Use the shared date helper » (traduction : « utiliser l’utilitaire de dates partagé ») peut indiquer une préférence de style, un invariant de localisation ou un défaut de fuseau horaire
- « Check the account owner » (traduction : « vérifier le propriétaire du compte ») peut indiquer une condition manquante isolée ou un échec plus large du modèle de contrôle d’accès
- « Add a test » (traduction : « ajouter un test ») peut indiquer une faible couverture, un besoin non documenté ou une implémentation difficile à tester
Promouvoir directement la phrase en règle encode souvent le symptôme. Un contrôle de chaîne de caractères sur l’utilitaire partagé peut rejeter des alternatives correctes sans prouver le comportement des fuseaux horaires. Un prompt disant « check permissions » (traduction : « vérifier les permissions ») peut reproduire le même jugement vague sur chaque pull request.
Construisez un groupe autour de la cause sous-jacente. Conservez le commentaire original, l’emplacement du diff, la décision acceptée, le code final et le besoin. Demandez à un reviewer humain de confirmer que les exemples vont ensemble. Une même phrase récurrente peut couvrir plusieurs causes, et une cause peut s’exprimer par de nombreuses phrases.
Une review peut instruire le processus de production
La discussion IFTTD de Yacine Hmito fournit une distinction utile : l’inspection identifie une mauvaise pièce, tandis que l’amélioration change la production de la suivante. Il prend l’exemple de la définition d’un bon test unitaire pour un agent. Écrire l’instruction force son auteur à expliciter les critères de qualité tacites ; distribuer cette instruction n’établit pas que chaque opérateur peut évaluer le résultat.
Cela justifie 2 contrôles séparés avant de promouvoir un commentaire de review. Testez si le nouveau contrôle distingue l’échec d’une alternative valide et vérifiez que les personnes qui l’utilisent comprennent sa frontière. Le témoignage d’Hmito motive cette méthode ; il ne prouve pas une réduction des reprises pour le système décrit ici.
Le coût peut aussi se déplacer dans la boucle automatisée. Dans Tokenomics, Salim et ses collègues ont tracé 30 tâches ChatDev avec un modèle de raisonnement GPT-5 ; l’étape itérative de code review consommait en moyenne 59,4 % des tokens. Ce résultat mesure les tokens dans un framework multi-agent, pas le temps humain de review ni le coût de promotion d’une règle dans ce workflow. Il incite à suivre review automatisée et correction comme des coûts distincts lors de l’évaluation d’un contrôle.
L’étude Marmelab de François Zaninotto, fondée sur 246 repositories open source de harnais, arrive à une recommandation de maintenance voisine : tester le harnais lui-même, déplacer les contraintes exécutables dans des scripts, observer l’usage et retirer les composants obsolètes. Son inventaire décrit le contenu de ces repositories. Il ne mesure pas l’effet du processus de promotion de règles proposé ici.
Live AIDD : collecter les rapports, conserver la décision de promotion
À 25:00 dans le live AIDD du 16 octobre 2026, je décris la conservation de rapports JSON de correction et l’analyse périodique des échecs répétés. À 49:00, je précise la frontière d’automatisation : une analyse planifiée combine logs, issues et erreurs Sentry pour préparer des priorités. Je décide toujours des changements. C’est une pratique de collecte décrite, pas un système autonome qui promeut ses règles ni une réduction mesurée des reprises.
L’échec à 1:03:00 concerne le harnais lui-même : j’avais cassé un skill TDD, et le développement avait continué sans tests avant que je le remarque. Corriger un défaut visible par l’utilisateur n’aurait pas réparé ce chemin d’instructions. Cela motive la conservation d’un cas comportemental vérifiant que la procédure de développement produit et exécute encore les tests attendus, à côté des tests de l’application.
À 1:11:00, je décris le fait de faire écrire aux agents des scripts et CLI réutilisables que les personnes peuvent aussi lancer sans LLM. Cela donne à une propriété stable un chemin d’exécution concret, mais le script exige encore ses propres contrôles. Le live est distinct de la conférence Dev With AI du 12 octobre ; les sous-titres automatiques et le début manquant limitent le compte rendu. Ces anecdotes ne fournissent ni les cas réservés ni les mesures avant/après exigés ci-dessous.
Envoyer chaque classe vers le bon contrôle
Le cadre de harness engineering de Birgitta Böckeler (2 avril 2026) appelle cette maintenance menée par l’humain la boucle de pilotage : les échecs récurrents alimentent des modifications des guides et capteurs. Cela n’établit pas un apprentissage autonome.
Utilisez le mécanisme le plus ciblé capable de vérifier la propriété :
| Destination | Adaptée à | Peu adaptée à |
|---|---|---|
| Formatter ou linter | Syntaxe, nommage, imports, API interdites, schémas structurels locaux | Intention métier et comportement entre services |
| Système de types ou schéma | États invalides, champs requis, formes aux frontières, variantes exhaustives | Autorisation à l’exécution et comportement temporel |
| Test unitaire ou de contrat | Comportement déterministe aux entrées et sorties stables | Compromis produit ambigus |
| Analyse statique | Flux de données, propagation de données non fiables, dépendances et schémas de sécurité connus | Besoins absents du code et de la configuration |
| Exemple ou fixture | Schéma préféré que développeurs et agents peuvent copier | Propriété qui doit bloquer du code invalide |
| Instruction de repository | Contexte, conventions, responsabilités et procédures nécessaires pendant le travail | Invariants mécaniques qu’une commande peut imposer |
| Checklist humaine | Questions rares à fort impact exigeant un jugement contextuel | Contrôles déterministes fréquents |
| Décision architecturale | Compromis durables, frontières et exceptions justifiées | Erreurs d’implémentation ligne par ligne |
Une instruction peut apprendre à un agent où réside une frontière. Un test déterministe peut établir qu’une implémentation respecte une propriété explicite. Utilisez les deux lorsque la règle exige contexte et application stricte.
Placez le contrôle dans la première boucle disposant d’assez d’informations. Un formatter appartient à la boucle interne de l’auteur. Un test de contrat peut tourner localement puis en CI. Une décision concernant le risque entre services peut rester à la frontière de la pull request avec un responsable nommé.
À 19:40 dans sa conférence sur la livraison assistée par agents, Lauren Tan énonce son objectif architectural : « the easy path is the right path for agents. »1 Traduction : « Le chemin facile est le bon chemin pour les agents. » Le skill correct de Pstack en fait une procédure concrète : regrouper les erreurs répétées, essayer architecture et types avant lint ou tests, et exiger que chaque nouveau contrôle échoue sur une vraie erreur passée. Son principe encode-lessons-in-structure explicite la même préférence. Le déclencheur de deux occurrences dans correct est une heuristique de workflow, pas un remplacement des critères de risque, de stabilité de correction et de faux positifs ci-dessous. L’existence de ces instructions n’établit aucune réduction de récurrence.
Utiliser un seuil de promotion
Une règle candidate devrait satisfaire 4 conditions avant déploiement :
- Récurrence observée. La même classe d’échec arbitrée apparaît dans plusieurs modifications ou chez plusieurs auteurs sur une fenêtre déclarée.
- Correction stable. Les reviewers s’accordent sur le résultat valide et la correction ne dépend pas d’une préférence non documentée au cas par cas.
- Impact significatif. La classe cause des défauts, des reprises, une exposition à des risques de sécurité ou assez d’attention répétée pour justifier sa maintenance.
- Risque acceptable de faux positifs. Le contrôle peut distinguer les exceptions valides ou les faire passer par une procédure explicite de suppression d’alerte.
L’hypothèse centrale n’est pas encore mesurée : aucun jeu de données avant/après lié ici ne montre qu’une règle promue depuis une review a réduit les reprises. La méthode ci-dessous vise à produire ces preuves.
Une leçon proposée exige encore une source et un responsable
AutoHarness sépare capture, propositions sans accès en écriture et promoteur unique qui écrit : un schéma de maintenance utile à examiner. Le 26 septembre 2026, sa suite fournie passait 410 tests, et 16 reproductions ciblées sur la révision épinglée trouvaient encore des lacunes que le compte rendu d’évaluation relie au code. Des preuves fabriquées étaient acceptées sans lien à une transcription, et créer un skill pouvait écraser un skill appartenant à l’utilisateur. Ces cas visaient à sonder les frontières et ne disent rien de la fréquence des échecs en usage.
Gardez observation, interprétation, règle candidate et règle promue distinctes. Résolvez les contradictions en vous appuyant sur une source consultable, nommez qui peut promouvoir la règle et qui la maintient, et validez la totalité du candidat avant distribution.
Pour chaque commentaire récurrent, décidez d’automatiser un invariant stable, de conserver le jugement humain contextuel ou de retirer un conseil sans valeur démontrée. Maintien et retrait exigent des raisons. Le nombre de commentaires seul ne fournit aucune de ces raisons.
Garder les candidats rejetés hors des instructions actives
WikiSkill, prépublication d’août 2026 de Tang et ses collègues, sépare traces immuables, wiki révisable et skills actifs. Son harnais externe n’accepte que les améliorations de validation et annule les skills rejetés, y compris en cas d’égalité, tout en préservant le wiki et les résultats des propositions.
Pour cette boucle de review proposée, conservez la source de chaque candidat, son diff, la version du jeu de données, l’exécutant, le budget d’outils, le score et la décision de maintien ou rejet. Une instruction rejetée peut rester hors du contexte actif tandis que ses preuves alimentent une maintenance ultérieure. De nouveaux besoins ou de nouvelles preuves peuvent justifier un réexamen.
Concevoir une procédure et l’exécuter sont des capacités distinctes. Le tableau 2 rapporte que Qwen-3.5-9B atteint 70,2 % sur ALFWorld avec des skills développés par Qwen-3.6-27B, contre 63,4 % avec les siens. Le transfert peut aussi nuire : les skills de Qwen-3.5-4B font baisser le résultat SpreadsheetBench de Gemini-3.5-Flash de 50,5 % à 18,1 %. Évaluez les procédures avec l’exécutant, les outils et la classe de tâches visés.
Le protocole expérimental injecte tout le texte des skills actifs dans le prompt ; ces résultats n’évaluent donc ni récupération ni activation. Ils ne mesurent pas non plus les résultats à long terme des code reviews ni la baisse des reprises pour ce workflow proposé.
Améliorer séparément l’auteur et le reviewer
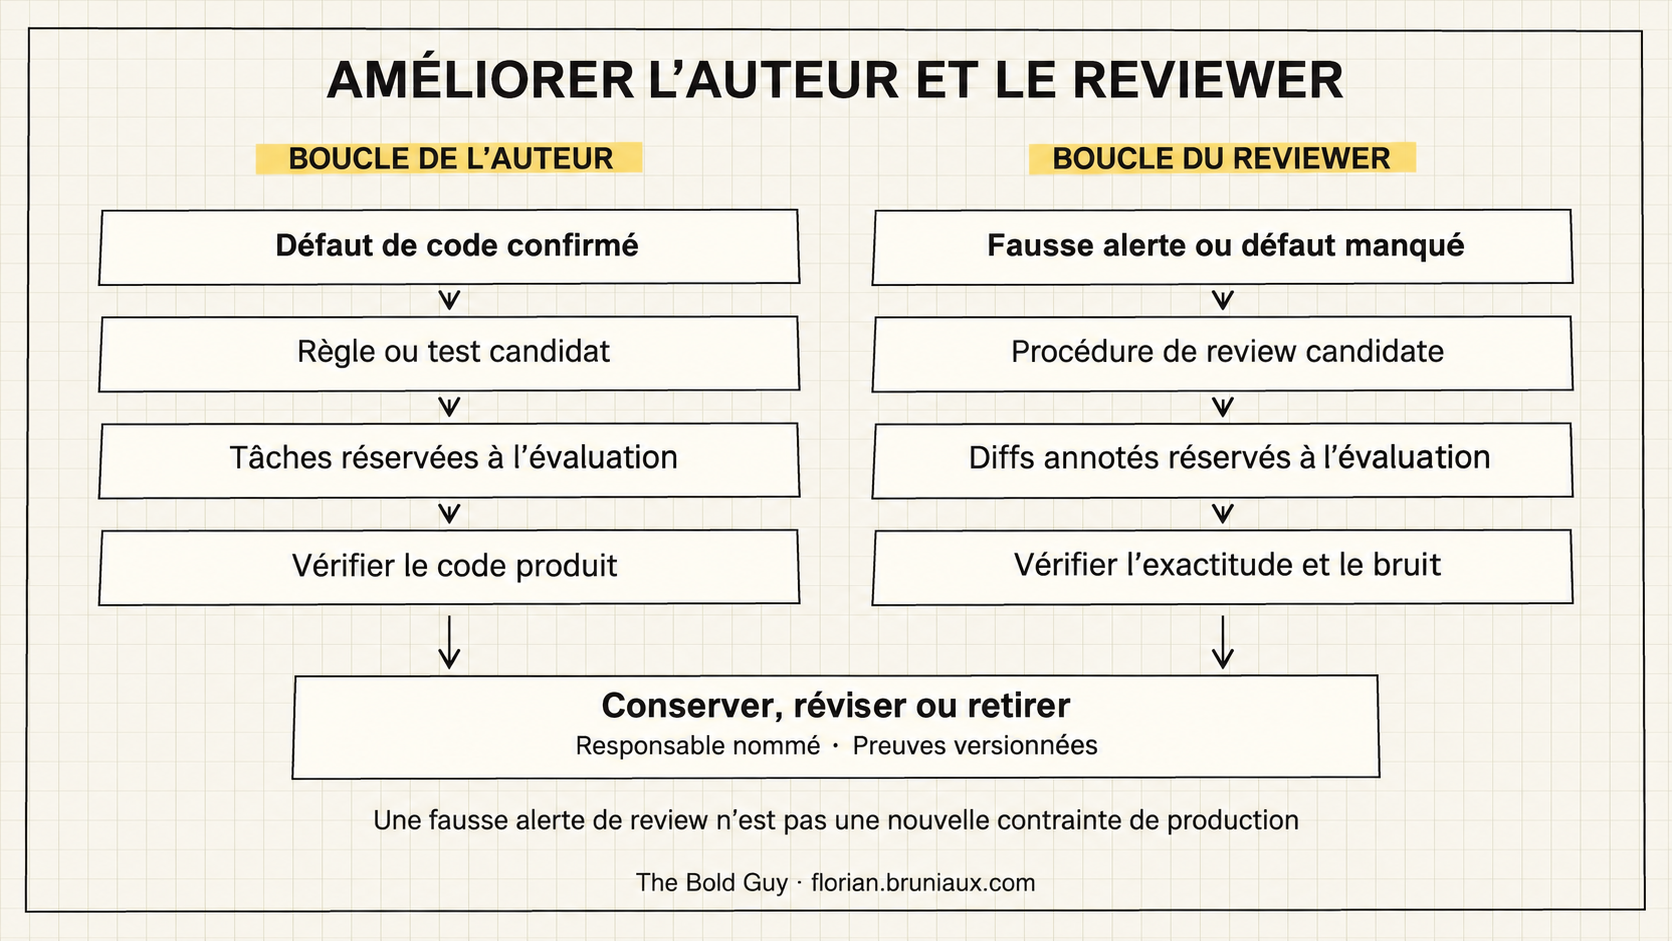
Une review peut révéler un défaut du code ou de la procédure de review. Donnez à ces observations des boucles d’amélioration séparées :
| Cible | Changement candidat | Évaluation réservée | Preuves de décision |
|---|---|---|---|
| Harnais de l’auteur | Règle, exemple, skill ou test exécutable répondant à un défaut de code confirmé | Tâches réservées avant d’ajuster le candidat | Code produit vérifié indépendamment, exigences non satisfaites, alternatives valides et reprises |
| Harnais du reviewer | Contexte, prompt ou procédure répondant aux fausses alertes, défauts manqués ou doublons | Diffs réservés avec annotations indépendantes, y compris des modifications valides | Précision, rappel lorsque la référence le permet, taux de doublons et coût humain de triage |
Pour un défaut d’autorisation construit, un candidat côté auteur pourrait enseigner où la propriété du compte est contrôlée et ajouter un test comportemental pour un autre acteur. Évaluez si les nouvelles tâches omettent encore ce contrôle et si des implémentations valides restent possibles.
Supposons maintenant que le reviewer signale à tort une autorisation manquante parce qu’il n’a jamais inspecté le service partagé qui contrôle déjà la propriété. Le candidat appartient à la procédure de review : inspecter la frontière d’autorisation appelée avant d’émettre ce signalement. Évaluez-le sur des diffs annotés avec et sans protection. Exiger que chaque appelant duplique le contrôle du service transformerait une erreur du reviewer en code de production inutile.
Gardez des versions et résultats de candidats séparés pour ces boucles. Une amélioration de l’auteur n’établit pas la précision du reviewer, et un rapport plus propre n’établit pas une meilleure qualité du code produit. Chaque candidat exige un responsable nommé, une décision maintenir/réviser/retirer et de nouveaux cas réservés si l’ancien jeu d’évaluation sert à ajuster le candidat.
Apprendre sur des exemples, valider sur des cas réservés
Dans l’entretien AI Engineer avec Cat Wu et Thariq Shihipar, à 16:27, publié le 15 juillet 2026, les intervenants décrivent l’ajout de PR impliquées dans des incidents à un jeu d’évaluation de code review pour contrôler les régressions des changements suivants. C’est une pratique attribuée, sans jeu de données public ni effet mesuré dans ce passage. Elle donne une source concrète de cas à conserver, plutôt que de traiter chaque commentaire récurrent comme une nouvelle instruction.
Distinguez maintenance des prompts et réentraînement des modèles. When AI Reviews Its Own Code, de Song, Cai et Zhao, soumis le 26 juin et révisé le 12 octobre 2026, étudie le fine-tuning récursif sur du code généré. Son dernier résumé rapporte un autocontrôle dont l’acceptation augmente tandis que la justesse au benchmark baisse. Ce résultat concerne leurs régimes de réentraînement, pas le workflow de promotion de règles ici ni les reviewers de pointe actuels. Ma boucle proposée garde les cas vérifiés en dehors du système et l’évaluation réservée séparés du système proposant sa propre amélioration.
Séparez le corpus avant d’implémenter la règle :
- les cas positifs d’entraînement contiennent l’échec ciblé
- les cas négatifs d’entraînement lui ressemblent mais sont valides
- les cas positifs réservés testent la détection d’instances inédites
- les cas négatifs réservés testent si la règle rejette du code valide
Utilisez le sous-ensemble d’entraînement pour écrire la règle et ses messages. N’ajustez pas la règle en fonction du sous-ensemble réservé après chaque échec. Si vous révisez la règle après inspection des résultats réservés, versionnez le jeu de données et réservez un nouveau sous-ensemble de validation.
Un enregistrement minimal de règle peut ressembler à ceci :
schemaVersion: 1
ruleId: auth-owner-scope
owner: platform-security
reason: "Mutations must bind the target resource to the authenticated owner"
sourceCluster: review-cluster-2026-014
implementation: tests/security/owner-scope.test.ts
trainingSet: datasets/auth-owner-scope/train-v1.yaml
validationSet: datasets/auth-owner-scope/held-out-v1.yaml
approvedFalsePositiveRate: 0.02 # FP / (FP + TN) on adjudicated negative cases
reviewAfter: 2026-12-01
removal: "Delete the rule only after an approved replacement passes the same held-out set"
Le taux de cet exemple est un paramètre de la politique, pas une recommandation mesurée. Choisissez un seuil correspondant au coût d’un défaut manqué et au coût de l’interruption.
Exécutez le candidat sur les cas positifs et négatifs. Consignez défauts manqués, faux positifs, échecs d’exécution et durée. Une règle qui détecte tous les exemples d’entraînement et rejette du code valide réservé n’est pas prête.
Encoder le comportement, pas une seule forme acceptable
Prenons un test de pont conçu pour cet exemple. Exiger un tablier plat rejette une arche sûre ; vérifier largeur, hauteur et longueur peut approuver 2 moitiés déconnectées. Les deux règles manquent le but : un passage sûr sous la charge requise. En logiciel, une règle imposant un nom d’utilitaire précis peut rejeter une alternative valide, tandis qu’un test qui ne vérifie que la forme peut accepter une implémentation qui échoue à accomplir la tâche de l’utilisateur.
Écrivez l’invariant comportemental d’abord. Incluez une alternative valide comme cas négatif du détecteur et un défaut superficiellement conforme comme cas positif. Si le contrôle ne les distingue pas, réduisez la portée de son affirmation ou gardez-le consultatif. Ne promouvez pas une préférence récurrente de reviewer en invariant bloquant simplement parce qu’elle revient souvent.
Un test promu depuis un commentaire de review exige le même contrôle. TDD avec Claude Code exige qu’un test de régression échoue sur l’implémentation inchangée pour la raison comportementale attendue, puis passe avec la correction. Un test qui n’a jamais échoué n’a pas montré qu’il détecte le défaut.
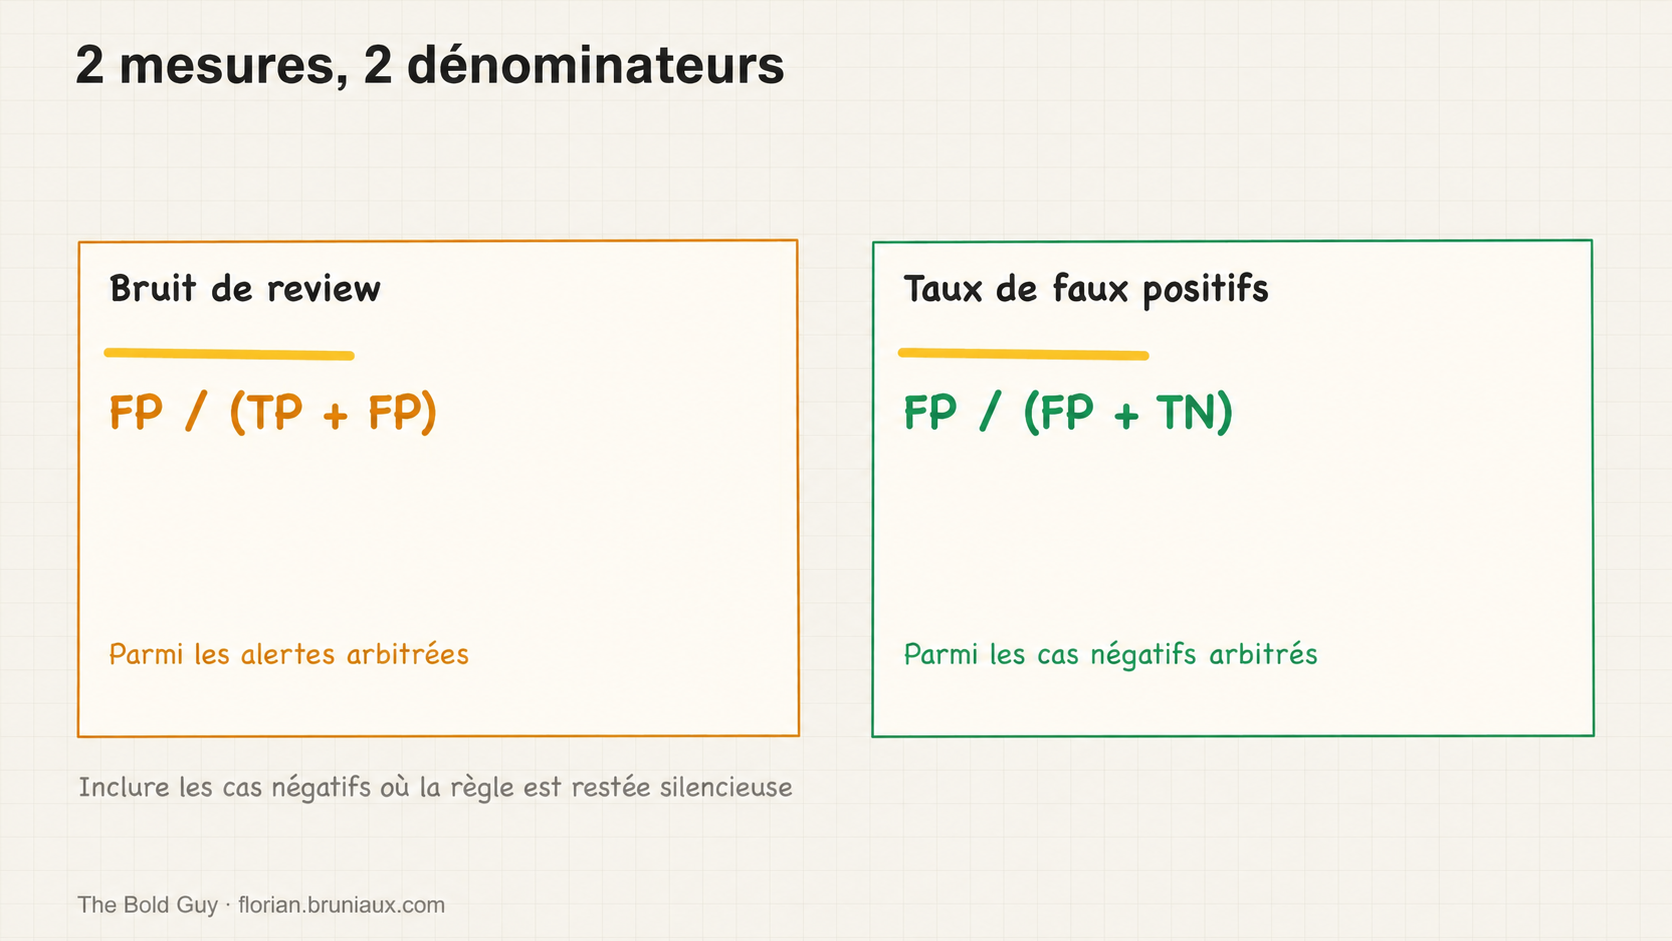
Gardez les dénominateurs explicites. La fraction d’alertes jugées fausses, FP / (TP + FP), mesure le bruit de review. Le taux de faux positifs, FP / (FP + TN), exige des cas négatifs arbitrés, y compris ceux où la règle est restée silencieuse. Ils répondent à des questions différentes et ne doivent pas partager une étiquette.
Donner à la règle un responsable et une sortie
Les règles vieillissent. Les API changent, l’architecture évolue et une exception valide peut devenir le parcours courant. Une règle sans responsable devient une dette du harnais.
Conservez :
- la classe d’échec et les preuves originales
- la propriété exacte imposée
- les versions d’implémentation et de configuration
- le responsable autorisé à la modifier
- la politique de suppression d’alerte et la justification requise
- les champs de télémétrie
- la prochaine condition ou date de review
- la procédure de retrait ou remplacement
Une suppression d’alerte est une donnée. Capturez son emplacement, son approbateur et le besoin éventuel de réparer le message ou la portée de la règle. Des suppressions répétées inexpliquées peuvent montrer que le contrôle a déplacé le bruit de review dans la CI.
Une faible fréquence d’invocation ne suffit pas à retirer un contrôle. Un garde-fou pour une action rare à fort impact peut rester utile même si les exécutions ordinaires ne le déclenchent jamais. Distinguez les contrôles non découverts, chargés mais inutilisés, invoqués et inefficaces, et efficaces seulement sur le parcours exceptionnel. Rejouez l’incident original et les alternatives autorisées avant de changer la portée.
Le retrait exige la même discipline que l’ajout. Exécutez le contrôle de remplacement sur le jeu réservé conservé, comparez le comportement et gardez la décision. Ne supprimez pas une règle bruyante sans vérifier si elle empêchait aussi un échec à fort impact.
Mesurer la méta-boucle
Comparez des fenêtres équivalentes avant et après promotion. Rapportez la distribution des modifications et tout changement concomitant de politique.
| Mesure | Définition |
|---|---|
| Taux de récurrence | Instances arbitrées de la classe d’échec par modification éligible |
| Constats de review évités | Échecs de règle corrigés avant l’exécution habituelle du reviewer |
| Fausses alertes parmi les échecs de règle | FP / (TP + FP) : échecs de règle invalides divisés par tous les échecs de règle arbitrés |
| Taux de faux positifs sur les cas négatifs | FP / (FP + TN) : fausses alertes divisées par tous les cas négatifs arbitrés, y compris ceux qui ont réussi le contrôle |
| Taux de suppression d’alerte | Suppressions approuvées divisées par tous les échecs de règle |
| Défauts échappés | Défauts du jeu de référence dans la même classe non détectés avant la frontière choisie |
| Charge de review | Décisions humaines et temps consacré à la classe |
« Avoided finding » (traduction : « constat évité ») exige une frontière contrefactuelle explicite. Un échec de règle local corrigé avant review montre une intervention de la règle. Il ne prouve pas qu’un reviewer précis aurait publié le même commentaire ; rapportez donc un nombre d’interventions plutôt que du travail de review évité.
Un commentaire de review accepté n’est pas automatiquement un vrai défaut. Une suppression d’alerte n’est pas automatiquement un faux positif. Arbitrez les deux selon la propriété déclarée de la règle et le besoin produit.
La méta-boucle réussit lorsqu’un contrôle versionné fonctionne mieux sur les cas réservés et que les mesures opérationnelles s’améliorent dans la fenêtre déclarée. Installer la règle prouve seulement qu’elle existe.
Garder le jugement là où l’invariant est instable
N’automatisez pas mécaniquement un commentaire lorsque la bonne réponse dépend d’un choix produit non résolu, d’un jugement éthique ou juridique, d’une migration ponctuelle ou d’une action irréversible. Une règle peut assurer qu’une personne nommée revoit un changement de paiement ou de contrôle d’accès. Elle ne doit pas fabriquer sa décision.
Gardez les humains responsables de :
- besoins contradictoires et impact utilisateur flou
- acceptation du risque et exceptions à la politique de sécurité
- compromis architecturaux avec plusieurs résultats valides
- migrations destructrices et effets de bord externes
- changements où les preuves disponibles ne peuvent pas établir l’invariant
La frontière sépare les propriétés stables exécutables du jugement contextuel, quelle que soit la personne qui les traite aujourd’hui. Les reviewers font émerger des candidats des deux types, et le harnais n’absorbe une propriété qu’après que le contrôle a passé son propre test.
Pas encore démontré : un cas mesuré exige un corpus versionné de commentaires, des groupes revus par des humains, au moins 1 règle évaluée sur des cas positifs et négatifs réservés et une fenêtre avant/après définie. Sans cela, la baisse des reprises, des défauts échappés et de la charge de review reste non mesurée.
La partie 6, Exploiter un système multi-reviewers en sécurité, étend la même discipline aux frontières avec les fournisseurs, aux entrées non fiables, à la normalisation, aux budgets, à la réponse aux incidents et à l’arrêt.
YSNK
(Vous devriez maintenant savoir)
- Regrouper les retours de review par cause avant d’en encoder la formulation
- Ne promouvoir que des classes récurrentes, stables et significatives avec un risque acceptable de faux positifs
- Valider les contrôles candidats sur des cas positifs et négatifs réservés
- Donner à chaque règle un responsable, une télémétrie, une condition de review et un chemin de retrait
- Préserver l’autorité humaine pour l’ambiguïté, les compromis et les décisions irréversibles
Footnotes
-
La citation suit les sous-titres anglais automatiques originaux de la vidéo, vérifiés le 3 novembre 2026 par comparaison avec l’archive du 15 octobre. Le repère temporel localise le passage ; c’est un témoignage attribué de praticienne, pas un résultat mesuré indépendamment. ↩
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.