Une configuration d’agents portable est un système de release, pas un dossier partagé
Partager instructions, skills et définitions MCP Claude Code et Codex via des releases versionnées, adaptateurs d’hôte et contrôles de l’installation et du comportement à l’exécution.
Aller au résumé ↓ Florian Bruniaux
TL;DR
Je décrivais auparavant la configuration d’agents par un pourcentage fixe de portabilité. C’était pratique et faux. Je la traite maintenant comme un système de release, pas un dossier partagé, et mesure la couverture par capacité et état de preuve : tout ce qui n’a pas été testé sur une surface d’hôte nommée reste UNKNOWN.
| Couche | Unité portable | Ce qui varie encore |
|---|---|---|
| Source | Politiques partagées, corps des skills, styles de réponse, scénarios et définitions de serveurs | Surcouches d’hôte et exceptions déclarées |
| Développer | Une release immuable avec projections natives Claude Code et Codex | Noms de fichiers, schémas et adaptateurs |
| Installation | Modifications des instructions, skills, styles et hooks actifs liées à une empreinte | Chemins natifs, magasins de confiance et cycle de vie |
| Exécution | Même politique prévue et corpus de routage | Ce que chaque client a chargé, invoqué et imposé |
| Audit | Un contrat statique de preuve | Canaris comportementaux par surface |
La conversion MCP était le dernier manque que je citais avec ce pourcentage fixe. Je ne l’avais pas mesuré, et un en-tête secret n’est qu’un problème de conversion dans un système de distribution plus large.
Ma configuration Claude Code et Codex distingue maintenant six sujets : source canonique, releases immuables, projections d’hôte, installation transactionnelle, état de routage mutable et preuves d’exécution. Certains fichiers peuvent être partagés octet pour octet. D’autres nécessitent un adaptateur. Aucun choix structurel ne prouve qu’un client actif a suivi le résultat.
Cet article est la carte stable du système. Il se concentre sur Claude Code et Codex, les deux hôtes que j’ai implémentés et audités. Cursor n’apparaît qu’en exemple voisin, où un concept commun peut avoir un contrat différent. Je ne déduis pas la parité de noms de fichiers similaires.
L’unité portable est une arborescence source
Copier un dossier dans deux répertoires personnels retire de la duplication. Cela ne crée pas un système fiable. Une installation fiable doit répondre à quatre questions :
- Quels fichiers font autorité ?
- Quels artefacts appartiennent à chaque hôte ?
- Quelle release exacte est active ?
- Quelles preuves montrent son utilisation par le client ?
Je garde l’autorité éditable dans une arborescence unique. Règles partagées et courtes surcouches Claude Code et Codex cohabitent. Les skills ont un corps canonique. Les politiques de hooks vivent dans des noyaux purs avec adaptateurs séparés. Les grandes références restent hors des instructions permanentes.
agent-config/
├── src/
│   ├── instructions/
│   │   ├── shared.md
│   │   ├── claude.md
│   │   └── codex.md
│   ├── skills/
│   │   ├── common/
│   │   └── host-specific/
│   ├── hooks/
│   │   ├── policy-core.mjs
│   │   ├── claude-adapter.mjs
│   │   └── codex-adapter.mjs
│   ├── output-styles/
│   │   └── claude.md
│   ├── routing/
│   │   └── scenarios/
│   └── reference/
├── releases/
└── scripts/
Le générateur combine instructions partagées et surcouche d’un hôte. Il écrit un CLAUDE.md plat pour Claude Code et un AGENTS.md plat pour Codex. Je ne fais importer la source mutable par aucun de ces deux fichiers actifs. Une session doit voir une projection autonome d’une release identifiée.
Cette distinction résout aussi la question projet/global. Le modèle de build reste le même. Seule la destination d’installation change.
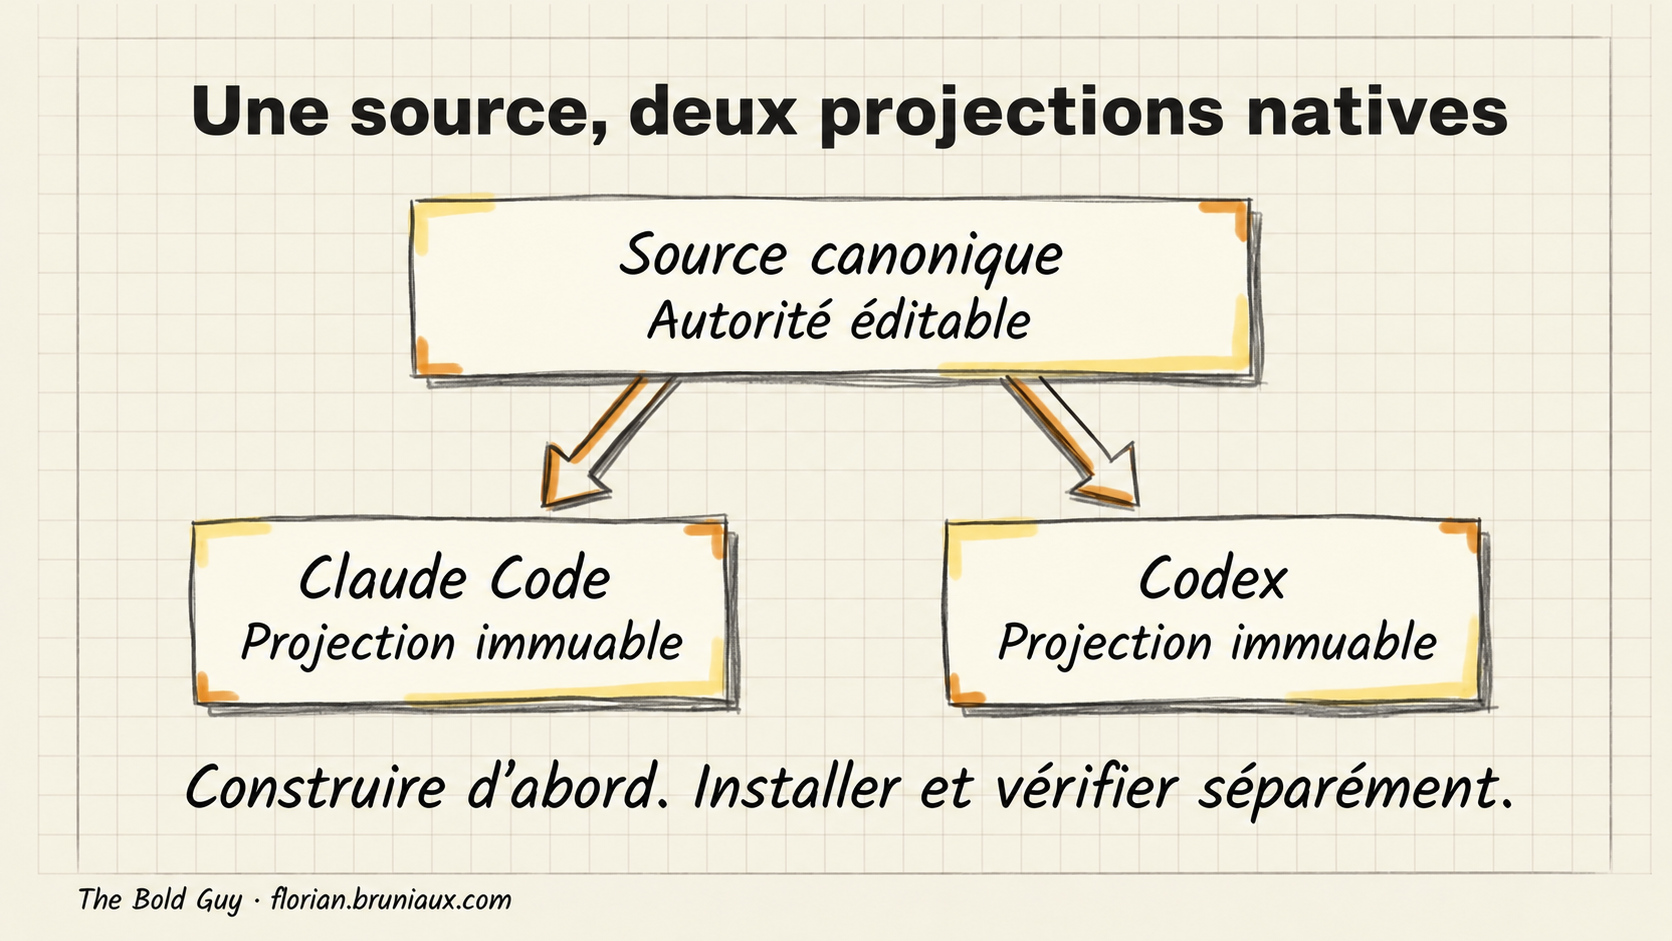
L’arborescence src/ est la source canonique. releases/<release-id>/ contient les projections de build inertes. Aucune n’est un emplacement actif de découverte. L’installation place les artefacts choisis dans ces destinations natives :
| Surface | Projet Claude Code | Global Claude Code | Projet Codex | Global Codex |
|---|---|---|---|---|
| Instructions | CLAUDE.md | ~/.claude/CLAUDE.md | AGENTS.md | ~/.codex/AGENTS.md |
| Skills | .claude/skills | ~/.claude/skills | .agents/skills | ~/.agents/skills |
| Output style | .claude/output-styles | ~/.claude/output-styles | N/A | N/A |
| Hooks | .claude/settings.json | ~/.claude/settings.json | .codex/hooks.json | ~/.codex/hooks.json |
Les chemins projet sont relatifs à la racine du repository. Les chemins globaux sont la configuration utilisateur active. L’installateur compare ces destinations aux projections choisies sans jamais les considérer comme source canonique.
Dans cette conception, .codex/skills est une entrée historique de compatibilité, pas la racine canonique des skills Codex. Le routeur déployé l’ajoute automatiquement si le répertoire existe, avec priorité inférieure et provenance séparée de .agents/skills.
Projet et global ont des frontières de confiance différentes. Un repository peut relire ses skills locaux avec son code. Une release globale touche les sessions futures dans tous les repositories. L’installateur global ne doit pas absorber les fichiers d’un projet, et une synchronisation projet ne doit pas réécrire la configuration personnelle.
Les Output Styles concrétisent l’exception d’hôte. Claude Code a une surface native modifiant le prompt système de la conversation principale. Codex n’a pas d’artefact équivalent dans cette conception : la release ne contient qu’une projection Claude et consigne Codex comme N/A. L’étude de cas de l’Output Style Flow Lean montre pourquoi réglages de réponse, contexte projet et skills complets restent des sources distinctes.
Construire une release immuable avant de toucher à l’état actif
Chaque build produit des artefacts natifs dans un répertoire de release adressé par le contenu :
releases/<release-id>/
├── claude/CLAUDE.md
├── claude/output-styles/flow-lean.md
├── codex/AGENTS.md
├── reference/ANTI_AI.md
├── skills/
│   ├── common/
│   ├── codex-only/
│   └── projections/
│       ├── claude/
│       └── codex/
├── agents/
│   ├── claude/
│   └── codex/
├── hooks/
│   └── skill-router/
└── artifact-manifest.json
Le manifeste consigne l’empreinte de chaque artefact, la version du schéma et les exigences d’exécution. L’identifiant de release dérive de ce manifeste canonique. Reconstruire la même source doit produire les mêmes octets. Sinon, le générateur s’arrête.
Les liens symboliques peuvent réduire la duplication dans la release si chaque destination résolue reste dans l’arborescence immuable. Un lien d’un répertoire actif de skills vers une copie mutable a un autre sens. Son contenu peut changer sans nouvel identifiant, supprimant la preuve recherchée par le modèle de release.
Le pointeur actif current identifie une release complète. Il doit pointer vers un répertoire situé dans l’arborescence des releases, pas vers un chemin arbitraire ailleurs. Avant activation, un validateur indépendant recalcule les empreintes du manifeste et des artefacts. Faire vérifier sa sortie par le générateur lui-même transformerait un bug en deux affirmations concordantes.
Le générateur est inerte. Il écrit sous releases/ sans modifier la configuration active Claude Code ou Codex. La CI peut ainsi construire et inspecter un candidat sans permission de réécrire un poste développeur.
Installer avec une approbation liée au candidat et à la préimage active
La configuration globale a une grande portée. Une copie imprudente peut remplacer instructions, skills ou hooks de toute nouvelle session. Je sépare préparation et installation.
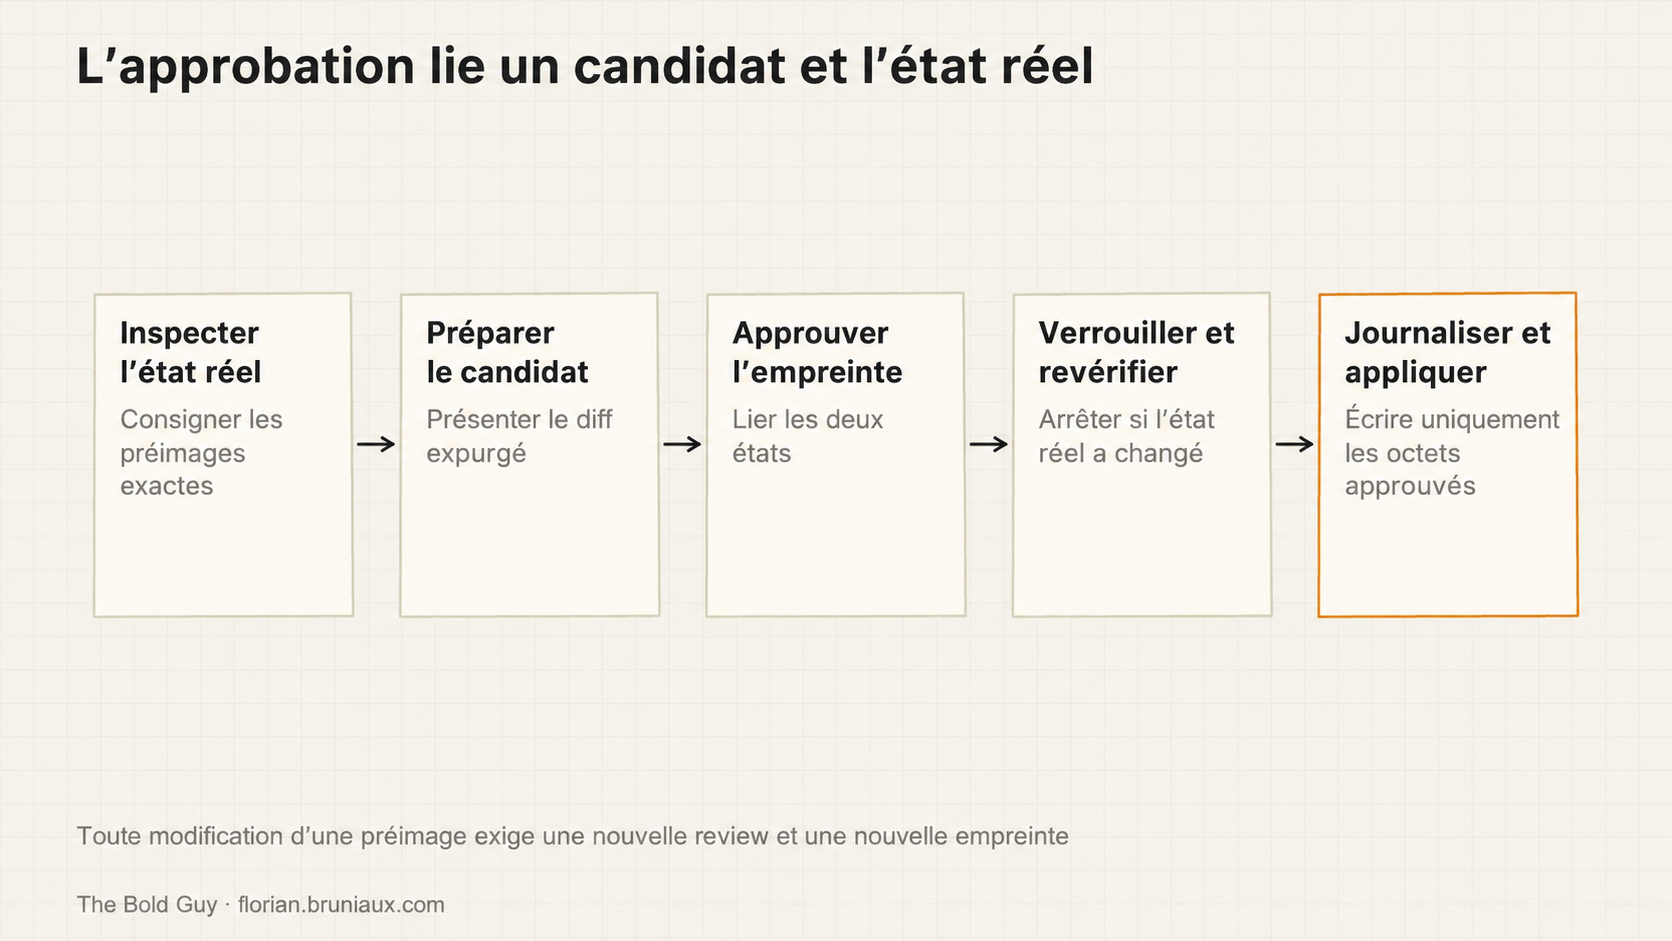
La préparation inventorie les destinations actives, calcule les empreintes de leur état exact, compare au candidat et produit un diff expurgé. Elle calcule ensuite une empreinte d’approbation couvrant les deux côtés de la transaction :
approval digest = hash(
  action
  + immutable release
  + candidate hashes
  + exact live preimage hashes
)
L’application accepte une chaîne d’approbation exacte. Elle revérifie la release, acquiert un verrou et recontrôle toutes les préimages avant la première écriture. Un octet changé invalide l’approbation. L’installateur prépare des instantanés et un journal durable avant toute mutation, puis utilise des remplacements atomiques si le système de fichiers le permet.
Cela peut paraître lourd pour du Markdown. Ses conséquences ne sont pas petites : ces fichiers peuvent orienter commandes shell, permissions, sélection de skills et hooks dans tous les repositories ouverts.
Les skills partagés ont besoin de découverte native et de provenance
Un corps de skill peut être portable sans que son chemin de découverte le soit. La release projette un package SKILL.md relu dans chaque arborescence native. Son catalogue de build consigne nom normalisé, hôte source et empreinte source. Le cache mutable du routeur consigne séparément chaque chemin actif, racine, portée, priorité et empreintes agrégées des sources et métadonnées pour l’hôte et le projet choisis.
Le builder rejette deux sorties normalisées au même nom et les chemins sortant d’une racine autorisée. Avant ce contrôle, sa priorité d’hôte explicite choisit un package source et consigne les collisions. La découverte à l’exécution suit sa propre priorité : premier skill actif conservé, chaque occurrence inférieure consignée comme shadowed_skill. Un doublon est donc visible sans faire disparaître toutes ses occurrences.
La découverte native reste le repli. Un routeur peut améliorer le rappel, mais ne doit pas devenir le seul accès au skill. Avec preuves de routage faibles, le skill reste installé et marqué native-only.
C’est aussi la frontière de la chaîne d’approvisionnement logicielle. Un skill porte des instructions influençant les outils. Importer un dossier d’un autre repository sans source ni empreinte distribue un prompt non relu aux deux hôtes. La portabilité du format ne rend pas le contenu fiable.
BM25 route des suggestions, pas une autorité
Le routage traite un autre problème que le partage de fichiers. Quand les deux hôtes découvrent un grand catalogue, inclure toutes les descriptions complètes dans chaque prompt gaspille le contexte et augmente les correspondances accidentelles. J’utilise un index BM25 conservateur pour suggérer peu de candidats.
Le cycle complet est :
native skill discovery
  -> provenance catalog
  -> positive and contrastive negative scenarios
  -> BM25 index and calibrated thresholds
  -> cache for one host and one project scope
  -> UserPromptSubmit hook
  -> zero to three suggestions
  -> host decides whether to invoke a skill
Chaque skill routé a des scénarios positifs et des négatifs proches. « Review this migration plan » et « implement this migration plan » (traductions : « Relire ce plan de migration » et « implémenter ce plan de migration ») partagent presque tout leur vocabulaire : les seuls positifs rendent le routeur trop confiant. Les scénarios négatifs définissent la frontière entre les intentions les plus proches.
L’index utilise un plancher positif de fréquence documentaire inverse et garde le meilleur score de scénario par skill. Il ne récompense pas le nombre d’exemples d’un auteur. L’évaluation au build utilise des sondes leave-one-out du corpus. La sonde courante est retirée des documents candidats, mais les statistiques IDF utilisent le corpus complet. C’est un contrôle interne de régression, pas un jeu de données indépendant réservé aux tests. Les skills manquant de rappel, se déclenchant hors sujet ou manquant de preuves contrastives restent native-only.
Le cache est mutable car il dépend de l’hôte, du repository, du répertoire de travail et des racines découvertes. Il n’appartient pas à la release immuable. Sa clé combine l’hôte et la portée. Je consigne la release et le catalogue qui l’ont produit, et je le reconstruis lorsque ces données changent.
Au moment du prompt, l’incertitude ne produit aucune suggestion. Cache indisponible ou mal formé non plus. Le hook laisse passer car le routage est une aide optionnelle, contrairement à un hook préventif devant parfois arrêter une écriture ambiguë.
Deux frontières gardent le routeur à sa place :
- Une invocation explicite contourne BM25.
- Un prompt reçoit au plus trois suggestions.
Le hook renvoie noms et chemins comme contexte. Il n’exécute pas de skill. Claude Code ou Codex applique toujours ses règles natives d’invocation, et l’utilisateur peut ignorer la suggestion.
Les hooks partagent la politique, pas l’analyse des payloads
La portabilité des hooks se résume souvent à l’existence d’un même nom d’événement dans les produits. Insuffisant. Un hook préventif doit reconstruire l’état candidat complet depuis le payload d’outil de l’hôte avant d’évaluer la politique.
Je partage le noyau pur et écris un adaptateur par hôte. Celui de Claude Code peut reconstruire un Write ou Edit structuré. Celui de Codex peut analyser une opération apply_patch et calculer le contenu candidat de chaque fichier concerné. Scanner le patch brut n’est pas équivalent : le texte retiré peut contenir une phrase interdite, et des hunks séparés peuvent ne créer une violation qu’après application.
Si l’adaptateur ne reproduit pas exactement une écriture prise en charge, le contrôle préventif retourne UNKNOWN et refuse. Les outils non pris en charge passent, car le hook ne revendique pas de couverture des redirections shell opaques, éditeurs externes ou de tout processus capable d’écrire.
L’installation reste propre à l’hôte : déclaration native, timeout et procédure de confiance. Changer une déclaration peut invalider la confiance sans changement de l’adaptateur. Une nouvelle session est requise comme preuve d’activation, un client ouvert depuis longtemps pouvant garder la configuration chargée au démarrage.
Un bug de conversion MCP montre pourquoi les projections nécessitent une politique
MCP est un cas utile, pas tout le problème. Claude Code accepte des définitions JSON, Codex stocke sa configuration MCP en TOML. Le générateur doit traduire les schémas en préservant les propriétés de sécurité des références à des secrets.
J’ai examiné Codex MCP writer et MCP schema dans la release taguée v9.6.3. Cette version mappe quelques champs connus et transmet les autres clés. Le schéma d’entrée conserve aussi les clés inconnues. Cela facilite la conversion large, mais le writer n’interprète pas une valeur HTTP générique headers comme référence secrète devant devenir env_http_headers dans Codex.
Cette inspection est liée à la version. Elle décrit v9.6.3, pas toutes les suivantes ni toutes les cibles de rulesync. Rulesync reste utile pour la diffusion large. Ce cas montre seulement pourquoi une projection nécessite parfois une politique de sécurité plus stricte.
Mon format source écrit un placeholder d’environnement, jamais la valeur secrète :
servers:
  documentation:
    type: http
    url: "https://mcp.example.test/mcp"
    headers:
      API_KEY: "${DOCUMENTATION_API_KEY}"
La projection Codex contient le nom de variable :
[mcp_servers.documentation]
url = "https://mcp.example.test/mcp"
env_http_headers = { "API_KEY" = "DOCUMENTATION_API_KEY" }
Le convertisseur n’accepte un placeholder que si toute la valeur correspond à ${VAR}. Il rejette une valeur mixte comme Bearer ${TOKEN} plutôt que deviner l’interprétation du client. Les valeurs statiques peuvent encore être émises comme en-têtes statiques si ce choix est intentionnel et relu.
Cette conversion est déterministe et testable unitairement. Elle ne prouve pas que le client a reçu la variable, s’est connecté au serveur ou a réalisé une requête MCP. Ce sont des questions d’exécution.
Cursor a des concepts voisins de skills, instructions, hooks et MCP, mais reste une projection séparée jusqu’au test de ses contrats de découverte, payload et confiance. Un JSON similaire prouve une proximité de schéma, pas une parité opérationnelle.
Six états de preuve évitent une confiance injustifiée
Les audits deviennent trompeurs quand toutes les couches sont réduites à « working » (traduction : « fonctionne »). J’utilise six états pour une capacité, hook ou skill partagé :
| État | Exemple de preuve |
|---|---|
| Présent | Fichier ou déclaration au chemin attendu |
| Installé | Octets correspondant au manifeste de la release choisie |
| Approuvé par le client | Identité exacte du hook ou de l’extension acceptée si nécessaire |
| Chargé | Nouvelle session exposant ou rapportant l’enregistrement attendu |
| Invoqué | Canari corrélé montrant l’exécution du composant |
| Effectif | Fichier, décision ou suggestion observés conformes au résultat prévu |
Une empreinte concordante peut prouver l’installation. Elle ne peut pas prouver le chargement. Une ligne de log peut prouver l’invocation alors que le client ignore une sortie mal formée. Un nom de skill suggéré peut prouver un routage positif alors que les cas négatifs et le contournement explicite échouent encore.
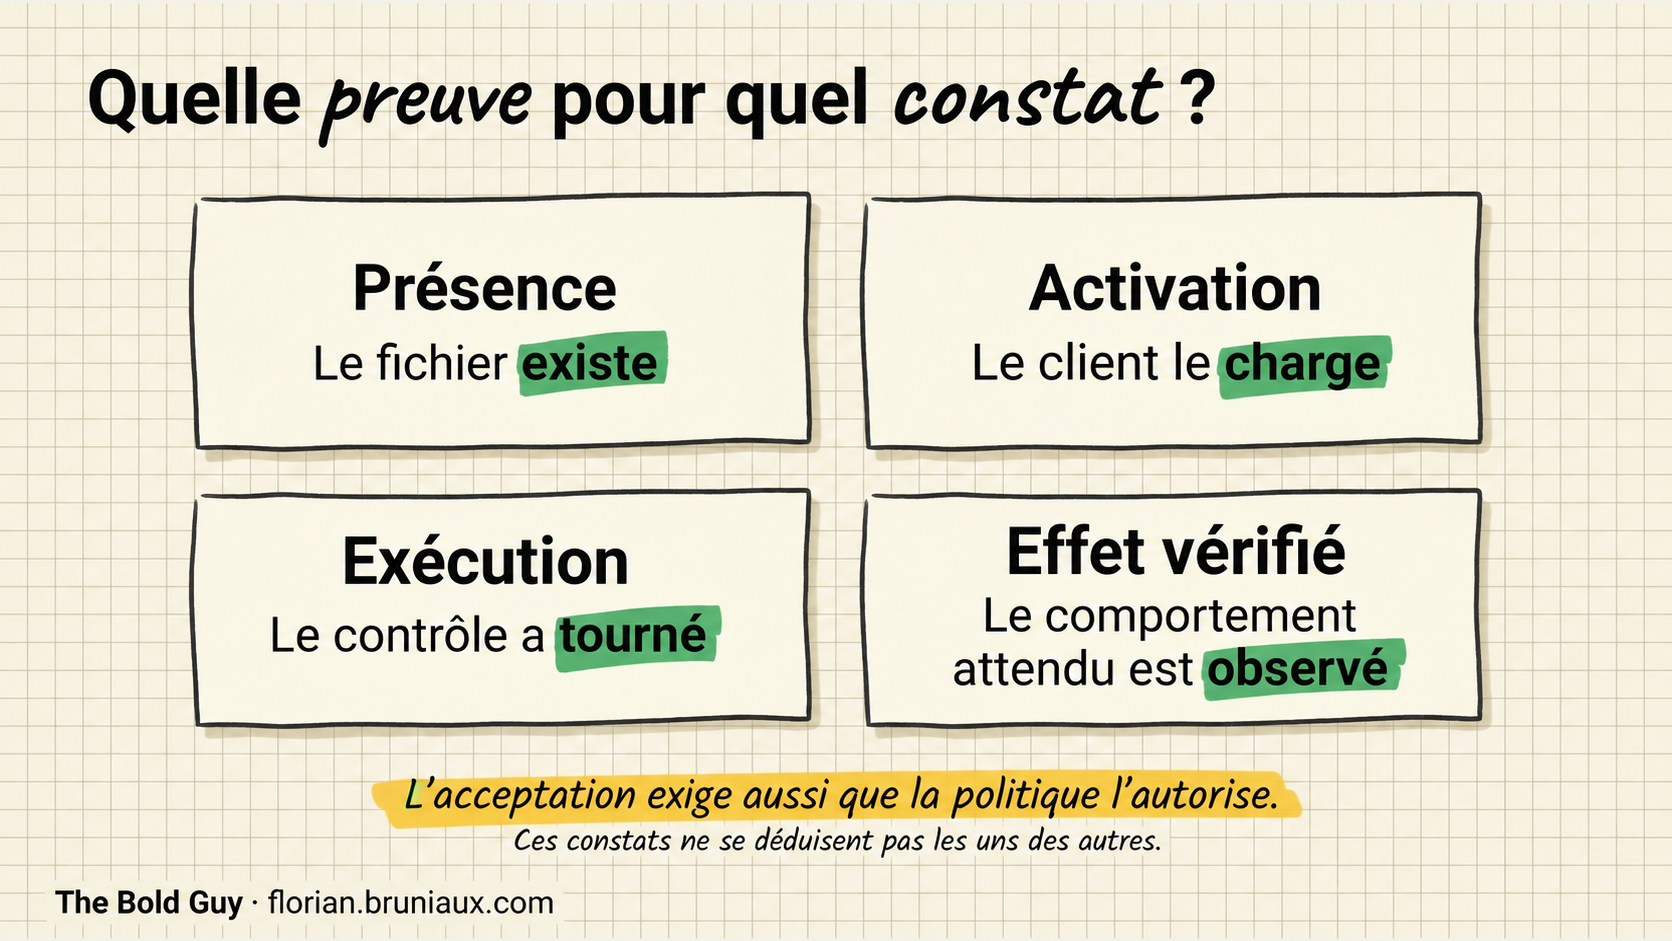
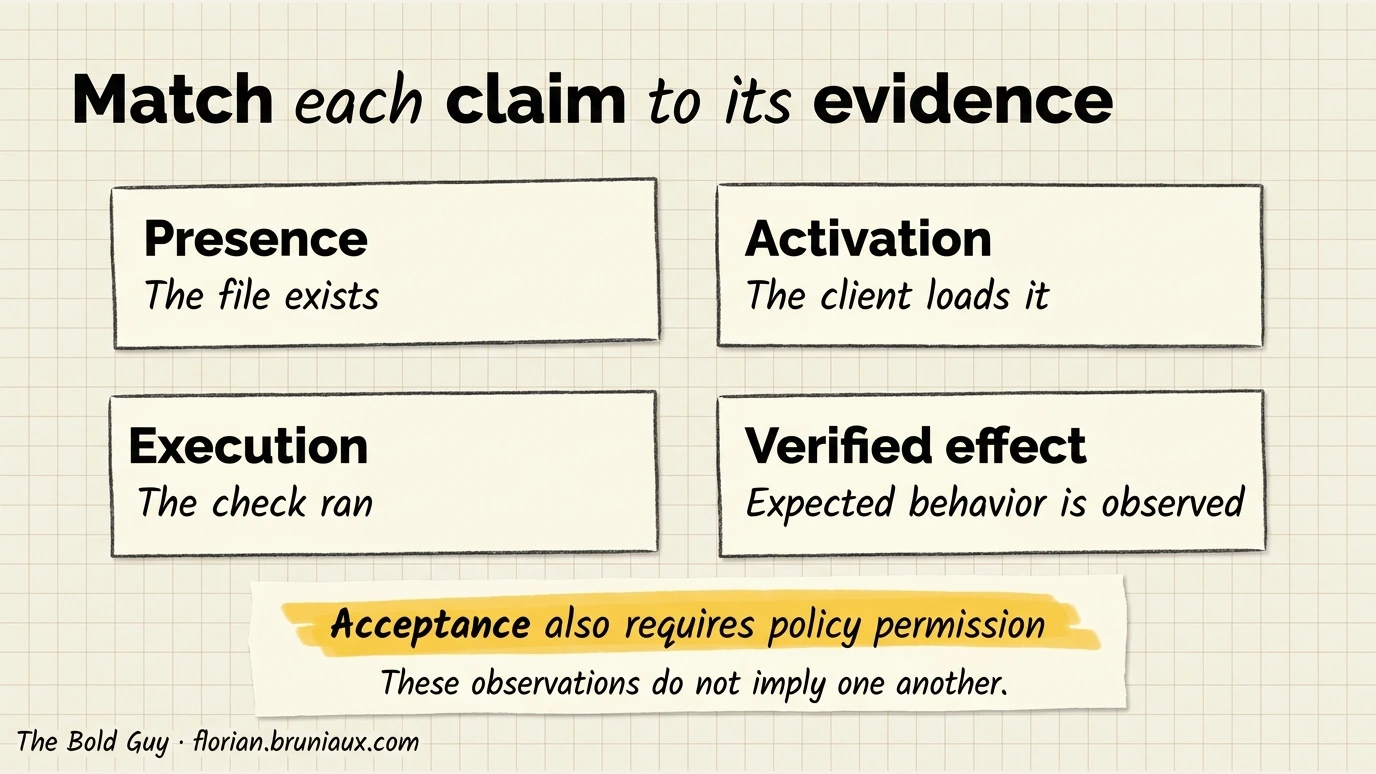
L’auditeur statique possède donc un contrat lisible par machine. Il inventorie les périmètres choisis Claude Code et Codex, valide instructions natives, skills, règles, agents, hooks, MCP et parité de release, puis émet des constats PASS, WARN, FAIL, UNKNOWN ou N/A. Un évaluateur consomme le rapport au lieu de rescanner avec un second moteur de politique.
Les preuves d’exécution sont jointes séparément. Canaris utiles : prompt devant suggérer un skill, prompt proche qui ne doit pas en suggérer, invocation explicite qui doit contourner le classement, écriture qu’un hook préventif doit refuser, écriture valide qui doit être autorisée et placeholder MCP qui doit être résolu sans afficher sa valeur.
Un Output Style demande une observation de config supplémentaire : le style sélectionné par les réglages résolus. La sélection ne prouve ni chargement ni effet. Une réponse canari en nouvelle session doit montrer le format attendu dans la conversation principale ; un sous-agent nommé reste hors de cette affirmation, avec son propre prompt système.
UNKNOWN n’est pas un succès. Cela signifie que les preuves choisies n’établissent pas l’affirmation. N/A diffère : une exception d’hôte déclarée rend le contrôle inapplicable. Aucun ne doit devenir un badge vert de parité.
L’inspection Walkinglabs a produit un repository synthétique avec score structurel de 100/100 et commande de vérification échouée. Cela reste compatible avec les six états : les fichiers attendus peuvent exister alors que le comportement décrit échoue. Un skill configuré peut aussi être consulté sans être invoqué ou utile. Consignez l’état atteint et la preuve de transition.
Séparer tests de release et évaluations de résultats
L’état des lieux des harnais de Marmelab demande si le harnais lui-même est testé et utilisé. Ici, cela sépare trois questions : respect des contrats par générateur et installateur, invocation du comportement installé par chaque client et amélioration d’une tâche acceptée.
Un hook refusant tout peut réussir une suite limitée aux écritures interdites. Un routeur peut reproduire ses scénarios d’entraînement et échouer sur des demandes réelles proches. Gardez cas autorisés et tâches inédites avec l’incident motivant chaque composant. Consignez release et surface client, responsable et condition de réexamen. Ce sont des exigences d’évaluation. La structure de release seule n’établit pas de réduction des défauts ou du coût.
La série d’implémentation en cinq guides
Je transforme cette architecture en cinq guides pratiques, sans date de publication fixée. Ils restent non publiés pendant la review des exemples de code, des liens croisés et des contrôles comportementaux. Cet article ne contient donc pas de liens vers des routes de brouillon qui renverraient une 404.
- Construire une configuration pour Claude Code et Codex définit source, release et projections.
- Partager les skills et router les prompts avec BM25 construit provenance, scénarios, seuils, caches et repli natif seul.
- Installer la configuration globale d’agents sans perdre l’état local implémente approbation par empreinte, journalisation et rollback détectant les divergences.
- Faire fonctionner les hooks dans Claude Code et Codex sépare noyaux de politique et adaptateurs de payload, puis définit les preuves d’activation.
- Auditer la configuration d’agents Claude Code et Codex ajoute un diagnostic statique sans réseau et des canaris d’exécution séparés.
L’ordre de lecture suit les dépendances. L’auditeur vient à la fin, après stabilisation des contrats de build, installation, routage et hooks. Commencer par un tableau de bord produirait un beau rapport sur des preuves indéfinies.
En attendant, le rapport d’inspection de la configuration active montre le résultat sur une machine à une date : pipeline de release, 4 couches, routeur BM25 et 3 lacunes détectées.
La frontière restante est comportementale
La source commune couvre bien plus que le convertisseur MCP ayant motivé l’article initial. Elle donne une place à chaque différence : politique partagée, projection d’hôte, état local mutable ou exception déclarée.
La difficulté n’est plus de copier du Markdown. C’est d’aligner les affirmations sur les preuves quand les clients évoluent. Une release structurellement valide peut coexister avec une session desktop utilisant un ancien état chargé. Un cache BM25 peut être frais avec un mauvais seuil. Un hook peut être approuvé et invoqué, mais sa décision inefficace.
Voilà pourquoi je n’associe plus de pourcentage de portabilité au système. La mesure utile est la couverture par capacité et état de preuve. Tout ce qui n’a pas été testé sur une surface d’hôte nommée reste UNKNOWN.
YSNK
(Ce que vous devriez maintenant savoir)
- Une configuration portable part d’une source canonique et produit des releases immuables natives par hôte.
- Claude Code utilise
.claude/skills, cette conception Codex.agents/skills;.codex/skillsest une entrée historique de migration. - BM25 ajoute zéro à trois suggestions optionnelles, laisse passer les invocations explicites et garde les skills faibles disponibles par découverte native.
- Présent, installé, approuvé par le client, chargé, invoqué et effectif sont des affirmations distinctes nécessitant leurs preuves propres.
- Un Output Style réservé à Claude est une projection déclarée, pas une preuve d’héritage par Codex ou un sous-agent nommé.
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source