Quand un reviewer indépendant justifie sa place
Comparer review indépendante, auto-review et contrôles déterministes. Mesurer les défauts supplémentaires détectés, les fausses acceptations, les régressions et le coût d'une passe supplémentaire.
Aller au résumé ↓ Florian Bruniaux
Engineering the Review Loop · Partie 2/8
TL;DR
Avant d’ajouter un reviewer, je veux des preuves qu’il détecte un défaut vérifié ou réduit assez les reprises pour justifier son coût. Un contexte neuf ou un autre fournisseur change le traitement ; cela ne suffit pas à établir un meilleur jugement.
| Décision | Preuve requise |
|---|---|
| Tester la valeur d’un reviewer supplémentaire | Comparer la même modification figée avec et sans le traitement de review supplémentaire |
| Traiter l’indépendance comme un protocole | Consigner modèle, fournisseur, contexte, prompt, outils, règles, budget et autorité de chaque passe |
| Séparer désaccord et qualité | Arbitrer les constats au regard du code sans révéler le nom du produit lorsque c’est possible |
| Borner les affirmations sur les produits | Friendly Reviewer est une déclaration d’intention de conception de son auteur ; le discours d’indépendance de Greptile est une déclaration du fournisseur |
| Reporter tout classement | Le rappel, les défauts manqués en commun et la supériorité d’un produit exigent un jeu de référence indépendant |
L’agent qui a écrit une modification a déjà une théorie expliquant pourquoi elle est correcte. Lui demander de revoir son travail peut révéler une coquille, un test en échec ou une incohérence, mais ne soumet pas cette théorie à une remise en question indépendante. L’auto-review conserve beaucoup des conditions qui ont produit la modification : la même interprétation du besoin, le même contexte sélectionné, les mêmes outils et souvent le même modèle. Une seconde passe assurée peut répéter l’angle mort de la première.
Un reviewer distinct peut appliquer un autre test, et sa contribution doit apparaître dans le protocole et dans le travail accepté. Un nouveau nom de produit, un chat neuf ou un autre fournisseur de modèles ne constitue pas une preuve suffisante à lui seul.
4 traitements et 1 arbitrage
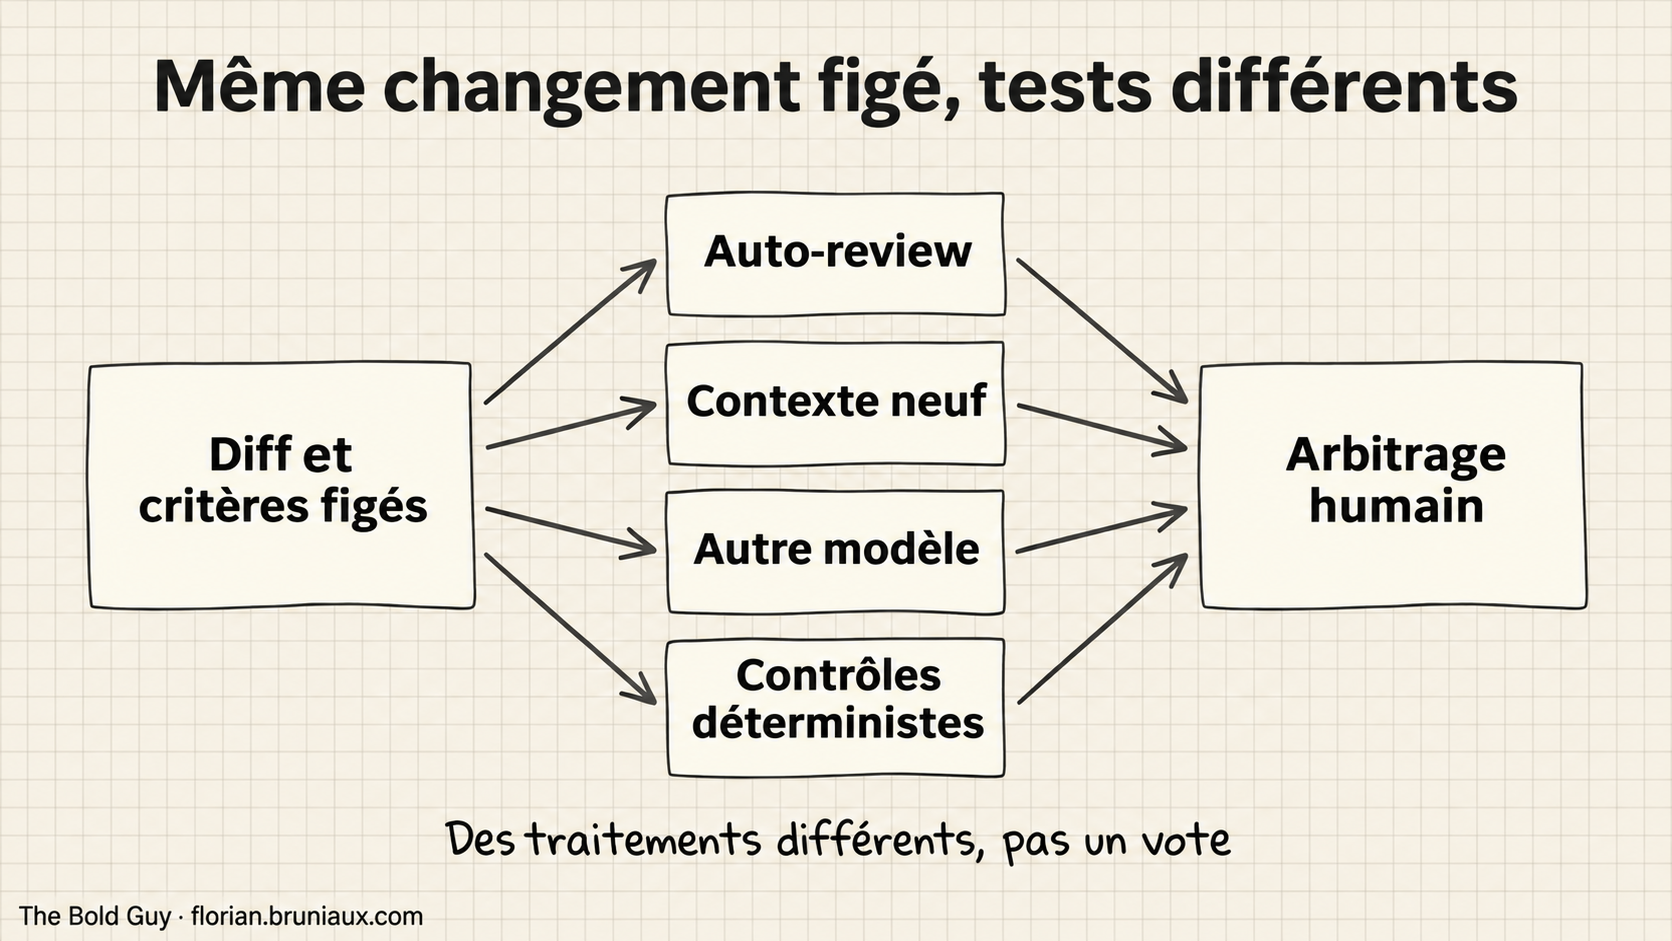
Une évaluation exige plus que « reviewed » et « not reviewed » (traduction : « revu » et « non revu »). Donnez le même diff figé et les mêmes critères de review à 4 traitements distincts, puis soumettez leurs constats à un arbitre humain :
- Auto-review dans la session de l’agent auteur. Cela mesure ce que l’agent auteur peut remettre en question en conservant son contexte de travail.
- Le même modèle dans un contexte neuf. Cela retire la mémoire conversationnelle tout en conservant la famille de modèles et une grande partie de son entraînement.
- Un autre modèle ou fournisseur. Cela change une source possible d’erreur, mais peut conserver le même besoin, les mêmes instructions de repository et les mêmes limites d’outils.
- Des contrôles déterministes. Tests, vérifications de types, linters, analyse statique et contrôles de politique évaluent des propriétés explicites sans dépendre du jugement d’un LLM.
L’arbitre humain n’est pas un cinquième traitement. Cette personne décide si chaque constat est étayé par les preuves figées et si la décision proposée convient au contexte produit et aux risques.
Les traitements ne votent pas. Les contrôles déterministes peuvent prouver qu’une assertion précise passe sur une révision nommée, mais ils ne peuvent pas déduire chaque règle métier manquante. Un modèle peut repérer une incohérence entre fichiers qu’aucun test actuel n’encode. L’arbitre peut résoudre une ambiguïté et accepter un compromis, avec une attention limitée et faillible.
La comparaison cherche une contradiction utile. L’accord peut refléter une convergence indépendante, mais aussi une mauvaise spécification partagée.
L’indépendance a plusieurs dimensions
SWR-Bench, de Zhengran Zeng et ses collègues, fournit une comparaison complémentaire sur 1 000 PR GitHub vérifiées manuellement avec le contexte du repository. La version du 5 juin 2026 évalue si les reviews générées couvrent les actions de modification annotées et rapporte des gains par agrégation de rapports. Sa référence inclut les changements de maintenabilité et les défauts fonctionnels, et la notation utilise un LLM, validé par rapport au jugement humain avec environ 90 % d’accord. Cela justifie de tester l’agrégation sur un corpus défini. Cela n’établit ni l’indépendance des erreurs, ni un classement des modèles actuels, ni une baisse du travail humain de review dans notre repository.
Même les noms de stratégies peuvent masquer un jugement partagé. La documentation actuelle d’elek, vérifiée le 14 octobre, indique que ses stratégies crosscheck et council emploient différents angles dans une seule session de modèle. Elles ne fournissent donc pas les sessions distinctes requises par la comparaison proposée ici. C’est une frontière d’implémentation documentée, pas un résultat de qualité.
Des reviewers dans des processus séparés peuvent encore commettre des erreurs corrélées. Inspectez au moins ces dimensions avant de qualifier la seconde passe d’indépendante :
| Dimension | Risque de corrélation |
|---|---|
| Besoin | Les deux reviewers reçoivent les mêmes critères d’acceptation incomplets ou faux |
| Contexte du repository | Les deux voient les mêmes fichiers sélectionnés et manquent la même dépendance ou contrainte opérationnelle |
| Outils | Les deux sont privés d’exécution de tests, d’inspection des dépendances, d’accès réseau ou de preuves de production |
| Modèle et données d’entraînement | Des prompts distincts adressés au même modèle peuvent reproduire le même raccourci appris |
| Prompt et règles | Des instructions de review partagées peuvent exclure la même classe de problème |
| Budget | Des limites similaires de tokens, de temps ou de fichiers peuvent tronquer les deux reviews au même endroit |
| Incitations et autorité | Les deux peuvent chercher un résultat vert ou éviter de bloquer l’auteur |
L’indépendance a donc des degrés. Un contexte neuf sépare la mémoire conversationnelle. Un autre modèle sépare une partie du chemin d’inférence. Un reviewer avec d’autres outils et des critères explicites de remise en question renforce cette séparation. Aucune de ces mesures ne répare un besoin faux que tous les participants traitent comme une autorité.
Les permissions de lecture seule réduisent les actions possibles d’un reviewer. Elles n’établissent pas l’indépendance de son jugement. De même, un contexte neuf peut hériter d’une passation biaisée. Consignez les preuves que le reviewer obtient indépendamment et les hypothèses qui restent partagées.
Préserver un jugement avant la synthèse
Une review assurée peut influencer le lecteur suivant avant qu’il ait examiné les preuves. Dans AI Agents Push Humans Out of the Loop, Margaret Mitchell, Avijit Ghosh et Samir Passi soutiennent que les systèmes d’agents actuels érodent l’attention dont dépend la supervision, par ancrage et fatigue d’approbation. Pour certaines tâches de comparaison, conservez le verdict initial de l’arbitre avant de lui montrer une autre review, puis notez toute révision et sa justification. L’utilité de cette mesure dans un workflow de review n’a pas été mesurée.
Comptez une suggestion qui introduit une régression comme une correction nuisible, même si quelqu’un l’a d’abord acceptée. Rapportez les défauts supplémentaires détectés, faux positifs, corrections nuisibles et effort de triage à côté du résultat final accepté.
Un évaluateur de fin de tâche a un rôle plus étroit
L’évaluateur d’objectif de Claude Code lit la conversation de l’agent auteur pour décider si les preuves enregistrées satisfont la condition de l’objectif. Il ne relance pas indépendamment les commandes et n’inspecte pas le repository. Addy Osmani fait cette distinction dans Practical Loop Engineering : le contrôle de fin ne remplace pas la review du travail produit.
Si la transcription consigne un contrôle de performance desktop réussi, cela n’établit pas un comportement mobile acceptable. La spécification doit nommer l’environnement requis, le worker doit conserver la mesure correspondante et le vérificateur assigné doit l’inspecter ou la reproduire. Gardez la décision de fin de l’évaluateur séparée de ce résultat de vérification et de la décision d’accepter la modification.
Un verdict contraignant exige encore une évaluation des résultats
Liza fournit un exemple inspectable de séparation exécutant/reviewer, appuyé par un superviseur déterministe. Le profil Liza du guide consigne les preuves dans le code au commit a22c12381c5d884d2586a48aaaa517bca184f9cf : frontières des rôles, transitions de tâches et intégration supervisée. C’est une analyse d’architecture rattachée à ce commit, pas une affirmation sur la dernière release ou sur une qualité de production mesurée.
Ces contrôles établissent quels verdicts peuvent faire avancer le workflow. Ils n’établissent pas à quelle fréquence un résultat accepté satisfait un besoin incomplet. Un reviewer distinct peut partager les hypothèses de l’auteur. Mesurez les fausses acceptations par rapport à une référence indépendante, puis testez la détection, le confinement et la récupération après une fausse acceptation. Un verdict contraignant donne de l’autorité au reviewer ; l’évaluation détermine si cette autorité se justifie dans le périmètre testé.
Friendly Reviewer a rendu cette question concrète
Lors d’un appel le 1er septembre 2026, Marc Hugon a décrit Friendly Reviewer comme délibérément séparé du harnais qui a produit le code. Vers 00:53:28 dans la transcription, il a dit que le reviewer devait être « très décorrélé » du système auteur parce que sa mémoire et son contexte peuvent biaiser la review.
C’est une déclaration d’intention de conception de l’auteur, consignée dans une transcription automatique non publique. La page publique du produit décrit des agents parallèles dont un agrégateur déduplique les constats. Aucune de ces sources n’est une inspection indépendante du service et aucune n’établit une meilleure détection des défauts.
Transparence : Marc Hugon me donne accès à Friendly Reviewer. Je le teste sur de vrais projets, signale des problèmes et discute avec lui d’idées produit et éditoriales. La collaboration est informelle et je n’ai pas été payé pour classer le produit. Cet accès reste une relation significative dont les lecteurs doivent être informés.
La discussion produit a soulevé une question fondée : le producteur du code devrait-il aussi être son propre juge ? Pour y répondre, il faut une comparaison figée et des sorties arbitrées.
Greptile montre pourquoi une étiquette commerciale n’est pas un résultat
La page sur l’indépendance de Greptile, consultée le 27 septembre 2026, présente le service comme « the independent code validator » (traduction : « le validateur de code indépendant »), une couche de validation indépendante des agents pour du code produit par plusieurs agents auteurs. Sa référence de configuration documente les règles au niveau du repository, les fichiers à lire pour le contexte et les réglages de contexte entre repositories.
Ces déclarations du fournisseur étayent ce que Greptile dit vouloir faire avec son service. Je n’ai inspecté ni exécution, ni contexte effectif, ni résultats comparatifs, et la documentation ne montre pas que ses erreurs sont indépendantes de celles d’un agent auteur.
La même frontière s’applique à tout reviewer commercialisé comme indépendant. Vérifiez quelles dimensions ont changé dans l’exécution réelle et considérez la qualité comme non mesurée tant que la sortie n’a pas été arbitrée.
Faire une comparaison figée avant d’ajouter un autre bot
Utilisez 1 dossier de review immuable pour tous les traitements :
schemaVersion: 1
repository: example/service
baseSha: 71d4c9a
headSha: c30f610
diffSha256: "<sha256>"
criteriaVersion: review-criteria-v3
allowedContext:
  - src/auth/**
  - tests/auth/**
forbiddenContext:
  - prior-reviewer-outputs/**
limits:
  wallClockSeconds: 600
  maxCostUsd: 1.00
Pour chaque passe, conservez le fournisseur, la version du modèle ou de l’outil, les hashes du prompt et des règles, le contexte accessible, les outils activés, les heures de début et de fin, le coût s’il est disponible, l’état final et la sortie brute. Normalisez les constats en champs stables comme l’emplacement, la gravité, l’affirmation, la preuve et la correction proposée. Préservez la sortie originale à côté de l’enregistrement normalisé.
Arbitrez ensuite les constats dans un ordre mélangé. Masquez l’identité du reviewer lorsque le texte ne la révèle pas. L’arbitre doit inspecter le code et les critères figés, pas décider à partir de la fluidité du commentaire.
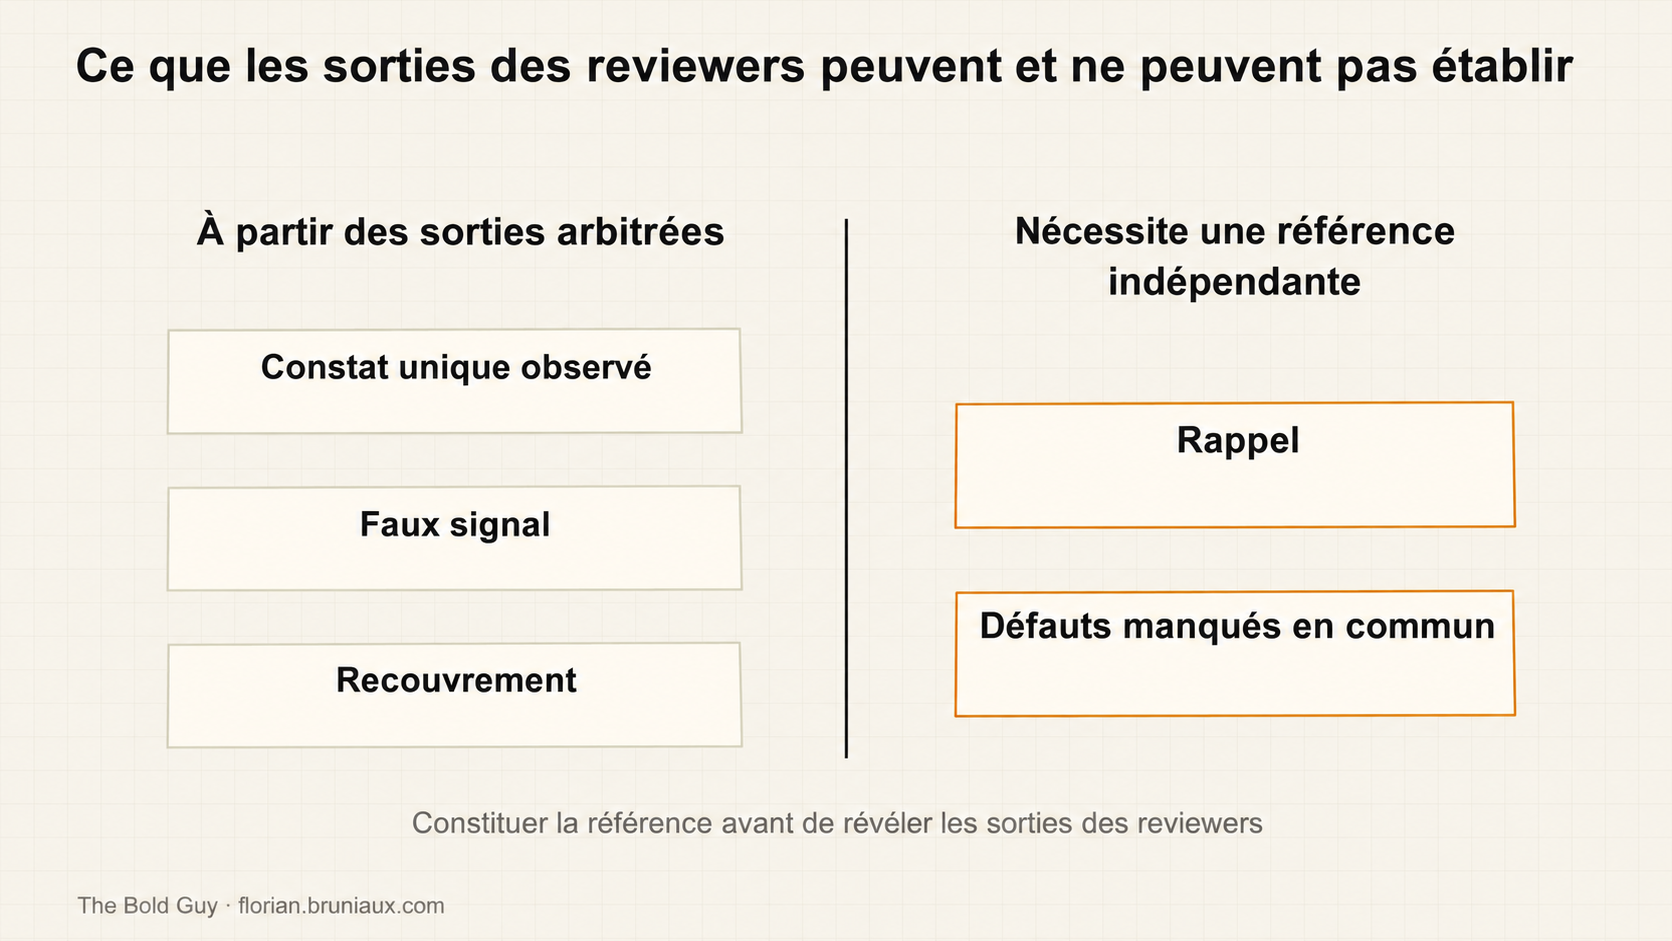
Rapportez 3 observations bornées :
- Constat observé unique : 1 traitement a rapporté un défaut arbitré absent des sorties de référence sélectionnées ; cette observation dérive des sorties, ce n’est pas un rappel par rapport à tous les défauts
- Faux signal : un traitement a affirmé un défaut que les preuves figées n’étayaient pas
- Recoupement : 2 traitements ou plus ont décrit le même problème sous-jacent, même avec une formulation ou une gravité différente
Ne rapportez pas de défauts manqués par tous les reviewers à partir de cette seule procédure. Cette affirmation exige un jeu de référence indépendant constitué avant de révéler les sorties des reviewers. La partie 7 montre ce que 3 mois de sorties de reviewers sur 1 repository permettent ou non d’établir sans ce jeu.
Live AIDD : le coût des reviews répétées
À 22:00 dans le live AIDD du 16 octobre 2026, je décris une séquence qui commence par l’agent natif, puis passe à FriendlyReviewer et à CodeRabbit, et rapporte un coût approximatif d’équipe de 500 à 600 € par mois pour CodeRabbit. C’est une facture déclarée pour notre usage, pas un tarif public actuel ni un budget transférable par développeur. Mon accès gratuit à FriendlyReviewer, déclaré plus haut, affecte aussi cette progression.
À 24:00, je décris des essais de priorisation fondés sur l’accord et ma confiance personnelle dans les reviewers. À 26:00, je distingue un diagnostic correct d’une mauvaise correction proposée. Ni la préférence ni l’accord n’établissent la précision comparative. Conservez le constat, la décision choisie et sa raison avant de transformer cette expérience en politique de routage. Le live fournit un retour de praticien issu de sous-titres automatiques avec un début incomplet ; il n’ajoute ni jeu de référence ni classement des reviewers à cet article.
Plus de reviewers peuvent augmenter le mauvais coût
Natural-Language Agent Harnesses, RQ2 tableau 3, fournit un contre-exemple. Sur son sous-ensemble de 125 tâches SWE-bench Verified, ajouter un vérificateur a fait passer le score de 75,2 % à 74,4 %, tout en résolvant certains cas manqués par la référence. C’est une différence nette de 1 tâche résolue avec le runtime et le budget testés. Dans la tâche sympy__sympy-23950, le vérificateur a rapporté une réussite alors que l’évaluateur officiel échouait toujours. Cette petite comparaison incite à tester la contribution du vérificateur sur la charge de travail visée ; elle n’établit pas une pénalité générale de la review indépendante.
L’expérience de Naresh Jain sur le coût des harnais conserve la même étape indépendante d’acceptation, que l’agent reçoive ou non des retours pendant le développement. Cette séparation est utile ici : le traitement de review peut changer tandis que la référence qui décide si le travail produit est acceptable reste fixe. L’expérience compare des configurations de génération de services, pas des produits de code review.
Une flotte sans rôles assignés produit souvent des commentaires en double, des gravités incohérentes et plusieurs résumés qu’un humain doit mettre en cohérence. Un autre reviewer peut améliorer la couverture tout en rendant le système plus long à comprendre.
Donnez un but à chaque traitement. Par exemple, les contrôles déterministes prennent en charge la syntaxe, les types et les invariants exécutables, et un reviewer contextuel recherche les exigences non satisfaites et les défaillances qui touchent plusieurs fichiers. Un reviewer sécurité se concentre sur les frontières de confiance. Un humain assume les compromis produit ambigus et la décision finale. L’agrégateur préserve les désaccords plutôt que de fabriquer un verdict majoritaire.
Fixez un budget avant l’exécution et arrêtez quand les traitements assignés terminent, échouent, expirent ou épuisent leur budget. Un reviewer manquant est un trou dans les preuves, pas un vote implicite indiquant que la modification est sans problème. Un reviewer qui renvoie 0 constat prouve seulement qu’il a renvoyé 0 constat sur cette entrée.
La partie 3, Concevoir une boucle de review bornée, transforme cette comparaison en workflow observable avec états d’exécution, limites de nouvelles tentatives, preuves de passation et escalade.
YSNK
(Vous devriez maintenant savoir)
- L’auto-review et la review indépendante sont des traitements expérimentaux différents
- L’indépendance dépend du contexte, des outils, du modèle, des règles, du budget et de l’autorité
- Friendly Reviewer fournit un cas de conception déclaré, pas une preuve comparative
- Le discours d’indépendance de Greptile reste une affirmation du fournisseur tant que les exécutions réelles ne sont pas inspectées
- Les classements de reviewers exigent des entrées figées, un arbitrage en aveugle et un jeu de référence indépendant
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.