UVAL : le protocole que j’ai construit pour cesser d’accepter du code que je ne comprends pas
Jeremy Twei l’a nommé. Addy Osmani l’a popularisé. Margaret-Anne Storey l’a étendu aux équipes. Voici ce que j’ai construit pour combattre ces trois dimensions.
Aller au résumé ↓ Florian Bruniaux
TL;DR
Je ne livre pas de code que je ne peux expliquer sur les chemins sensibles, et je confie le reste à une review déléguée selon une politique de risque. UVAL couvre seulement la couche individuelle. Pour les équipes, c’est un point de départ : la couche suivante est faite de journaux de décisions partagés, dossiers d’architecture et PR centrées sur le pourquoi, car la discipline d’une personne ne reconstruit pas le modèle partagé d’une équipe.
| Sujet | Détails |
|---|---|
| Le problème | Dette de compréhension : code livré, qui fonctionne, mais impossible à expliquer trois semaines après |
| Le protocole | UVAL (Understand, Verify, Apply, Learn) place la compréhension avant la livraison, pas après |
| Ce qu’il couvre | Compréhension individuelle en quatre étapes concrètes, avec limites assumées sur la dette cognitive collective |
| Ce qu’il ne résout pas | La perte du modèle partagé de l’équipe (dette cognitive) nécessite d’autres couches : journaux de décisions, dossiers d’architecture, reviews de PR centrées sur le pourquoi |
| Pour qui | Toute personne écrivant du code de production avec l’IA et souhaitant rester auteur, pas seulement approbateur |
Le moment dont je me souviens le mieux n’est pas spectaculaire. Mardi, 23 heures. Un bug de sessions de la plateforme que je construis chez Méthode Aristote bloquait une démo le lendemain matin. J’ai demandé à Claude Code de le corriger. Il a généré 40 lignes dans trois fichiers, restructurant le renouvellement des tokens. Lecture rapide, tests réussis, livraison.
Trois semaines plus tard, un collègue m’a demandé pourquoi les tokens étaient renouvelés à chaque requête plutôt qu’à expiration. J’ai rouvert le fichier, l’ai relu, sans pouvoir expliquer le raisonnement, les arbitrages ni l’alternative que j’avais apparemment rejetée. Je pouvais montrer le code et dire « that’s what it does » (traduction : « voilà ce qu’il fait »), sans expliquer le choix.
Le code fonctionnait. Je ne pouvais pas expliquer pourquoi il était structuré ainsi.
Le problème a maintenant un nom
Pendant un temps, j’y voyais un manque de discipline personnel. Puis deux chercheurs lui ont donné des noms.
Jeremy Twei a forgé comprehension debt, la dette de compréhension : code fonctionnel, livré, dans votre codebase, mais incompris. Addy Osmani (équipe Google Chrome) a repris le terme en janvier 2026 pour en faire un cadre du développement assisté par IA. La distinction est précise : dans le cas de la dette technique, vous savez que le code est sous-optimal et vous avez un plan. La dette de compréhension est invisible. On la découvre quand quelqu’un vous demande d’expliquer votre système et que vous ne le pouvez pas.
Margaret-Anne Storey (titulaire d’une chaire de recherche du Canada, université de Victoria) l’a étendue aux équipes avec cognitive debt, la dette cognitive : perte des modèles mentaux partagés à l’échelle d’une codebase et des personnes qui la maintiennent. Sa formulation est précise : « Cognitive debt tends not to announce itself through failing builds or subtle bugs after deployment, but rather shows up through a silent loss of shared theory. » Traduction fidèle : « La dette cognitive tend à ne pas s’annoncer par des builds échoués ou des bugs subtils après déploiement, mais par une perte silencieuse de la théorie partagée. »
Les deux décrivent le même échec à des échelles différentes. Osmani couvre l’individu quand l’IA génère plus vite qu’il n’assimile. Storey couvre l’équipe. Le signe est difficile à détecter : rien ne casse visiblement. Builds et tests passent, personne ne signale la dérive jusqu’à une question sans réponse, souvent en review où chacun est trop embarrassé pour admettre avoir perdu le fil.
J’ai reconnu ce qui m’était arrivé ce mardi soir. Lorsque j’ai vu nettement le schéma dans plusieurs sessions, j’avais déjà commencé à construire quelque chose pour y répondre.
UVAL : Understand, Verify, Apply, Learn
J’ai formalisé UVAL dans la section learning-with-ai du Claude Code Ultimate Guide. L’acronyme suit une logique simple : comprendre avant d’utiliser et livrer.

Understand First : comprendre d’abord
Pendant des mois, face à un problème, j’ouvrais d’abord un chat pour le décrire. Résultats corrects mais opaques. Je collais la solution, elle fonctionnait, puis je passais à la suite. Je n’arrivais pas avec le contexte rendant la réponse utile pour moi, avec ma codebase, mes contraintes et ce que je comprenais déjà.
Maintenant, je fais quatre choses avant de demander. D’abord, écrire le problème en une phrase. Sinon, je ne le comprends pas encore. La différence entre « the auth doesn’t work » (traduction : « l’auth ne marche pas ») et « the login form doesn’t display inline validation errors when the email field is empty on the first submission » (traduction : « le formulaire de connexion n’affiche pas les erreurs de validation au niveau des champs quand l’e-mail est vide au premier envoi ») compte. La seconde produit une réponse utile. Ensuite, je nomme trois approches possibles, même grossières ou fausses. Les nommer me fait réaliser quelle part du problème je comprends déjà. Puis j’identifie précisément l’inconnu : pas « I don’t know how to do this » (traduction : « je ne sais pas faire »), mais « I know Zod handles schema validation, I don’t know how to surface field-level errors inline in React without triggering a full re-render » (traduction : « je sais que Zod gère la validation des schémas, mais pas comment afficher les erreurs par champ dans React sans déclencher un nouveau rendu complet »). Puis je demande.
Ces 15 minutes imposent une collaboration sur le problème plutôt qu’une délégation. La première phrase est la plus difficile : elle révèle la compréhension du problème. Quand je n’arrive pas à l’écrire, plus souvent que je ne voudrais l’admettre, j’essaie de résoudre quelque chose encore mal défini.
Verify : réexpliquer
Quand j’ai essayé pour la première fois d’expliquer le code à voix haute (méthode Rubber Duck de Hunt et Thomas dans Pragmatic Programmer), je pensais y arriver facilement. J’avais lu le code généré, il me paraissait logique et je comprenais ce qu’il faisait. Puis j’ai essayé d’expliquer non ce que chaque ligne faisait, mais pourquoi elle était écrite ainsi. Pourquoi ce niveau de middleware plutôt que la route. Pourquoi reduce plutôt que forEach. Pourquoi la logique de retry était ici plutôt que dans le code appelant.
J’ai bloqué à la troisième ligne.
C’est là que le travail commence. Décrire ce que fait le code sans expliquer sa structure révèle les lacunes : les trouver est le but. Une fois ces lacunes repérées, je pose des questions précisément sur les lignes concernées. « Why is the token refresh triggered here rather than in the middleware? » Traduction : « Pourquoi le renouvellement du token se déclenche-t-il ici plutôt que dans le middleware ? » La réponse est concrète. Je la retiens car elle s’ancre dans quelque chose que j’avais presque compris, sans y être tout à fait arrivé. Lecture passive et vérification active sont différentes. Trouver le code logique en le lisant ne signifie pas le comprendre.
Si je ne peux l’expliquer à un collègue, je ne l’ai pas compris. Test simple, qui détecte encore des choses que je pensais comprises.
Apply : prédire, tester, adapter
Appliquez la solution à l’exigence réelle. Si le code généré convient déjà, gardez-le intact. Renommer une variable ou changer le style d’itération ne démontre pas à lui seul la compréhension et peut créer une review inutile.
Ce sont des contrôles d’apprentissage proposés. Cet article ne présente aucun résultat longitudinal montrant qu’une petite modification permet de retenir ce qu’on a appris six semaines plus tard. Consignez ce que vous pouvez expliquer sans aide, ce qui a nécessité de l’aide et ce qui se transfère à une nouvelle tâche.
Learn : consigner l’enseignement
J’ai commencé quatre journaux d’apprentissage dans ma carrière. Aucun n’a dépassé la deuxième semaine. Le quotidien va vite, ce qu’on jugeait utile de consigner semble évident dès le samedi, et le lundi le contexte et la motivation pour l’écrire ont disparu. Je ne pense pas que ce soit la discipline. Je pense que c’est la friction.
J’utilise plutôt un hook Claude Code sur l’événement Stop. Après chaque session, Claude demande « What’s one thing you learned today? » (traduction : « Quelle chose as-tu apprise aujourd’hui ? »). La réponse va automatiquement dans un log. Dix secondes, sans friction, avant de fermer le terminal. L’événement Stop fait partie du catalogue de hooks présenté dans Claude Code sous le capot si vous voulez savoir comment le configurer. Les enseignements sont bruts, parfois inutiles, mais il y en a parfois un que j’aurais complètement oublié dès le lendemain, et il est là, dans le log.
L’autre mécanisme est CLAUDE.md comme journal de décisions. Pas « we use Zod for validation » (traduction : « nous utilisons Zod pour la validation »), mais « we use Zod because manual validation missed a nested object edge case in production, and we needed the schema as the single source of truth for field rules » (traduction : « nous utilisons Zod parce que la validation manuelle a manqué un cas limite d’objet imbriqué en production et qu’il fallait le schéma comme référence unique des règles des champs »). Sans journal, vous savez ce que fait le code, pas pourquoi sa structure a été choisie. Le code se lit. Le raisonnement derrière ce code ne peut être retrouvé que si quelqu’un l’a consigné sur le moment. Trois mois plus tard, cette personne, c’est souvent vous, et vous ne vous en souvenez plus.
Ce que couvre UVAL, et ses limites
UVAL est la couche individuelle. Il traite votre capacité à expliquer votre code trois semaines après et à onboarder quelqu’un sur une logique construite des mois avant. Les quatre étapes sont des points de contrôle qui vous obligent à vous impliquer précisément aux moments où il est le plus facile de s’en dispenser.
Pour la dette cognitive de Storey, UVAL est un début, pas une solution. Même une équipe où chacun l’utilise a encore besoin de journaux de décisions partagés, de dossiers d’architecture et de PR avec des sections « why » (traduction : « pourquoi »). C’est la couche collective. Aucune ne remplace l’autre.
Sur les chemins sensibles, je dois expliquer pourquoi le code est structuré ainsi avant de livrer. Si je ne le peux pas, je ne livre pas. Lire ce que fait le code est facile. Expliquer pourquoi est le vrai travail.
Adapter l’exercice d’apprentissage à la politique de review
L’explication ligne par ligne est mon exercice pour exposer les lacunes. La règle précédente concerne les chemins sensibles. Elle n’exige pas qu’une personne relise en profondeur chaque ligne générée dans chaque changement. Le reste peut aller en review déléguée : une équipe peut déléguer la review courante selon une politique de risque établie tout en conservant la responsabilité du comportement, de l’architecture et de la reprise. Chemins sensibles, exigences incertaines et changements qui interagissent demandent toujours un examen proportionné aux conséquences.
UVAL pose la question de savoir si je peux expliquer et maintenir les décisions que j’accepte. La répartition du jugement du guide traite le partage entre humains et agents. Un test réussi ou l’approbation d’un agent ne répondent pas, à eux seuls, à la question de la compréhension.
Dans le complément de mon épisode IFTTD, Bruno Soulez conteste les limites de ma réduction de review ligne par ligne. Je distingue compréhension des chemins sensibles et délégation de l’inspection courante.
Live AIDD : contrôles de compréhension pour juniors
À 1:33:00 du live AIDD du 16 octobre 2026, je décris des essais avec des hooks qui bloquent certaines actions jusqu’à ce qu’un junior réponde à une question de compréhension, ou avec des diagrammes qui lui demandent d’identifier un composant. Cela ajoute volontairement du temps d’apprentissage au workflow. C’est une extension explorée d’UVAL, pas une preuve que chaque étape est imposée ni que l’apprenant retient les connaissances.
Un participant rapporte une pratique liée à 1:35:00 : sur certaines PR juniors, un questionnaire échoué bloque la soumission, et l’essai suivant change formulation ou ordre sans changer le sujet. Ce récit appartient à son équipe. Ni ce témoignage ni mon expérimentation n’apportent de résultat pédagogique mesuré. Une réponse correcte nécessite encore un test de transfert ultérieur sur une tâche nouvelle.
L’échange à 1:25:00 place une part de responsabilité dans le management : protéger le temps nécessaire pour comprendre ce qui a été livré plutôt que consacrer immédiatement tout le temps gagné à la tâche suivante. La discussion du travail constant et du sommeil à 57:00 décrit des expériences personnelles, dont mon intensité, pas une norme de travail pour les juniors. Le live est distinct de la conférence Dev With AI du 12 octobre. Les sous-titres automatiques et l’ouverture incomplète ne permettent pas d’affirmations plus fortes sur l’apprentissage ou les effets sur la santé.
Là où UVAL s’arrête
UVAL vous ralentit volontairement.
Pour un prototype jetable ou l’exploration d’une solution sans intention de livrer, le protocole ne s’applique pas. Exploration, expériences jetables, première heure d’une fonctionnalité encore indéfinie : le vibe coding a sa place. Sautez les étapes.
Le protocole vise le code de production. Celui que d’autres maintiendront ou que vous déboguerez dans six mois sans souvenir des décisions. Pour ce code, le temps consacré à Understand et Verify est un investissement dans le diagnostic et l’explication ultérieurs. Cet article ne mesure pas le temps de débogage économisé.
Il ne résout pas totalement le problème collectif. Une équipe de cinq personnes qui utilisent UVAL individuellement a encore besoin de processus partagés explicites : journaux de décisions, dossiers d’architecture et reviews centrées sur le pourquoi plutôt que seulement « does it work » (traduction : « est-ce que cela fonctionne »). UVAL couvre une couche.
Cela demande de la discipline. Les étapes ne sont pas imposées par défaut ; les hooks expérimentaux couvrent certaines actions. L’habitude casse avec fatigue, pression ou précipitation. Le but est de relever le socle et de réduire ces mardis soirs de livraison sans compréhension.
Verify est l’exception, le moment où l’habitude peut devenir garde-fou imposé par les outils. Le développement piloté par les tests avec Claude transforme « explain it before you accept it » (traduction : « expliquez avant d’accepter ») en test rouge que l’implémentation doit satisfaire. Ne jamais laisser le modèle affaiblir un test pour passer au vert protège précisément l’engagement visé par UVAL.
Tester ce que l’apprenant sait faire après l’explication
Dans l’épisode 362 d’IFTTD, Yacine Hmito distingue le fait de formaliser les critères de qualité dans un skill du fait d’apprendre à une autre personne à juger la sortie. Une instruction partagée peut améliorer le contexte de l’agent sans établir la compréhension de l’opérateur.
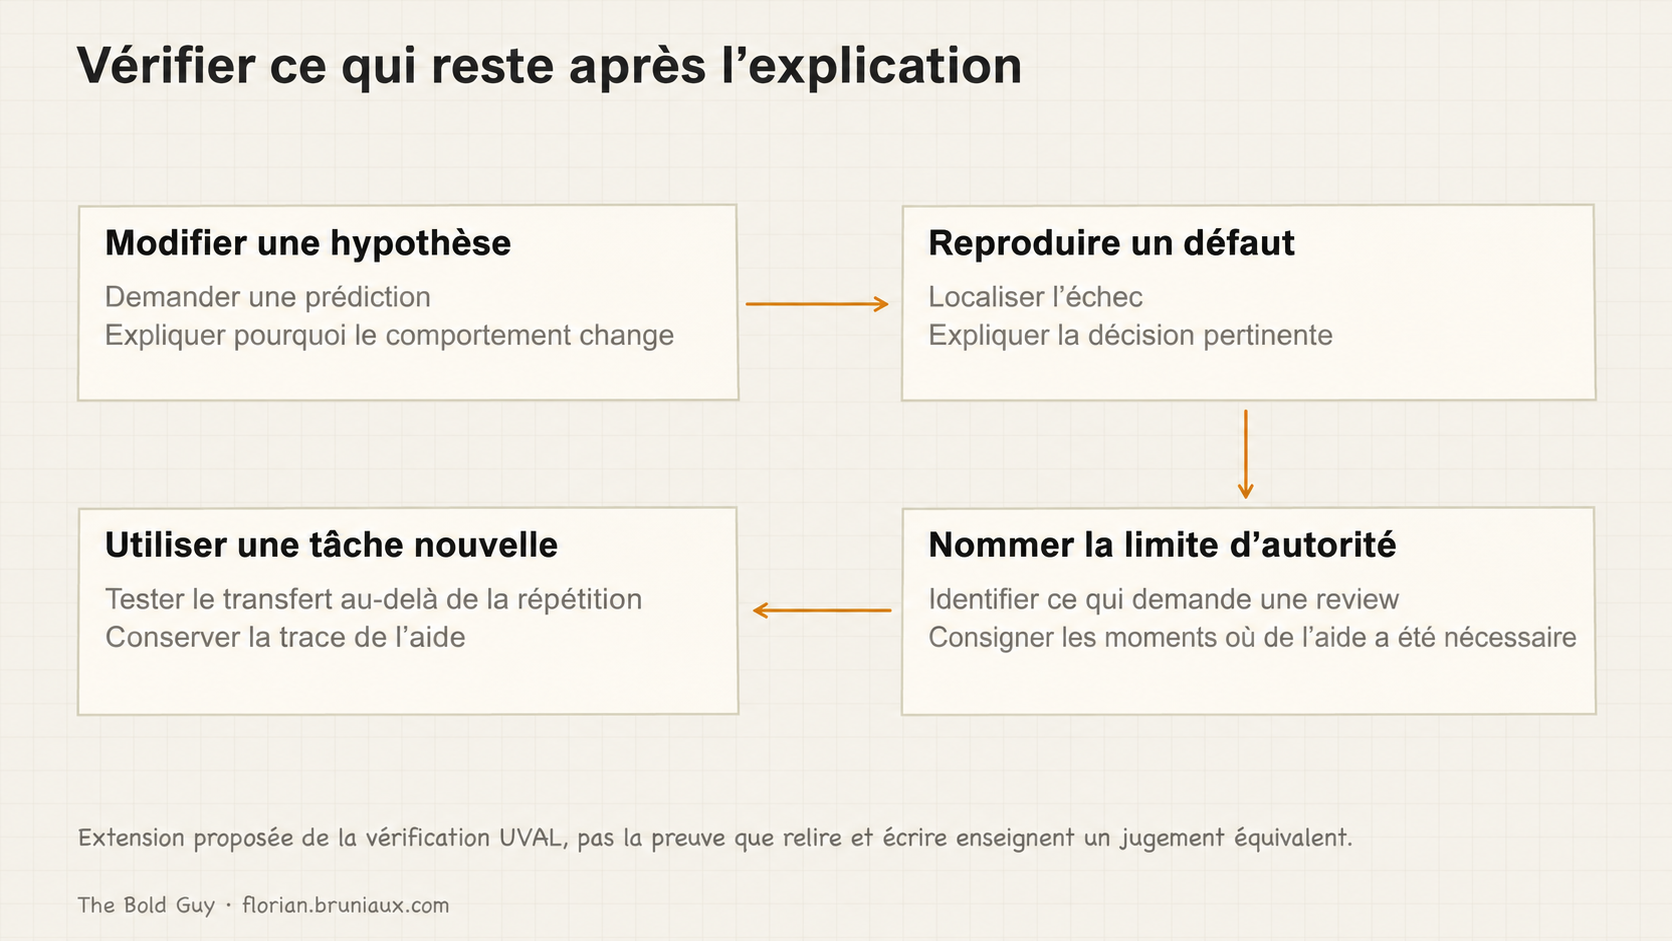
Après une explication, changez une hypothèse et demandez à l’apprenant de prédire l’effet, de reproduire un défaut et d’identifier quand la tâche dépasse son autorité. Consignez les étapes qui ont nécessité de l’aide. Utilisez une nouvelle tâche pour l’évaluation suivante : répéter une solution connue ne montre pas le transfert. Cela prolonge l’étape Verify sans établir que l’apprentissage par la review développe le même jugement que l’apprentissage par l’écriture.
Confronter l’explication au comportement
Necessary or Sufficient? teste les explications de modèles par interventions sur les entrées de deux tâches synthétiques de décision. Les résultats motivent la vérification des explications par rapport au comportement, mais ne valident pas UVAL et ne mesurent pas l’apprentissage humain. Pour le code, prédisez un cas limite avant exécution, puis comparez comportement observé et explication.
Rendre la supervision possible avant de demander l’approbation
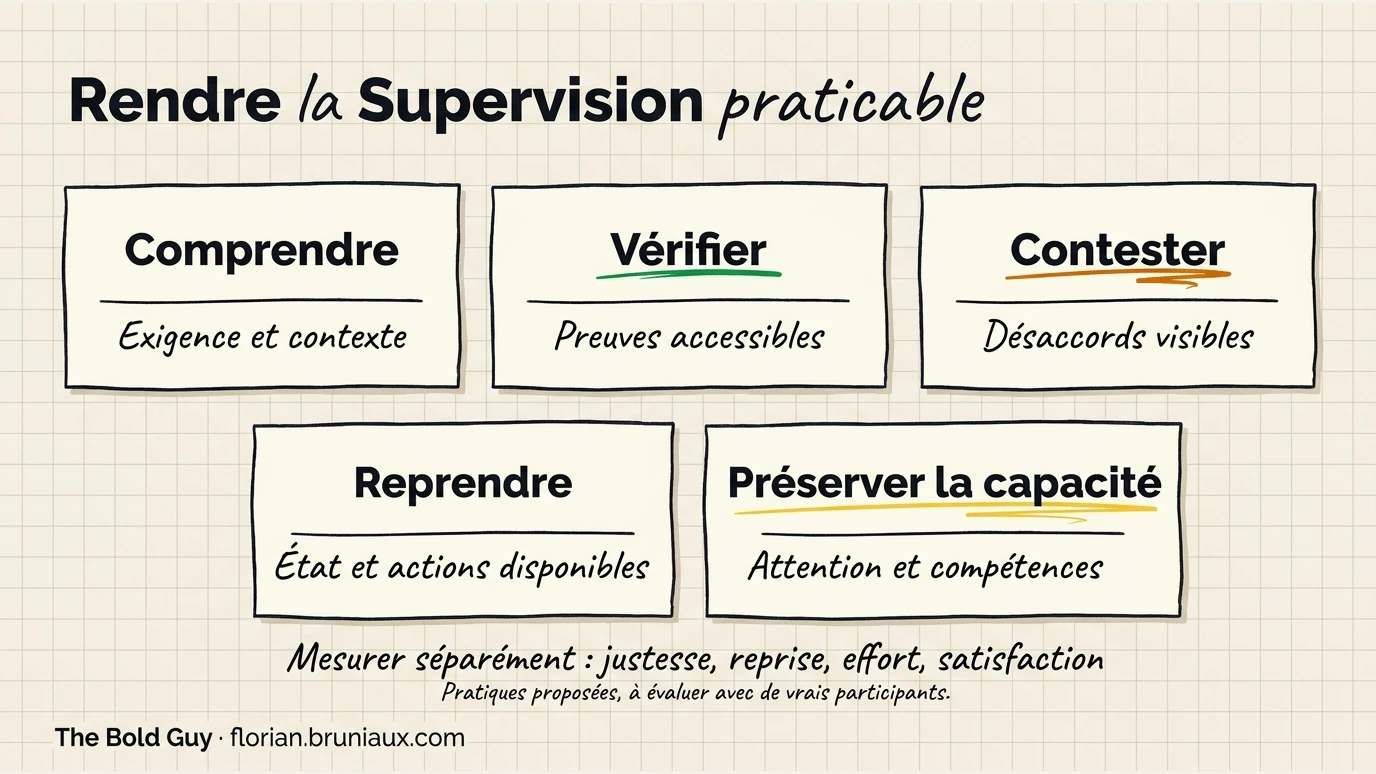
Mitchell, Ghosh et Passi soutiennent que les interfaces d’agents et l’organisation du travail peuvent affaiblir la supervision humaine dont elles dépendent. Il s’agit d’une prise de position fondée sur des recherches antérieures, pas d’un essai validant UVAL.
Pour un exercice choisi, montrez à l’apprenant l’exigence et les preuves avant la recommandation de l’agent. Conservez son premier jugement, puis notez si la recommandation le modifie et pourquoi. Donnez un vrai moyen de contester les preuves et de reprendre le travail. Mesurez séparément la justesse des décisions, la capacité à reprendre le travail, l’effort et la satisfaction. Un clic d’approbation n’est pas un test de compréhension, et cet exercice n’exige pas une seconde review humaine de toute PR courante.
Par où poursuivre
Pour essayer sans adopter tout le protocole, commencez par V. La prochaine fois que l’IA génère du code, avant de le coller, réexpliquez-vous le code ligne par ligne. Pas ce que chaque ligne fait, mais pourquoi elle est là. Repérez les endroits où vous bloquez et posez des questions à leur sujet. Ce seul changement ajoute cinq minutes et produit quelque chose d’utile : soit vous avez compris, soit vous avez trouvé la lacune qui vous échappait.
L’implémentation UVAL complète, configuration du hook Stop, modèle de journal de décisions CLAUDE.md et protocole, figure dans la section learning-with-ai du guide. La source brute est aussi sur GitHub pour approfondir.
Les gens sautent d’abord l’étape Understand quand je leur présente le protocole. Je m’impatiente à l’étape Verify. Je suis curieux de savoir quelle étape échoue en premier pour vous.
Rester responsable du code après livraison
La dette de compréhension reste invisible jusqu’à ce qu’elle vous coûte quelque chose : une sprint review qui déraille, une question d’un collègue à laquelle vous ne pouvez pas répondre, ou un débogage qui part de travers parce que vous n’avez laissé aucune trace du raisonnement trois mois plus tôt. UVAL nomme cet échec et ajoute quatre étapes aux moments où il est le plus facile de ne pas s’impliquer. Le résultat devrait être du code dont vous restez responsable s’il casse un mardi soir dans six mois.
Références : Jeremy Twei, création du terme « comprehension debt » (traduction : « dette de compréhension »). Addy Osmani, « The 80% Problem in Agentic Coding » (janvier 2026 ; traduction : « Le problème des 80 % dans le code agentique »). Margaret-Anne Storey, « Cognitive Debt » et « Cognitive Debt Revisited » (février 2026 ; traductions : « Dette cognitive » et « Dette cognitive revisitée »).
YSNK
(Ce que vous devriez maintenant savoir)
- Dette de compréhension (individu, Osmani) et dette cognitive (équipe, Storey) décrivent le même échec à deux échelles : rien ne casse visiblement, builds et tests passent, jusqu’à une question sans réponse
- Understand comporte quatre sous-actions avant toute demande : formuler le problème en une phrase, nommer trois approches possibles même approximatives, identifier précisément ce que l’on ne sait pas, puis demander
- Verify demande d’expliquer à un collègue pourquoi le code a cette structure. Bloquer à la troisième ligne signale une lacune
- Apply consiste à prédire un comportement, tester une exigence ou diagnostiquer un défaut. Gardez le code correct inchangé ; évaluez la rétention et le transfert plutôt que de les déduire d’une retouche cosmétique
- Le protocole ne concerne pas les prototypes jetables ni la première heure d’exploration d’une fonctionnalité. Il vise le code de production que quelqu’un, souvent vous dans trois mois, devra expliquer
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source