Je n’ai pas confiance dans mes pull-requests générées · Le cas #4518
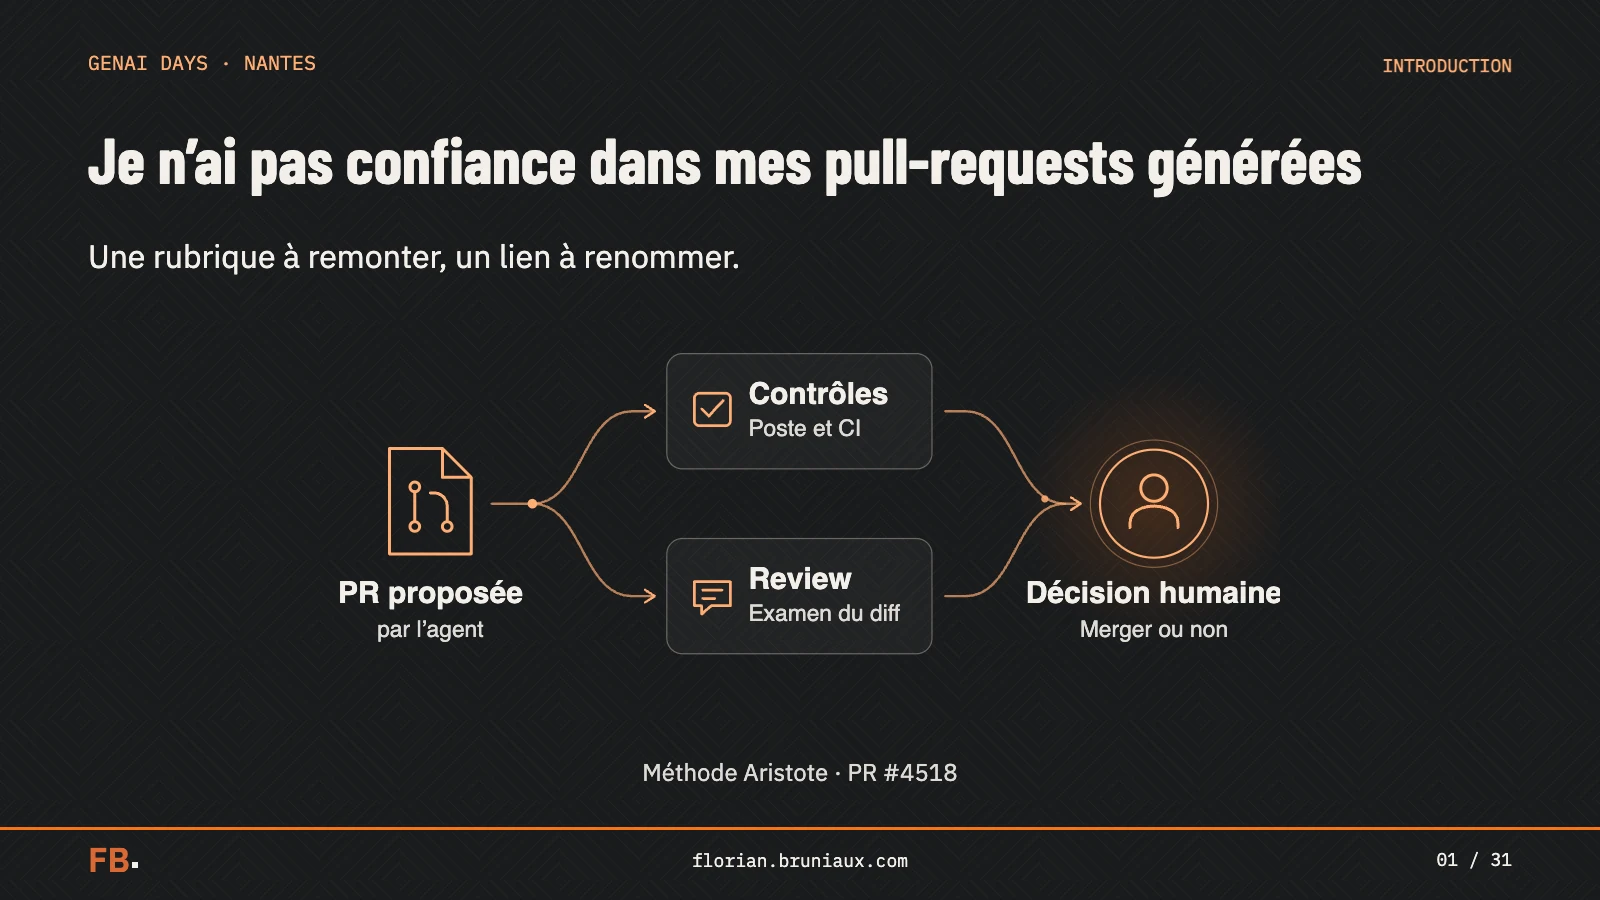
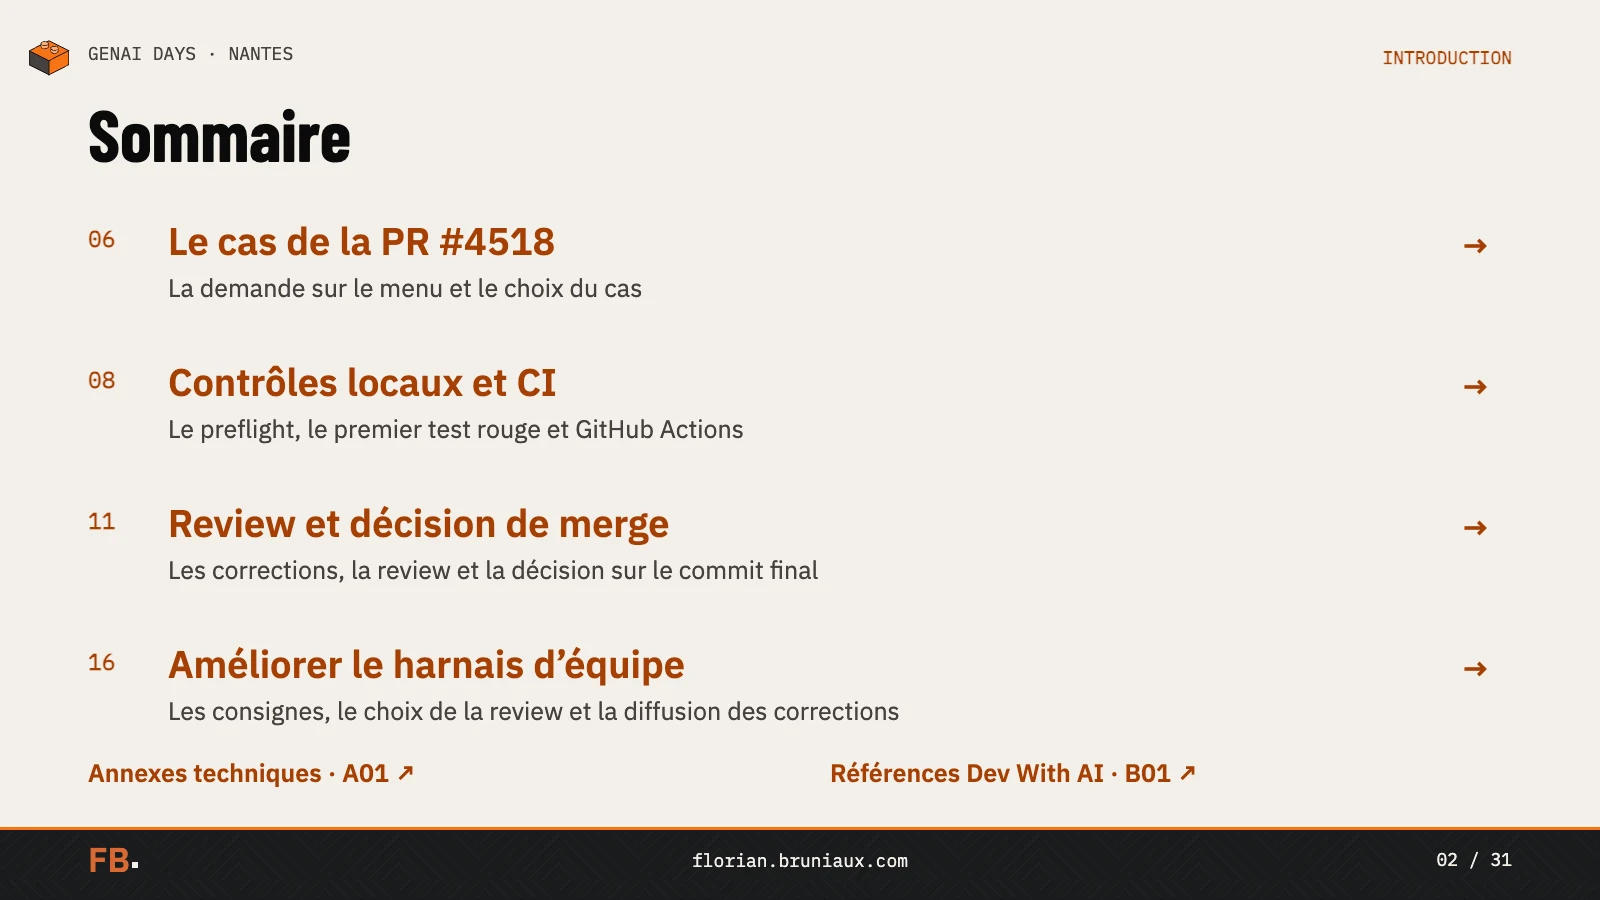
Je reprends la PR #4518 de Méthode Aristote, du preflight au merge, puis je montre comment rejouer un défaut pour vérifier une correction du harnais.
 Florian Bruniaux
Ce que vous en retirez
- ✓ Relier le diff, les checks et les avis de review au bon commit
- ✓ Choisir des tests qui couvrent le parcours modifié
- ✓ Borner les corrections et identifier qui décide du merge
- ✓ Rejouer un défaut et vérifier l’effet d’une modification du harnais
Prérequis
- → Avoir déjà ouvert ou relu une pull request
Chez Méthode Aristote, on avait commencé à produire beaucoup plus de code avec l’IA. Des collègues côté produit envoyaient leurs propres PR et, pendant longtemps, c’était moi qui appuyais sur le bouton de merge. Même sans refaire chaque code review comme avant, je me faisais déborder.
J’ai eu de la chance dans cette boîte. Mes dirigeants m’avaient dit d’y aller à fond, dans le produit comme dans notre façon de développer. Si j’avais besoin de licences supplémentaires, je pouvais les prendre. On avait de quoi produire plus vite, mais derrière, il fallait suivre les tests, les retours des bots et les PR qui attendaient encore une décision humaine.
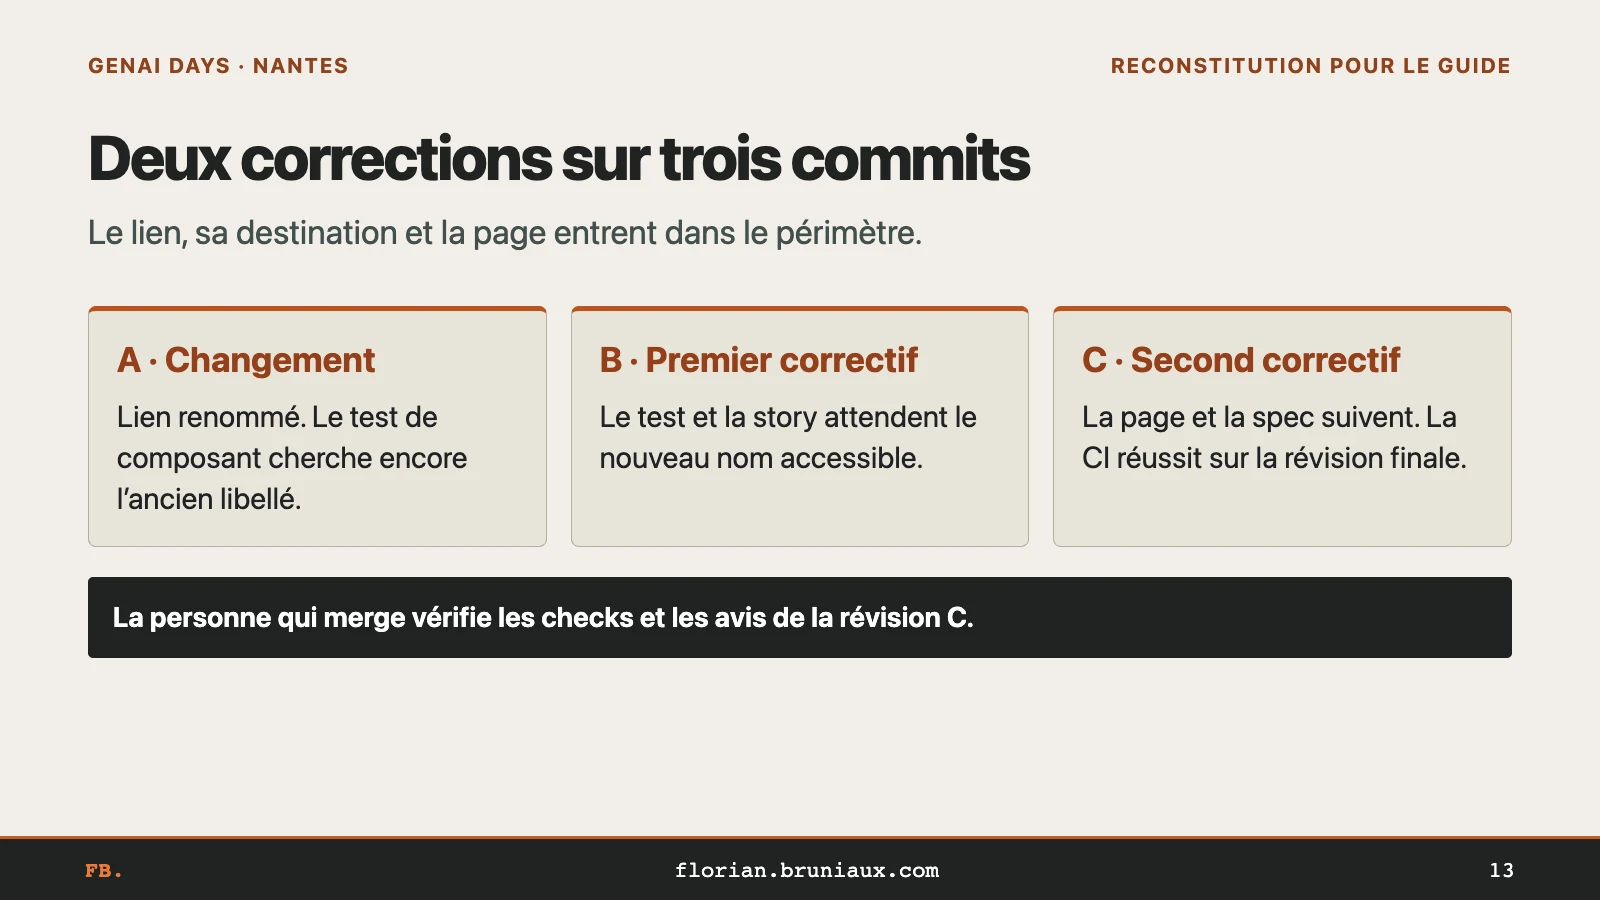
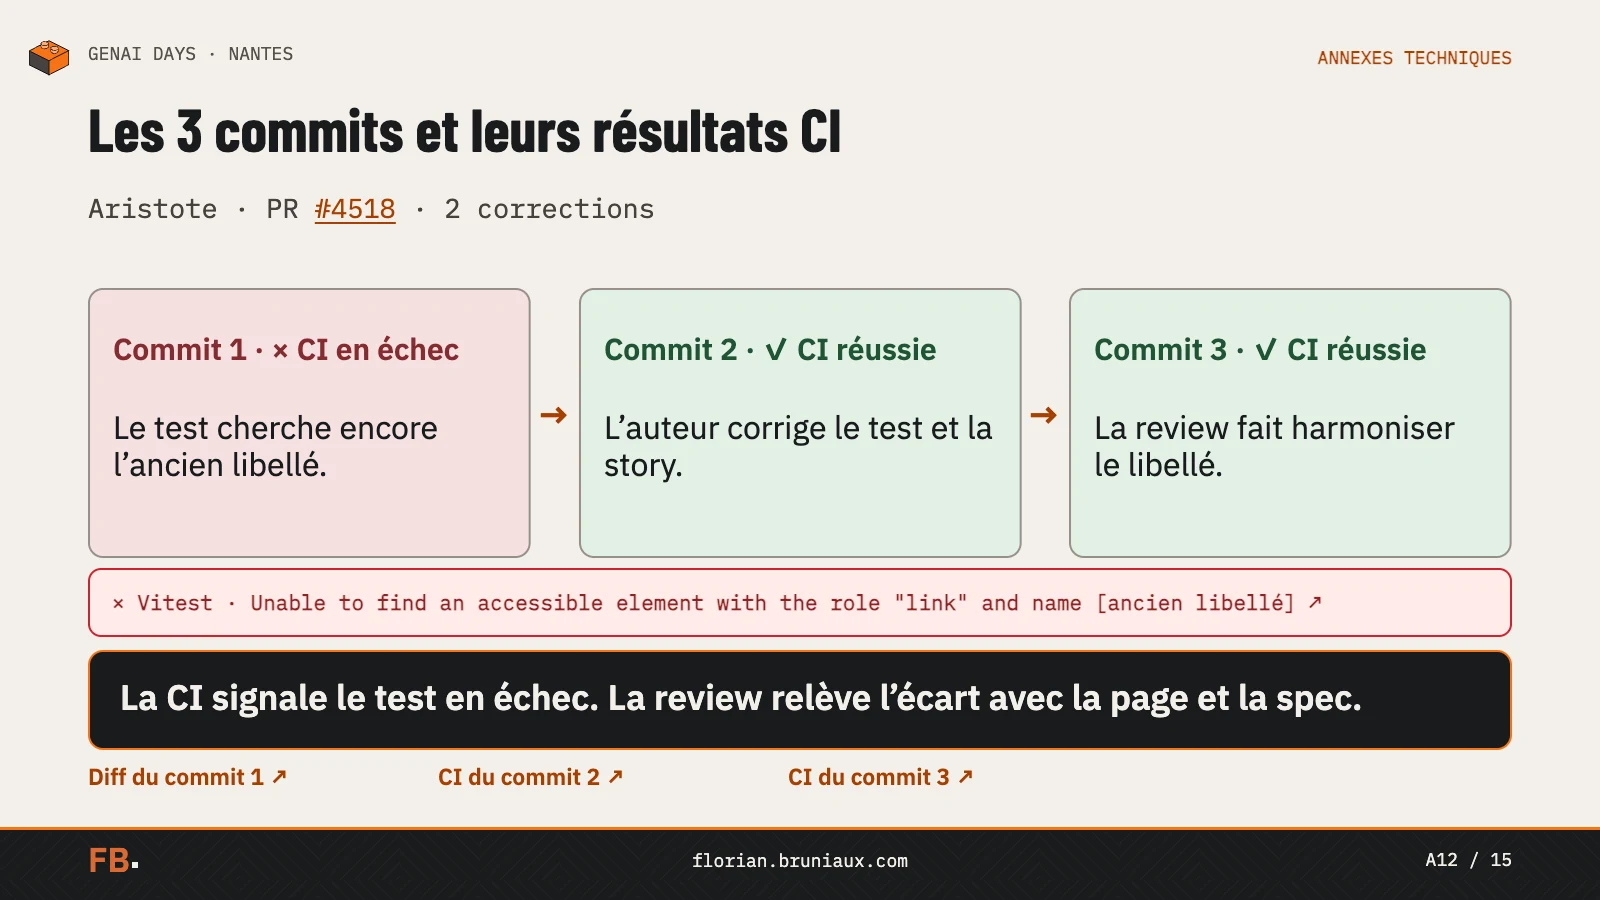
Pour mon talk à GenAI Days Nantes, le 17 novembre 2026, j’ai choisi une PR volontairement triviale. Il fallait remonter une entrée dans le menu admin et renommer un lien. On peut comprendre le changement sans connaître toute l’application. Il a quand même fallu 3 commits et 2 corrections pour la merger.
Autour de cette PR, la #4518, on retrouve les tests locaux, la CI, la review et les règles données aux agents. C’est ce que j’appelle le harness, avec les outils et les permissions qui encadrent leur travail. Dans Du code au merge, je décris comment on organise le travail des agents en équipe. Ici, je reprends ce qui s’est passé sur cette PR et ce que je changerais après l’avoir relue.
Un changement de menu, 3 commits
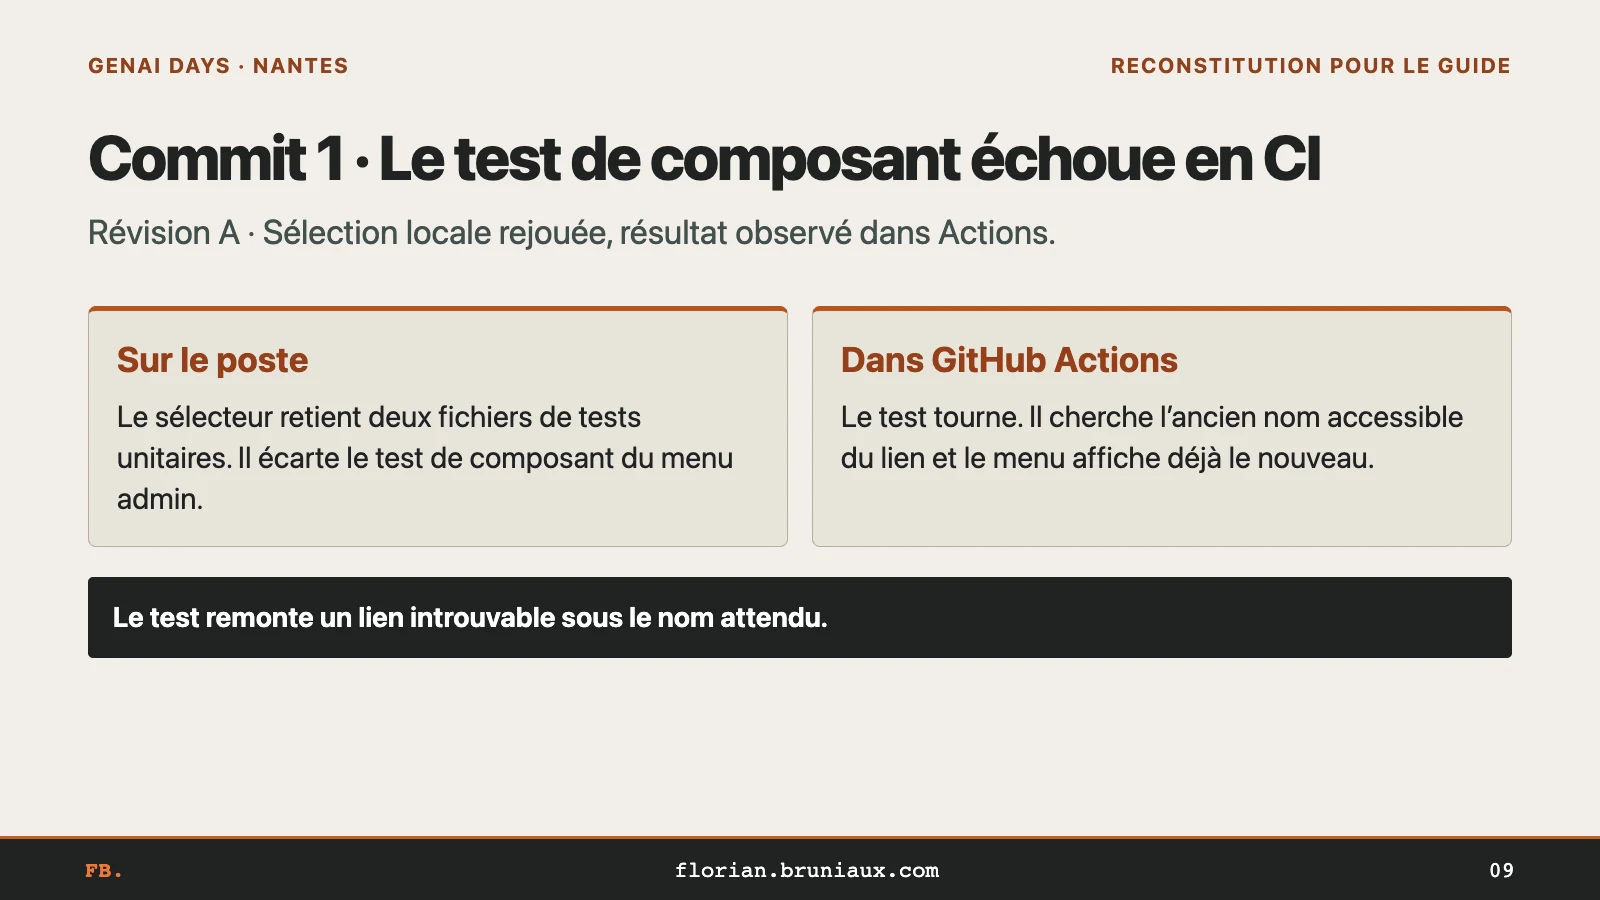
Le premier commit modifie les données du menu, mais un test de composant cherche encore le lien sous son ancien nom. La CI échoue. L’auteur vient du produit, je ne l’avais pas formé au TDD et j’attendais de l’agent qu’il gère les tests. Quand ça casse, je regarde donc aussi ce qui manque dans le harness que je lui ai préparé.
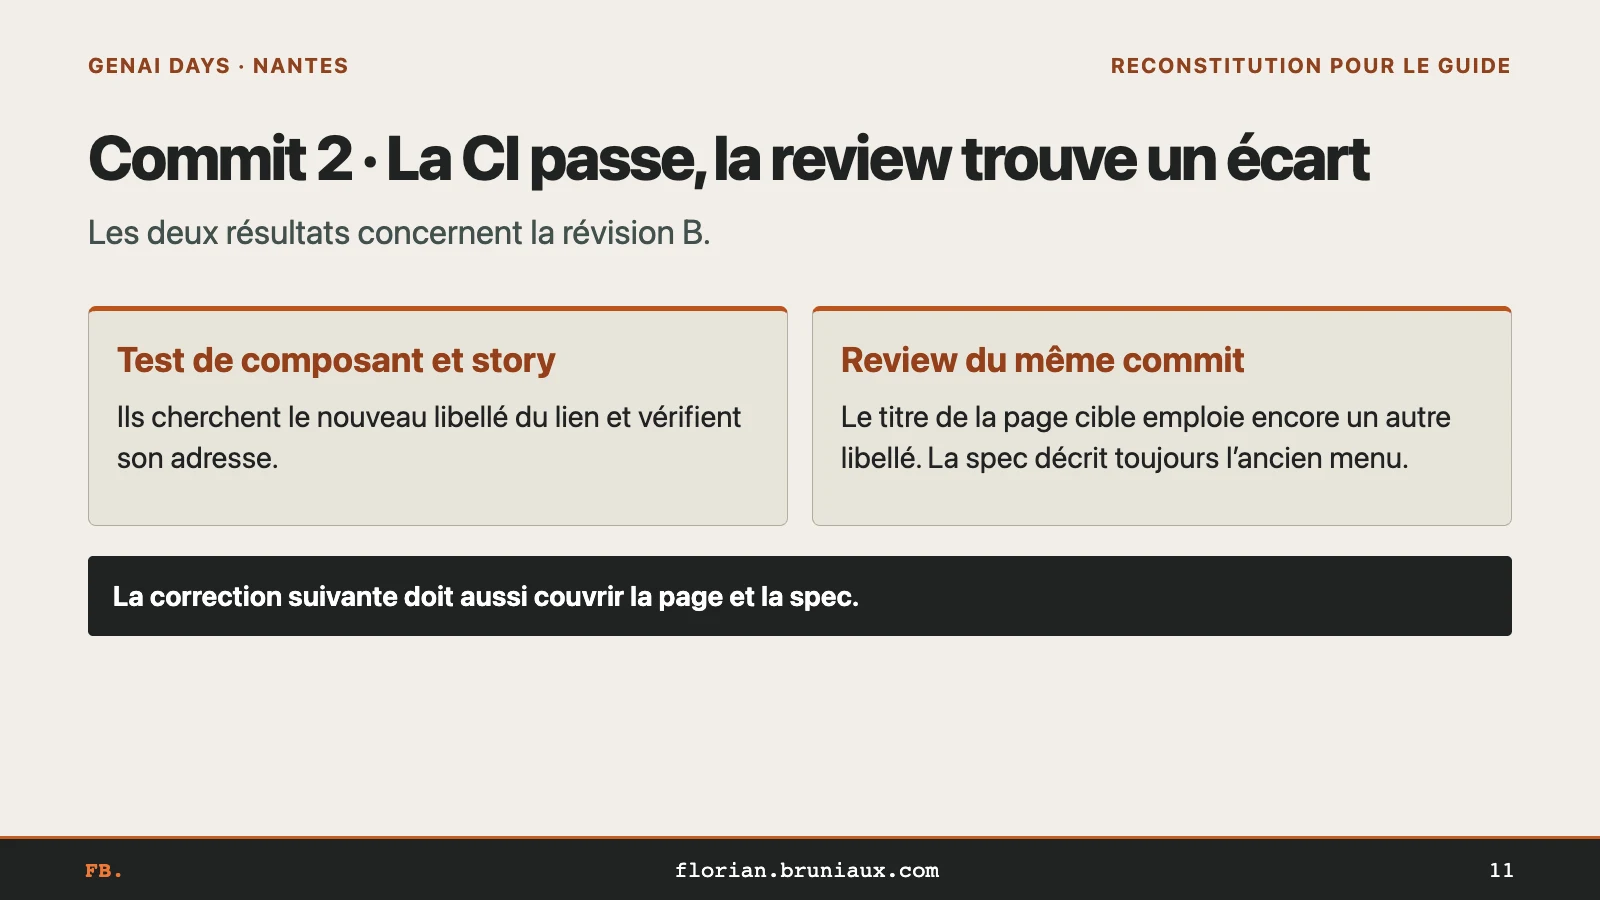
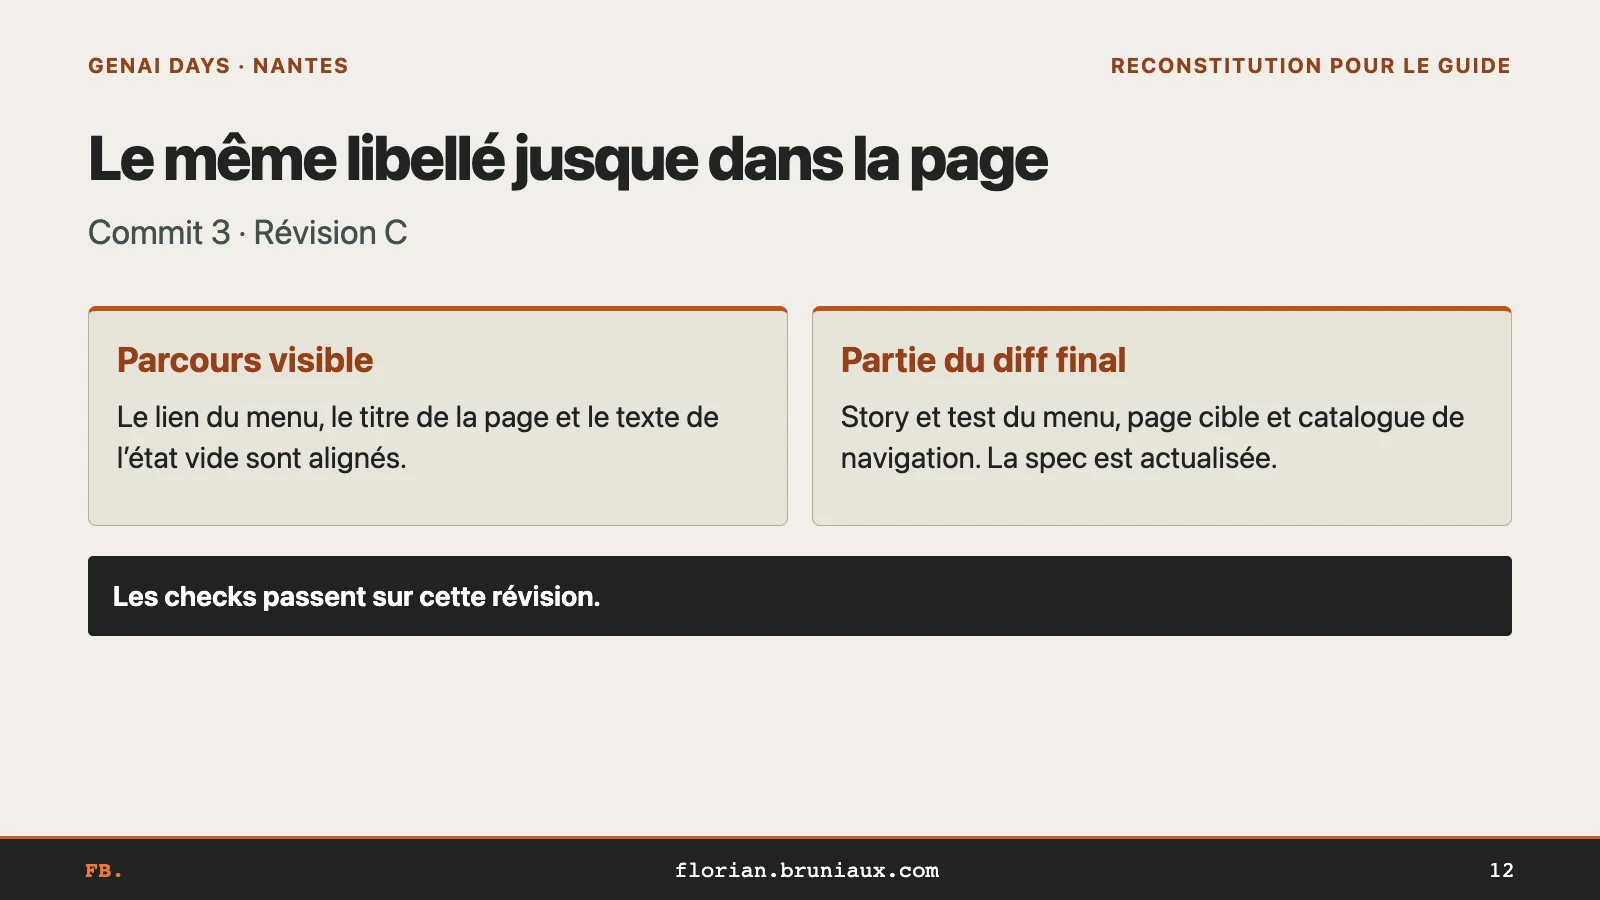
L’auteur corrige le test et la story, puis envoie un deuxième commit. La CI passe, mais la review relève encore 2 écarts : la page d’arrivée affiche un autre libellé et la spec décrit toujours l’ancien menu. Le test vérifie le texte et la destination du lien dans le menu. Il ne va pas jusqu’à vérifier ce que la page affiche à l’arrivée. Le troisième commit aligne le menu, le titre de la page, son état vide et la spec.
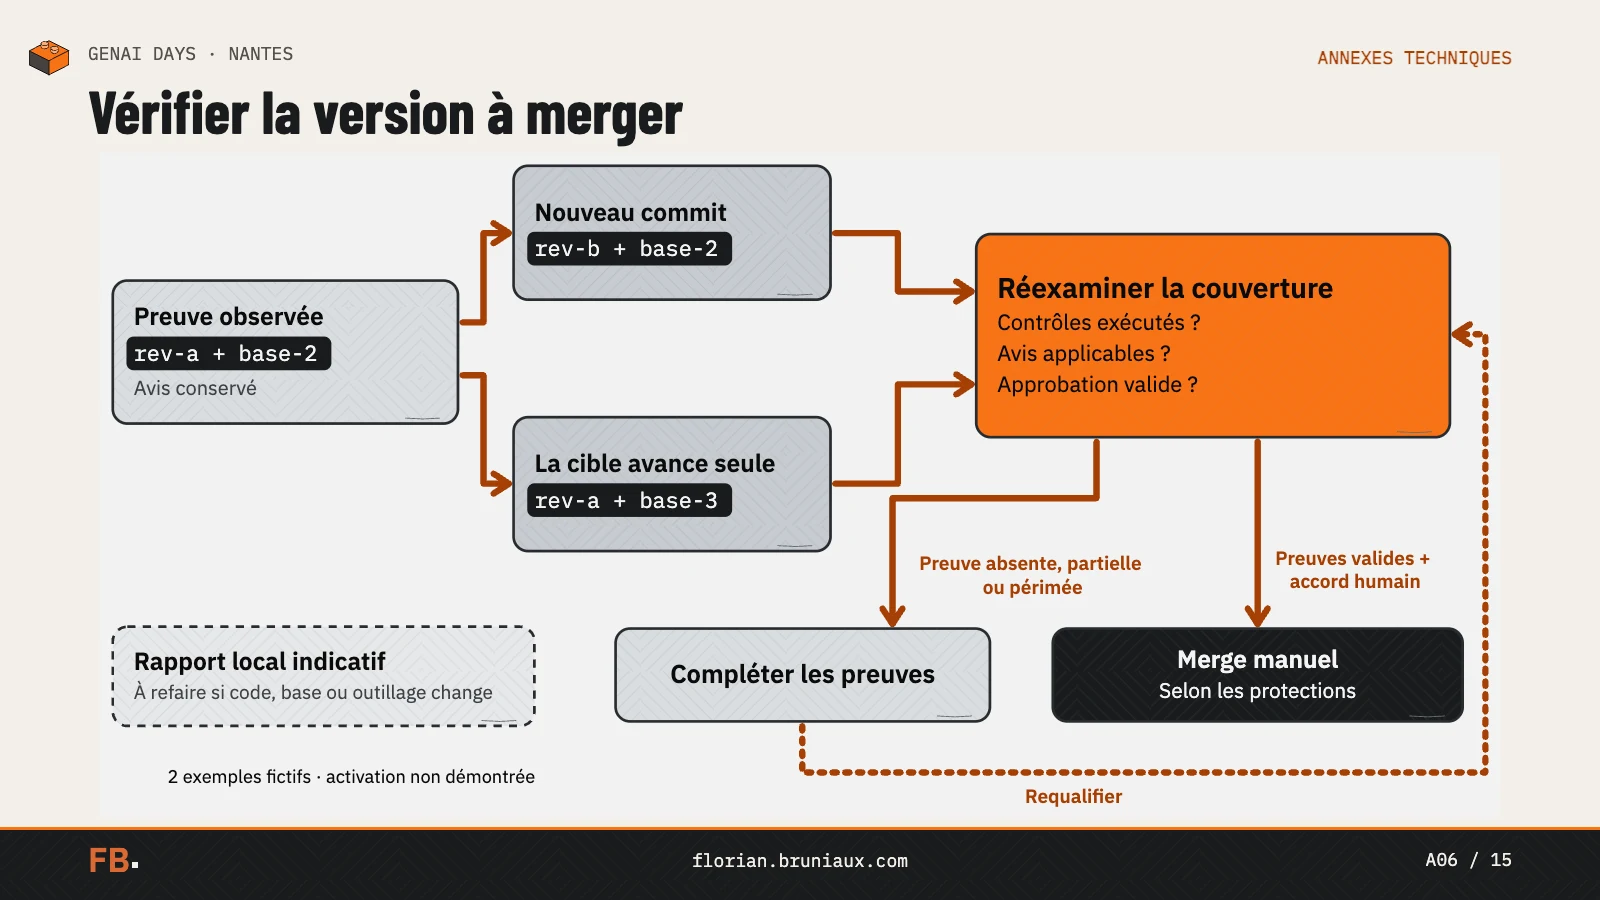
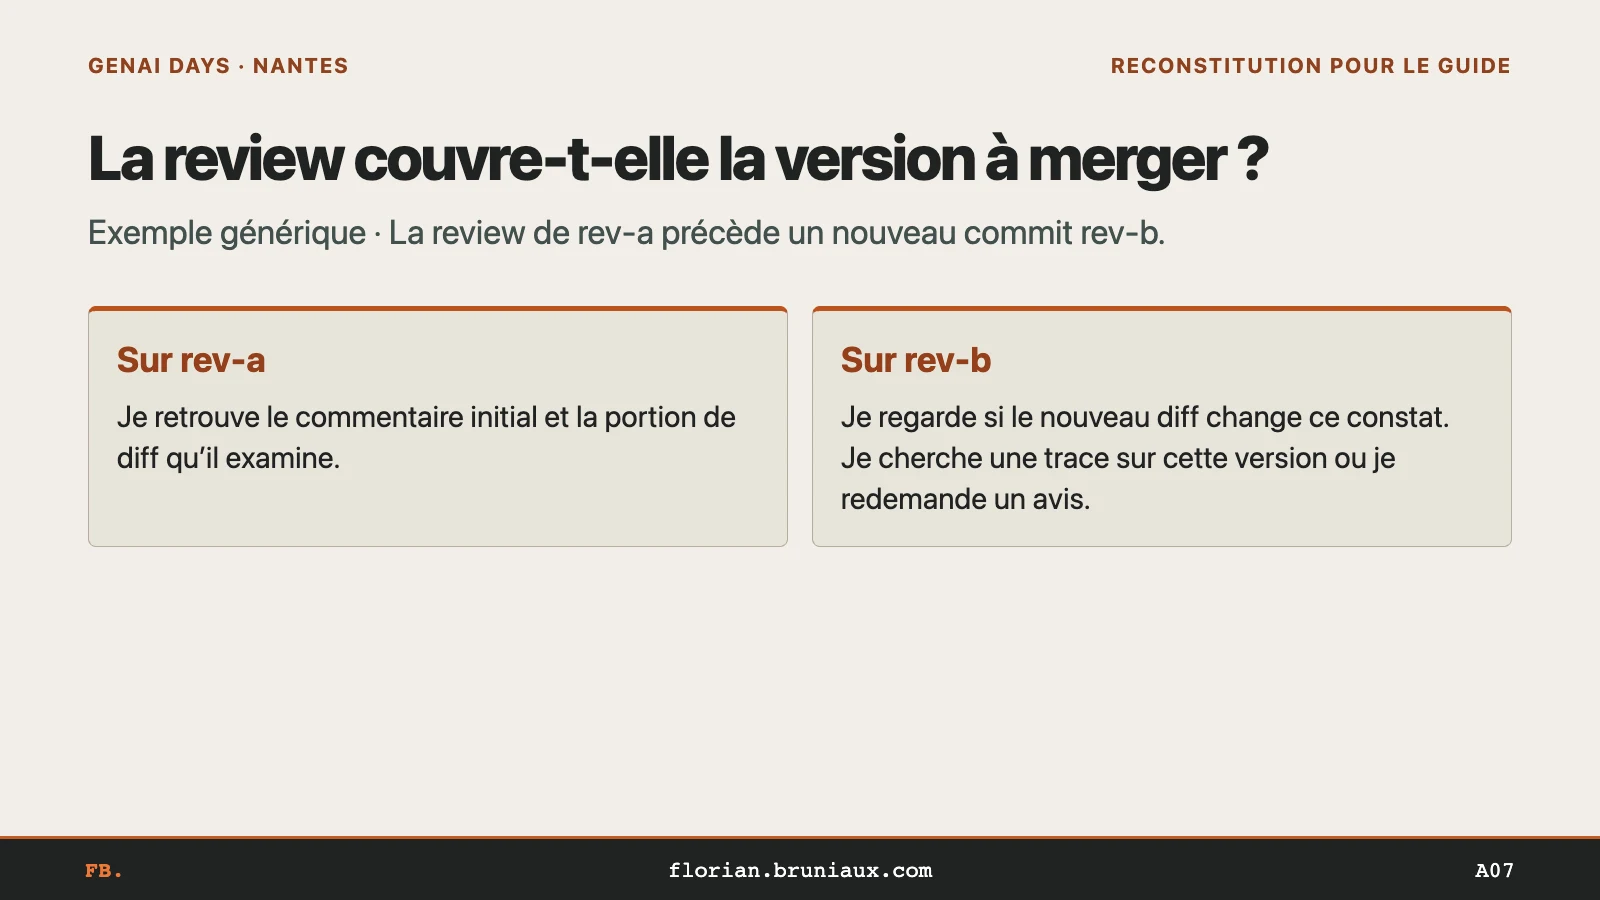
hrefAvant de merger, je regarde les checks et les avis de review sur le dernier commit. Ceux du deuxième commit ne suffisent pas à vérifier le troisième. Une ancienne review peut encore m’aider sur une partie du diff qui n’a pas bougé, à condition de regarder ce qui a changé depuis et si la base a évolué.
L’équipe a mergé le troisième commit. La review finale reparlait de la recherche par l’ancien terme, mais je n’ai pas retrouvé le détail de la décision sur cette suggestion.
Le détail des 3 commits et de leurs checks · Slides 06 à 15.
Lancer les bons tests avant la CI
À chaque correction, on peut repartir pour des tests, un build et une review. Les licences IA, on en avait discuté. La facture des runners GitHub Actions et Namespace nous avait davantage surpris. J’essaie donc de détecter les échecs sur le poste, avec les tests qui peuvent y tourner, avant d’envoyer le code en CI.
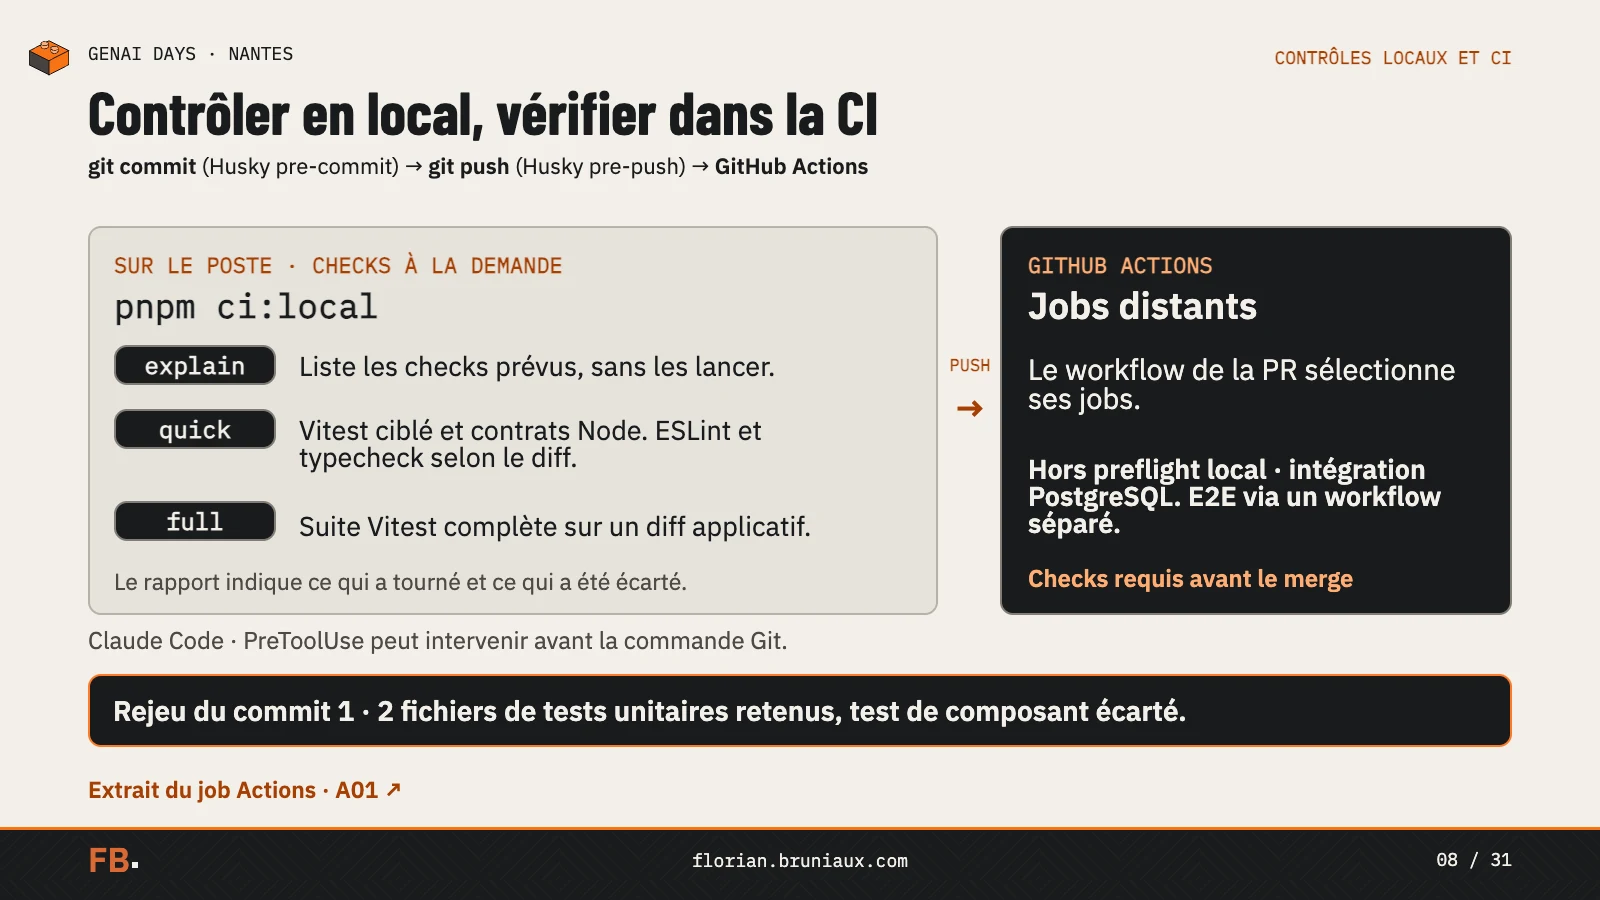
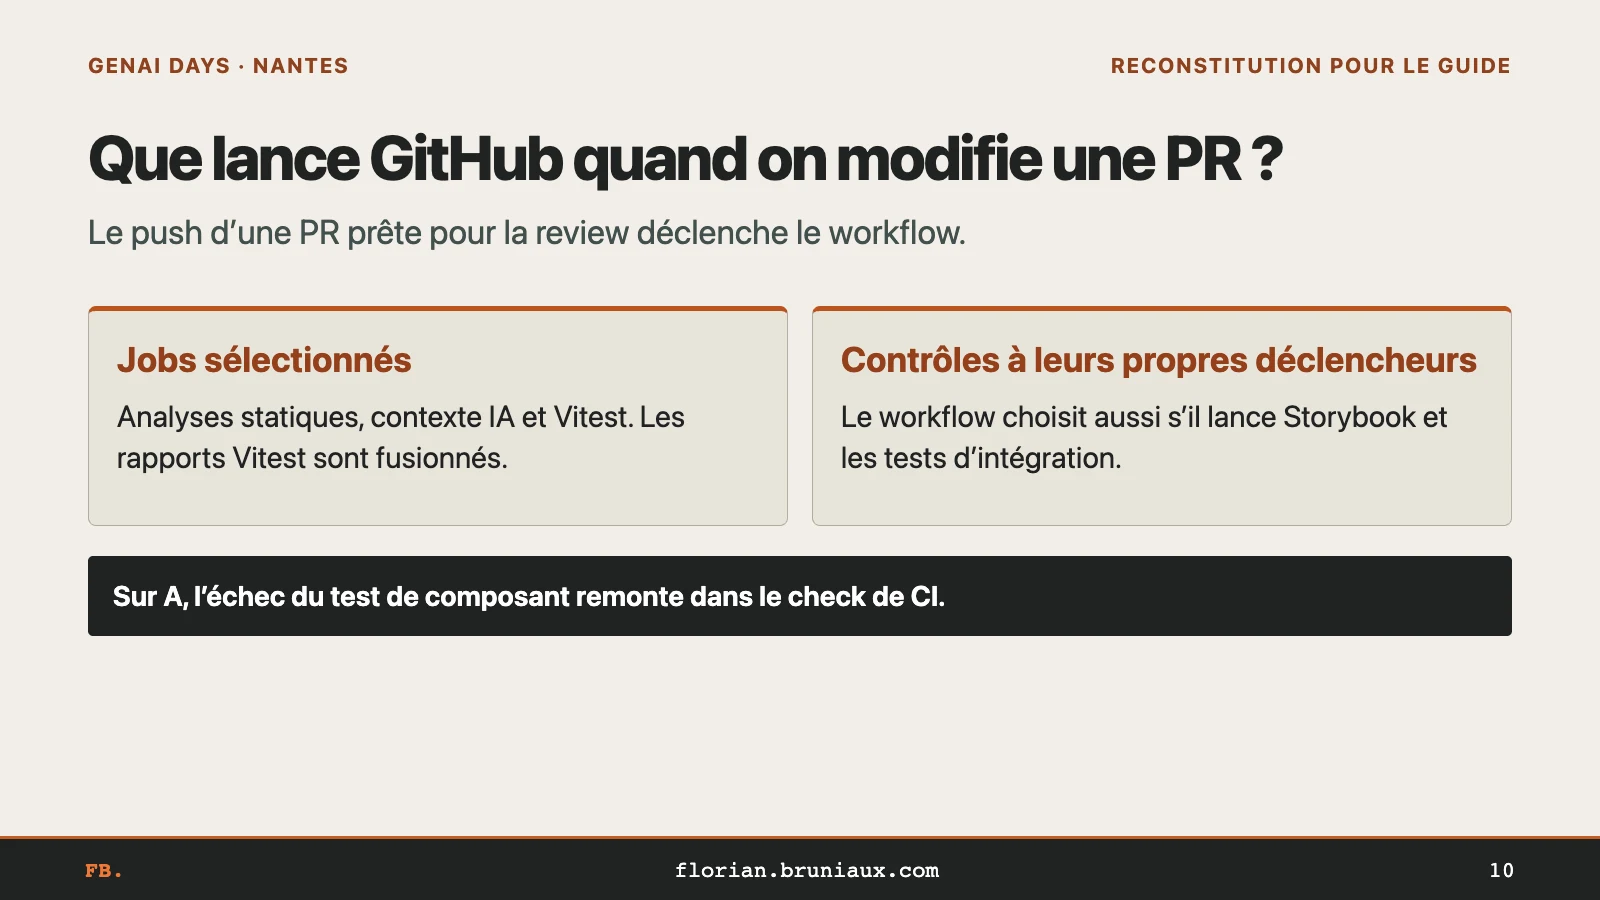
Chez Aristote, le preflight sélectionne des checks à partir du diff. Je peux lui demander d’expliquer sa sélection, de lancer les tests retenus et de produire un rapport. La CI a ses propres règles de déclenchement. Les tests d’intégration PostgreSQL tournent à distance et les tests E2E passent par un workflow distinct, lancé à la demande.
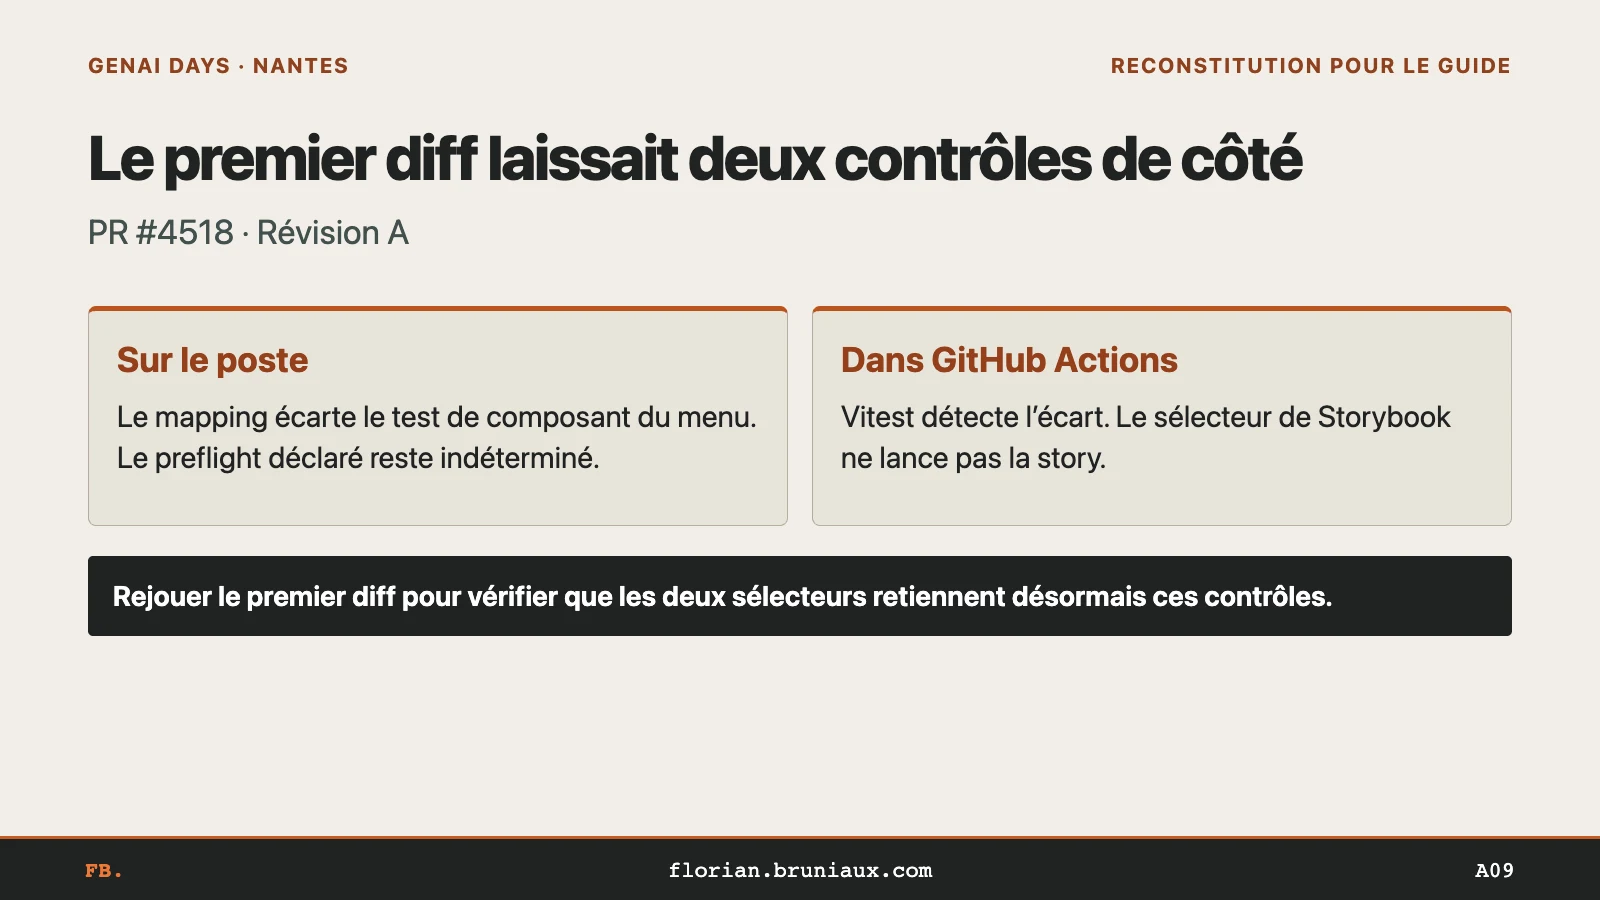
Sur la #4518, le test du menu pouvait tourner en local. Pourtant, quand je rejoue le premier diff dans le sélecteur, il retient des tests du catalogue de navigation et laisse de côté le test de composant. Cela me dit quels tests il aurait sélectionnés. Pour l’exécution de l’auteur, je dispose de son compte rendu : il rapporte un preflight indéterminé à cause de fichiers d’environnement. Je ne peux pas le compter comme un passage au vert.
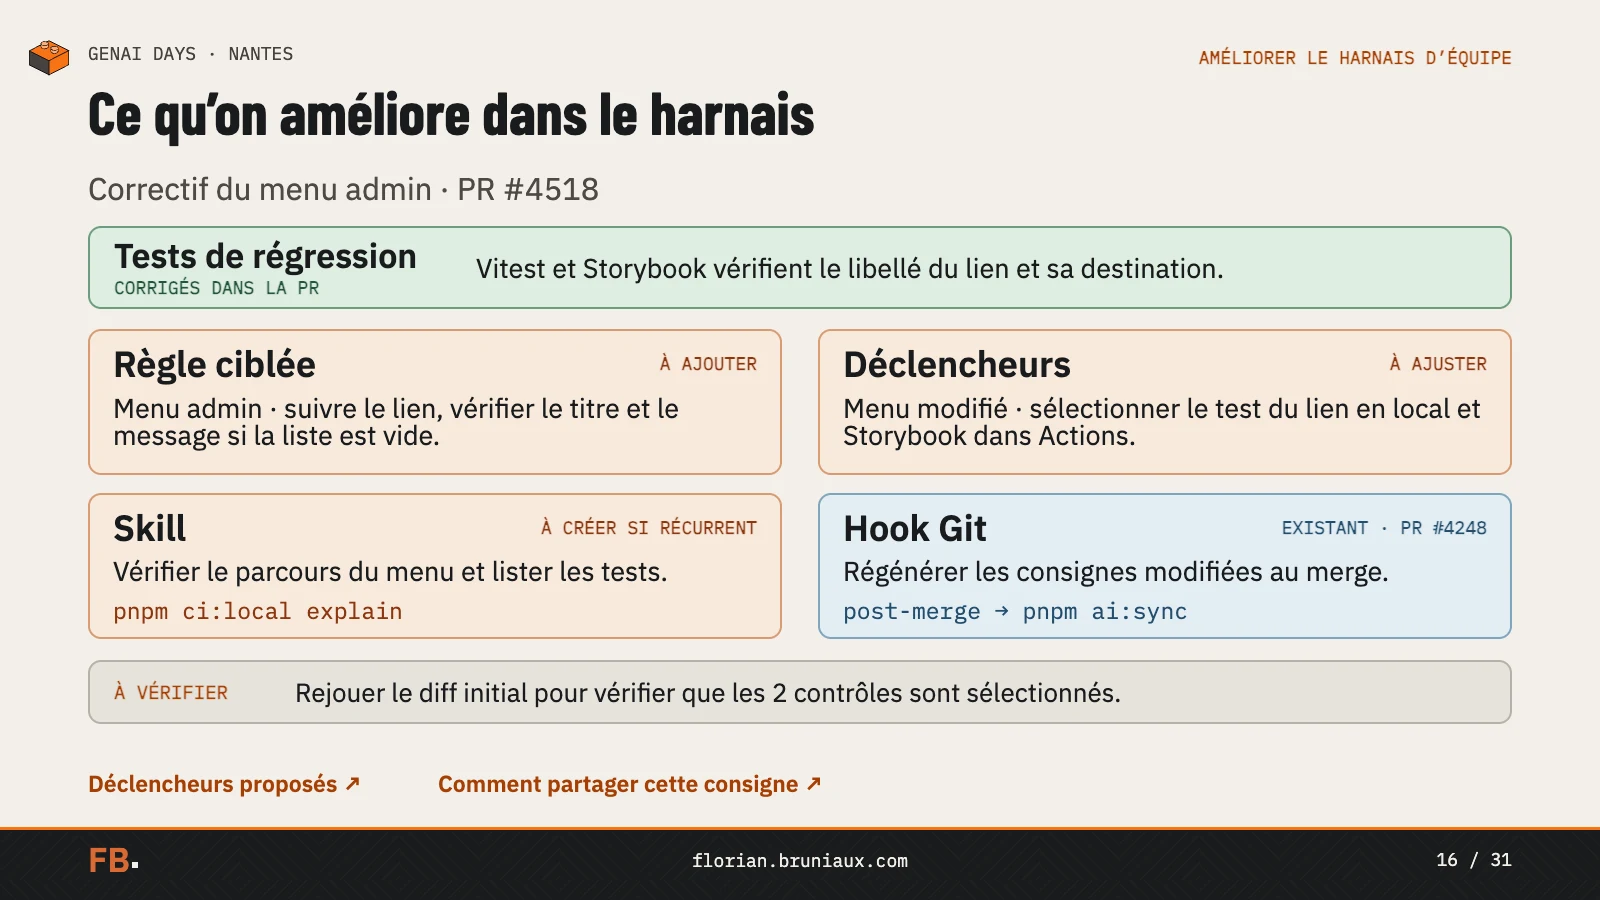
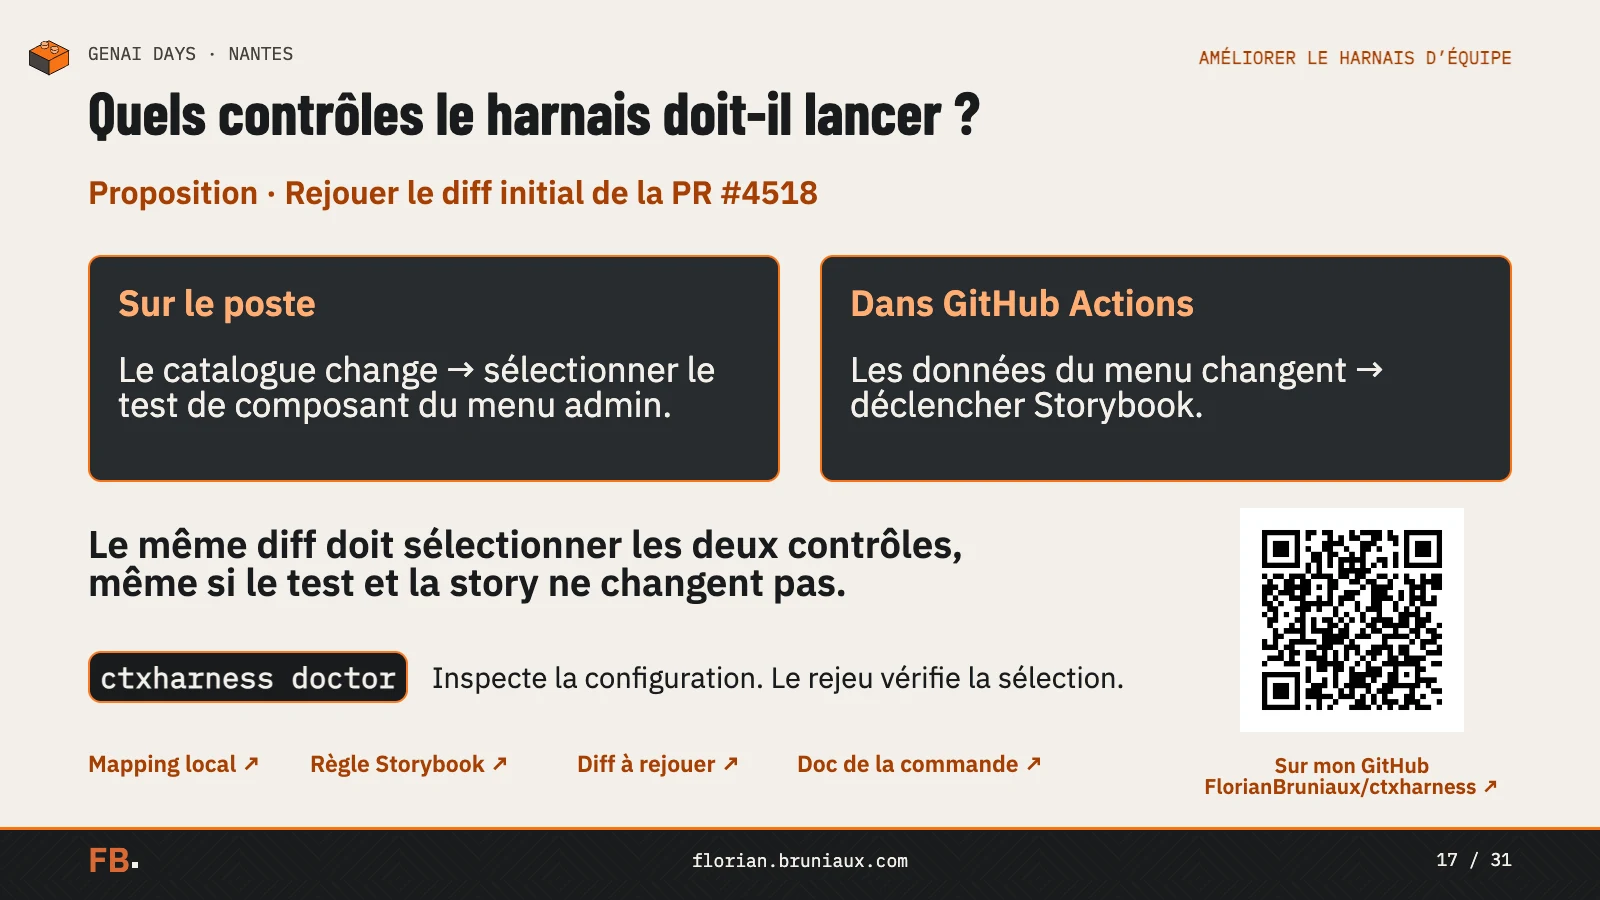
Je testerais 2 changements à partir de ce diff : associer les données du menu au test de composant dans le mapping local et faire déclencher Storybook dans Actions lorsque ces données changent. Je peux vérifier la sélection avec le premier diff, puis lancer les tests pour voir ce qu’ils détectent. Je rejouerais aussi un diff sans rapport pour vérifier que je ne déclenche pas ces jobs inutilement. Ces changements restent à tester.
Commandes du preflight et lecture du rapport · Les 2 règles de sélection proposées · Slides 08, 16 et 17.
Corriger la PR, puis le harness
Une fois la PR corrigée, je veux éviter que la suivante refasse la même erreur. Je peux préciser dans une règle ce qu’il faut vérifier quand on touche au menu ou ajouter un hook qui lance un test au bon moment. Mais pour savoir si j’ai corrigé le harness, je dois revenir au scénario qui avait posé problème.
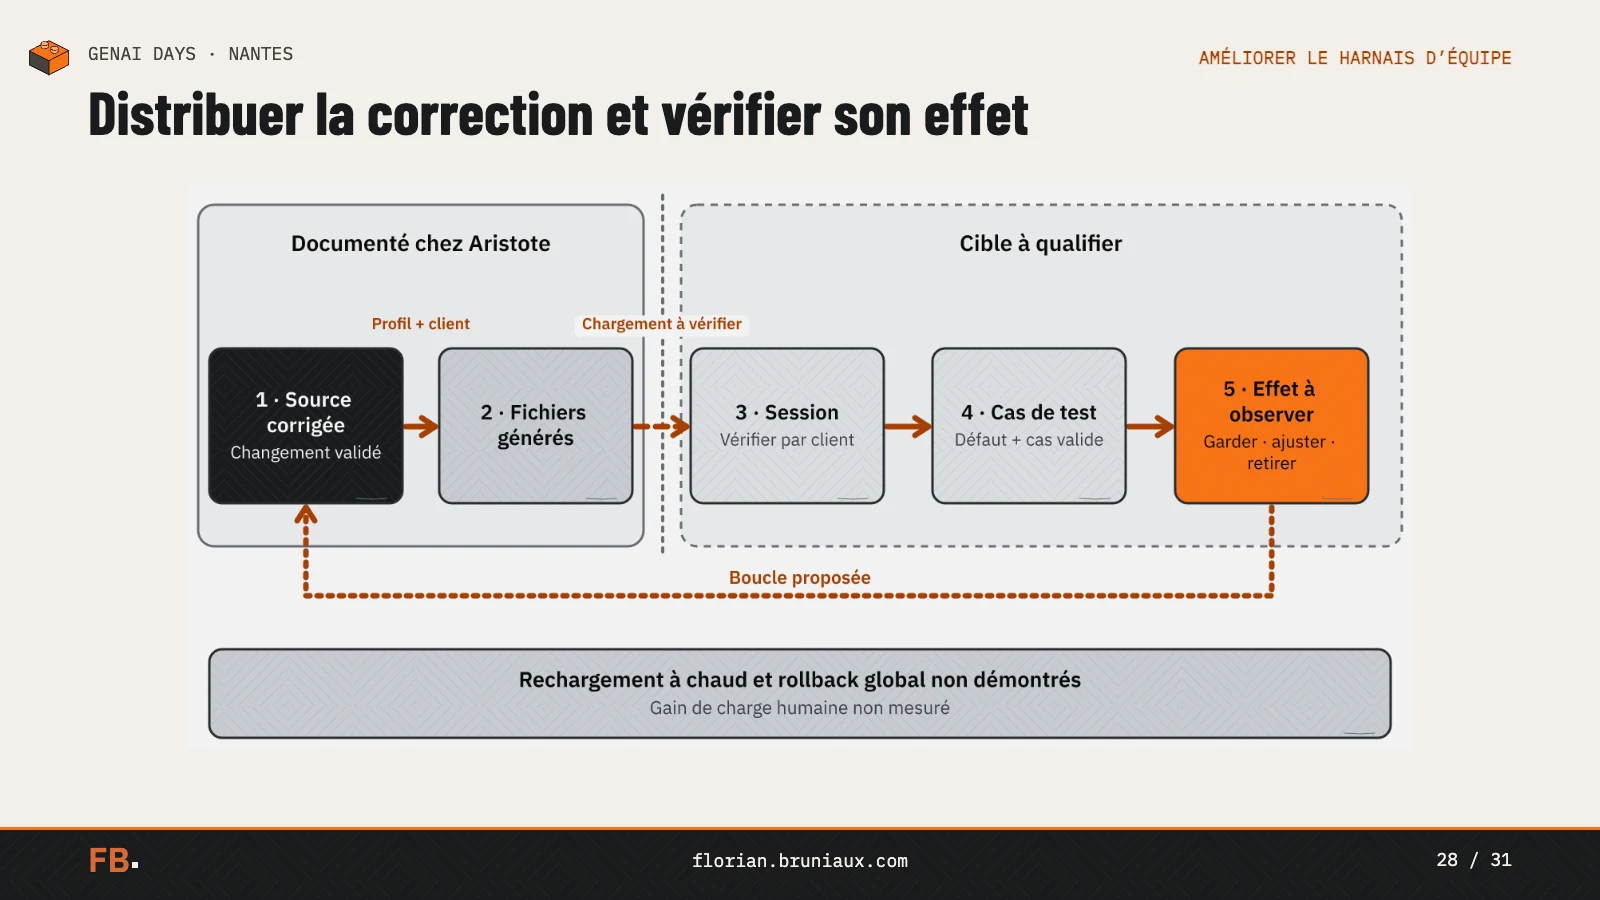
C’est pour ça que je garde autant de traces que possible : le ticket, les instructions, les conversations quand je peux les récupérer, le modèle, les skills et les hooks utilisés. Dans un clone indépendant du repo, je peux reprendre le scénario avec le harness corrigé et voir si l’erreur se reproduit.
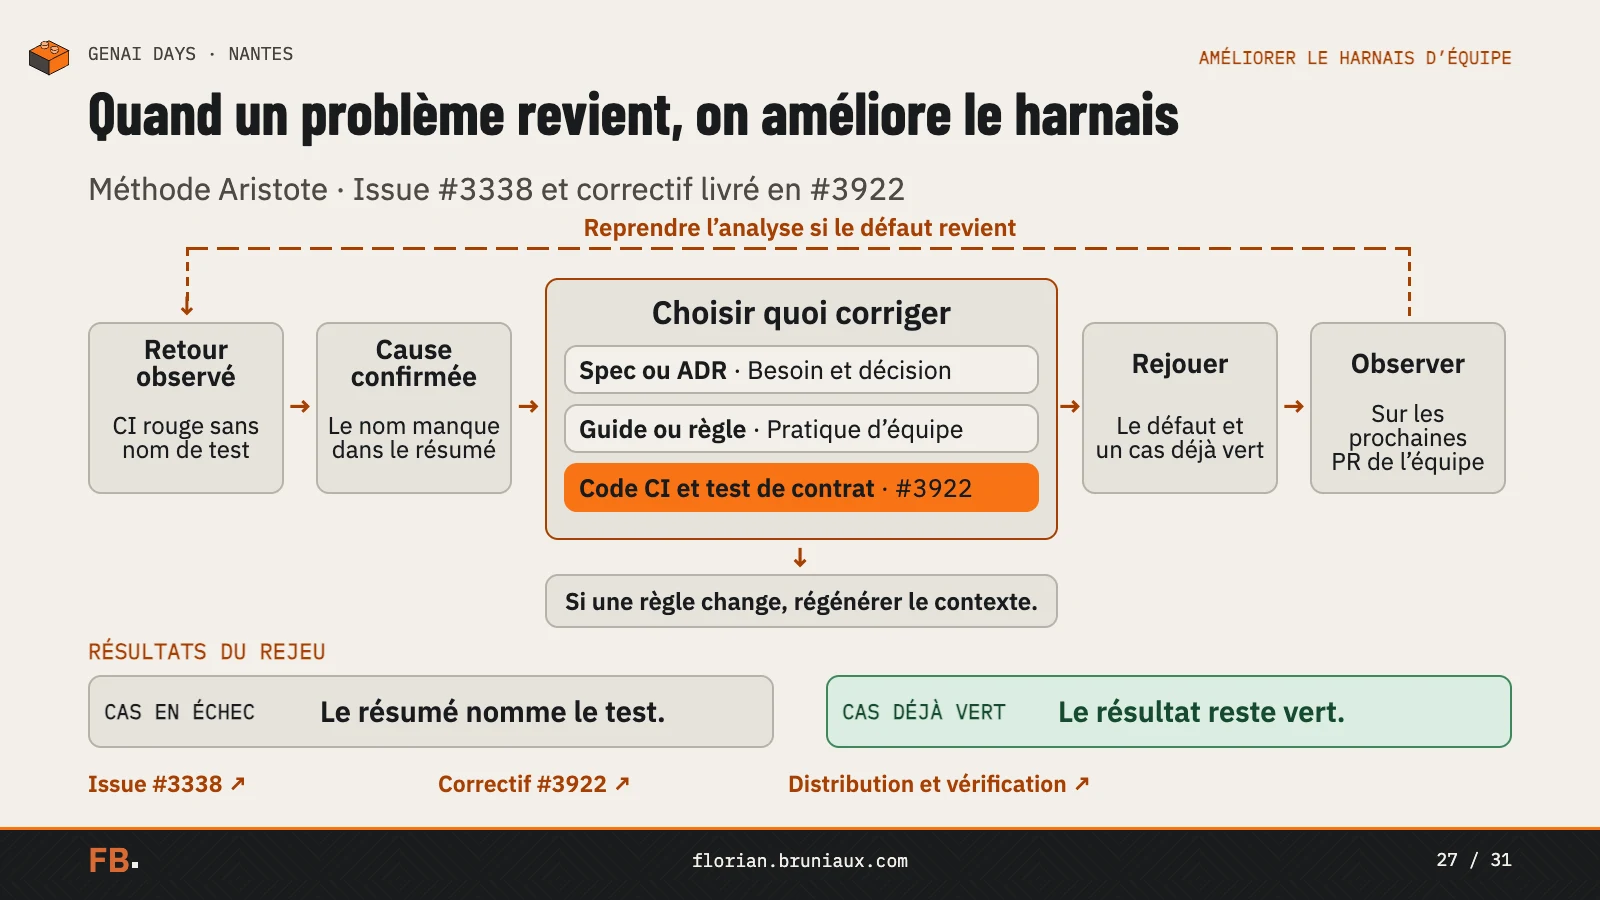
L’issue #3338 donne un exemple plus limité. Le résumé CI était rouge, mais il ne nommait pas le test qui avait échoué. La #3922 ajoute ce nom et un test de contrat. Quand je rejoue les tests, le résumé nomme bien le test en échec et le cas déjà vert passe toujours. J’ai vérifié ces 2 cas. Il reste à mesurer si ce résumé fait gagner du temps sur les PR suivantes.
Chez Aristote, j’estime que je consacrais au moins 50 % de mon temps à modifier le harness. Je faisais de la R&D, avec du temps et du budget pour comparer et rejouer, pendant que l’équipe produit avançait avec les outils et les règles que je préparais. Ce temps senior fait partie du coût de cette façon de travailler.
Le correctif du résumé CI et les conditions de replay · Slides 27 à 29.
Quelles PR ont encore besoin d’un humain ?
Je voudrais qu’environ 2/3 des PR n’aient plus besoin d’une intervention humaine dans la review. C’est l’objectif que je donne pendant le talk, et je travaille encore sur l’aiguillage. À terme, je voudrais aussi que l’agent puisse décider du merge sur les PR qu’il sait qualifier.
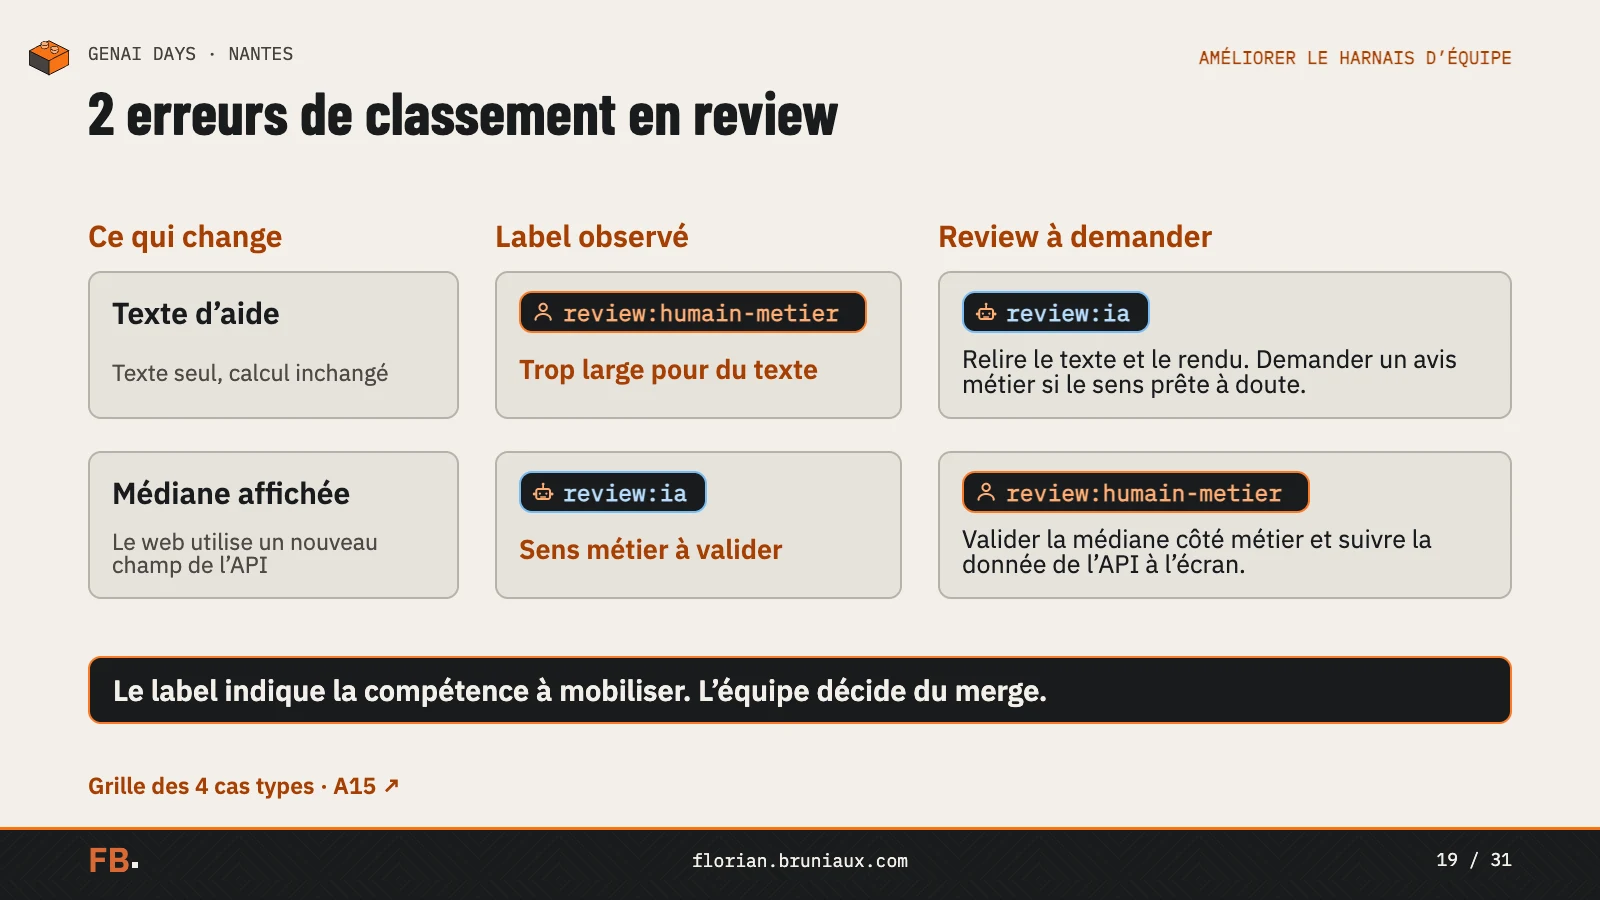
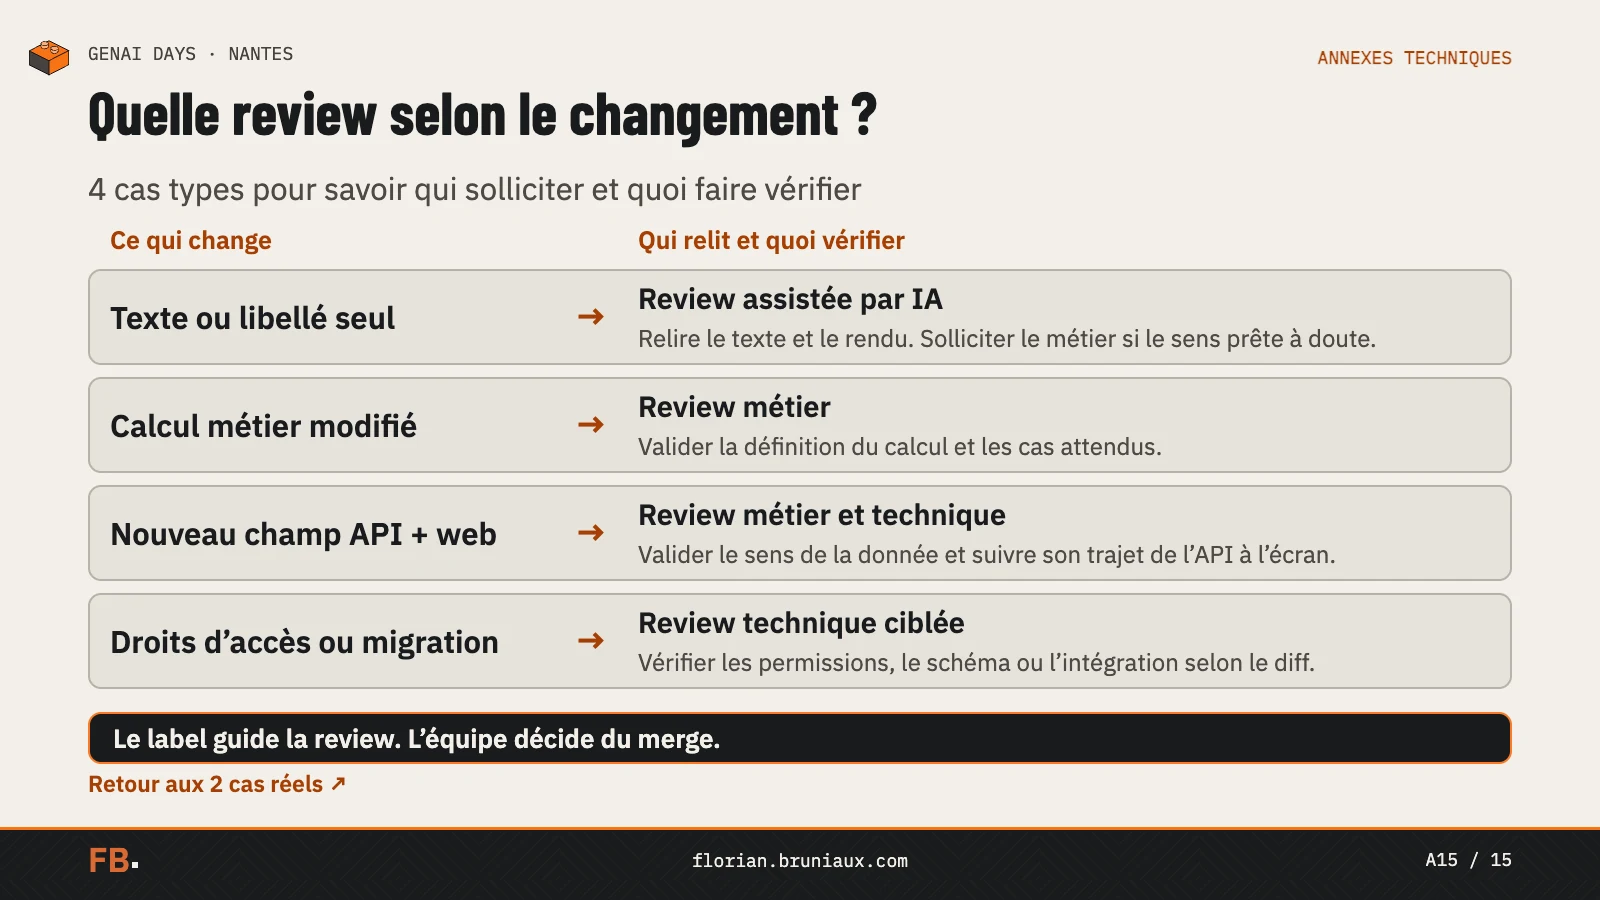
Pour régler le classement, j’ai demandé à un CTO de relire les PR en indiquant celles où il avait servi à quelque chose, celles où il n’avait rien eu à faire et celles que l’IA avait mal classées. Je peux reprendre la règle avec ses retours. Un texte d’aide, une médiane et une formule de calcul ne demandent pas les mêmes vérifications. Le label indique de quelle compétence on a besoin. Le diff, les dépendances, la CI et les discussions servent ensuite à décider jusqu’où pousser la review.
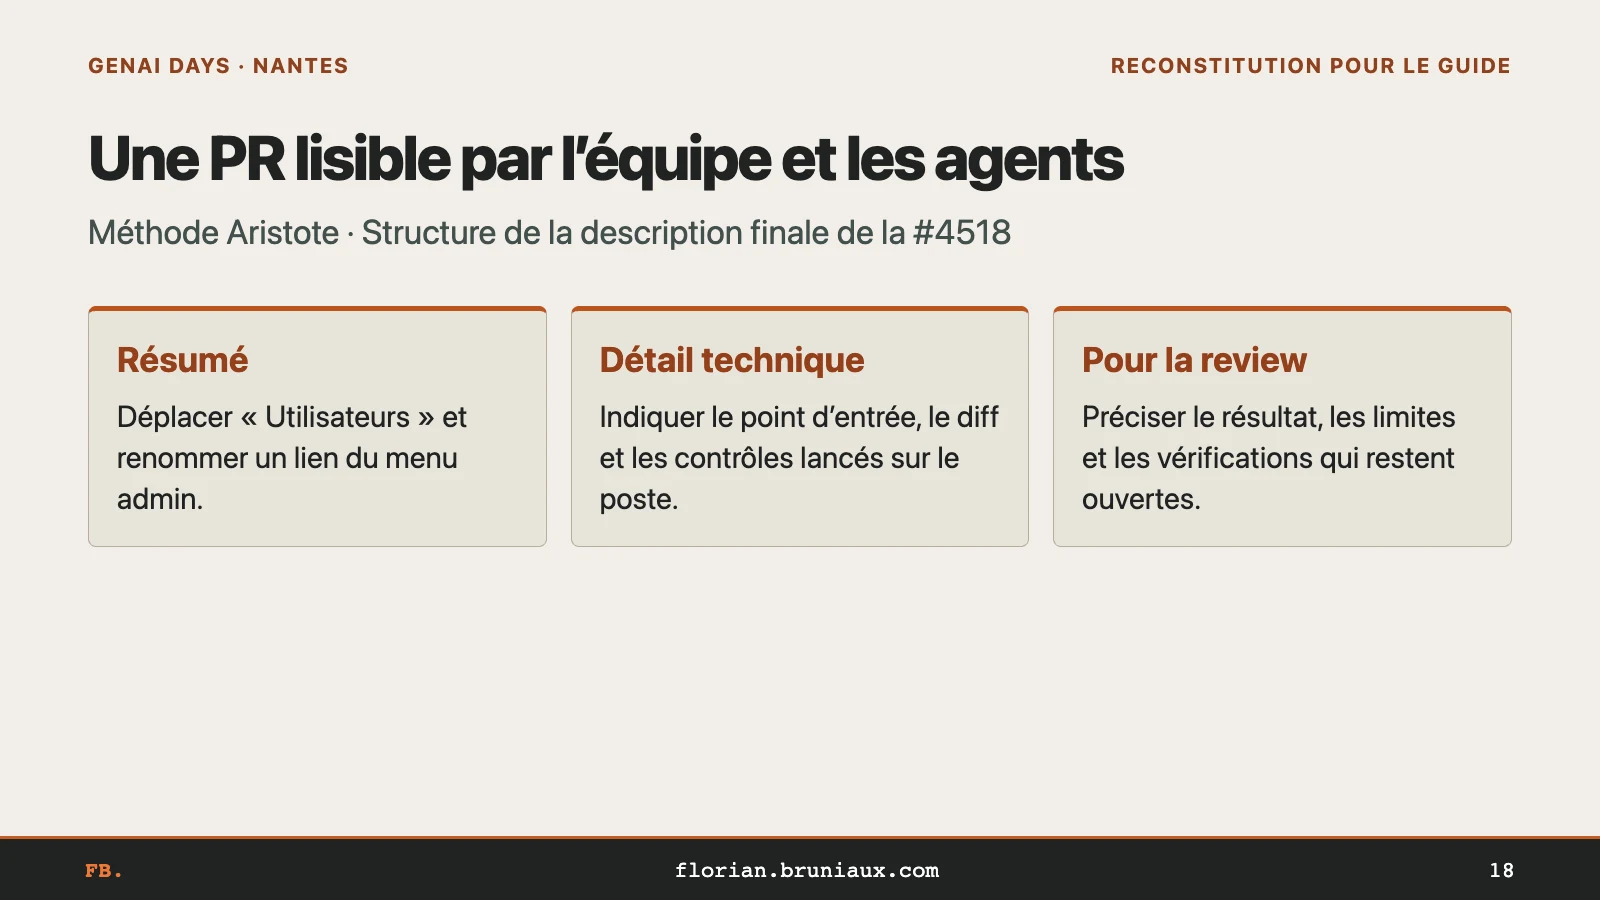
Je veux aussi comprendre la PR sans commencer par lire tout le code. La description doit expliquer ce qui change dans le produit, puis donner les détails techniques, les tests et les traces du harness local. Un diagramme ou un screenshot peut aider. Sur la #4518, la description finale contient ces informations. Je ne sais pas comment l’agent s’en est servi.
Sur un CRM de statistiques, je vois par exemple des PR techniquement correctes qui attendent une réponse sur le sens d’une donnée. C’est une question pour le produit ou le business, mais elle reste dans une discussion GitLab que ces personnes n’ont pas le temps de suivre. Je cherche à la remonter dans Slack, avec le contexte et les choix possibles, pour qu’elles puissent répondre et débloquer la PR. Au moment du talk, je travaille encore sur cette intégration.
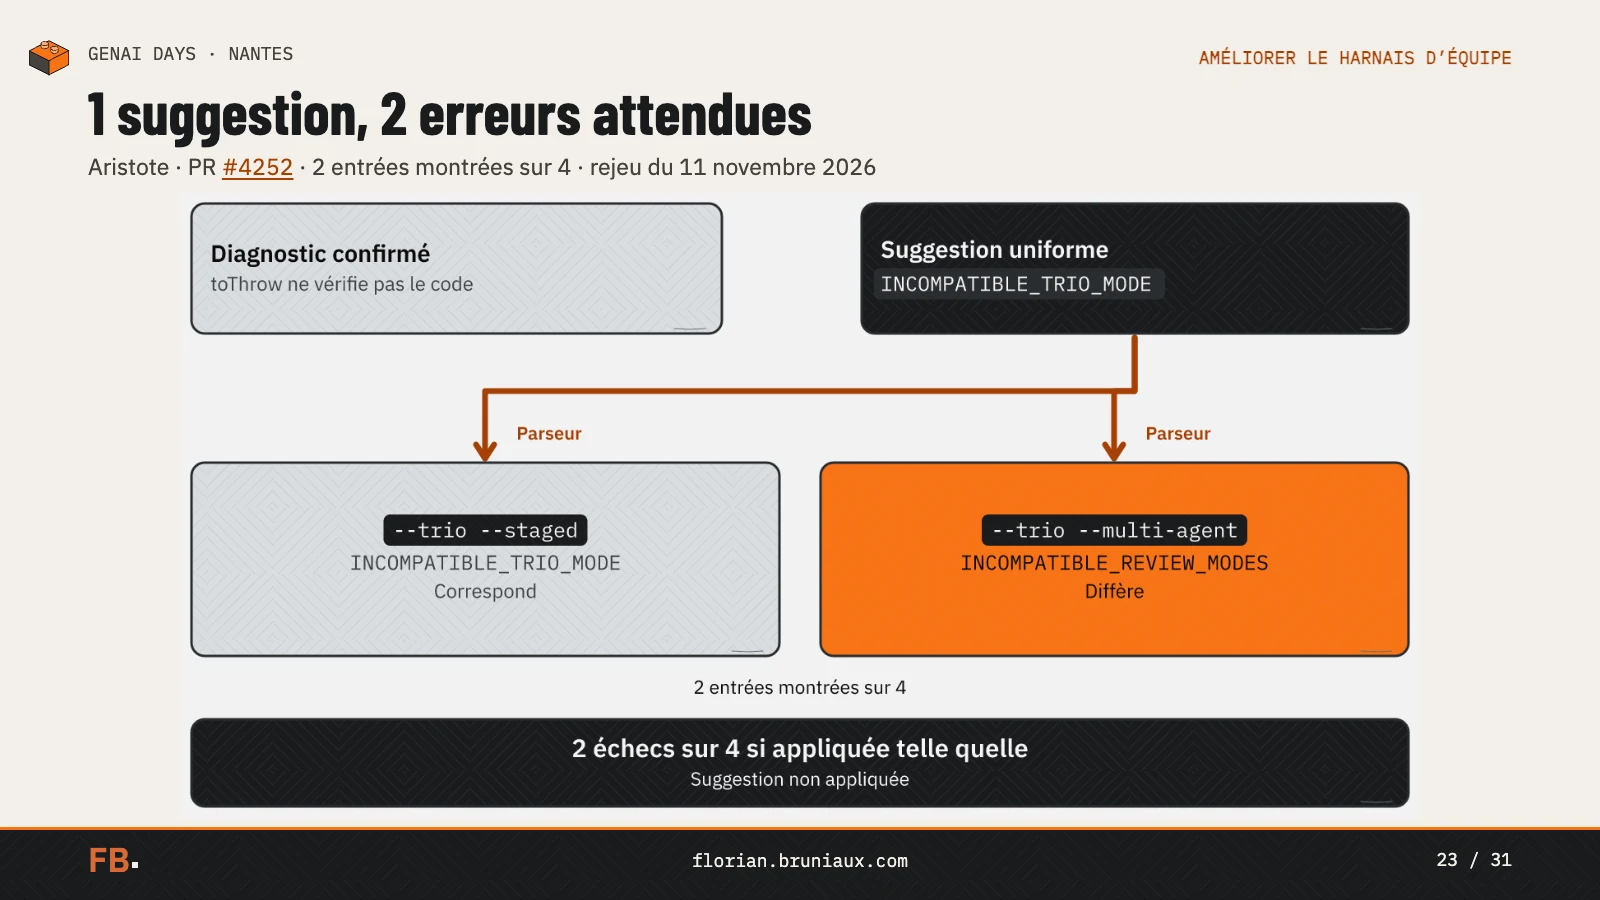
Les bots de review peuvent aussi se tromper. Je rassemble leurs commentaires, je regroupe les doublons et je vérifie ce qu’ils disent dans le diff avant de corriger. Sur la #4252, CodeRabbit avait repéré un test trop permissif. Mais le patch proposé donnait le même code à 2 erreurs distinctes. En rejouant le parseur, j’ai retrouvé des codes distincts pour ces erreurs. La suggestion est restée en commentaire.
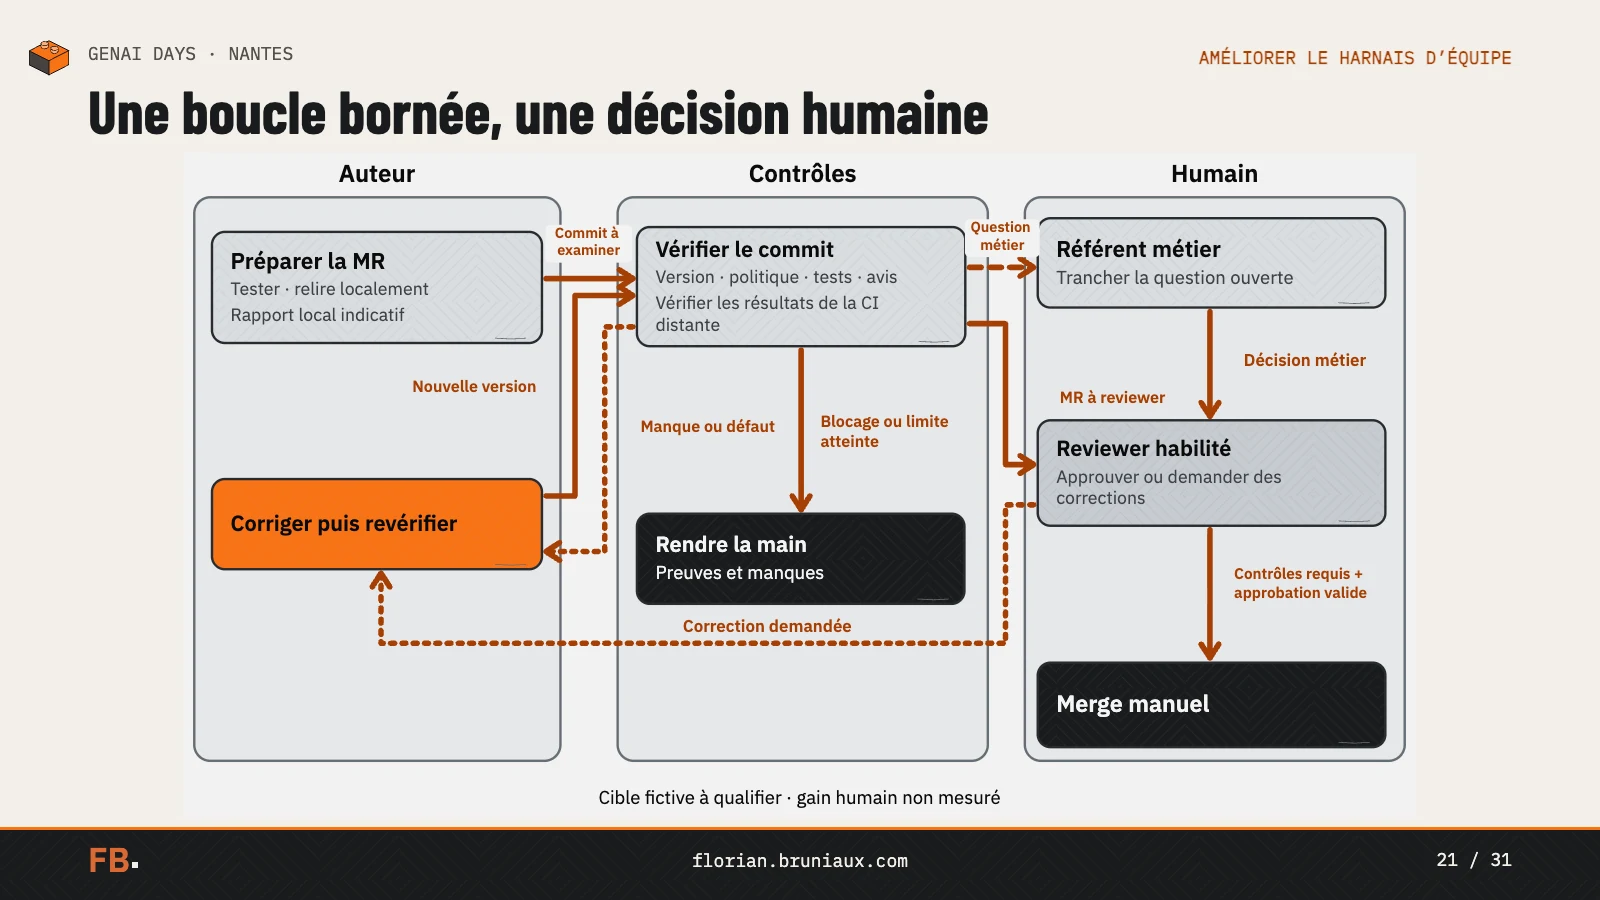
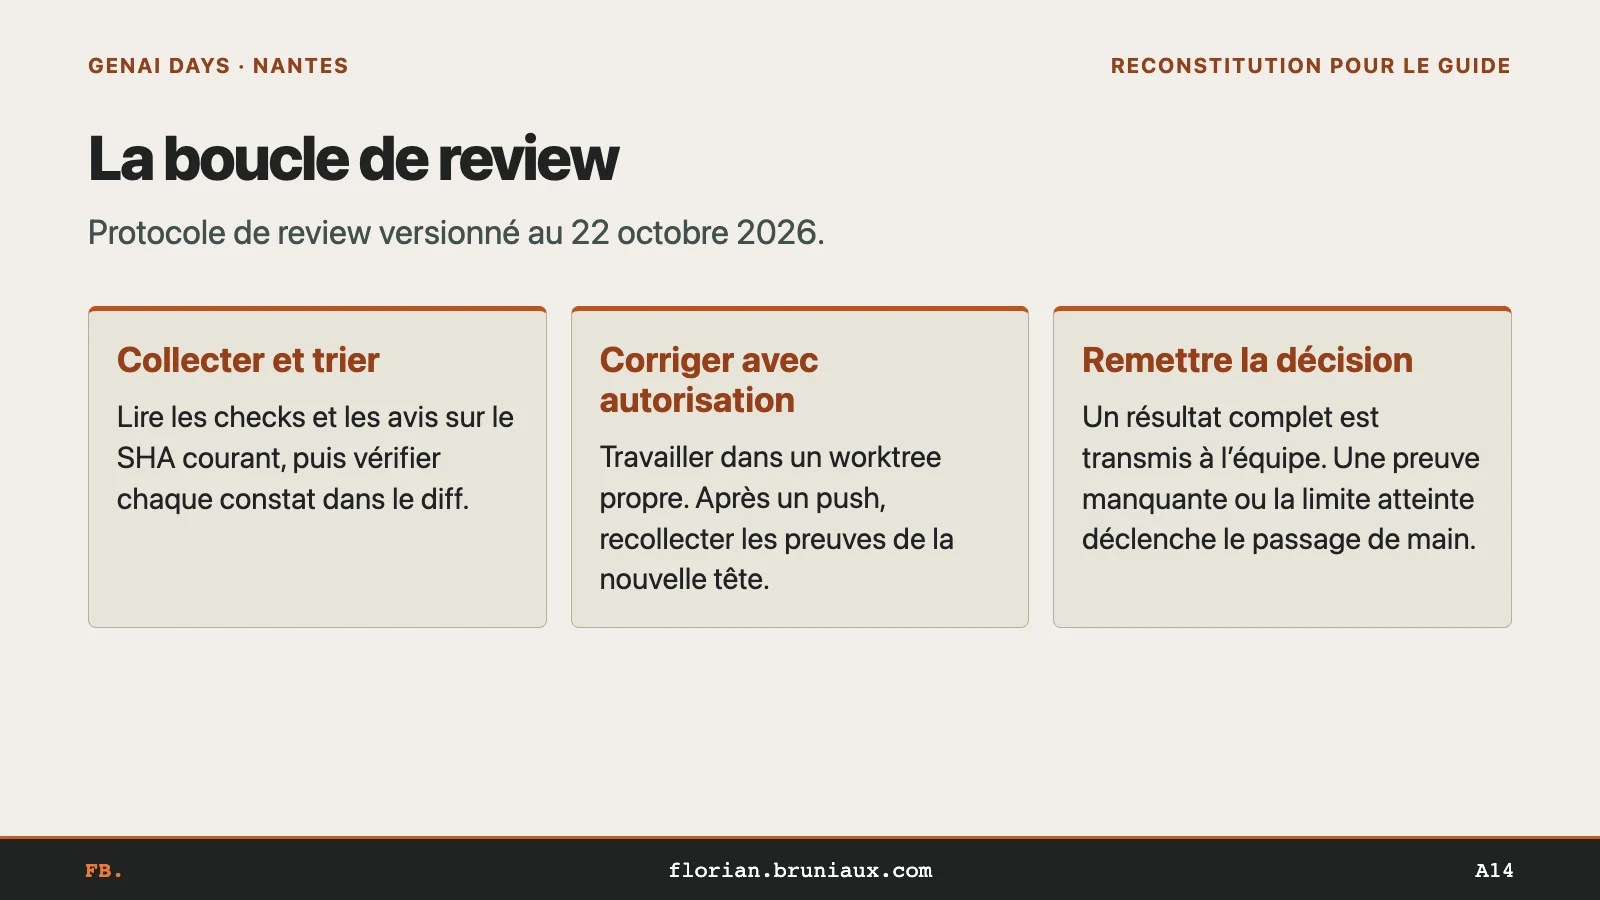
Si j’autorise l’agent à corriger, je fixe ce qu’il peut modifier, ses tentatives et les conditions du push. Il doit me rendre la main s’il n’a pas les résultats nécessaires, s’il stagne ou s’il a épuisé son budget. Aujourd’hui, quand il repère un défaut du harness, il crée souvent une issue avec son diagnostic et sa suggestion. Je reprends ces issues pour croiser les cas avant de choisir ce que je vais corriger et rejouer. Je n’ai pas établi que cette boucle avait tourné de bout en bout sur la #4518.
Les cas métier, les reviewers et les limites de correction · Slides 18 à 23.
Les règles dans Claude Code, Cursor et Codex
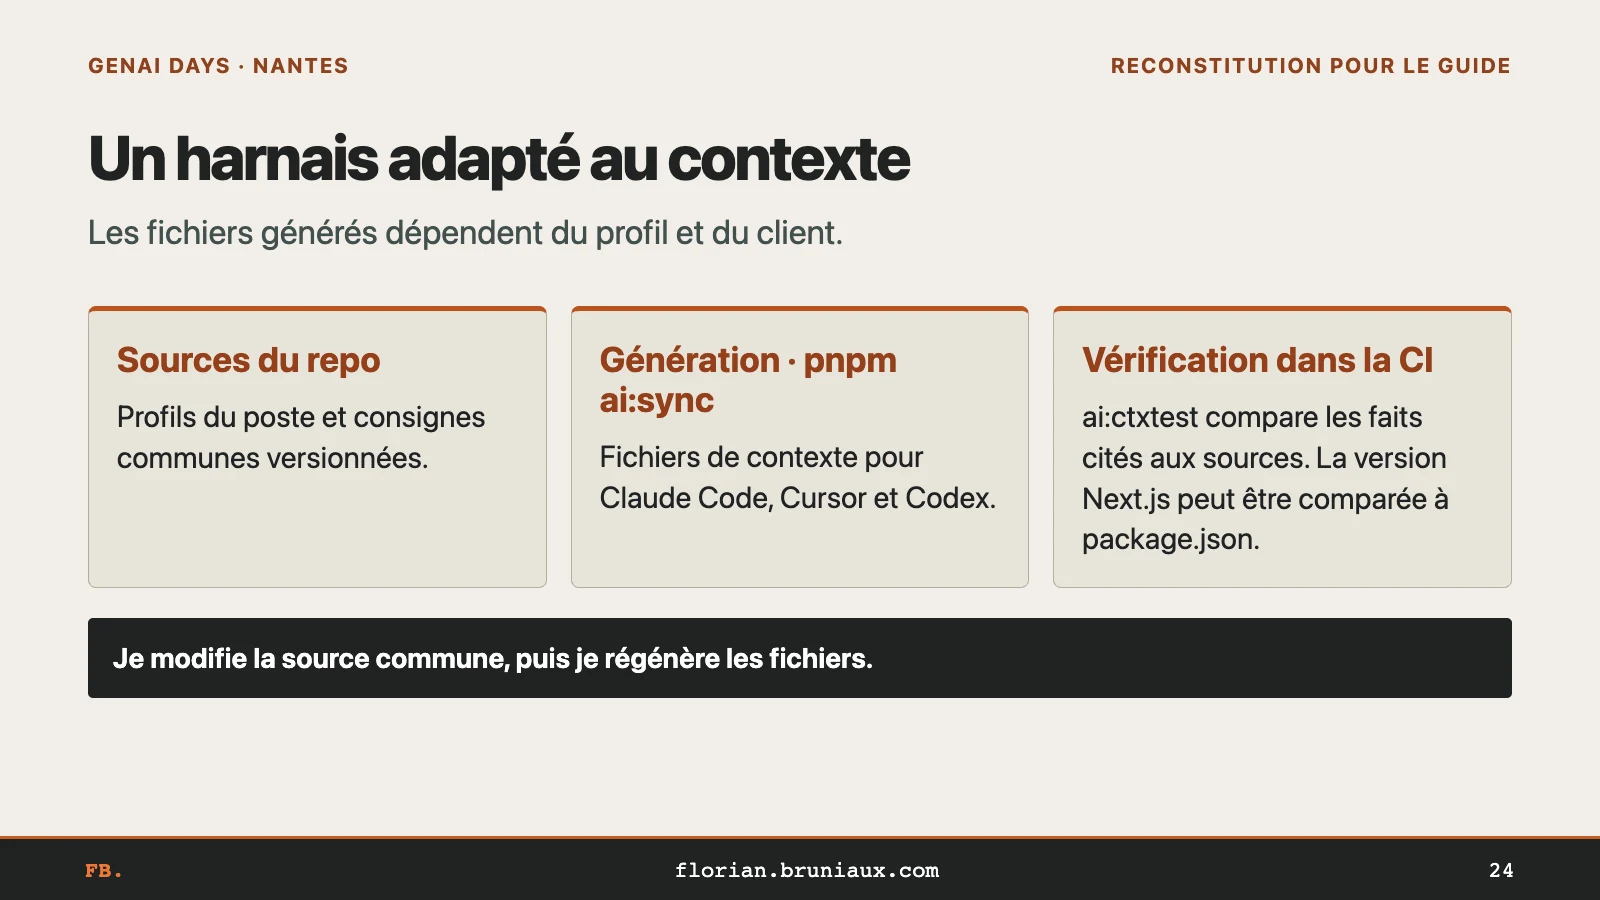
Chez Aristote, les règles partent de sources versionnées dans le repo. Je régénère ensuite les fichiers pour Claude Code, Cursor et Codex, selon le client et le profil du poste. Un dev backend et un dev front n’ont pas forcément besoin des mêmes MCP. Un collègue qui découvre le repo peut avoir des restrictions ou des questions avant le commit que je ne m’applique pas dans les mêmes conditions.
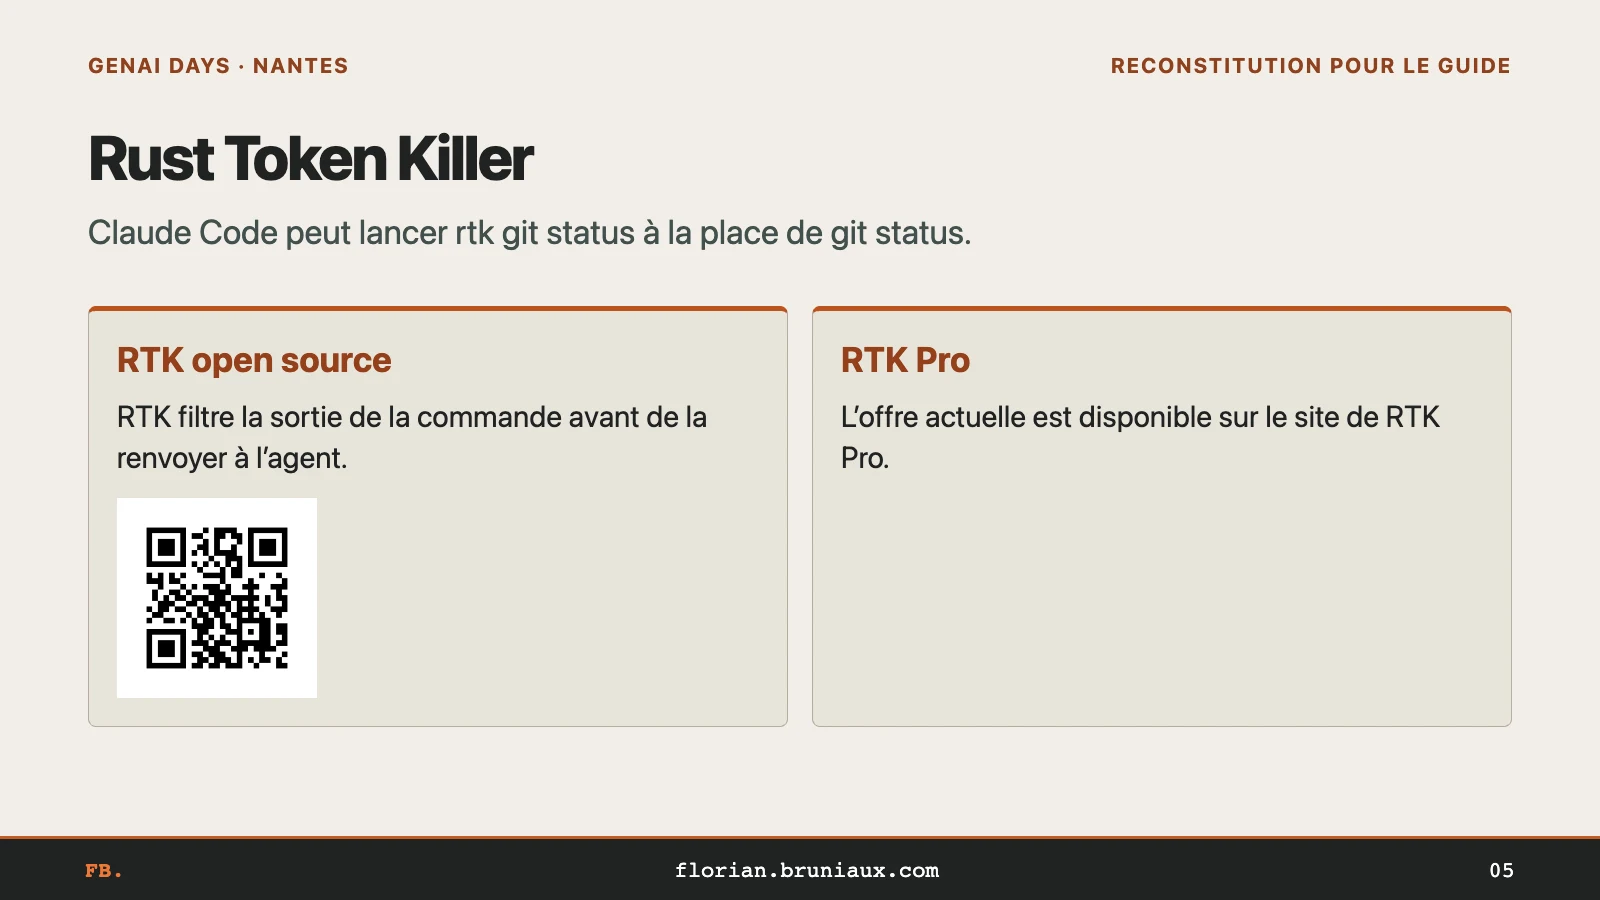
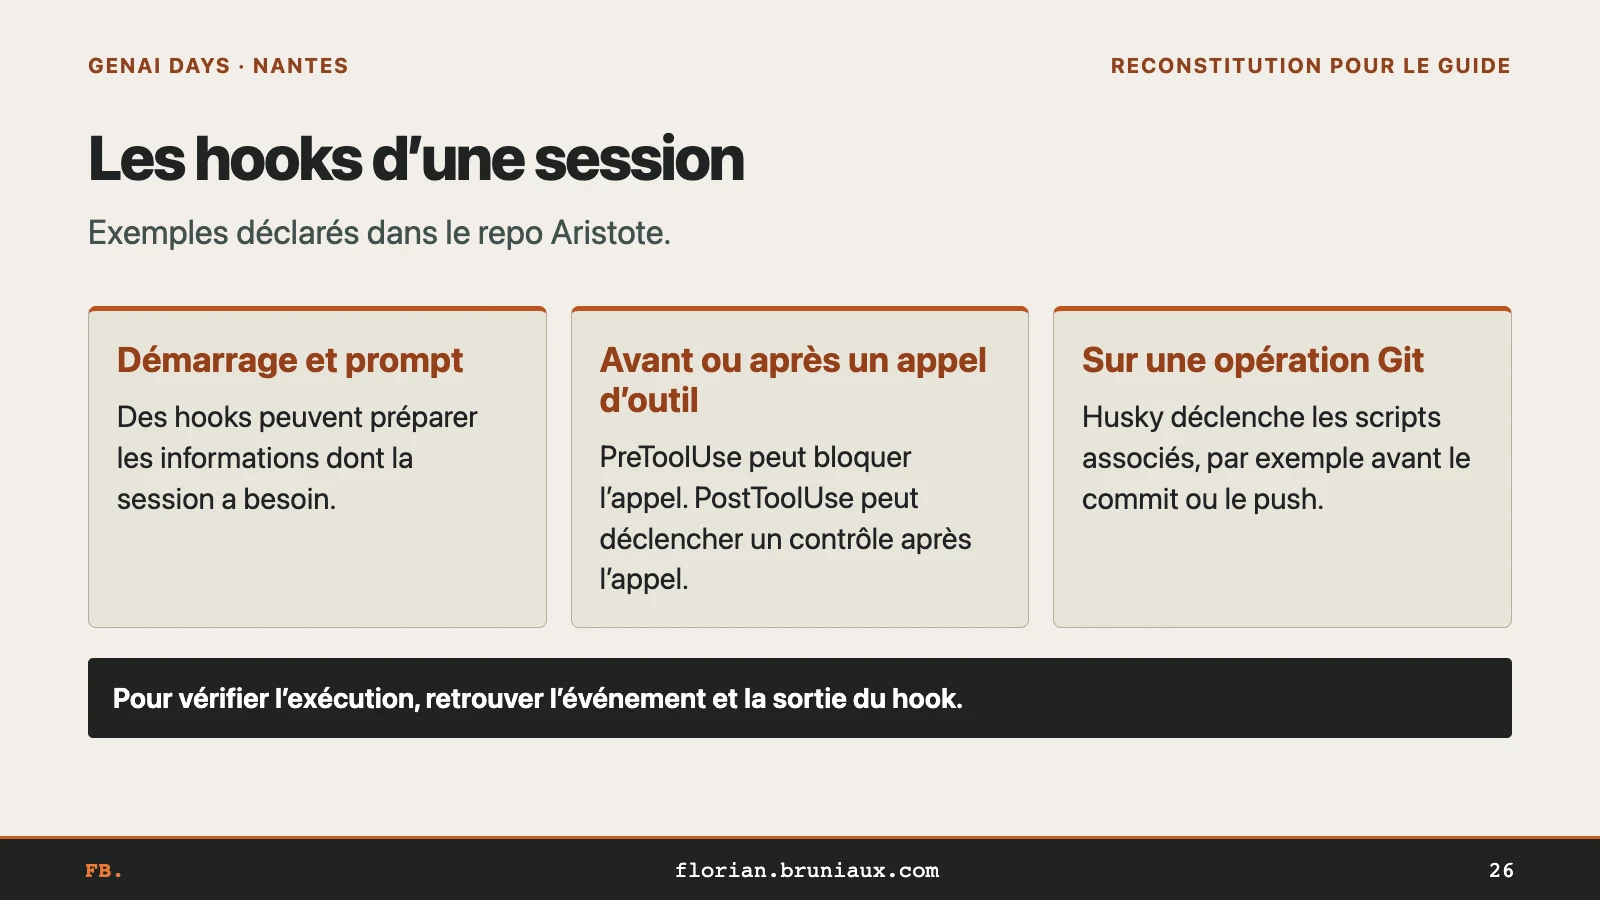
Un hook peut intervenir au démarrage de la session ou avant un appel d’outil. Avec RTK, par exemple, il peut demander rtk git status pour que l’agent reçoive une sortie filtrée. Les hooks Git réagissent aux opérations Git, comme un commit ou un pull. Je parle aussi pendant le talk d’une recherche BM25 à l’arrivée du prompt, pour retrouver des skills ou des agents utiles à la demande. Un collègue peut ainsi découvrir une partie du harness sans connaître chaque commande.
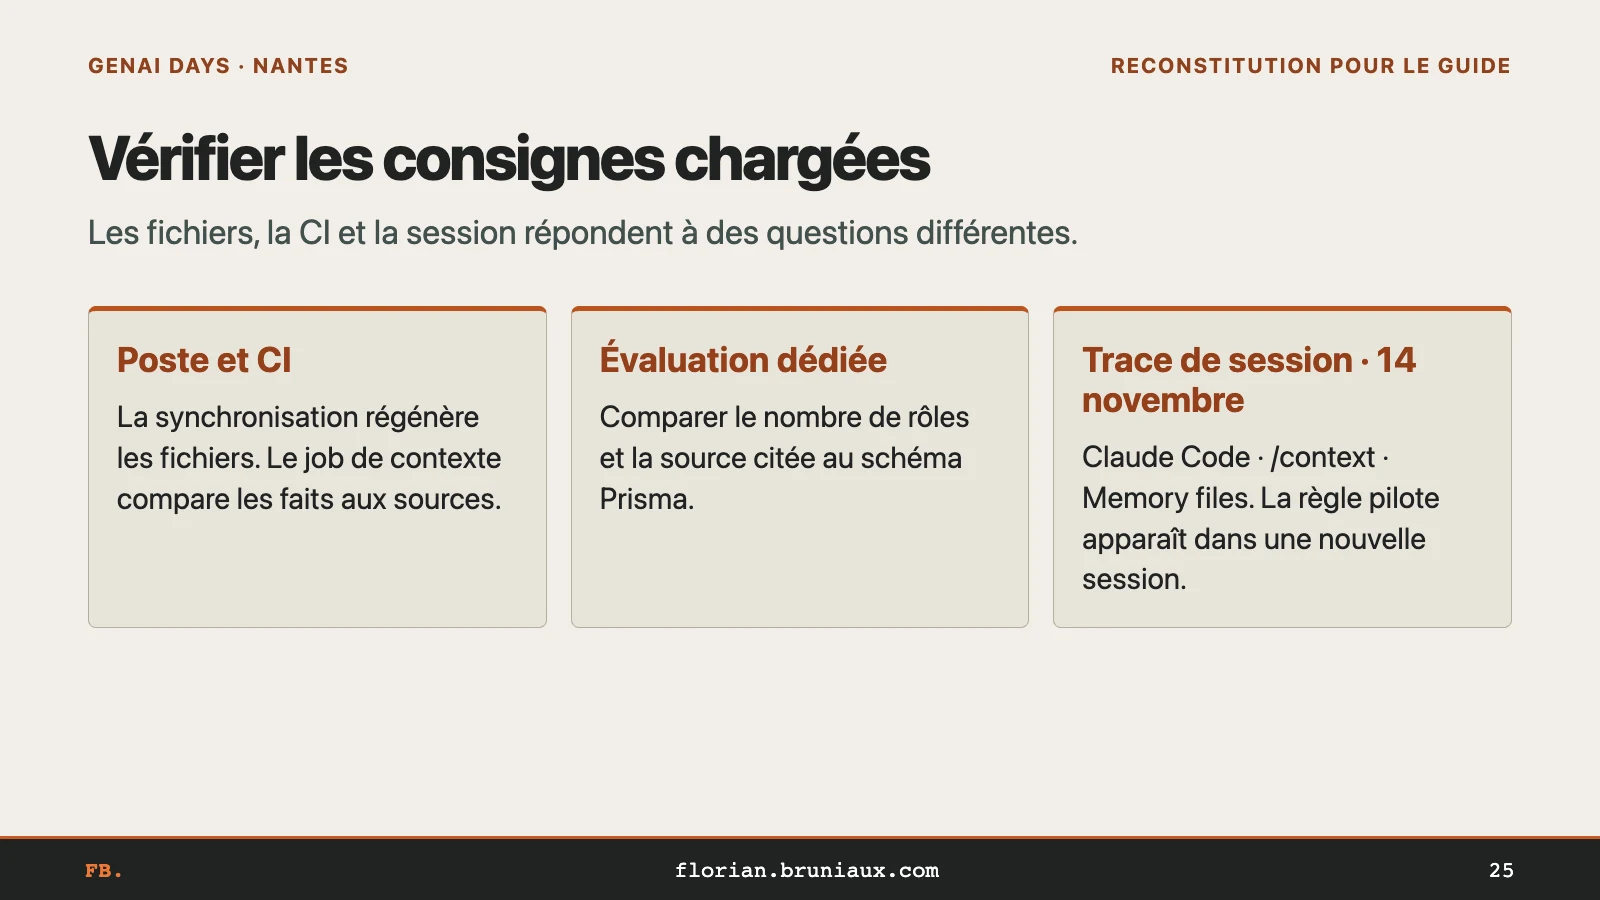
Je vérifie ensuite où la règle est arrivée. Si elle figure dans le fichier généré, je sais qu’elle est sur disque. Si elle apparaît dans la trace de la session, je sais que cette session l’a chargée. Pour voir ce qu’elle change au résultat, il faut encore rejouer un cas.
- La règle est-elle déclarée ?
- Diagnostic statique de
doctorsur les fichiers du projet. - La session a-t-elle chargé la règle ?
- Trace de la session, par exemple
/contextdans Claude Code. - Le nouveau mapping retient-il le test ?
- Rejeu proposé du diff A et comparaison avec la sélection attendue.
Le 14 novembre 2026, une nouvelle session Claude Code a listé la règle pilote dans /context, sur une copie isolée du repo. Je peux confirmer ce chargement. Pour Cursor et le rechargement à chaud, cela reste à vérifier. De même, ctxharness doctor inspecte les fichiers du projet. Si je veux savoir si le test du menu serait sélectionné, je dois rejouer le diff dans le sélecteur.
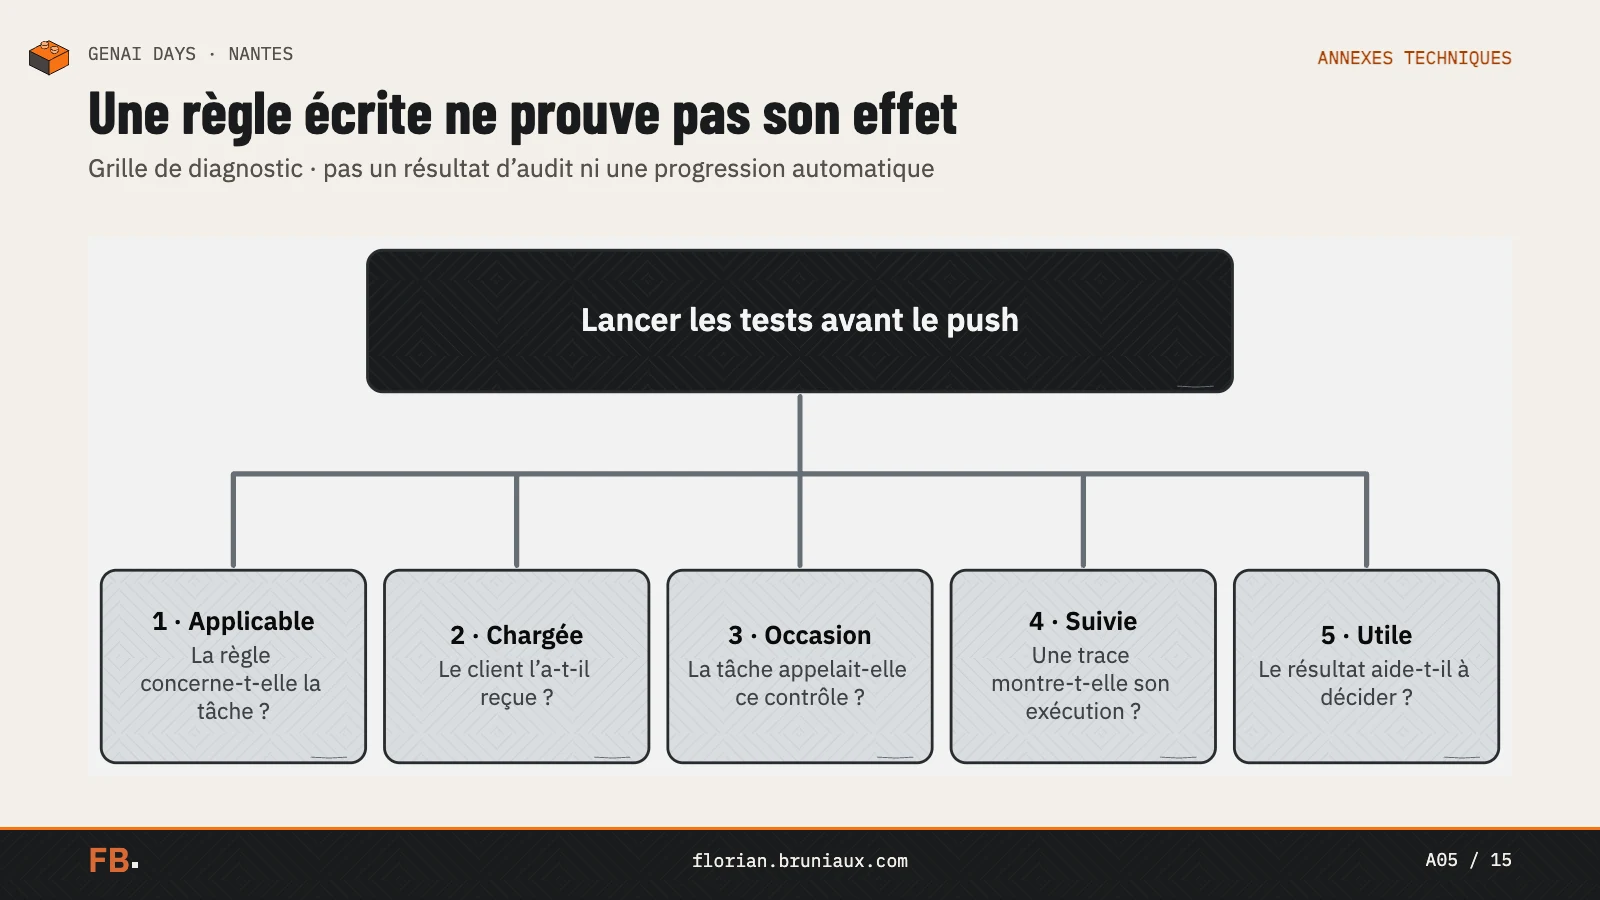
Quand un collègue n’obtient pas le comportement attendu, je peux regarder où ça s’arrête. La règle s’applique-t-elle à sa tâche ? La session l’a-t-elle chargée ? Le check devait-il se déclencher et a-t-il tourné ? Je reprends le réglage à partir de ces traces, puis je vérifie ce qui se passe sur son poste.
Génération des fichiers, profils, hooks et chargement des règles · Slides 24 à 28.
Les 99 % de confiance dans mes PR
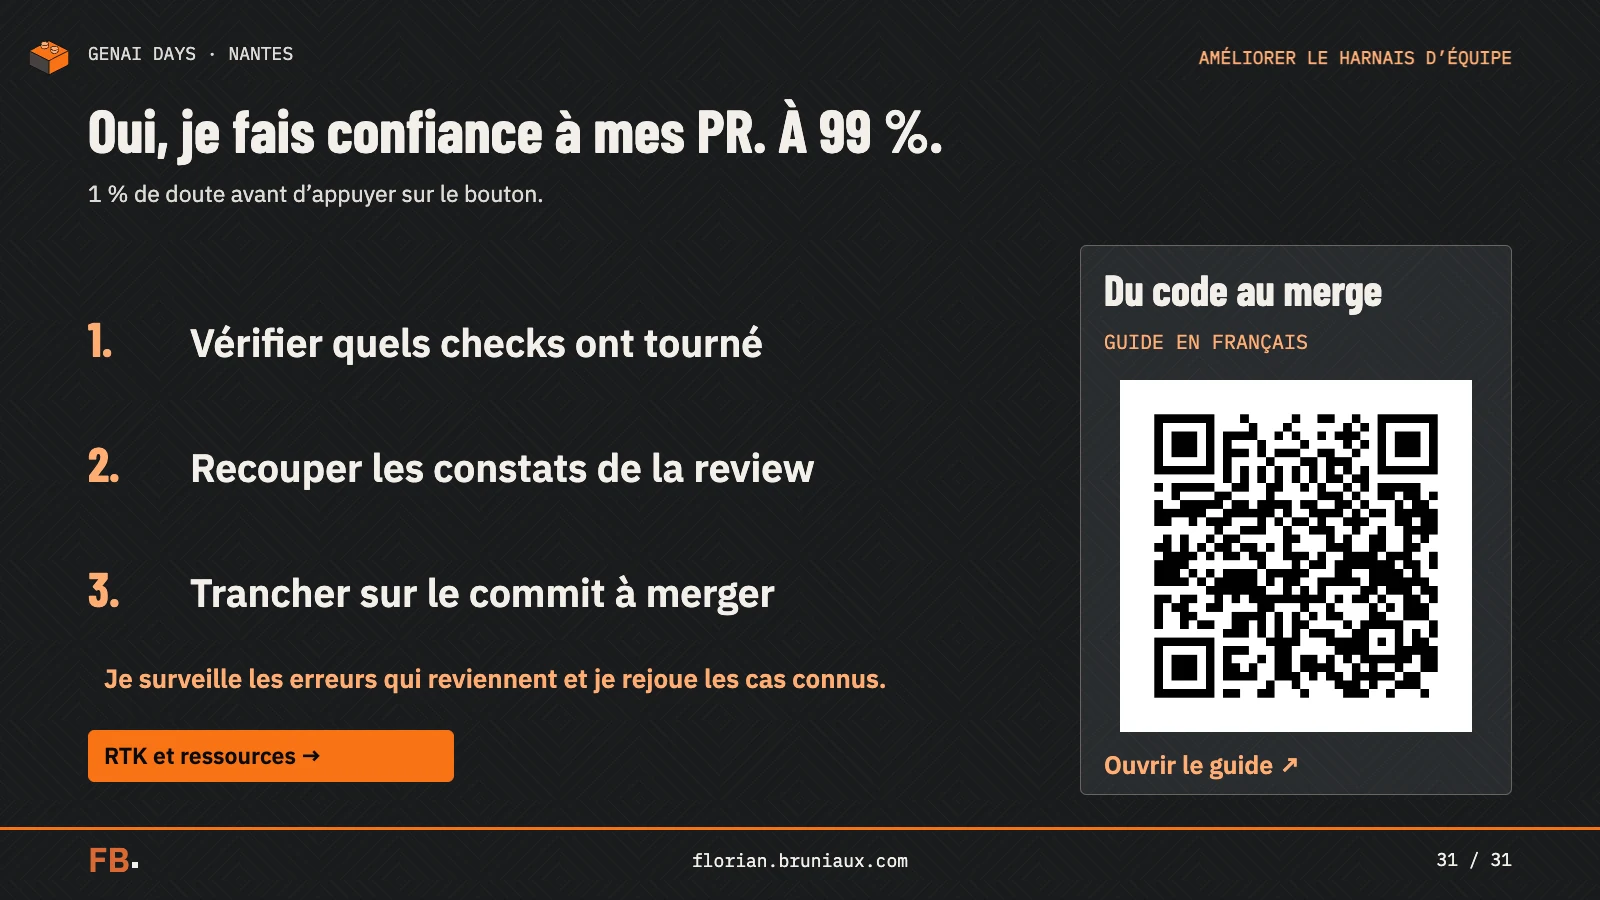
Aujourd’hui, je dirais que je fais confiance à mes PR à 99 %. C’est mon appréciation personnelle. Je n’ai pas mesuré un taux de fiabilité de 99 %. Avant de merger, je regarde les checks, les retours de review et le commit auquel ils se rapportent.
Sur la #4518, le deuxième commit avait une CI verte et la page d’arrivée demandait encore une correction. Si cet écart revient, l’équipe peut repartir de ce cas pour écrire un check et vérifier, en le rejouant, s’il détecte bien le problème.
La conclusion et les guides associés · Slide 31.
Exercice · Rejouer un contrôle sur votre PR
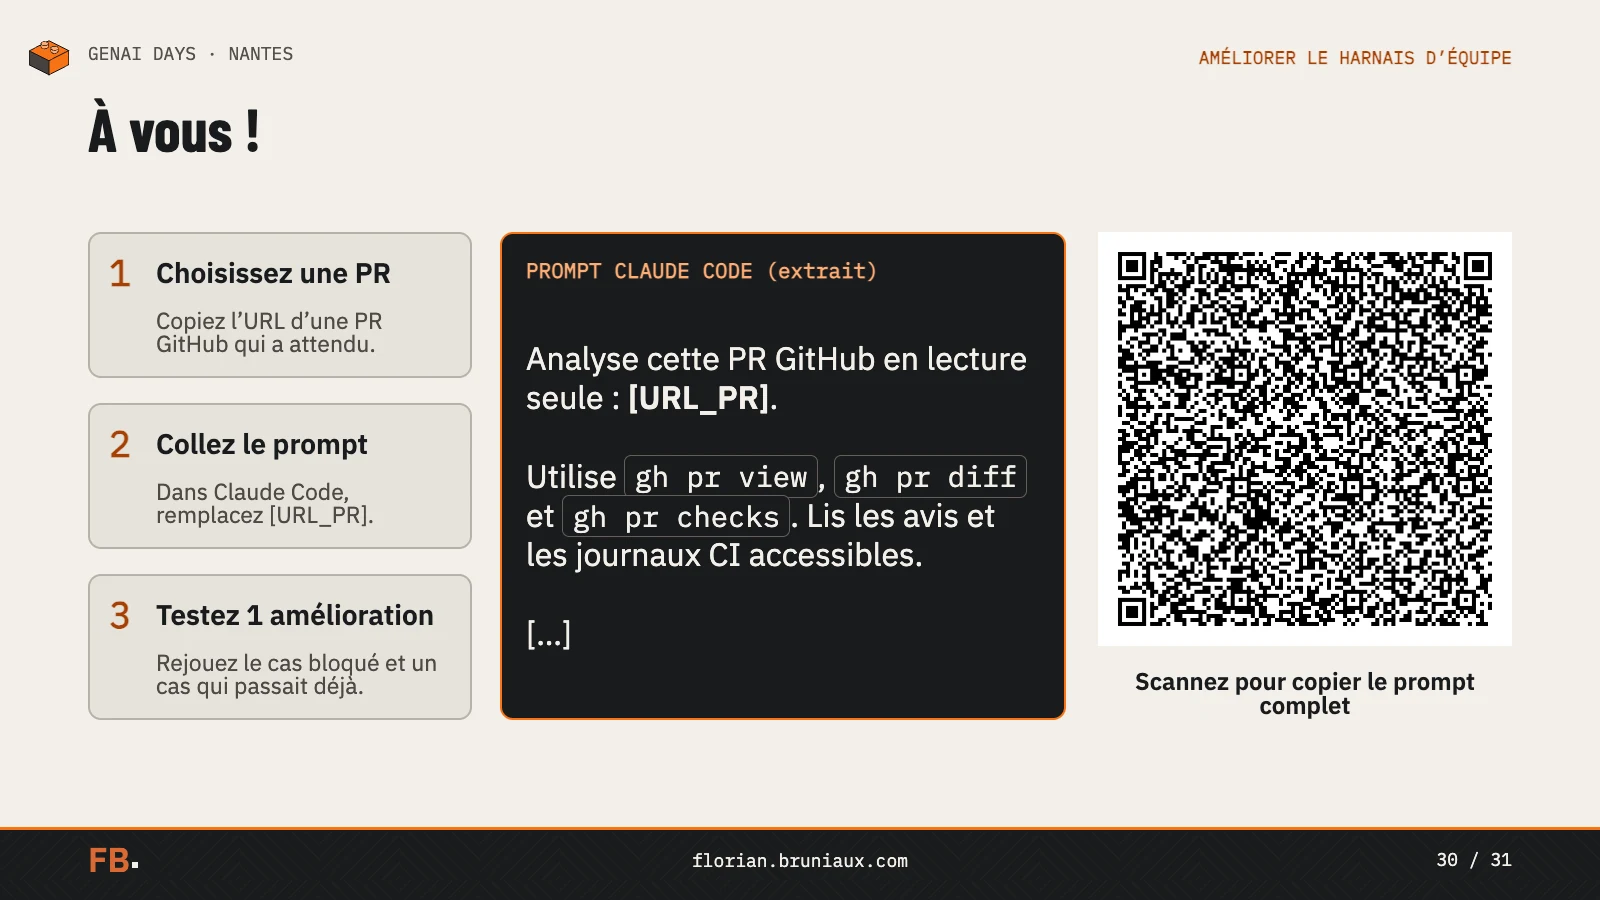
Je commencerais par une PR mergée qui a attendu un check ou une review. Je vérifie que les checks, les commentaires et les journaux sont encore accessibles. Donnez le prompt à un agent qui a accès au repo en lecture, par exemple Claude Code avec gh authentifié, puis remplacez [URL_PR] par le lien. Si un run manque ou qu’un commentaire ne mentionne pas sa révision, indiquez-le dans le rapport.
Analyse cette PR GitHub en lecture seule : [URL_PR].

Utilise gh pr view, gh pr diff et gh pr checks. Lis les avis et les journaux CI accessibles.

1. Date l’ouverture, les commits, les checks, la review et le merge. Associe chaque résultat à son SHA.
2. Repère la plus longue attente observable. Cite les traces et distingue les faits, les hypothèses et les données manquantes. Sépare le délai du temps de travail humain.
3. Propose 1 amélioration du harnais. Indique la mesure et le résultat attendu en rejouant ce cas et un cas comparable qui passait déjà.
Relisez le rapport avec les onglets Commits et Checks ouverts. Demandez à l’agent de distinguer les changements de SHA des relances d’un même run et de citer les deux événements qui encadrent la plus longue attente observée. Si le rapport attribue cette attente à un reviewer sans preuve, ramenez-le au délai entre événements. Choisissez une seule amélioration, notez le résultat attendu, rejouez le cas qui coinçait et un cas comparable déjà valide. Le compte rendu doit permettre à quelqu’un d’autre de refaire le contrôle.
Exemple de restitution sur la #4518
| Champ | Ce que je noterais |
|---|---|
| Périmètre | Révision A et base utilisée pour le diff. |
| Trace | Le job Vitest échoue sur A. Le test de composant du menu admin cherche l’ancien nom accessible. |
| Limite | Le rejeu indique quels tests le sélecteur local aurait retenus. L’auteur rapporte un preflight indéterminé. |
| Délai | Inconnu dans cette fiche. Pour le chiffrer, relever les deux événements et leurs horodatages dans GitHub. |
| Modification à essayer | Associer le catalogue admin au test de composant du menu admin dans le mapping local. |
| Résultat attendu | Le diff A sélectionne le test de composant du menu admin. Un diff voisin sans rapport garde la même sélection. Je lance ensuite le test pour vérifier le résultat. |
Retrouver tous les supports
Les 50 folios du deck final V11.17 restent consultables ici : les 31 slides du talk, les 15 annexes techniques et les 4 références Dev With AI. Cliquez sur une miniature pour agrandir la slide dans cette page. Les flèches permettent de passer à la suivante ou à la précédente.
Le talk · 31 slides
Les annexes techniques · 15 slides
Les 15 folios A détaillent les traces de CI, la sélection des tests, le chargement des règles et les cas de review.
Les références Dev With AI · 4 slides
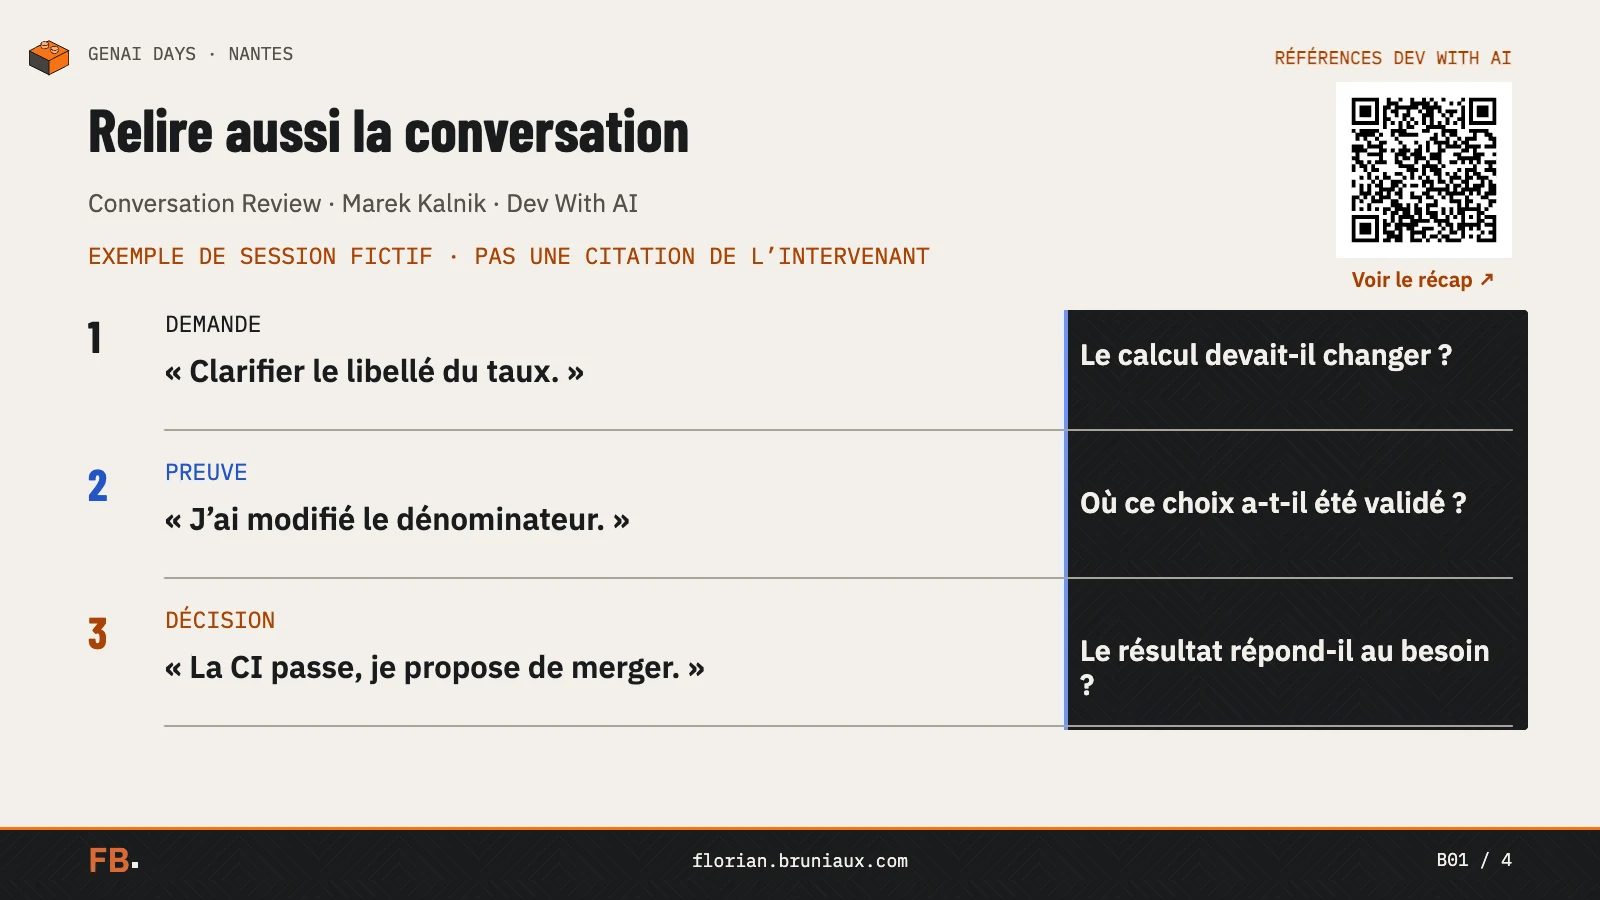
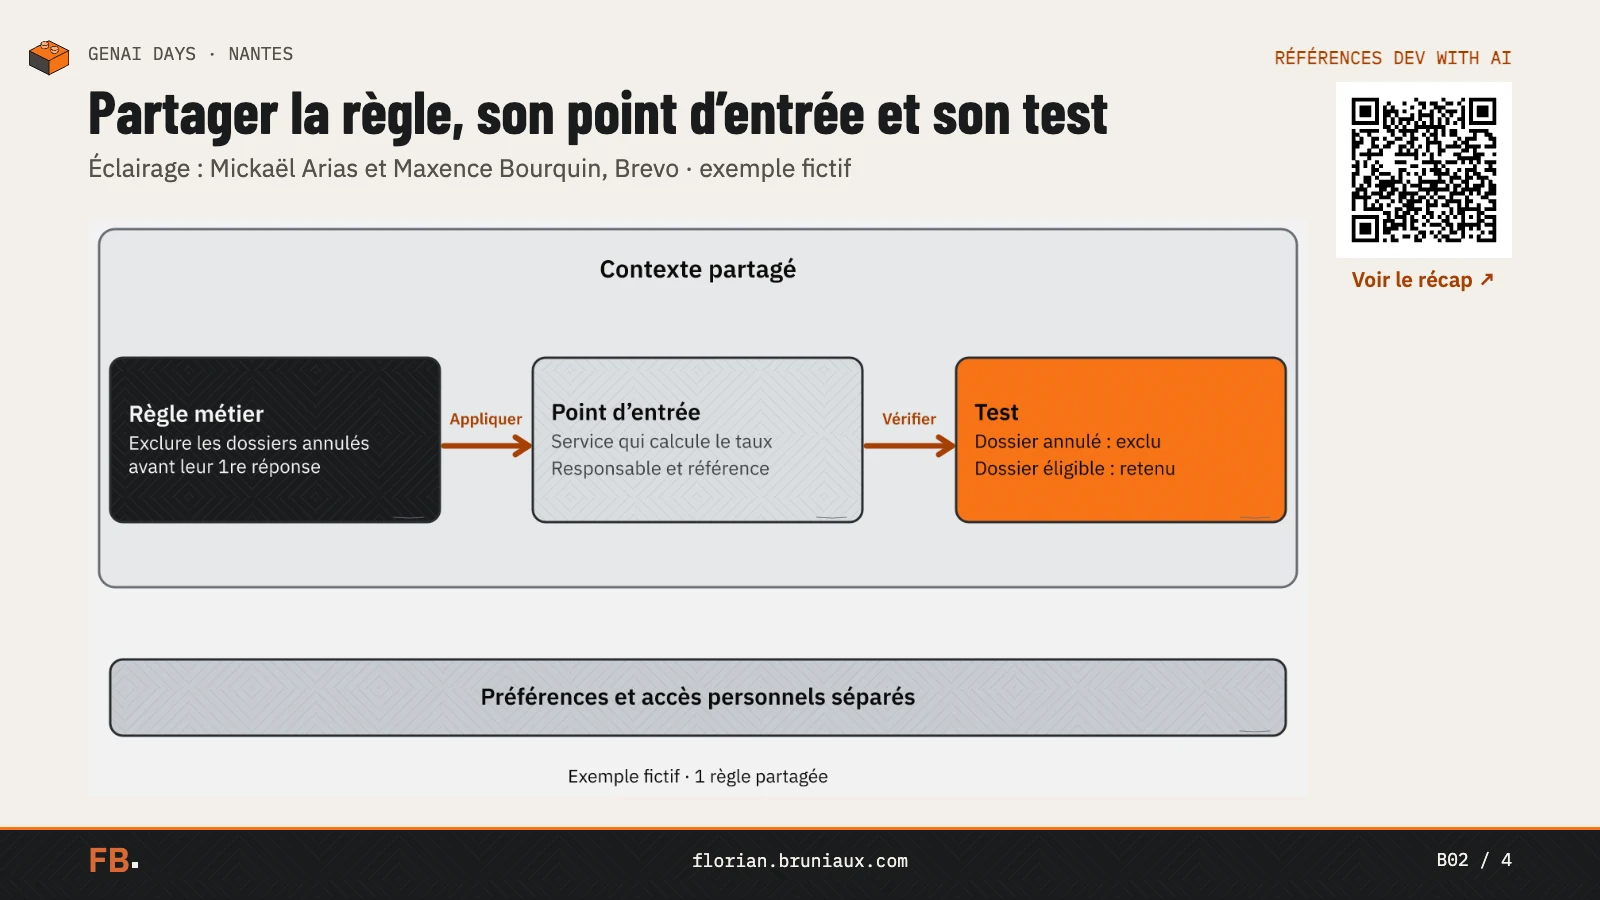
Les 4 folios B reviennent sur la conversation de l’agent, le partage d’une règle et le rejeu d’un contrôle.
Ces repères viennent de Dev With AI. Les exemples de taux de réponse sont fictifs. Conversation Review de Marek Kalnik · Retour de Brevo · Intervention de Tugdual Grall et Xavier Noya.
Approfondir les vérifications
Ces volets conservent les détails du guide : commandes, exemples, traces disponibles et limites des résultats. Les liens vers les folios ouvrent le support correspondant.
Accès direct aux sections détaillées :
- Ce que la PR attend avant le merge
- Le menu admin et le preflight · Le coût des allers-retours
- Les trois commits de la #4518
- Deux déclencheurs à revoir
- Aiguiller la review et borner les corrections · Faire parvenir la question au métier
- De la règle générée à son effet · Le harness cible
- Refaire l’exercice sur votre PR
- Pourquoi je parle de 99 %
- Annexes techniques · Références Dev With AI
Le contexte, les attentes et la méthode de comptage
Ce que la PR attend avant le merge
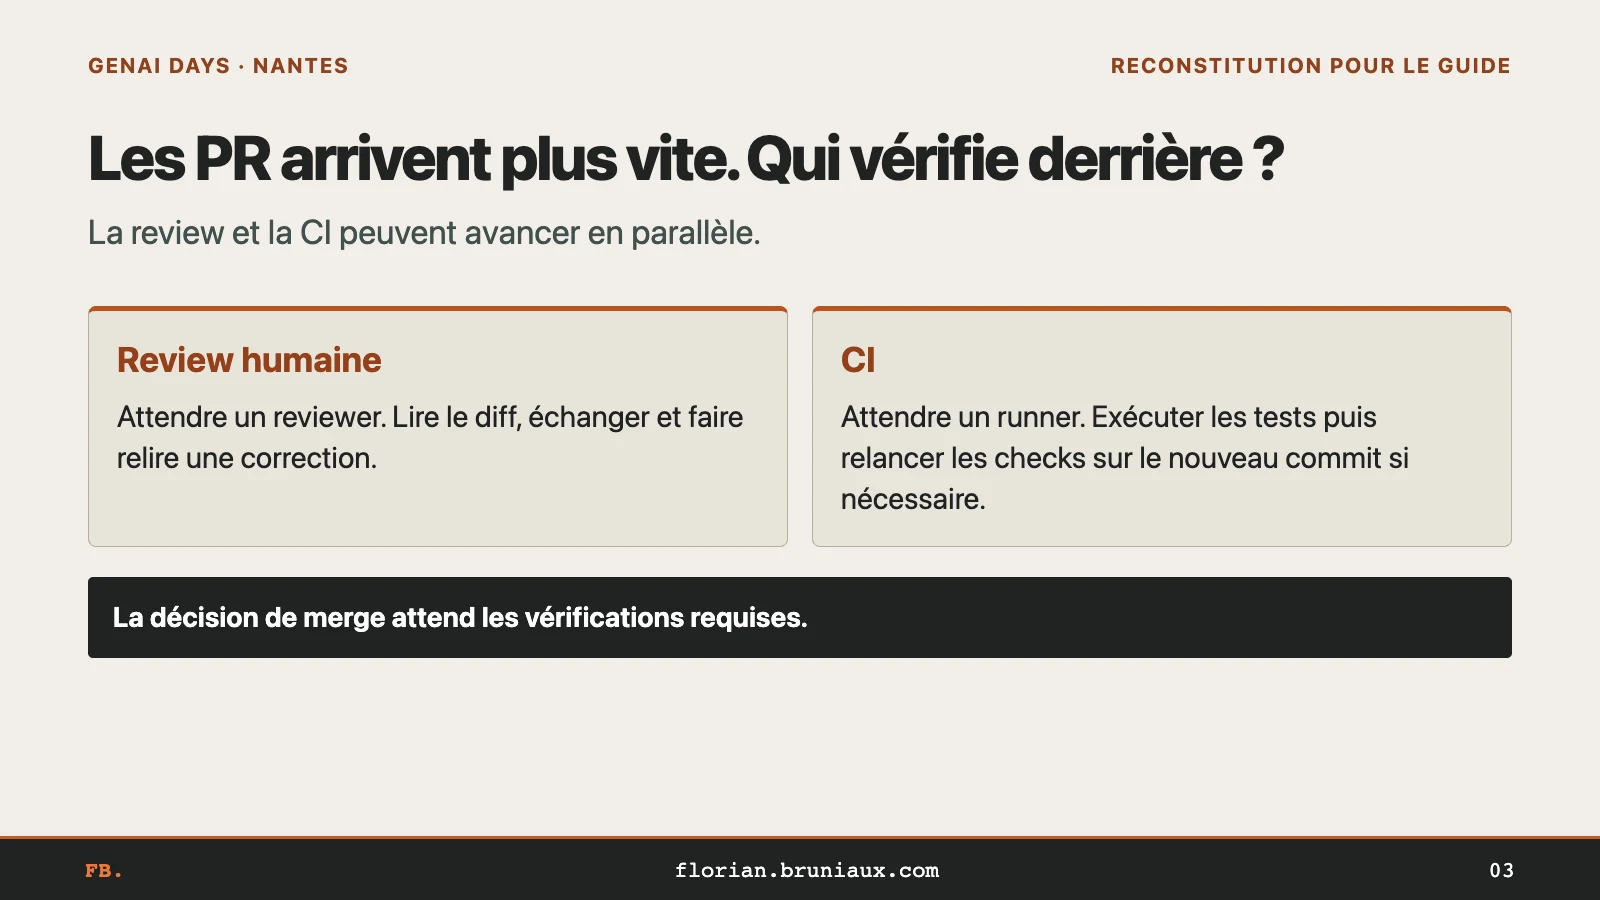
Avant le merge, une PR peut attendre un reviewer ou un runner. Une correction peut faire repartir les checks et la review.
Je distingue l’attente d’un reviewer du temps qu’il passe à lire le diff et à traiter les retours. Même distinction en CI entre le temps en file d’attente et la durée du run. La review et la CI peuvent avancer en parallèle. Quand une correction arrive, je compare les versions pour savoir quels résultats couvrent encore le diff.
Pour compter les reprises après un échec de CI, je groupe les tentatives admissibles par SHA. Je compte une reprise quand le check CI Success échoue au moins une fois sur un SHA et que GitHub évalue ensuite un autre SHA, que celui-ci passe ou échoue. Je prends l’ordre des premières exécutions observées. Une relance sur le même SHA se compte à part. Même si elle passe, je garde l’échec initial lorsqu’une autre révision suit. J’écarte les tentatives sans jobs exploitables et les annulations seules. Ce comptage ne renseigne ni la cause de l’échec, ni sa correction, ni le temps de travail. Méthode et périmètre du comptage, A13.
Mon parcours chez Méthode Aristote
J’ai repris le développement chez Méthode Aristote après avoir dirigé des équipes tech. Aujourd’hui, j’aide des équipes à intégrer l’IA dans leur travail. Je maintiens le Claude Code Ultimate Guide et je contribue à RTK. J’ai choisi le menu de notre application de soutien scolaire parce qu’on peut juger le résultat sans connaître son architecture.
Chez Aristote, mes dirigeants m’avaient donné une grande latitude pour essayer l’IA, dans le produit comme dans notre façon de développer. Je pouvais multiplier les licences et consacrer du temps aux essais. Des collègues côté produit ont commencé à envoyer leurs propres PR. Sur le cas que je décris, je n’avais pas formé l’auteur au TDD. J’attendais de l’agent qu’il prenne en charge les tests. Quand ces PR ont commencé à s’accumuler, il fallait aussi que j’améliore les contrôles qui encadraient leur travail.
Chez Aristote, je pouvais consacrer du temps et du budget à la R&D sur le harness, pour comparer et rejouer. J’estime que cela prenait au moins 50 % de mon temps. L’équipe produit avançait avec les outils et les règles que je préparais. Ce temps senior fait partie du coût de cette façon de travailler.
Pendant le talk, j’annonce aussi que je rejoins le réseau des ambassadeurs Claude. Je compte organiser ou coorganiser des événements, surtout à Paris.
Sur le poste, le hook de Claude Code peut appeler rtk git status pour filtrer la sortie de git status avant de la renvoyer à l’agent. RTK open source · Offre RTK Pro.
Le menu admin, le vocabulaire et les commandes du preflight
Deux changements dans le menu admin
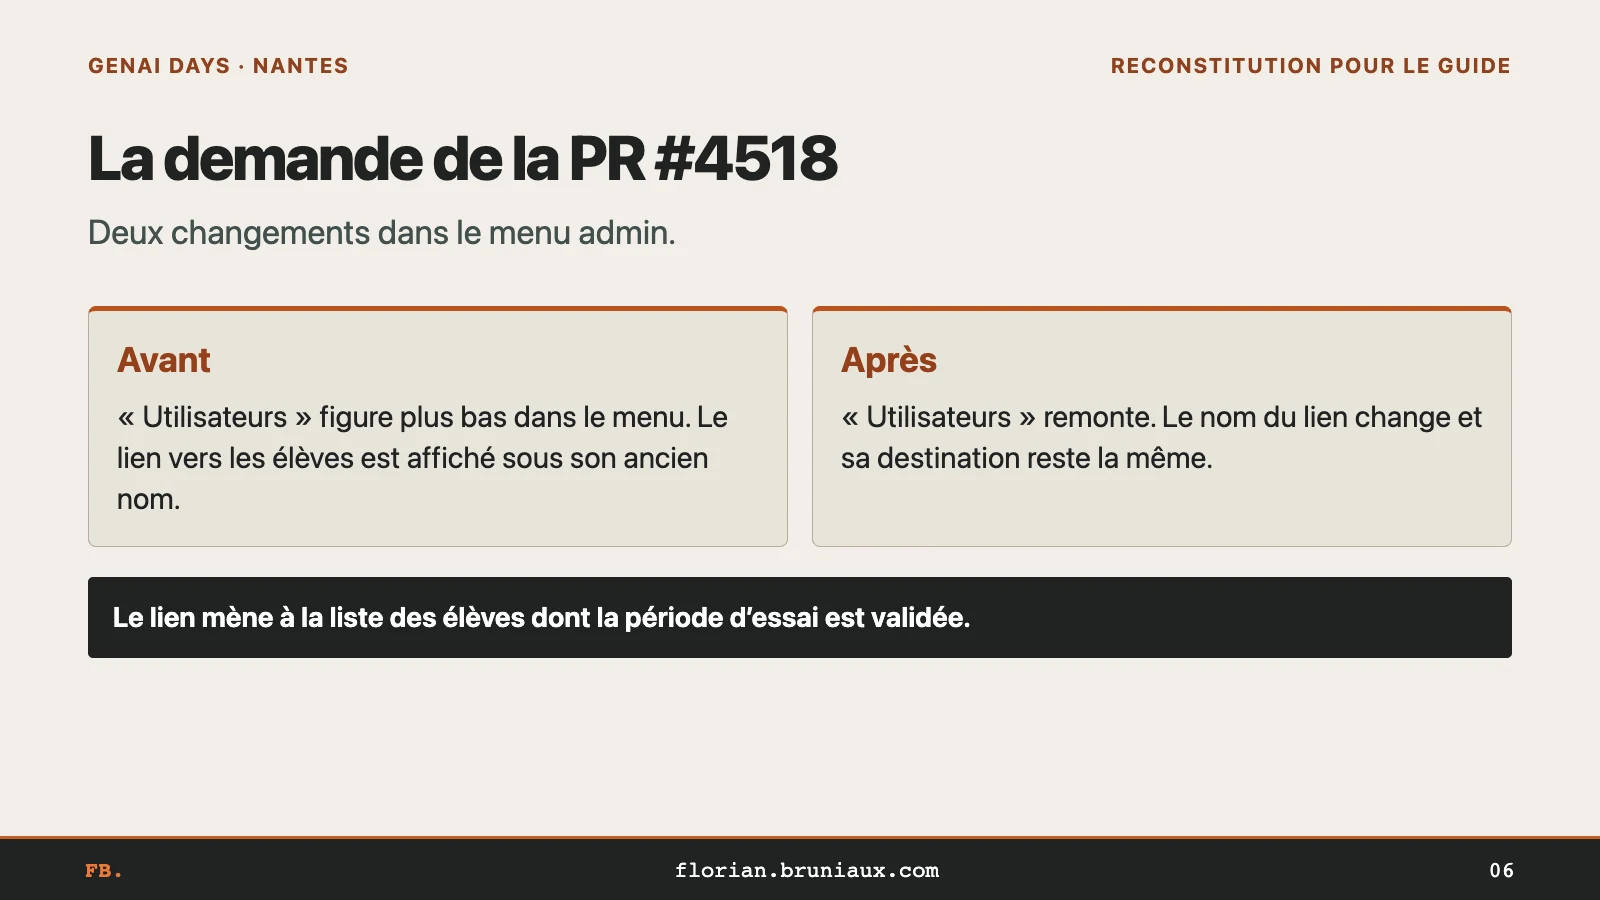
La #4518 remonte « Utilisateurs » et renomme un lien. Le changement de libellé se vérifie aussi dans le titre et l’état vide de la page cible.
Le 23 octobre 2026, la PR remonte « Utilisateurs » dans le menu des admins et super admins. Elle renomme aussi le lien vers la liste des élèves passés à l’accompagnement payant après leur période d’essai. La route, les droits et les critères d’inclusion restent les mêmes. Quand je relis le diff, je vérifie la place de « Utilisateurs », puis je suis le lien renommé jusqu’à la page. Les reconstitutions masquent les libellés exacts.
Le vocabulaire du talk
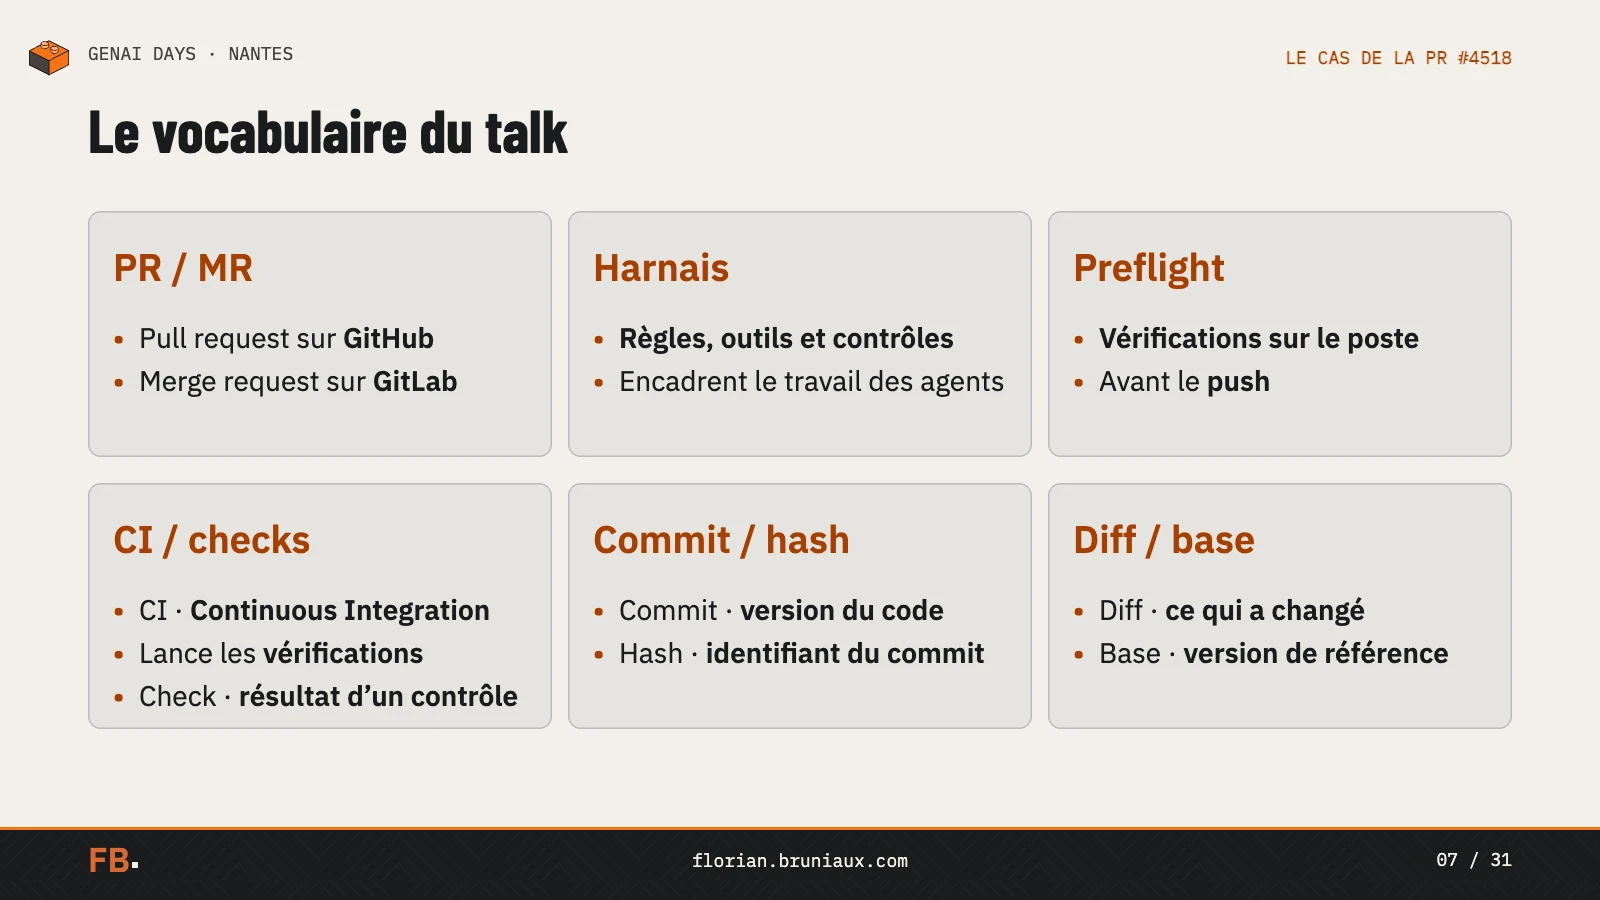
Une PR propose un changement à l’équipe avant de l’intégrer dans la branche cible. GitLab appelle cette proposition une MR. Le diff indique les changements par rapport à une base. Le SHA identifie le commit examiné. Le preflight désigne ici les vérifications lancées sur le poste. Les checks sont les résultats publiés sur la forge. J’appelle harness les consignes, les outils, les permissions et les contrôles qui encadrent le travail des agents.
Le coût des allers-retours entre le poste et la CI
Les licences des agents avaient fait partie de nos discussions budgétaires. La facture des runners GitHub Actions et Namespace nous a davantage surpris. Avec les PR et leurs correctifs, on relance des tests, des builds et des reviews. Le coût s’accumule même sur un changement de menu.
J’essaie donc de détecter ces échecs en local, avant le passage en CI, avec les checks qui peuvent tourner sur le poste. Avec la sélection par diff, je cherche aussi à réserver les déploiements front aux changements qui les justifient. Pour savoir si ce réglage aide, je dois regarder le temps local, l’attente en CI, les exécutions évitées et les défauts qui passent à travers.
Pendant le talk, je décris des pointes de 80 à 100 sessions Claude Code ou Codex ouvertes sur mon poste, avec des conteneurs. Dans cet usage, même mon M5 Max de 128 Go arrive à saturation. C’est ce qui explique l’équipement que j’ai choisi.
Ce que le preflight sélectionne sur le poste
Dans le repo Aristote, je lance explain pour voir quels contrôles le preflight retient et pourquoi. quick lance les contrôles locaux sélectionnés, dont des tests Vitest ciblés et des tests de contrat Node. La sélection peut aussi inclure ESLint ou le typecheck. Sur un diff applicatif, full lance la suite Vitest. Dans ce dispositif, les tests d’intégration PostgreSQL tournent à distance. Les tests E2E passent par un workflow distinct que l’équipe lance à la demande.
pnpm ci:local explain --base origin/develop
pnpm ci:local quick --base origin/develop
pnpm ci:local report --format markdown
Le sélecteur lit les changements depuis la merge-base, y compris les fichiers staged, unstaged et non suivis. Le mapping associe les chemins modifiés aux tests correspondants. Le moteur ajoute les tests modifiés qu’il reconnaît. Même avec un PASS, je lis le périmètre couvert, y compris si le moteur réutilise un rapport éligible. FAIL indique un échec et SKIPPED une exclusion. Avec UNKNOWN, le moteur n’a pas pu conclure, par exemple si la base manque ou si des fichiers d’environnement empêchent l’isolation.
Je regarde aussi combien de tests ont tourné. Dans le preflight Aristote relevé le 22 octobre, si le rapport Vitest manque ou compte zéro test exécuté, le résultat passe en UNKNOWN, même quand la commande renvoie un code de sortie 0.
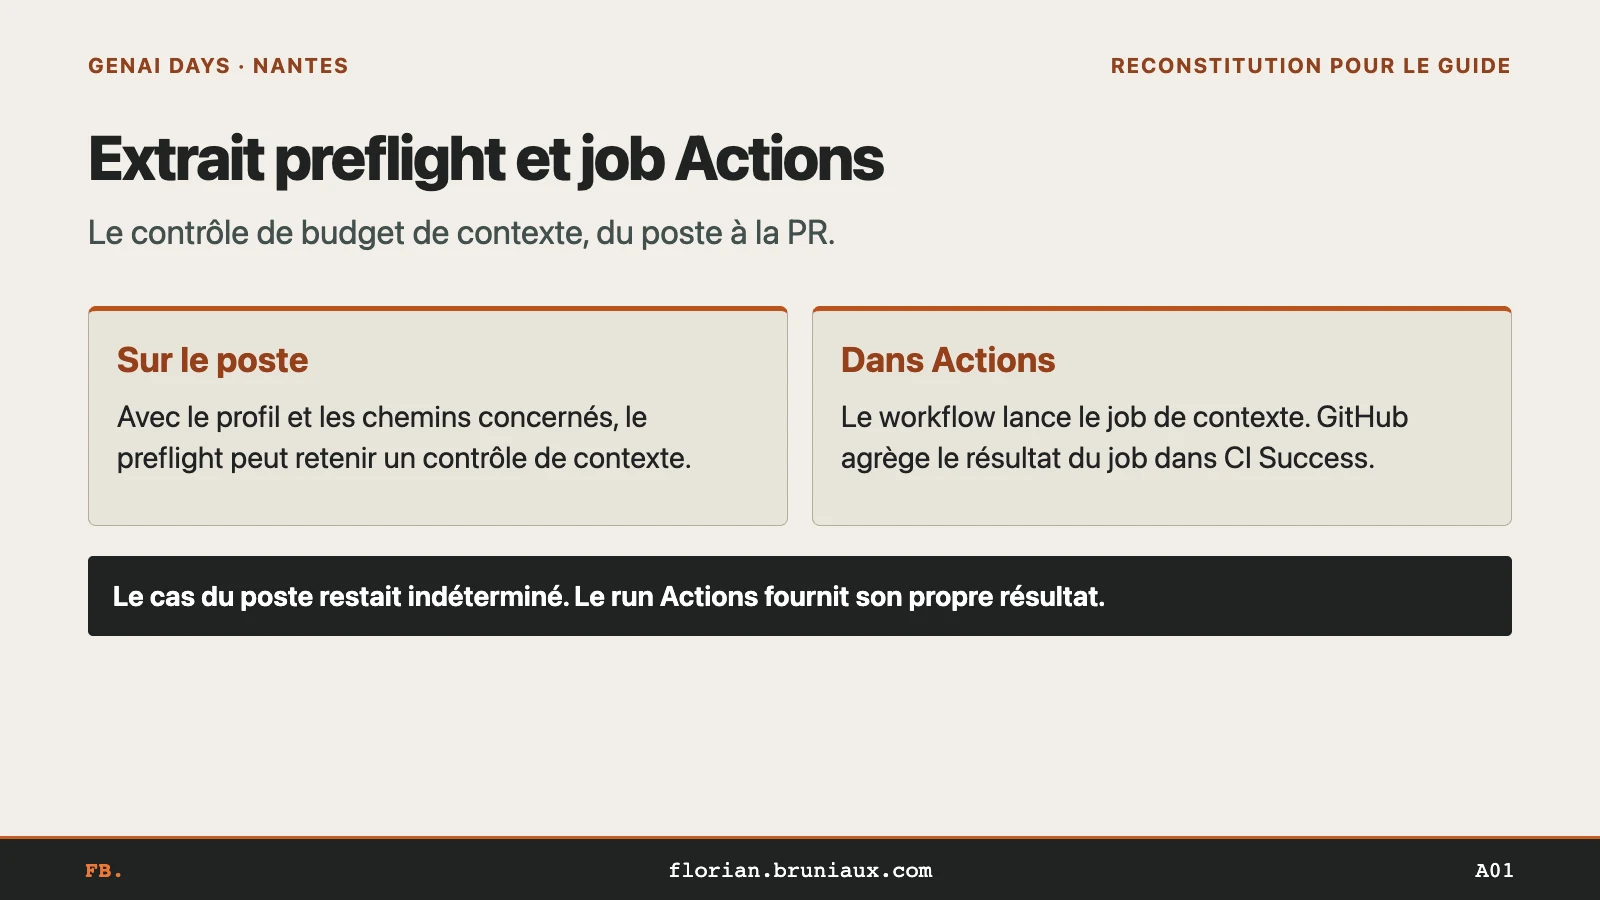
Je lance ce preflight à la demande. Les hooks Git ont leurs propres déclencheurs et GitHub Actions choisit ses jobs suivant les règles du workflow de la PR. Un rapport local indéterminé et un run Actions distinct, A01.
Les trois commits, leurs tests et la décision de merge
Trois commits, deux corrections et une décision de merge
Sur A, le test de composant du menu admin échoue. Après la correction du test et de la story sur B, la review relève deux écarts dans la page et la spec. C est le commit qui les corrige et que l’équipe merge.
Commit 1 · Le test de composant du menu admin cherche l’ancien libellé
Sur le commit A, l’auteur déplace « Utilisateurs » et renomme le lien dans les données du menu. Quand je rejoue les quatre chemins de ce diff dans le sélecteur local, il retient deux fichiers de tests unitaires du catalogue. Ces tests peuvent vérifier l’ordre des entrées et leurs libellés dans les données. Le test de composant Gestion, pourtant exécutable sur le poste, reste hors de la sélection.
Le replay indique quels tests le sélecteur retient. Pour l’exécution de l’auteur, je dispose de son compte rendu sur la PR : il rapporte des tests ciblés lancés directement et un preflight quick resté indéterminé à cause de fichiers dotenv.
Dans Actions, Vitest affiche Gestion en isolation. Le test cherche le lien par son ancien nom accessible alors que le composant affiche déjà le nouveau libellé. Le job qui fusionne les rapports Vitest fait remonter cet échec. Le workflow écarte Storybook sur A. Claude relève que la story cherche elle aussi l’ancien texte.
| Contrôle | Ce que je lui demande sur ce changement |
|---|---|
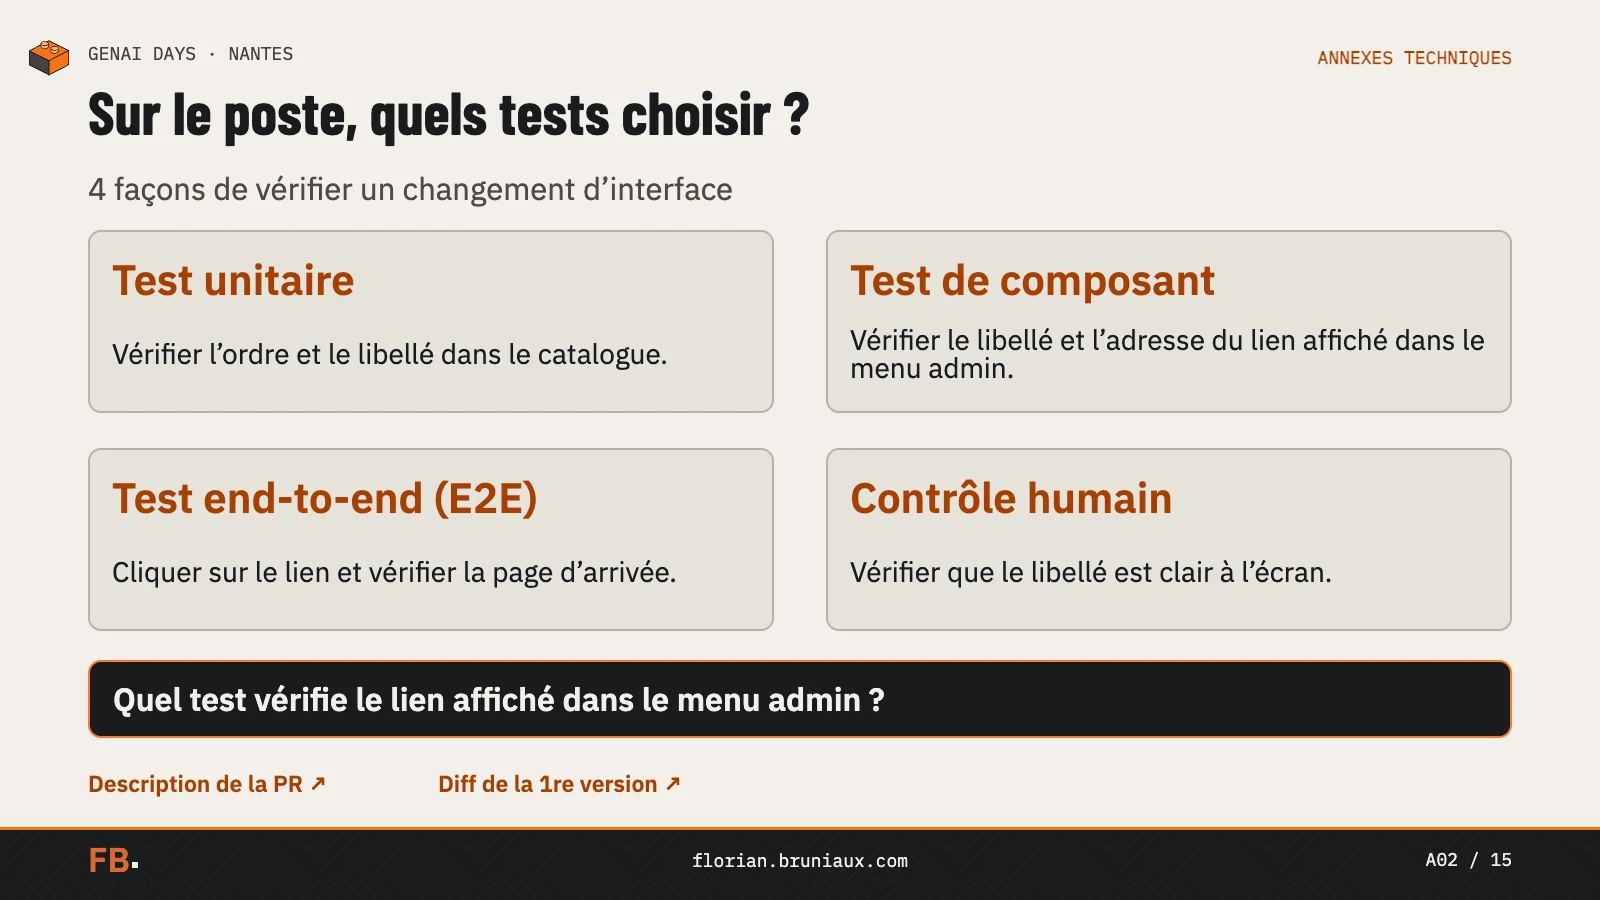
| Test unitaire du catalogue | Vérifier l’ordre des entrées et les valeurs des libellés dans les données. |
| Test de composant Gestion | Afficher l’écran en isolation, trouver le lien par son nom accessible et vérifier son href. Une interaction Storybook peut vérifier ce même contrat dans la story. |
| Test de composant de la page cible | Afficher la page et vérifier son titre et son état vide. |
| Test E2E | Ouvrir l’application avec un compte admin, cliquer dans le menu, puis vérifier la page effectivement atteinte et ce qu’elle affiche avec les données attendues. Ce parcours reste à établir pour la #4518. |
En regardant l’écran, je vérifie aussi que le libellé est compréhensible et que la page emploie les mêmes mots que le lien. Choisir un test, A02 · Rejeu de la sélection initiale, A09.
Retrouver l’échec du test de composant dans Actions
Le Gate lit le diff et choisit les jobs. Setup prépare leur exécution, puis leurs résultats remontent vers les checks de la PR. Pour retrouver l’échec du test de composant, j’ouvre CI Success sur le commit A et je lis le résultat de la fusion des rapports Vitest. Quand le Gate écarte un job, je lis la condition qui l’a écarté. Quand une assertion échoue, j’ouvre le test et le diff.
Sur le run final, le job de contexte IA compare les faits cités dans nos consignes aux sources du repo. Par exemple, il signalerait une consigne qui indique Next.js 16.2 si package.json déclare 16.3.6. Sur ce run, les mentions de Next.js correspondaient au repo. La CI a produit un plan pour Claude et Codex. Je vérifie le chargement des règles dans la trace d’une session. Le job Actions en annexe, A01 · Comment je vérifie le chargement.
Commit 2 · La CI passe, la review relève deux écarts
Sur le commit B, l’auteur remplace l’ancien locator dans le test de composant du menu admin et dans la story. Les deux cherchent le nouveau nom accessible et vérifient l’adresse du lien. L’auteur rapporte 8 tests ciblés du composant réussis après correction. Actions passe sur B, interactions Storybook comprises. La modification de la story a déclenché ce job sur ce commit.
La review de B relève que la page cible affiche toujours un autre libellé et que la spec décrit encore l’ancien menu. Les deux tests vérifient le texte et le href du lien dans le menu admin. Ces retours amènent le deuxième correctif sur la page et la spec. Détail du correctif test et story, A10.
Commit 3 · L’auteur aligne le menu, la page et la spec
Sur le commit C, l’auteur aligne le libellé du menu, le titre de la page et le message affiché si la liste est vide. Il actualise aussi la spec. Le test de composant du menu admin couvre le lien. Un autre test couvre le titre et l’état vide. L’auteur rapporte 127 tests unitaires ciblés et 35 interactions Storybook réussis dans la description finale. Dans Actions, je retrouve le run vert de C et le résultat du job Storybook.
Dans Files changed, GitHub montre le diff de la PR avec la base. La PR finale touche 9 fichiers et la slide en montre une partie. Pour reproduire la sélection initiale, je repars du premier commit et de ses 4 chemins. Vue du diff final agrandie, A11.
Quels checks et avis couvrent le commit à merger ?
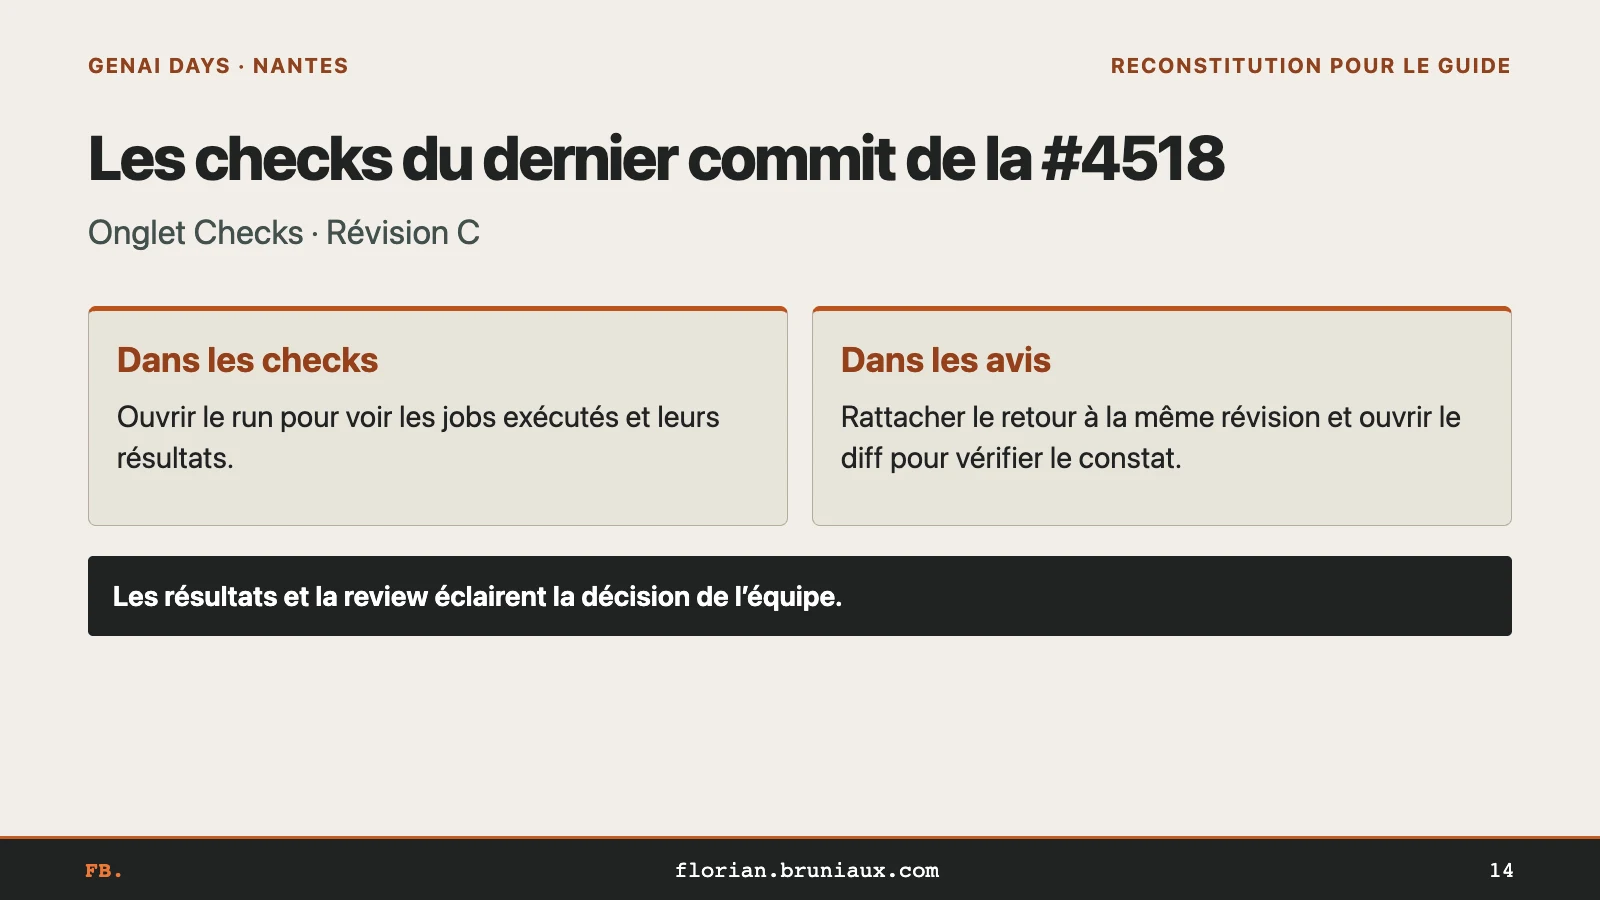
Je prends dans Commits le SHA de la tête à merger. Dans Checks, je retrouve les workflows CI et Claude Code Review du commit C. Le ruleset de develop relevé pour le talk exige CI Success, gitleaks et Changelog Gate. Un statut réussi indique que le workflow Claude Code Review a terminé. J’ouvre ensuite l’avis pour voir ce que Claude a relevé sur ce SHA.
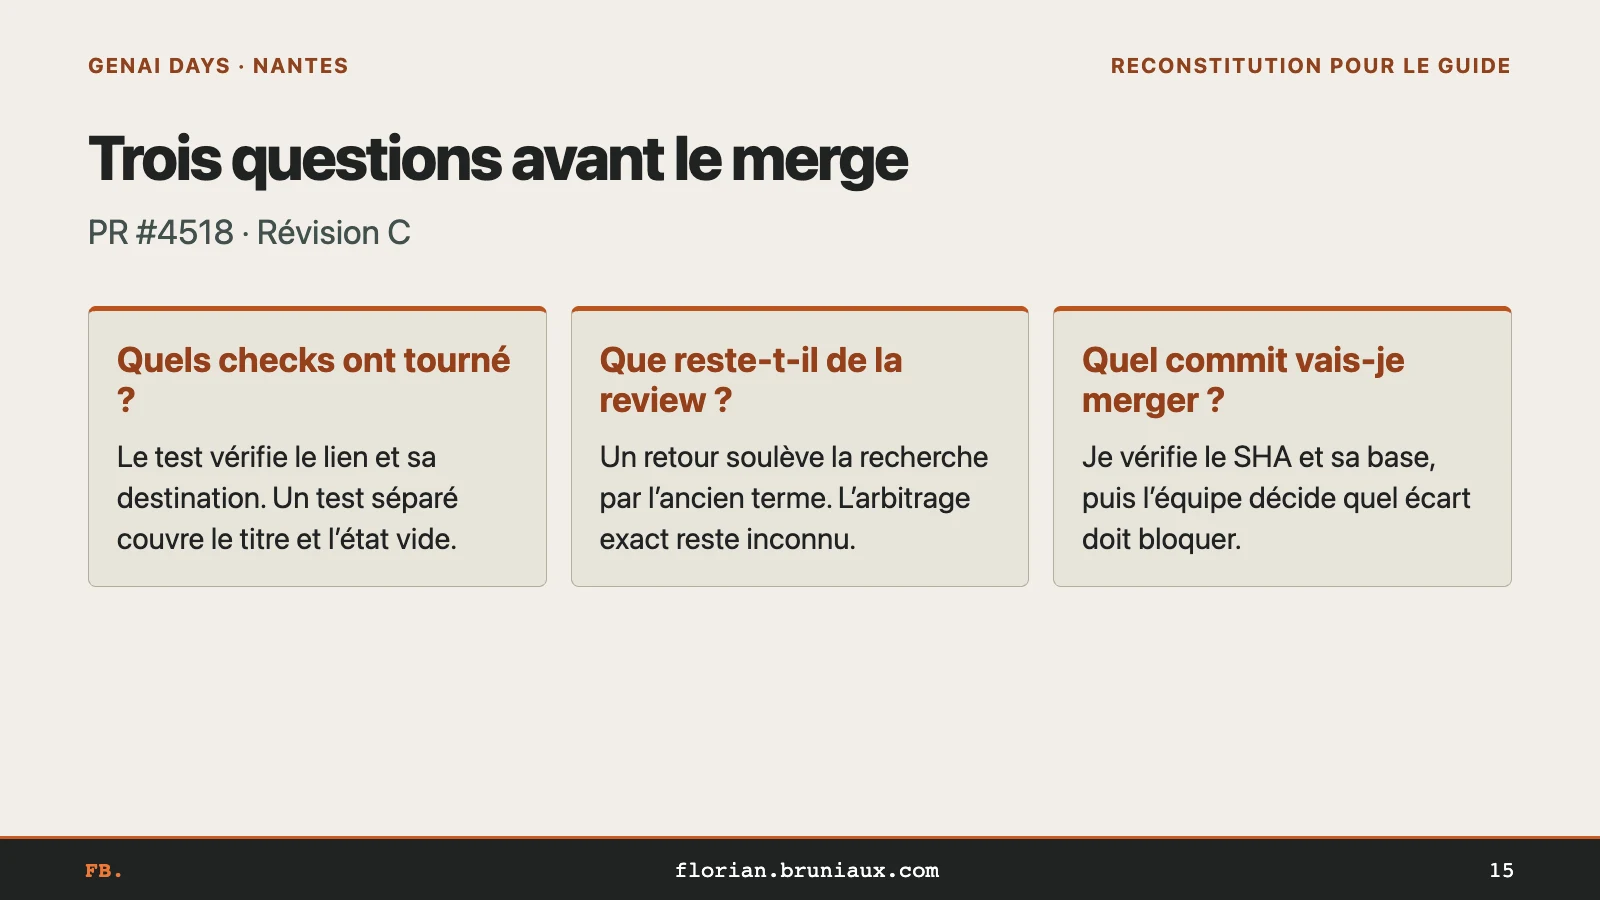
Je vérifie les checks requis et les retours qui demandent encore une correction ou un arbitrage. Sur C, la review finale reparle de la recherche par l’ancien terme. L’équipe a mergé ce commit. Dans les échanges que j’ai consultés, je ne retrouve pas le détail de sa décision sur cette suggestion.
Après un nouveau commit ou un rebase, je compare ce qui a changé depuis le SHA relu et je regarde aussi si la base a évolué. Une review peut rester utile pour comprendre une partie intacte du diff. Je vérifie séparément son périmètre, les preuves du nouveau commit et la validité de l’approbation dans la forge. Vérifier la version à merger, A06 · Review et révision, A07 · Résultats des trois runs, A12.
Les deux modifications de sélecteurs proposées
Deux déclencheurs à revoir après la #4518
Je préciserais le parcours dans la consigne et je testerais deux déclencheurs sur le premier diff, côté poste et côté Actions.
Je demanderais à l’agent de vérifier dans le menu admin l’ordre des entrées, le nom accessible du lien et sa destination, puis de lire le titre et l’état vide de la page cible. Dans son compte rendu, je veux voir les contrôles qu’il a pu faire et savoir, avant la review, s’il lui manquait un accès admin.
Je changerais aussi 2 sélecteurs. Le mapping local associerait le catalogue de navigation admin au test de composant du menu admin. Dans Actions, les chemins des données du menu déclencheraient Storybook même si le fichier de story n’a pas changé. Pour vérifier la proposition, je donnerais aux 2 sélecteurs les 4 chemins du diff A et j’attendrais la sélection du test du lien sur le poste et le déclenchement de Storybook dans Actions. Je rejouerais aussi un diff sans rapport pour repérer des déclenchements inutiles. Le replay du sélecteur indique les checks qui partiraient. Pour savoir ce qu’ils détectent, je lance les tests sur le commit concerné.
En mode configuration, ctxharness doctor --host both --scope project inspecte les fichiers du projet pour Claude Code et Codex. Pour savoir si le test de composant du menu admin ou les interactions Storybook se déclencheraient, je rejoue le diff dans le sélecteur concerné. Diagnostic de configuration dans ctxharness v0.6.0 · Configuration, session et rejeu.
L’aiguillage, les cas métier et les corrections bornées
Aiguiller la review et borner les corrections
Je donne le parcours et les limites aux reviewers, puis je traite leurs retours sur la même version. L’équipe fixe l’autorisation et le point d’arrêt.
Décrire le changement et les tests dans la PR
Dans le résumé de la #4518, je cherche les deux changements du menu et les personnes concernées. Le bloc technique donne le point d’entrée, les tests lancés, le résultat du preflight et les contrôles qui restent à faire. Le reviewer peut utiliser ce bloc pour orienter sa lecture du diff et retrouver les résultats à vérifier. La description finale contient ces informations. Je n’ai pas de trace de la façon dont l’agent s’en est servi.
La description s’adresse à l’équipe et à l’agent qui reprend le travail. Je veux comprendre le changement produit en un coup d’œil, avec un diagramme du parcours ou des échanges entre composants si cela aide. Je garde aussi les détails techniques, les tests et les traces du harness local, avec des screenshots quand il faut juger le rendu.
Qui relit le texte d’aide et la médiane ?
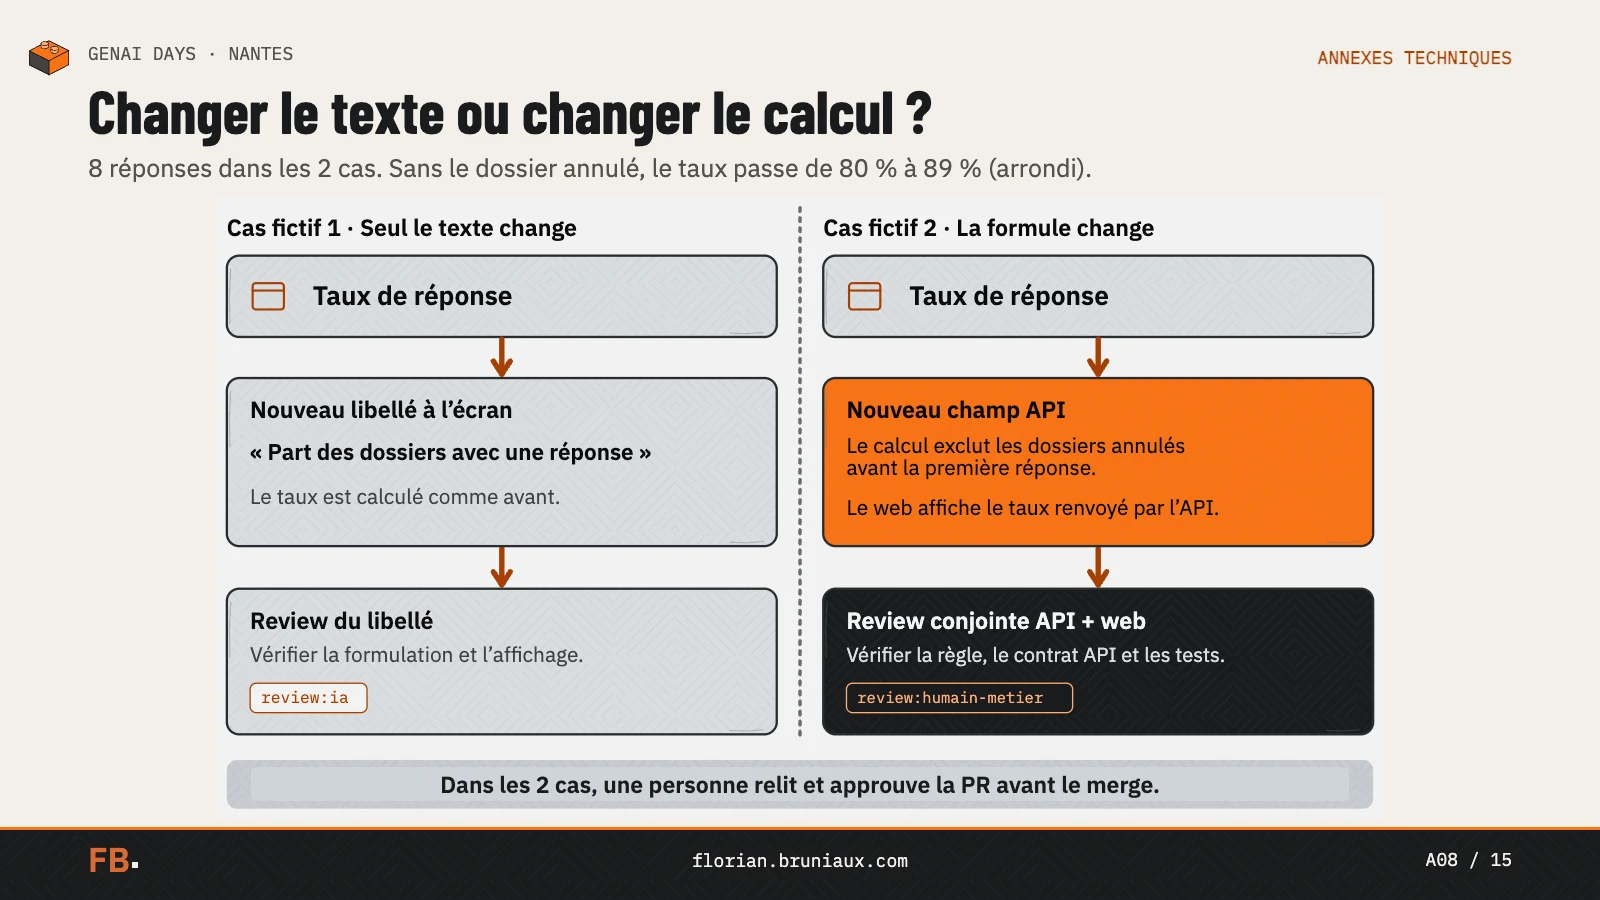
Deux MR de statistiques sur un autre produit m’ont aidé à préciser notre règle de review. La première changeait un texte d’aide côté web. Une MR API traitait déjà la formule. Il fallait donc relire le texte et vérifier le rendu, puis demander un avis métier si la formulation prêtait à confusion. Après le rebase, j’ai retrouvé un contrôle d’équivalence et un pipeline vert sur la nouvelle tête.
La seconde MR affichait une médiane ajoutée par l’API. Le métier devait vérifier le sens de la donnée. Le reviewer technique devait suivre la valeur d’une MR à l’autre, y compris quand elle manquait ou valait zéro. Les tests front utilisaient une API simulée. Après correction, le pipeline était vert et l’équipe a demandé une nouvelle review. Je n’ai pas reconstitué la suite jusqu’au merge de cette MR web.
Le label indique la compétence à mobiliser. La profondeur de review se décide à partir du diff, des dépendances, de la CI et des discussions. Dans le relevé présenté, un rapport merge-gate lancé manuellement pouvait recommander une review complète dans les deux cas. Il restait à choisir qui la ferait. Quand un reviewer corrige le classement, je garde son retour pour revoir la règle à partir de ce cas. Quatre cas d’aiguillage, A15 · Changer un texte ou un dénominateur, A08 · Relire la conversation si la demande a changé en route, B01.
Si le calcul lui-même change, je demande au métier de valider la définition et les cas attendus. Pour des droits d’accès ou une migration, je fais relire les effets sur les permissions, les données ou les intégrations concernées.
Réduire la part de PR qui attend une lecture humaine
Pendant le talk, je donne mon objectif : environ 2/3 des PR n’auraient plus besoin d’une intervention humaine dans la review. Je travaille encore sur cet aiguillage. À terme, je voudrais aussi que l’agent puisse décider du merge sur les PR qu’il sait qualifier.
Pour régler le classement, j’ai demandé à un CTO de relire les PR et de signaler celles où son intervention avait servi, celles où elle avait été inutile et celles que l’IA avait mal classées. Ce travail humain me donne de quoi corriger la règle. Changer un libellé, modifier une définition métier ou lancer une migration ne demande pas le même regard.
Faire parvenir la question à la personne qui peut répondre
Sur le CRM de statistiques évoqué pendant le talk, une PR peut être techniquement correcte et attendre une réponse sur le sens d’une donnée. Cette question s’adresse au produit ou au business. Elle peut rester coincée dans une discussion GitLab que ces personnes n’ont pas le temps de suivre.
Je cherche à faire remonter la question dans Slack, avec les choix possibles et le contexte pour décider. Une réponse sur le dénominateur d’un taux ou le sens d’une médiane permettrait à l’agent de poursuivre. Au moment du talk, je travaille encore sur cette intégration.
Relire les retours avec le diff ouvert
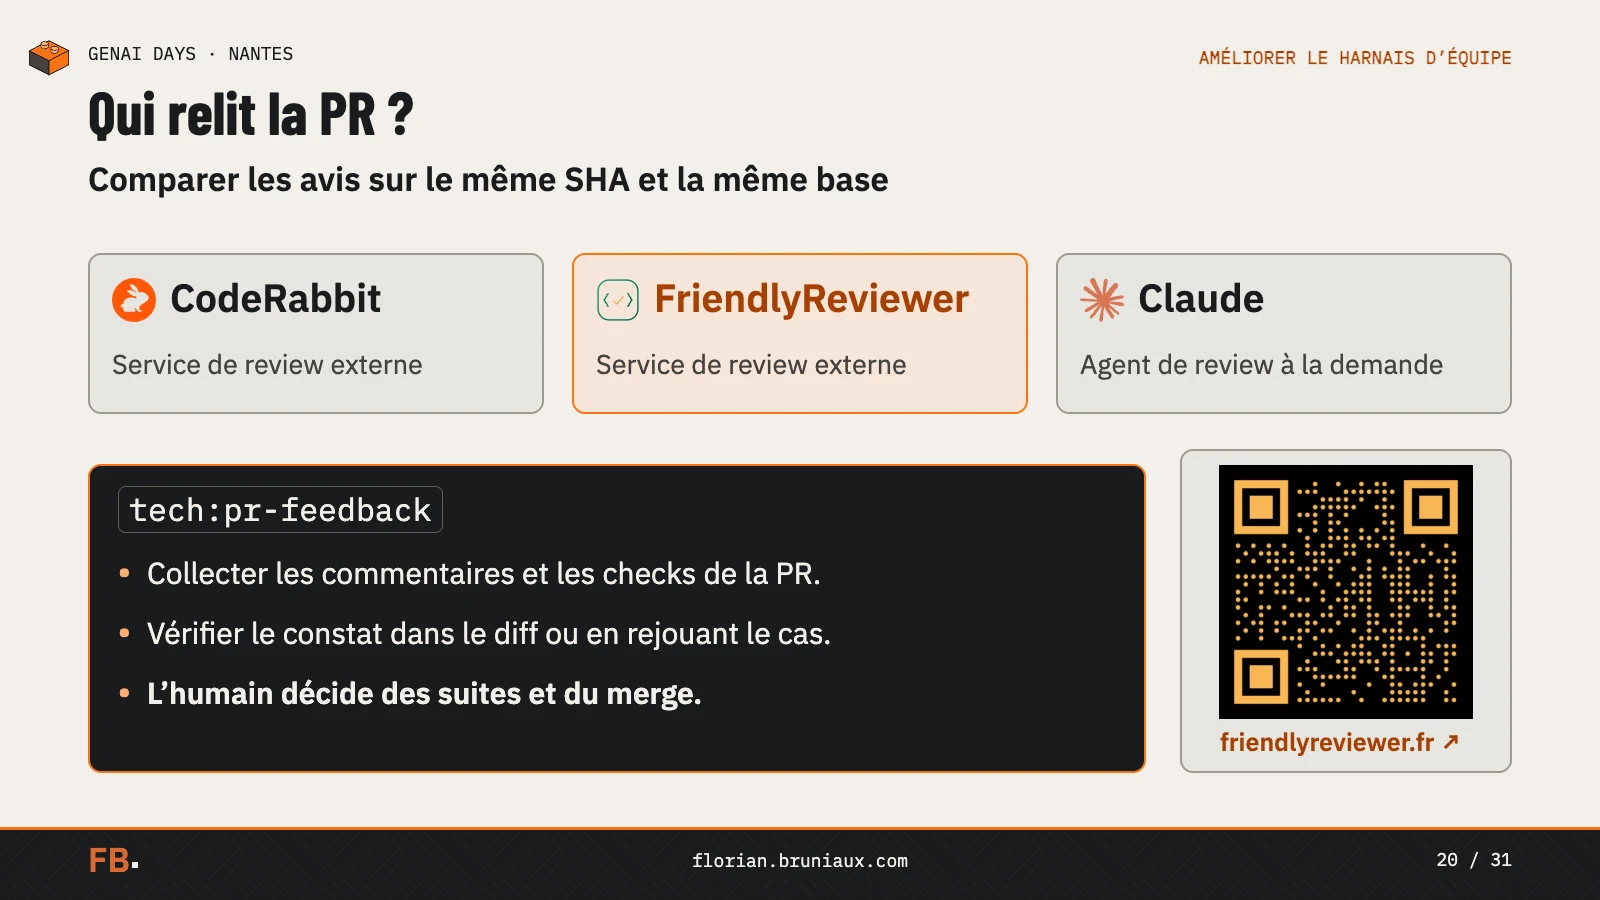
CodeRabbit et FriendlyReviewer sont deux services externes qui publient leurs avis sur la PR. Claude peut intervenir sur demande. Sur la #4518, Claude a relevé le locator de la story au premier tour, puis l’écart entre les libellés et la spec au deuxième. Le quota CodeRabbit a limité ses deux premières tentatives. Sa dernière synthèse couvrait 7 fichiers sur 9 et ne demandait aucune action. Je retrouve au moins 2 passages de FriendlyReviewer. Certains commentaires ont changé depuis leur publication, ce qui empêche de recompter les passages avec certitude.
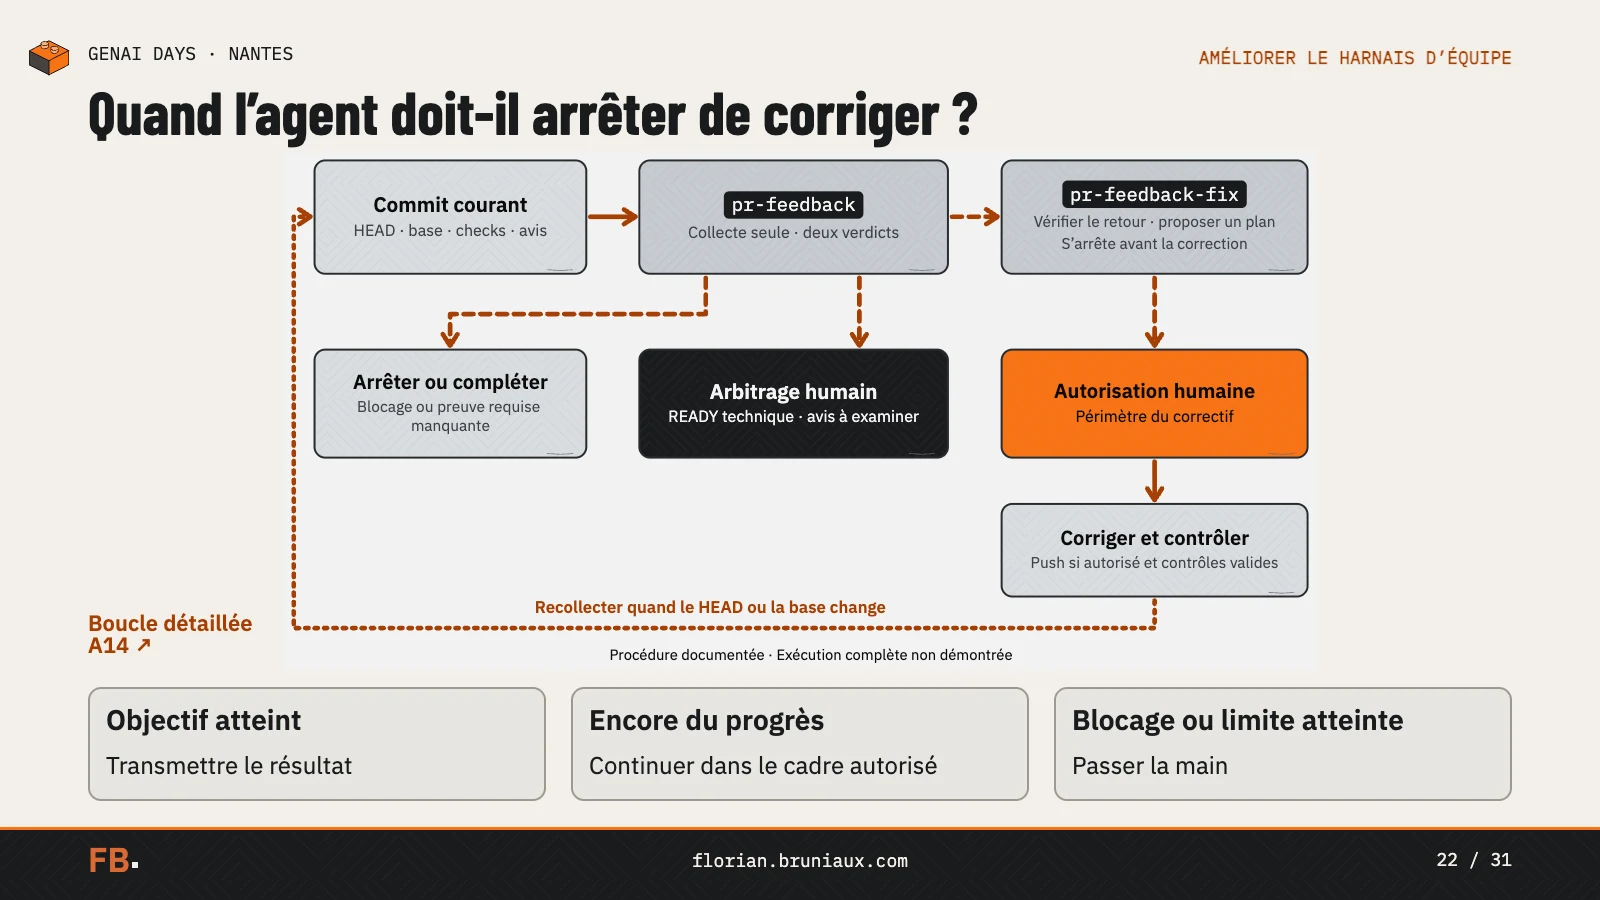
tech:pr-feedback peut rassembler les checks et les avis pour le SHA et sa base. Je regroupe les retours en double, je vérifie les constats dans le diff et je transmets les désaccords à la personne qui peut trancher. Je ne sais pas si quelqu’un a utilisé ce skill sur la #4518. Les retours de Claude figurent dans l’historique de la PR. FriendlyReviewer.
Je collecte les retours toutes les semaines ou tous les 15 jours, sur des lots de 50 ou 100 PR, pour repérer ce qui revient. Je regarde les allers-retours et les commentaires qui portent sur les tests ou la sécurité. Un problème récurrent me donne un cas à rejouer et une piste pour modifier une règle, un skill ou un contrôle.
Quand l’agent repère un défaut du harness, il crée souvent une issue avec son diagnostic et sa suggestion. Je reprends ensuite ces issues pour croiser les cas avant de choisir le correctif. Des signalements proches peuvent orienter cette analyse. Je vérifie leur cause et l’effet du correctif en rejouant les cas.
Quand l’agent corrige et quand il rend la main
Avec pr-feedback-fix, je demande à l’agent de vérifier le retour puis de proposer un plan. Avant de l’autoriser à intervenir, je fixe ce qu’il peut modifier, le nombre de tentatives et les conditions du push. Selon l’avis, je peux demander de corriger le code, de lancer un contrôle pour lever un doute ou de passer la main au référent métier.
Après correction, je relance le contrôle qui permet de trancher. Si le SHA ou la base change, je collecte les résultats de la nouvelle version. L’agent remet le diff et les preuves à l’équipe quand le contrôle confirme le correctif. Il peut poursuivre tant qu’il progresse sur une correction autorisée et qu’il lui reste des tentatives. En cas de stagnation, de preuve inaccessible ou de budget épuisé, il rend la main avec l’historique de ses tentatives et les questions ouvertes. Le push vient après les contrôles et l’autorisation. L’approbation revient au reviewer habilité et l’équipe décide du merge. Je n’ai pas établi que ce circuit a tourné de bout en bout sur ce cas.
Le protocole versionné du 22 octobre prévoit 3 pushes par tâche par défaut, avec une limite que la personne qui délègue peut ajuster. Si les preuves du nouveau SHA manquent encore après 15 minutes, l’agent rend la main. Le protocole de review, A14.
Sur la #4252, CodeRabbit propose le même code pour deux erreurs
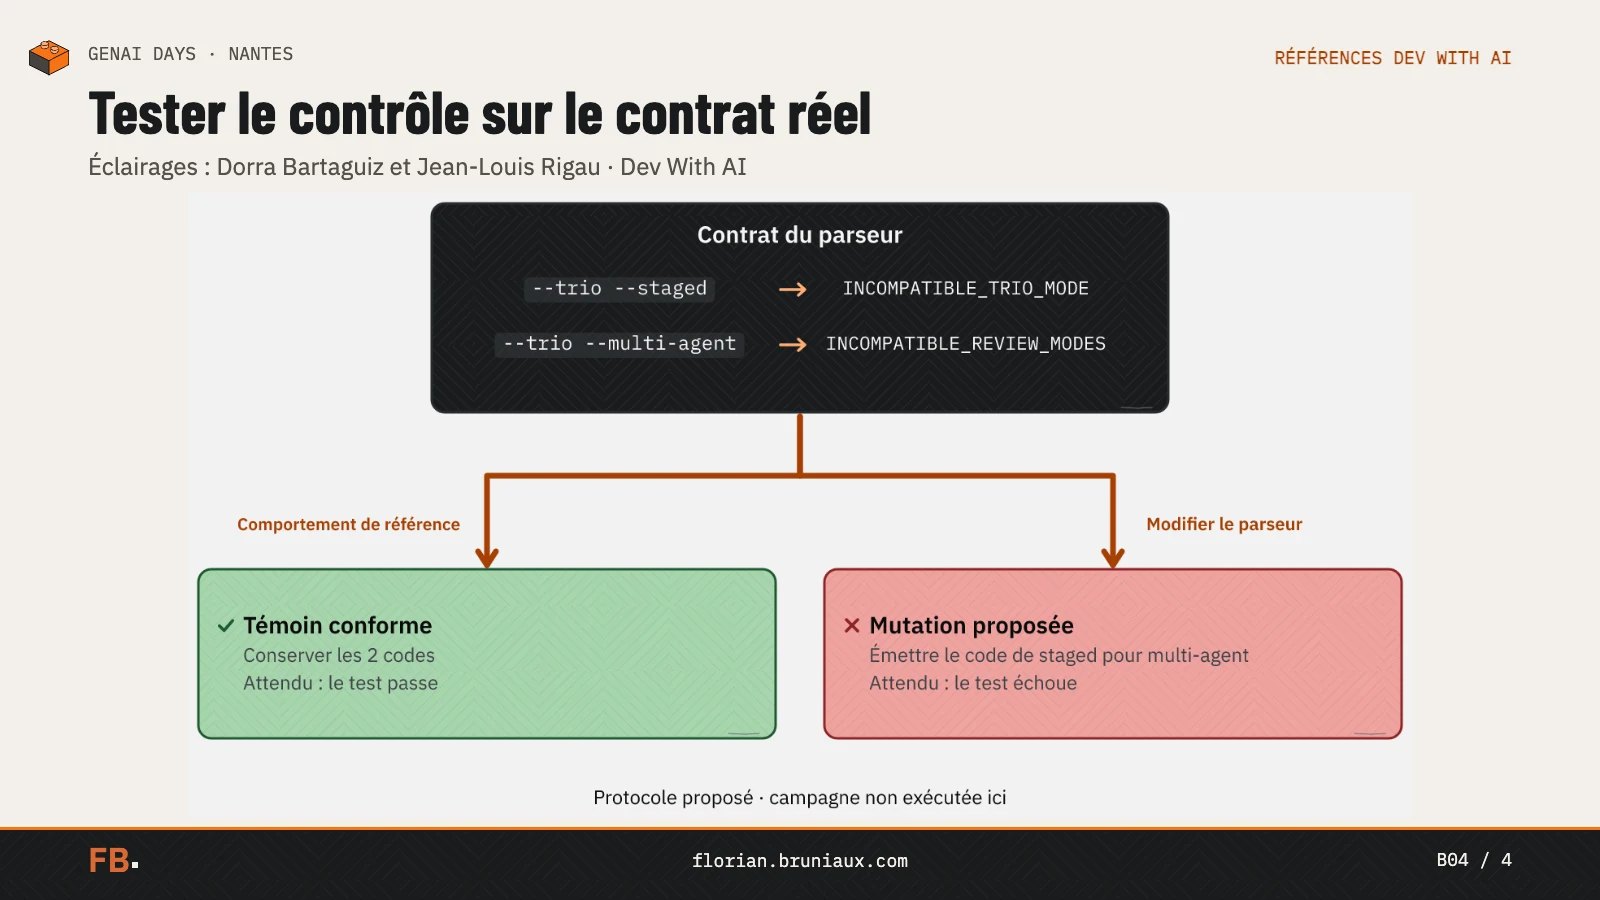
Sur la #4252, CodeRabbit a vu qu’un test qui attendait simplement une exception acceptait aussi un incident sans rapport, comme l’absence du binaire. Le patch suggéré attendait une erreur plus précise, mais il donnait le même code à deux familles d’entrées. Lors du replay du parseur du 11 novembre, staged et multi-agent renvoyaient des codes distincts. 2 entrées sur 4 donnaient un code différent de celui proposé. La suggestion est restée en commentaire.
Pour vérifier que la nouvelle assertion distingue bien les deux cas, je ferais renvoyer au parseur le code de staged dans le cas multi-agent. Le test devrait alors échouer. Je propose cet exercice à partir des résultats du replay du parseur. Exercice de mutation, B04.
Les règles, les hooks et les cas de replay
De la règle générée à son effet
Je vérifie que le repo a généré la règle et que la session l’a chargée. Le rejeu de la #3922 couvre le défaut et un cas déjà vert. La mesure sur les PR suivantes reste à faire.
Le repo génère les consignes de Claude Code, Cursor et Codex
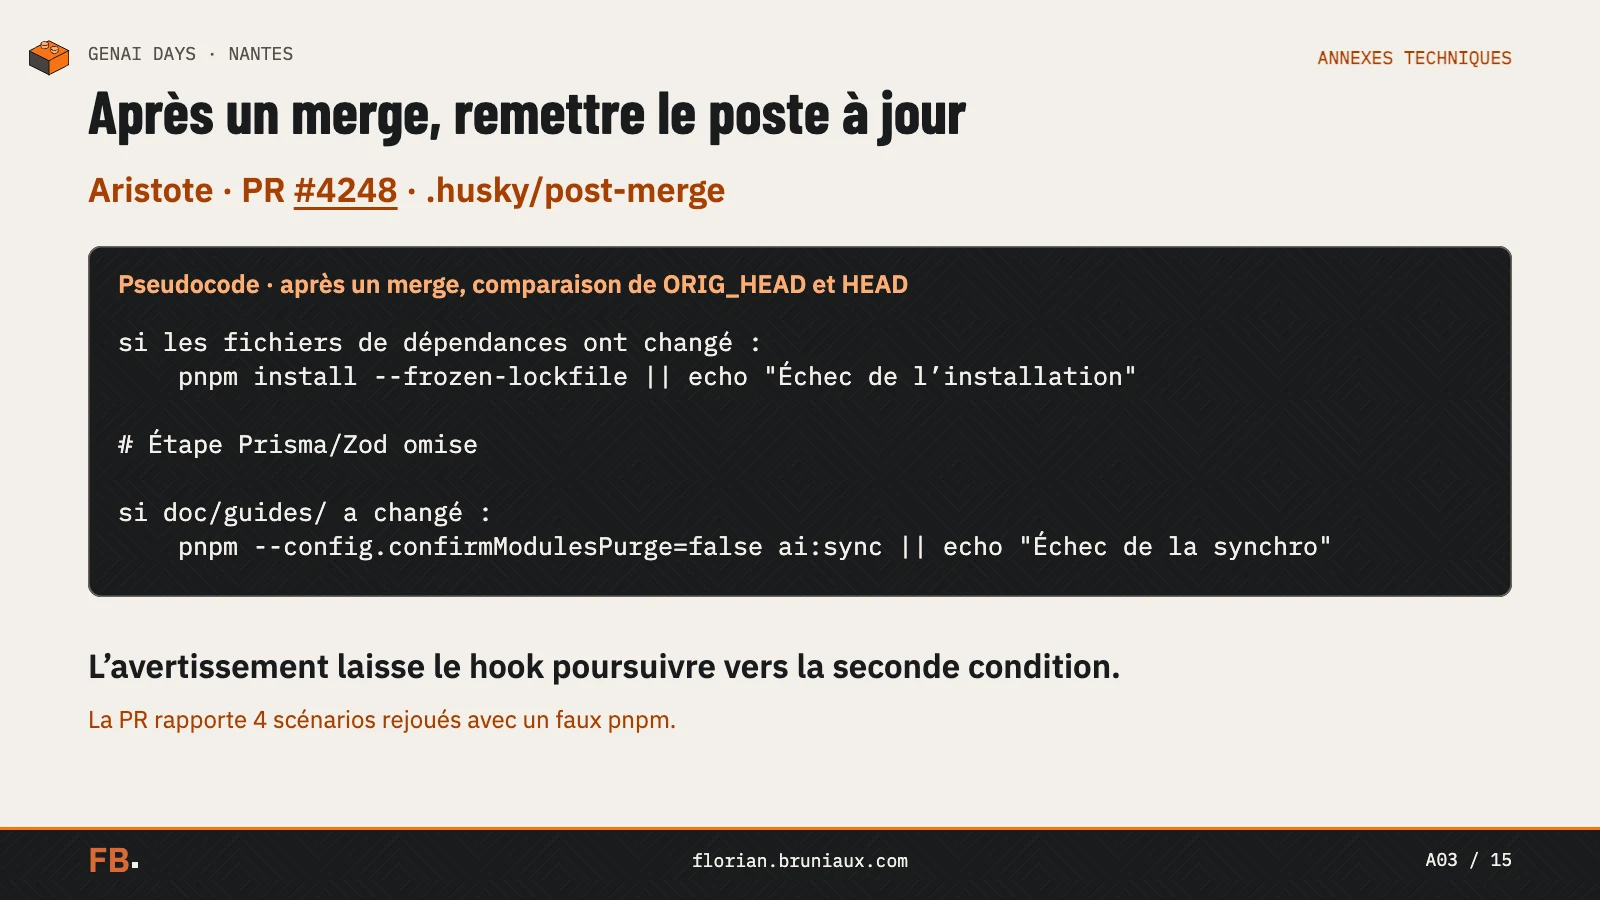
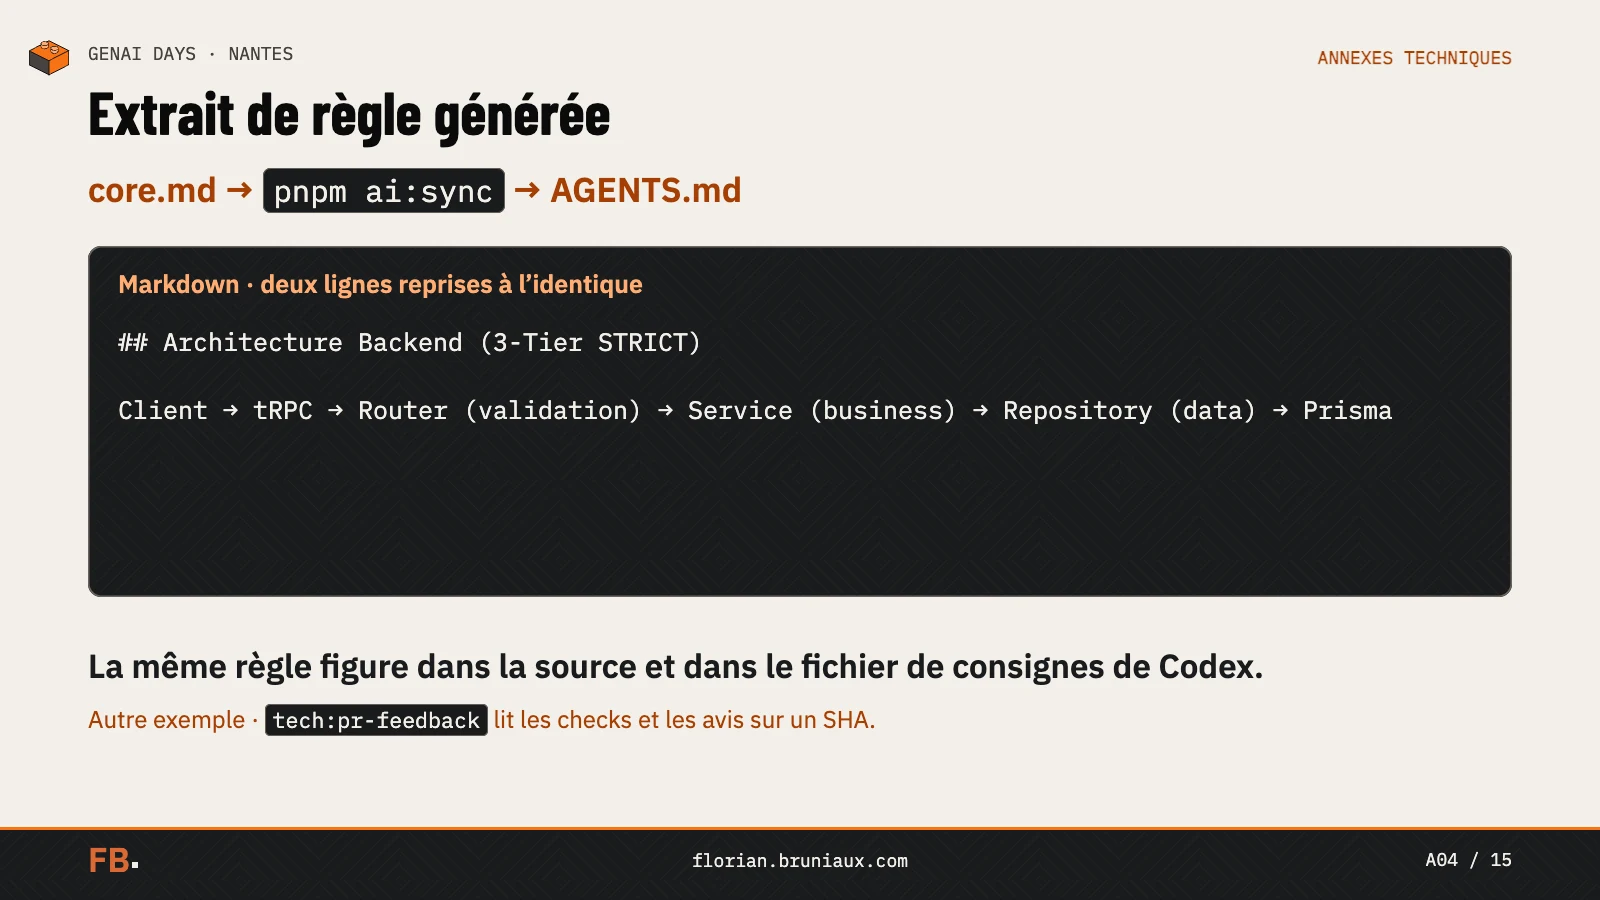
Chez Aristote, je modifie la règle dans les sources versionnées du repo. pnpm ai:sync régénère les consignes pour Claude Code, Cursor et Codex selon le client et le profil du poste. Lors d’un pull avec merge ou rebase, des hooks Git peuvent relancer la synchronisation si les guides changent. Ils comparent le point de départ à la nouvelle tête quand cette comparaison est disponible. Un changement de branche peut aussi déclencher la synchronisation. En cas d’échec, le hook affiche un avertissement. Dans la CI, ai:ctxtest vérifie des faits cités dans les consignes.
Le profil change aussi ce que je génère. Un développeur backend et un développeur front n’ont pas besoin des mêmes MCP pour leur tâche. Un collègue qui découvre le repo peut avoir des restrictions ou des questions avant le commit que je ne m’applique pas dans les mêmes conditions.
Le profil détermine les fichiers et les réglages générés. Je les vérifie ensuite sur disque et dans la session qui les utilise. Pour confirmer qu’une protection est active, je regarde si elle intervient sur la tâche concernée.
Ce que /context confirme dans une session Claude Code
- Sur disque. Dans les sources communes, je retrouve la règle et ses conditions. Après génération je regarde dans quel fichier de sortie elle apparaît pour le client et le profil utilisés. Exemple de règle générée, A04 · Hook après merge, A03.
- Dans la session. Le 14 novembre, sur une copie isolée du repo, une nouvelle session Claude Code a listé la règle pilote sous Memory files dans
/context. Je peux donc confirmer que cette session avait chargé la règle. Le chargement dans Cursor et le rechargement à chaud restent à vérifier. - Dans le résultat. Pour vérifier un comportement, je choisis un cas qui départage deux réponses. Le script de comparaison des contextes providers peut demander combien de rôles
UserRoleexistent et quelle source fait foi, puis contrôler le nombre et la référence face au schéma Prisma. Le run CI de la #4518 s’arrête au plan pour Claude et Codex. L’évaluation sur une session est une vérification distincte.
Si un collègue n’obtient pas le même comportement, je regarde si la règle correspond à sa tâche, si la session l’a chargée, si le contrôle devait se déclencher, s’il a tourné, et ce que son résultat a changé dans la décision. Distribution et rejeu, 28 · Diagnostiquer où ça s’arrête, A05 · Partager une règle avec son test, B02.
En CI, le diagnostic porte sur les fichiers disponibles dans le checkout. Quand je lis un export, je vérifie séparément son format et les résultats qu’il contient. Un rapport valide peut contenir des échecs statiques.
Les hooks de session et les hooks Git
Un hook de session peut préparer le contexte au démarrage ou à l’envoi d’un prompt. Avant un appel d’outil, PreToolUse peut bloquer une action. Après l’appel, PostToolUse peut lancer un contrôle. Les hooks Git réagissent aux opérations Git, par exemple avant un commit ou un push. Pour savoir si un hook est intervenu, je relève l’événement et son résultat dans la session ou la sortie Git.
Avec RTK, le hook peut demander rtk git status avant l’exécution de git status, pour que l’agent reçoive une sortie filtrée. Au même point d’interception, un hook peut refuser une action selon la configuration. Je peux vérifier ce déclenchement à partir de l’événement et du script exécuté.
Je parle aussi d’une recherche BM25 au moment où le prompt arrive. Le texte de la demande sert à retrouver des skills ou des agents utiles à la tâche. Un collègue peut ainsi découvrir une partie du harness sans connaître le nom de chaque commande. Je distingue la suggestion, le chargement du skill et l’exécution du contrôle. Pour vérifier l’ensemble, il faut une trace à chacune de ces étapes.
#3338 / #3922 · Le résumé CI nomme le test en échec
L’issue #3338 décrit un résumé CI rouge qui omettait le nom du test en échec. La #3922 ajoute ce nom au résumé et livre un test de contrat. Au rejeu, le résumé nomme le test dans le cas en échec et le cas déjà vert passe toujours. Le rejeu couvre ces deux cas. Il reste à mesurer le délai sur les PR suivantes.
Sur des PR comparables qui utilisent ce résumé, je relèverais avant et après le changement si le nom est présent, combien de temps s’écoule entre la publication de l’échec et sa première qualification, et à quelle fréquence il faut ouvrir les journaux. Les horodatages GitHub donnent le délai écoulé. Pour mesurer le travail humain, je demanderais aux reviewers de relever leur temps de lecture et de diagnostic. Si je change aussi un sélecteur comme celui de Storybook, je relève le taux de déclenchement, les reprises sur d’autres SHA et le coût des jobs supplémentaires.
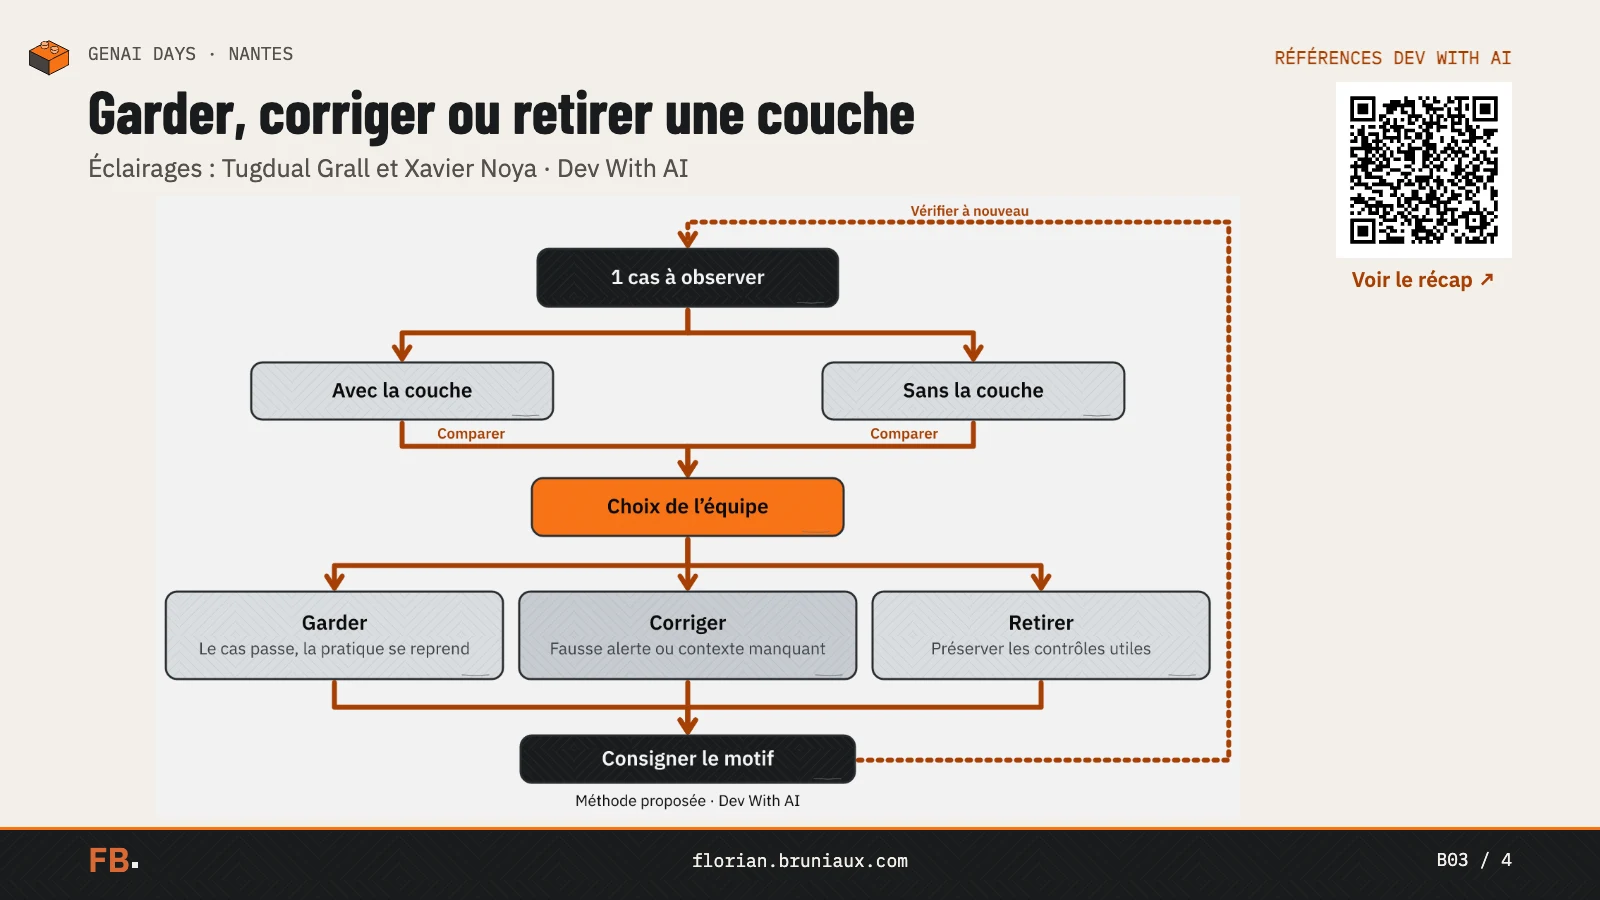
Je garde la trace du défaut, du rejeu qui le montre et de la décision prise avec l’équipe. Si le défaut revient ou que les faux signaux s’accumulent, j’ai de quoi reprendre le réglage. Garder, ajuster ou retirer un contrôle, B03.
Faire arriver la consigne sur le poste d’un collègue
Si la correction porte sur une consigne, je modifie sa source et je régénère les fichiers du profil et du client concernés. Sur le poste du collègue, je cherche la règle chargée, puis je rejoue le défaut et un cas qui fonctionnait déjà. L’équipe garde, ajuste ou retire la correction selon le résultat. Chez Aristote, la génération est documentée. La prise en compte par chaque client, le rechargement à chaud et le gain de temps restent à vérifier.
Le harness cible chez Aristote
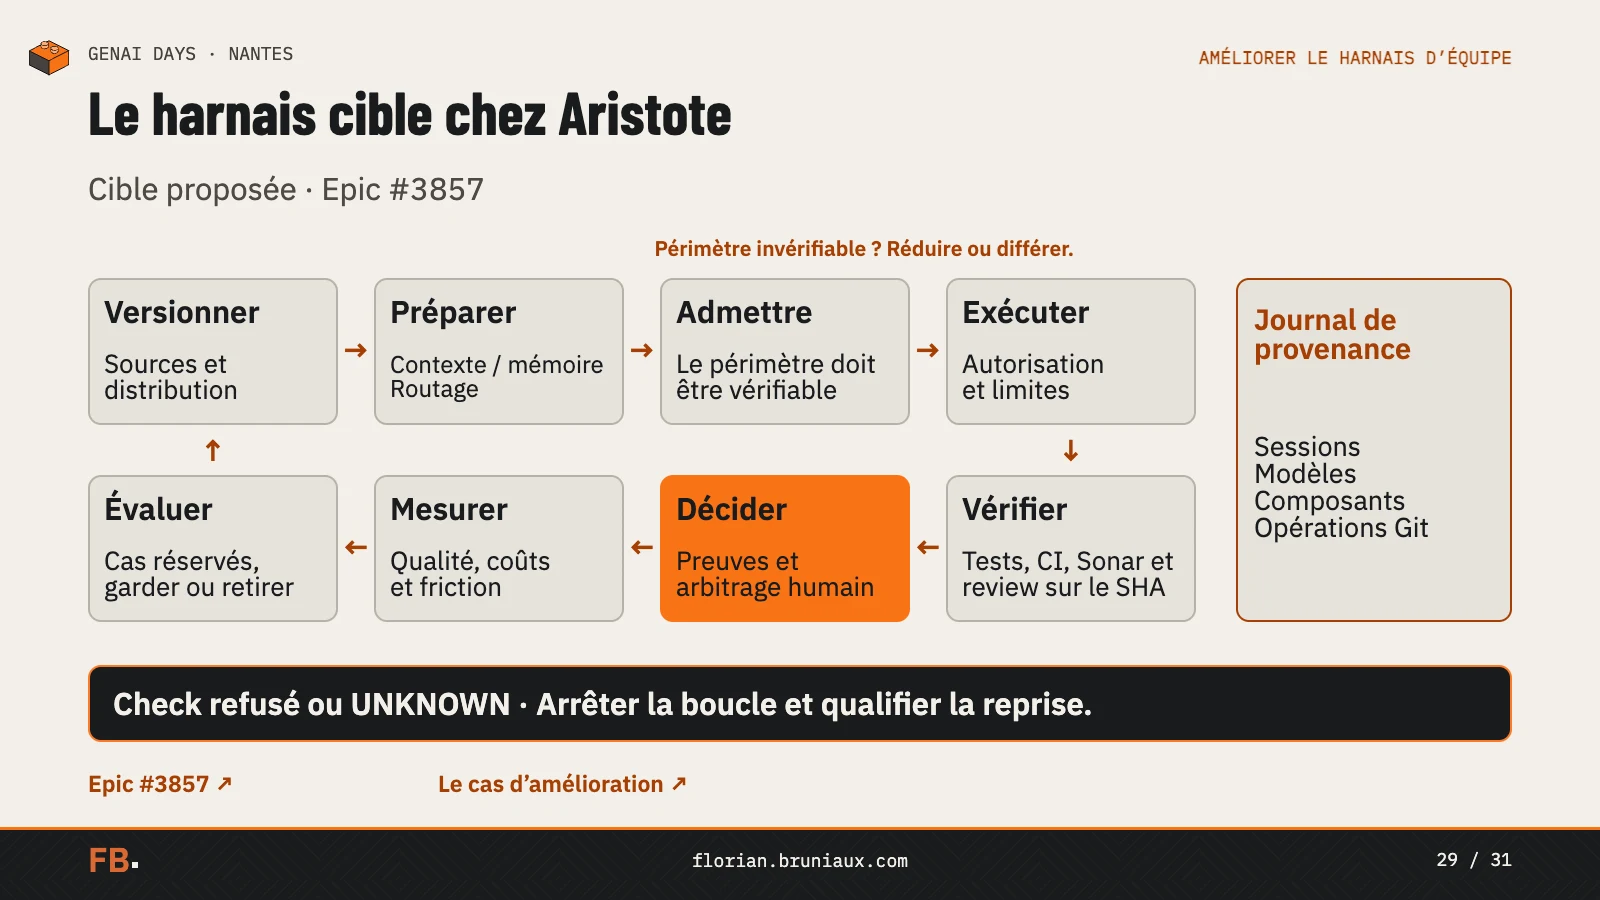
Dans la cible que je propose, je pars des sources versionnées et je donne à l’agent un périmètre dont l’équipe peut vérifier le résultat. Je rattache le diff, les checks et les avis au SHA et à la base que je dois juger. S’il manque une preuve, je cherche ce qui bloque. Une personne habilitée décide du merge.
Rejouer les conditions qui ont produit l’erreur
Pour retrouver ce qui a conduit au défaut, je veux garder le modèle utilisé, les skills, les hooks et les agents mobilisés. Je cite Git AI pendant le talk et j’explique que je cherche à compléter cette trace avec les informations du harness.
Je décris un clone indépendant du repo dans lequel je peux reprendre le ticket, les instructions et, quand je les ai, les conversations des collègues. Je cherche à savoir si le même scénario aurait encore produit le problème avec le harness corrigé. Le replay documenté de la #3922 dans ce guide couvre le résumé CI et ses 2 cas de test.
Pour évaluer une modification du harness, je rejoue les mêmes PR avant et après, avec le même modèle et le même budget. Je prends au moins une PR avec un défaut confirmé et une PR saine. Pour chacune, je note le verdict attendu et la preuve qui permet de le vérifier. J’automatise les contrôles qui ont un résultat déterminé et je laisse les avis ambigus à un reviewer.
Je relève les défauts manqués, les faux blocages et le temps de review. Avant de garder le changement, je vérifie si le résultat tient sur des PR mises de côté. Un script et un rapport CI suffisent pour démarrer. Dans la cible proposée, un journal rapprocherait aussi les sessions, les modèles et les opérations Git pour suivre la latence et le coût des runs.
La conclusion à 99 % et ses liens
Pourquoi je parle de 99 %
Aujourd’hui, je dirais que je fais confiance à mes PR à 99 %. C’est mon appréciation personnelle. Avant de merger, je vérifie quels checks ont tourné, je recoupe les constats de la review et je m’assure que ces preuves couvrent le commit que je vais accepter.
Sur la #4518, la CI verte du deuxième commit me dit que les tests sélectionnés passent. La review de ce même commit me fait ouvrir la page d’arrivée, où le libellé diffère encore. C’est le doute que je garde avant de merger. Si cet écart revient, l’équipe peut reprendre le cas pour écrire un contrôle qu’elle saura rejouer.
Du code au merge, le guide Dev With AI · From code to merge, sa version anglaise · Ma boucle de review bornée.
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source