6/6 · La portabilité devient un sujet de Scale
Des instructions portables exigent des sources neutres, des sorties générées pour les runtimes, des contrôles de release et des tests comportementaux. Les primitives natives seules ne suffisent pas.
Aller au résumé ↓ Florian Bruniaux
Context Engineering · Partie 6/6
TL;DR
Je pense que changer de modèle est la partie facile de la portabilité, et vérifier que le comportement survit au changement est la partie difficile. Je conserve des sources neutres et génère des sorties natives, éprouvées aujourd’hui pour Claude Code et Codex, entre lesquels j’alterne ; la pertinence d’un framework d’agents dépend de l’équipe, et mon installation fonctionne sans. Je m’attends à ce que le context engineering soit absorbé par le harness engineering, et les sources neutres et les tests comportementaux sont ce qui survivra à cette évolution.
| La question de Scale | Plusieurs personnes peuvent-elles changer d’outils sans créer des variantes des règles de fonctionnement de l’équipe ni perdre la vérification ? |
| Le piège | Les fichiers simples et les primitives natives restent propres à leur runtime sans couche de traduction contrôlée |
| L’architecture | Des sources neutres génèrent des sorties explicites pour chaque runtime pris en charge |
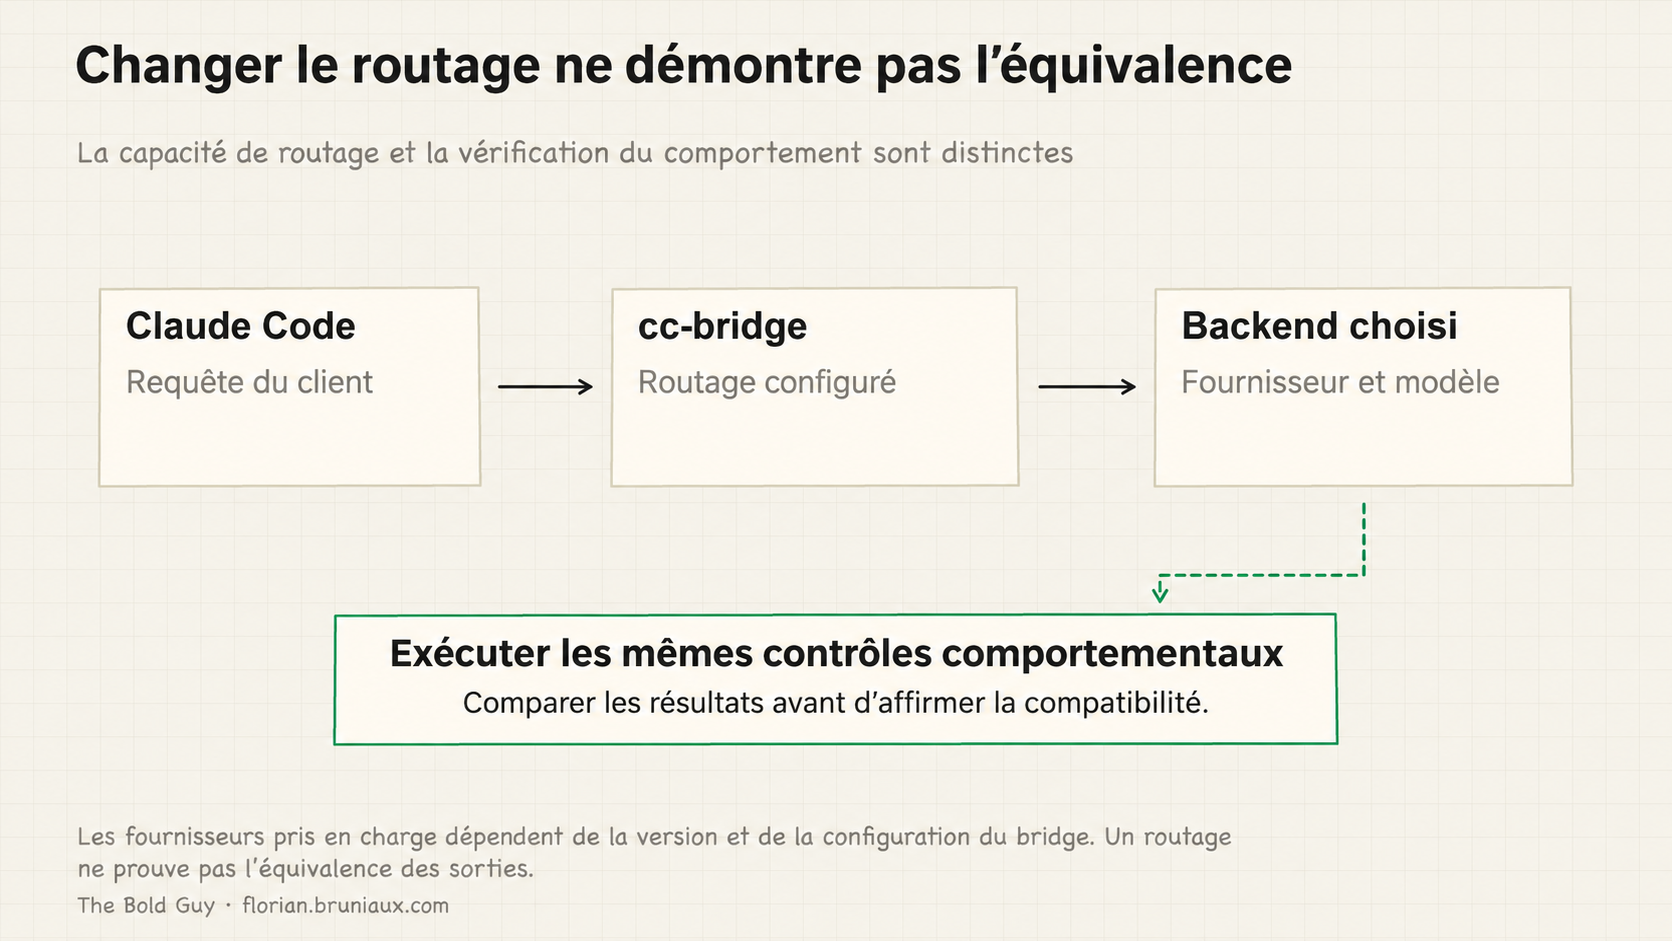
| La couche de routage | cc-bridge change le backend du modèle, mais le routage ne prouve pas l’équivalence des comportements |
| La preuve | Les manifestes de release, les contrôles des sorties générées et les tests comportementaux bornent l’affirmation de portabilité |
En cinq parties, cette série a construit un système d’instructions : sources isolées des sorties, modules partagés entre profils de développeurs, audit comportemental en CI et pipeline de synchronisation comme colonne vertébrale opérationnelle. La portabilité devient un sujet de Scale quand ce système sert plusieurs développeurs, repositories ou runtimes. Sans cela, une migration peut séparer les règles, tests et preuves de l’équipe en copies incompatibles.
La référence principale d’architecture est La configuration portable d’agents est un système de release, pas un dossier partagé. Elle définit le modèle source, les artefacts générés, le manifeste de release, les frontières d’installation et les preuves nécessaires pour affirmer une prise en charge. Cette conclusion explique pourquoi ces contrôles comptent.
Pourquoi cela relève de Scale
À Start, une personne peut garder un petit fichier d’instructions près d’un runtime. À Build, les tâches répétées révèlent quelles règles, procédures et vérifications méritent un emplacement stable. Scale ajoute le problème de coordination : plusieurs contributeurs ont besoin de préserver la même intention d’un hôte, d’une version, d’un repository et d’un parcours de review à l’autre.
La tentation du framework
L’Agent Development Kit de Google, CrewAI, LangChain : l’attrait des frameworks d’agents est réel. Ils abstraient la couche d’orchestration, fournissent des modèles prêts à l’emploi pour les appels d’outils et la mémoire, et permettent de faire tourner un agent plus vite. Pour un prototype évalué sur un week-end, c’est un choix raisonnable.
Pour un système de production dont dépendent six développeurs, le framework peut devenir une contrainte. Les abstractions qui simplifiaient le prototype s’interposent désormais entre vous et le comportement natif du modèle. Le débogage exige de comprendre l’état interne du framework avant de comprendre ce que le modèle a réellement fait. Migrer vers un nouveau fournisseur demande d’abord d’adapter les bindings du framework. Ajouter un outil que le framework ne prend pas nativement en charge oblige à lutter contre la couche d’abstraction. Le framework devient le runtime, et le runtime devient la dépendance qui vous enferme. L’intérêt de payer ce coût dépend de l’équipe.
Maxime Thoonsen défendait l’idée que prendre le développement d’agents au sérieux signifie investir dans les bases plutôt que dans la syntaxe des frameworks, et que les compétences d’architecture logicielle gagnent en valeur à mesure que les outils se multiplient (ép. 307). Hooks shell, modules Markdown et profils YAML utilisent tous un schéma durable : une configuration pilotée par les données, avec des effets de bord déclenchés par les événements. L’outil qui les lit peut être remplacé sans changer le schéma.
Construire directement sur des hooks shell, des fichiers Markdown et des profils YAML peut réduire les dépendances aux frameworks et garder le système inspectable. Ces propriétés aident une migration, mais ne rendent pas les sémantiques des hôtes équivalentes. Chaque sortie exige toujours un runtime nommé, un artefact généré, un chemin d’installation et une frontière de vérification.
Les primitives natives sont des entrées, pas une preuve de portabilité
Chez Méthode Aristote, l’installation Claude Code exécute 25 hooks shell sur le cycle de vie des événements. Le plus visible est un hook global PostToolUse situé à ~/.claude/hooks/anti-ai-markers.sh. Il se déclenche après tout appel Edit ou Write sur les fichiers .md, .mdx ou .txt, retire les blocs de code et le frontmatter avant l’analyse et vérifie un ensemble défini de motifs détectables d’écriture par IA : tirets cadratins (U+2014), une liste sélectionnée d’adjectifs surutilisés en anglais et en français corrélés aux textes générés, et des transitions mécaniques limitées à une par texte. Une violation renvoie un signal decision: block et dirige le retour vers un fichier de guide stylistique. Comme il s’agit de PostToolUse, l’écriture a déjà eu lieu : le signal demande une correction au lieu d’annuler la modification. Un contrôle préventif se place avant l’exécution. Voir le contrat de décision des hooks. Aucune couche de framework n’intervient. Le hook est un script shell, inspectable en deux minutes, débogable avec bash -x.
Les 56 skills procéduraux avec disable-model-invocation: true suivent la même logique. Ils couvrent les commits, l’envoi d’une PR, la création d’une release, les opérations sur la base de production et la création du squelette d’un nouveau module. L’utilisateur les invoque par une commande slash explicite. La raison est documentée pour les skills liés à Sentry : cela empêche le triage ou les corrections automatiques non demandés. Le même principe s’applique à l’ensemble des skills procéduraux. Les effets de bord qui comptent restent sous contrôle humain, et aucun framework ne décide quand les déclencher.
Le BM25 et le routage lexical des skills assurent l’aiguillage. Un hook calcule le score du prompt entrant par rapport à la bibliothèque de skills et route vers la meilleure correspondance. Le taux de suivi visé est d’environ 50 %, mesuré chaque semaine. C’est un objectif de calibration, pas encore un résultat confirmé, et le système s’affine à chaque cycle de correction. Cela remplace la classification d’intention d’un framework par une fonction de score inspectable sur du texte, avec des résultats que l’on peut journaliser et auditer.
Cela rend la couche comportementale de Claude Code inspectable sans connaissance propre à un framework. Cela ne dit rien, à soi seul, sur le fait que Codex, Cursor ou un autre hôte chargera les mêmes fichiers, exposera les mêmes événements ou appliquera la même décision. La portabilité commence quand l’intention neutre est traduite en artefact propre à un hôte et vérifiée sur cet hôte.
Indépendance du modèle avec cc-bridge et des sources neutres
La seconde moitié de la portabilité concerne le modèle lui-même.
cc-bridge route les requêtes de Claude Code selon la configuration du fournisseur sélectionné. Le repository public décrit le pont Copilot, Anthropic Direct et Ollama comme des routes distinctes. La prise en charge des fournisseurs et la traduction des protocoles dépendent de la version utilisée. Le schéma ci-dessous isole cette relation de routage de l’affirmation distincte selon laquelle un backend satisfait les mêmes attentes comportementales.
Le principe sous-jacent remonte à la composition des systèmes d’agents. Samy Lastmann décrivait les changements de modèle comme un remplacement de microservice : chaque modèle d’un pipeline devrait être remplaçable sans casser le pipeline, et les métriques de performance devraient être définies avant le changement plutôt que mesurées après (ép. 311). cc-bridge rend cela opérationnel au niveau du routage. Le changement est une modification de configuration, et les contrôles comportementaux canaris de la cinquième partie indiquent si le nouveau modèle satisfait les mêmes attentes.
Cela diffère de la couche de passerelle API décrite dans la troisième partie. Cette couche, LiteLLM, Bifrost et les outils similaires, intercepte le trafic API qui la traverse pour appliquer budgets, clés, listes de modèles autorisés et routage. Elle ne voit que ce trafic. La possibilité de faire passer une session d’abonnement Max ou Pro par une passerelle dépend du chemin d’authentification du client et de l’intégration documentée de la passerelle. Les conditions d’Anthropic interdisent aux développeurs tiers de router des requêtes avec des identifiants Free, Pro ou Max pour le compte de leurs utilisateurs (cadre juridique et conformité de Claude Code). cc-bridge route pour donner de la souplesse : tester un nouveau modèle avec exactement les mêmes instructions que le modèle de production, basculer vers un modèle local quand l’API d’un fournisseur est indisponible, ou exécuter un modèle moins cher sur des tâches moins sensibles sans changer le système de configuration qui les gouverne tous.
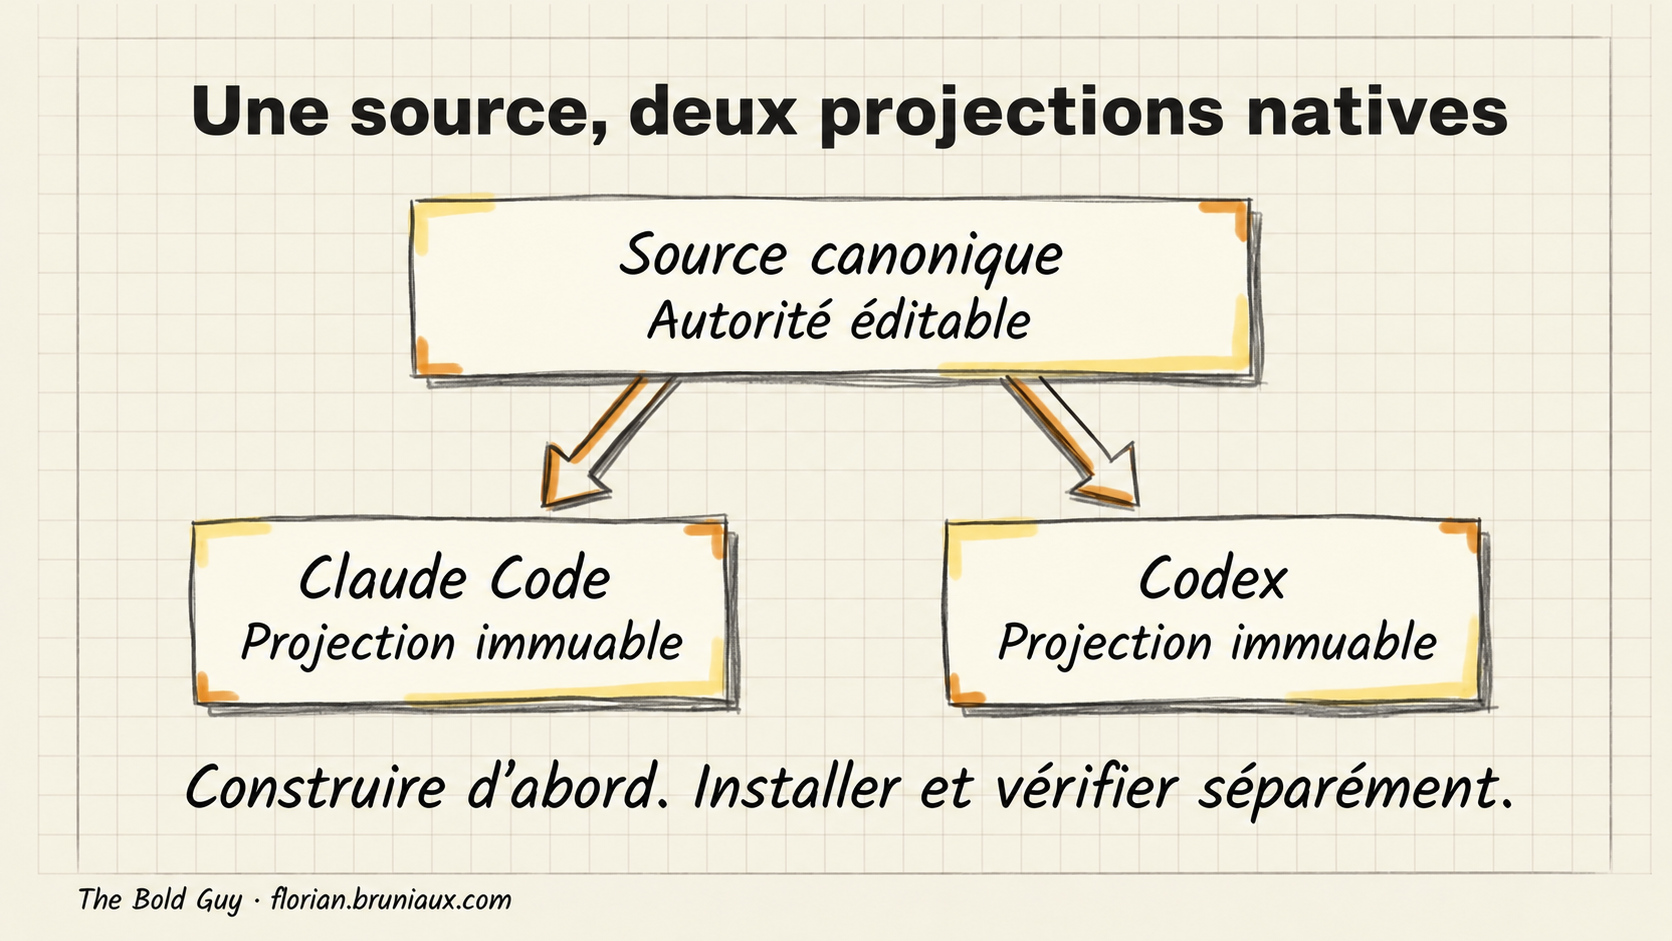
La portabilité plus profonde commence dans le format source. Les modules de doc/guides/ai-instructions/modules/ sont du Markdown simple. Ils ne contiennent ni syntaxe propre à Claude, ni directives propres à Cursor, ni annotations propres à un framework. Les profils sont en YAML. Les squelettes référencent les modules par des placeholders {{module:name}}, une convention de template que le script de synchronisation résout.
Les spécificités des runtimes résident dans les sorties. pnpm ai:sync produit CLAUDE.md pour Claude Code, .cursorrules pour Cursor, AGENTS.md pour Codex et les agents OpenAI, .codex/config.toml pour Codex terminal et .mcp.json pour la configuration des serveurs MCP.
Cette liste décrit les sorties de ce pipeline. Pour une nouvelle configuration Cursor, le format projet documenté est .cursor/rules/. .cursorrules reste un format historique.
L’architecture de configuration portable d’agents documente les frontières plus strictes de release, d’installation, de routage et de preuve derrière ce schéma. Son périmètre d’hôtes prouvé est volontairement plus étroit que sa matrice cible : Claude Code et Codex disposent d’adaptateurs concrets.
Chaque runtime pris en charge exige un adaptateur de sortie, un chemin d’installation documenté, une entrée dans la matrice de prise en charge, une validation statique de l’artefact généré et un test comportemental sur l’hôte. Un nouvel adaptateur peut réutiliser les modules sources là où l’hôte représente la même sémantique. S’il ne le peut pas, le modèle source ou sa frontière de prise en charge déclarée doit aussi changer.
Le test pratique consiste à demander ce qu’il faudrait réécrire si la couche modèle changeait demain. Avec cette architecture, la configuration de routage, l’adaptateur du runtime, la correspondance d’installation et les contrôles propres à l’hôte définissent le travail. Les vingt modules qui codent les conventions du projet, les six profils qui capturent les préférences des développeurs et les quarante fichiers de règles ne restent réutilisables que pour les sémantiques que l’hôte de destination peut représenter et vérifier.
Tester la mémoire après un changement de modèle
Une étude contrôlée sur la portabilité de la mémoire a relevé des effets de migration directionnels entre deux petits modèles à poids ouverts sur des historiques synthétiques. Traitez le modèle qui écrit la mémoire, celui qui la lit et l’index d’embeddings comme des cibles de migration distinctes. Notez leurs versions et rejouez des questions fixes avant de promouvoir un nouveau stockage ; des formats de fichiers partagés et des dimensions vectorielles identiques ne prouvent pas la compatibilité.
Ce qui survit à une migration contrôlée
Cette série est partie d’un écart de mesure : des résultats opposés dans les études sur le code avec IA, où la façon de construire le contexte explique une partie de la différence, parmi d’autres facteurs. Elle se termine par un choix structurel sur la construction de ce contexte pour qu’il survive à chaque outil de la chaîne.
Les décisions durables du système décrit dans ces six parties résident dans des modules Markdown neutres, des profils explicites, des attentes comportementales et un pipeline de synchronisation. Les hooks shell et fichiers de runtime sont des adaptateurs autour de ces sources. Certains adaptateurs devront être réécrits lors d’une migration. La connaissance du projet et les tests peuvent survivre si le système de release sépare source, sortie générée, installation et vérification.
Quentin Adam proposait un principe de gouvernance applicable aux outils : pour l’infrastructure IA, éviter les abonnements annuels et laisser les développeurs choisir leurs outils, parce que le domaine évolue trop vite pour un engagement plus long qu’un court cycle de facturation (ép. 341). Le système d’instructions décrit ici applique la même logique à la configuration. Les sources neutres et les sorties générées réduisent le travail dupliqué.
Chaque article se suffit à lui-même, même si lire les six parties dans l’ordre est le chemin le plus court vers une vue complète.
| Partie | Sujet |
|---|---|
| 1/6 · La science | Pourquoi le contexte se dégrade et le paradoxe +67 % / -19 % |
| 2/6 · La discipline | Diagnostic de dérive, lacunes de contrôle de L0 à L5 et boucle entre respect des instructions et maintenance |
| 3/6 · Les outils | Carte des mécanismes de réduction de tokens, RTK, taxe MCP |
| 4/6 · Les rôles | Context engineer, harness engineer, spec engineer, agent identity architect, AI eval engineer |
| 5/6 · L’équipe | Profils, modules, pipeline de synchronisation, audit comportemental en CI |
| 6/6 · La portabilité | Sources neutres, adaptateurs de runtime, preuves de release et prise en charge bornée |
Retours de terrain via les transcriptions d’épisodes IFTTD : Maxime Thoonsen, ép. 307 sur les bases plutôt que la syntaxe des frameworks ; Samy Lastmann, ép. 311 sur le changement de modèle comme remplacement de microservice ; Quentin Adam, ép. 341 sur la prévention de l’enfermement au niveau de la gouvernance des outils.
Si vous avez migré une codebase instrumentée pour l’IA d’un fournisseur de modèles vers un autre, je serais curieux de savoir ce qui a été le plus difficile. Mon intuition est que le modèle était la partie facile. Des questions, un autre point de vue ou des mesures qui contredisent ces observations ? Je lis tout sur LinkedIn.
Le contrat portable associe une source canonique à des adaptateurs et une validation propre à chaque client. Préservez séparément la révision source, l’artefact généré et les preuves de comportement natif lors d’une migration.
YSNK
(Vous devriez maintenant savoir)
- Le hook anti-marqueurs IA du site se déclenche à chaque Edit ou Write sur
.md/.mdx/.txt, recherche les tirets cadratins, les adjectifs surutilisés et les transitions mécaniques, puis renvoie un signal de blocage en cas de violation. Un script shell assure ce travail et s’inspecte en deux minutes - 56 skills procéduraux fonctionnent avec
disable-model-invocation: true. Une commande slash explicite, plutôt que le modèle, déclenche une release, une opération sur la base de production ou une correction Sentry - Le routage lexical des skills par BM25 vise environ 50 % de suivi, présenté comme un objectif de calibration mesuré chaque semaine, pas un résultat confirmé
- Changer le backend du modèle avec cc-bridge modifie la configuration du routage ; les contrôles comportementaux doivent encore établir si le nouveau modèle satisfait les mêmes attentes
- La portabilité est bornée par des adaptateurs nommés, des preuves de release et des vérifications propres à l’hôte, pas par le fait que deux runtimes acceptent des fichiers Markdown
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source