3/6 · Cartographier la boîte à outils de réduction de tokens
Comparer RTK, Tokenade, Headroom et le cache de prompts par mécanisme, intégration et preuve. Une sortie d’outil plus petite ne prouve pas qu’une tâche terminée coûte moins cher.
Aller au résumé ↓ Florian Bruniaux
Context Engineering · Partie 3/6
TL;DR
J’utilise RTK et je le trouve très efficace sur les sorties CLI : son propre compteur indique 48 % à 81 % de tokens de sortie CLI économisés par mois complet de juillet à septembre 2026 sur ma machine (lecture du 2 octobre 2026), ce qui n’est pas ma facture. Je m’attends à des agents plus efficaces auxquels nous confierons davantage de travail, et à des abonnements offrant moins de quota au même prix. Le chiffre à suivre est donc le coût par tâche acceptée, pas le ratio de compression.
| TL;DR | À vérifier |
|---|---|
| Mécanisme | Filtrage, sélection, délégation et cache changent différentes parties d’une session |
| Couverture | Un hook shell, un proxy MCP et une passerelle de modèles ne peuvent pas automatiquement atteindre le même trafic |
| Preuve | Comparez des tâches complètes, avec tentatives supplémentaires et qualité, plutôt que les ratios de compression mis en avant |
| Propriété | RTK publie ses sources ; Tokenade distribue un moteur propriétaire derrière un installateur public |
Transparence : j’ai contribué à RTK. Le même standard s’applique à ses affirmations et à celles des concurrents : nommer la charge de travail, le dénominateur et la limite de preuve.
Une réponse d’outil plus courte peut aider un agent à terminer avec moins de contexte. Elle peut aussi l’obliger à relire l’original. Une comparaison utile part du travail modifié, puis suit chaque appel de modèle nécessaire pour terminer la tâche.
La version précédente de cet article répartissait les outils en quatre couches exclusives. C’était trop rigide. Tokenade combine filtrage des commandes, navigation dans le code, contrôles du contexte et instructions de sortie ; Headroom expose plusieurs modes d’intégration. Un produit peut occuper plusieurs lignes de la carte.
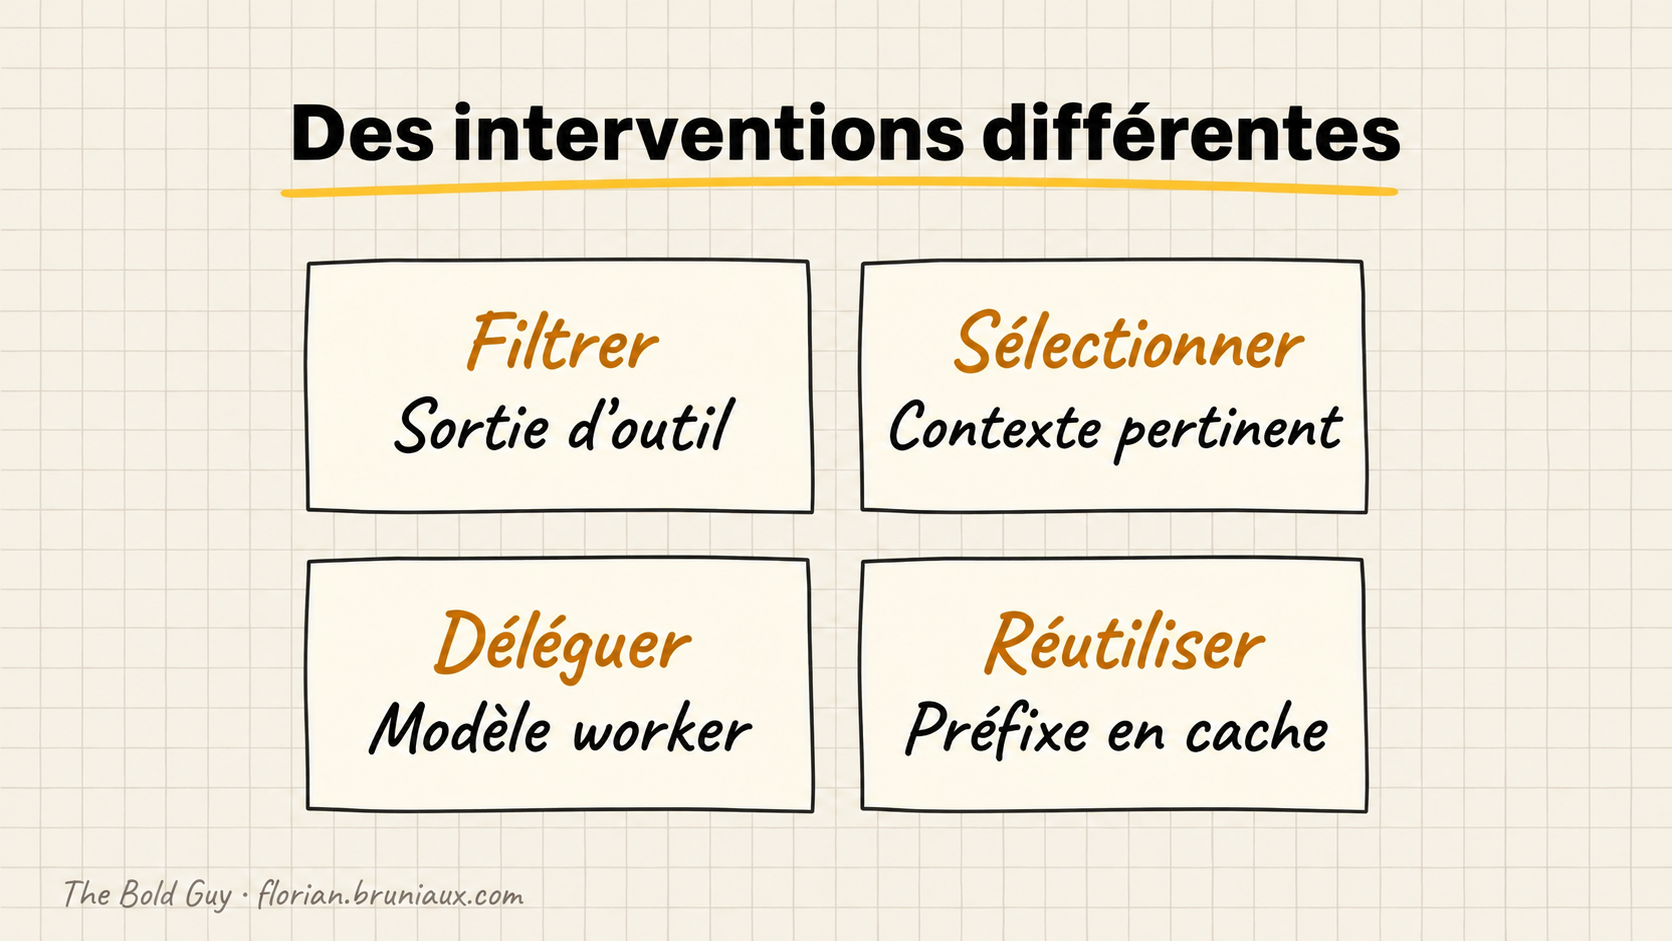
La carte des mécanismes
Les quatre interventions de la figure se déclinent dans les mécanismes ci-dessous. Un outil peut apparaître dans plusieurs catégories ; comparez son périmètre d’intégration avant ses économies.
| Mécanisme | Exemples à examiner | Ce qu’il faut mesurer |
|---|---|---|
| Filtrage des sorties de commandes | RTK, Snip, Distill, Tokenade | Sortie conservée, détails perdus, nouvelles tentatives en brut |
| Lectures sélectives et navigation | lean-ctx, Serena, Token Savior, Tokenade | Coût de l’index, récupération correcte, appels supplémentaires |
| Middleware avant lecture | OpenWolf | Demande de l’original par l’agent lorsque nécessaire |
| Découverte et exécution d’outils | context-mode, Cloudflare MCP, mcp2cli | Schémas chargés, taille des résultats, coûts d’exécution et de reprise |
| Récupération de documentation | Context7 | Pertinence et fraîcheur de la documentation récupérée |
| Compression de prompts | LLMLingua | Réduction des entrées et qualité des tâches en aval |
| Instructions de sortie | Caveman, claude-token-efficient, SuperClaude | Longueur des sorties, lisibilité, exigences omises |
| Compression et récupération | Headroom, Context Gateway | Effets sur le cache, durée de stockage, comportement de récupération |
| Services de passerelle | LiteLLM, Bifrost, Edgee | Fonctions activées et trafic qui y passe réellement |
| Représentation visuelle | pxpipe | Facturation des images, restitution des chaînes exactes, modèles compatibles |
| Travail délégué | Plugins Spotify Portal | Coût du modèle exécutant, latence et vérification par l’agent principal |
Cet inventaire identifie des approches, pas des intégrations testées indépendamment. LLMLingua élague les entrées avant l’inférence ; il n’appartient pas à une catégorie qui raccourcit seulement la réponse du modèle. Les outils de suivi tels que ccusage et ccboard aident à examiner l’usage ; leur présence seule ne le réduit pas.
Analyse 1 : RTK et le filtrage des sorties de commandes
RTK filtre les sorties de commandes avant que l’agent les consomme. Par exemple, une exécution de tests peut conserver les échecs et condenser les cas réussis. Son hook Bash Claude Code réécrit les commandes shell prises en charge ; les appels natifs Read, Grep et Glob ne passent pas par ce hook. Le CLI expose aussi la lecture compacte de fichiers, dont une sortie limitée aux signatures. Documentation RTK
Gardez le résultat brut accessible pendant l’évaluation. Si un filtre masque un diagnostic, comptez la lecture supplémentaire et le temps passé à le récupérer. La documentation RTK distingue les réductions de sortie Bash des réductions de facture et explique son estimation de tokens fondée sur les octets. Comment fonctionnent les économies RTK
Mise à jour du 6 novembre 2026. Pour gérer les usages à l’échelle d’une équipe, vous pouvez découvrir RTK Pro. La page de l’offre présente des fonctions de politiques d’usage, de sécurité et d’observabilité. Cette offre est distincte du CLI open source étudié ici ; les mesures de filtrage ci-dessus n’évaluent pas RTK Pro.
Tokenade couvre plus de périmètres avec un moteur propriétaire
Tokenade combine filtrage, navigation dans le code, proxy MCP, déduplication et instructions de réponses concises. Sa configuration publiée de benchmark Claude Code inclut des hooks autour de l’usage des outils et de la compaction, ainsi que des règles encourageant les opérations par lots. L’intervention est plus large qu’un filtre de commandes. Une amélioration agrégée ne peut donc pas être attribuée à un seul mécanisme sans tester séparément les composants. Manifeste d’intégration du benchmark
Le repository npm public contient un installateur et un lanceur. Son fichier LICENSE décrit explicitement le logiciel comme propriétaire, alors que la FAQ décrit un cœur MIT. Considérez le moteur distribué comme propriétaire tant que cette contradiction n’est pas résolue. Un installateur public ne rend pas le moteur auditable. Licence Tokenade
La comparaison de Tokenade minimise certaines parties de RTK : RTK documente les lectures compactes de fichiers et la prise en charge native de Windows. La différence est une couverture intégrée plus large, pas l’absence complète de lecture de fichiers dans RTK. Inversement, un lecteur limité aux signatures n’est pas un index sémantique de tout le repository.
La compatibilité doit être vérifiée pour le client exact. Le tableau actuel de Tokenade distingue Codex CLI de l’application desktop Codex, où la couverture passe surtout par MCP. Une coche pour le CLI ne prouve pas l’interception des lectures natives ou des appels shell de l’application. Tableau d’intégration du produit
Ce qu’établit le benchmark Tokenade
THOL est maintenu par l’auteur de Tokenade, qui déclare cette relation. Dans sa campagne publiée sur Claude Code 2.1.206, Tokenade 0.8.13 a un ratio de coût de 0,768 face au contrôle, contre 1,052 pour RTK 0.42.3. Leurs intervalles respectifs sont 0,647–0,900 et 0,913–1,190. Je ne prends pas le chiffre RTK au pied de la lettre : la campagne est menée par l’auteur d’un outil concurrent, et l’intervalle de RTK inclut l’absence d’effet. Les deux rapportent 170 exécutions réussies sur 17 tâches. L’agrégat est une moyenne géométrique des ratios de coût par tâche. Résultats publiés
Ces résultats appuient un gain pour Tokenade dans cette campagne. L’intervalle de RTK traverse 1 ; il n’établit ni surcoût certain ni équivalence. L’expérience compare des configurations complètes, dont des instructions qui changent le comportement. Elle n’établit pas quel composant a causé l’écart et ne prédit pas les économies sur un autre modèle et une autre charge. Aucune reproduction indépendante n’est présentée ici.
Analyse 2 : le coût MCP
Les schémas d’outils ont un coût de contexte, mais son montant dépend du client, du serveur et du mode de découverte. Il est incorrect d’assigner un coût fixe en tokens à chaque serveur connecté ou de supposer que chaque schéma est entièrement chargé à chaque tour. Claude Code permet la découverte différée des outils. Examinez ce que la session charge avant d’estimer le surcoût. Contrôles des coûts Claude Code
Conversion en CLI, découverte différée et exécution de code sont des options différentes. Un CLI déplace une partie de la découverte dans des commandes ; un outil d’exécution laisse l’agent calculer sur les données et renvoyer des résultats sélectionnés. Les deux nécessitent encore des descriptions utilisables, du temps d’exécution et assez de retours pour détecter les erreurs. Un skill peut réduire le chargement anticipé des instructions, mais ses métadonnées de découverte et son contenu invoqué consomment aussi du contexte.
Analyse 3 : les sorties
Les réponses concises peuvent réduire les tokens générés. Elles peuvent aussi omettre l’explication nécessaire à un reviewer. Demandez des confirmations courantes courtes en préservant hypothèses, échecs et limites de preuve. Mesurez si la brièveté change la réalisation des tâches ou l’effort de review avant d’y voir une économie gratuite.
L’authentification par abonnement ne rend pas toute passerelle techniquement impossible. La prise en charge dépend des interfaces de routage et d’authentification du client et de l’intégration documentée de la passerelle. Les estimations d’usage diffèrent aussi du forfait d’abonnement ou de la facture de crédits. Vérifiez le chemin exact pris en charge au lieu de déduire la compatibilité de la présence ou de l’absence d’une clé API.
Cache de prompts : avant la couche outils
Le cache réutilise le calcul du fournisseur pour un préfixe correspondant. Il ne retire pas nécessairement ce préfixe de la fenêtre de contexte du modèle. Un compresseur qui réécrit un préfixe établi peut réduire le nombre de tokens au prix de davantage d’écritures ou de défauts de cache. Évaluez les deux ensemble.
Gardez les instructions stables avant les données variables de la tâche lorsque le client le permet. Consignez séparément les entrées nouvelles, écritures de cache, lectures de cache et sorties, avec les tarifs et règles de rétention actuels du fournisseur. Aucune durée de vie de cache ni aucun multiplicateur de prix unique ne s’applique à tous les fournisseurs et modèles.
L’approche de récupération de Headroom ajoute une dépendance : conserver un original n’est utile que s’il reste disponible et si l’agent le récupère quand il en a besoin. TTL, éviction et échecs de récupération font partie du test. Un contenu compressé plus petit ne prouve pas une qualité de réponse inchangée. Sources et documentation Headroom
Ce qui ne fonctionne pas, et mesurer d’abord
Diviser un nombre d’octets ou de caractères par quatre est une heuristique, pas un tokenizer OpenAI. L’erreur dépend de la langue et du contenu, sans nécessairement aller dans un seul sens. Utilisez les données d’usage du fournisseur pour les requêtes facturées, ou identifiez le tokenizer d’une estimation hors ligne.
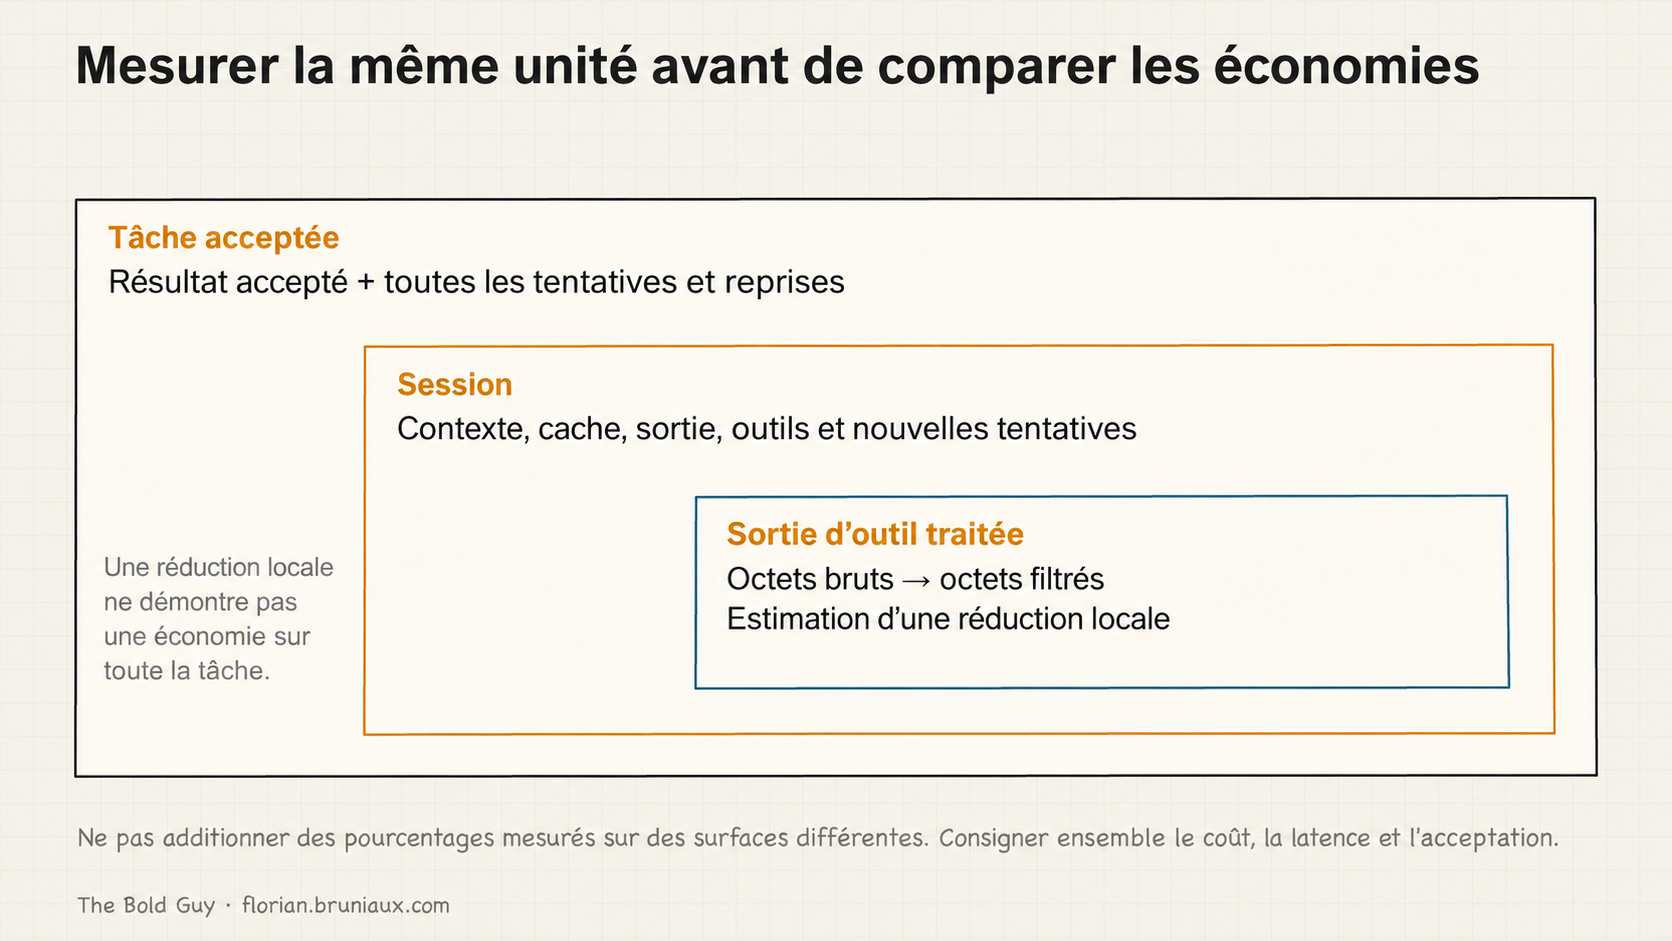
Évitez les camemberts universels assignant des parts fixes aux sorties shell, lectures de fichiers et réponses du modèle. Ces parts changent selon la tâche, et le volume de tokens n’est pas le coût. De même, les économies de mécanismes séparés ne s’additionnent pas simplement : ils peuvent viser le même contenu ou changer le comportement ultérieur de l’agent.
Que faire lundi
- Sélectionnez des tâches représentatives avec un résultat vérifiable, dont une où un détail exact doit survivre à la compression.
- Consignez l’usage et le résultat de l’agent non modifié sur des exécutions répétées.
- Testez une configuration d’outil de réduction à la fois, avec le même modèle, les mêmes entrées et la même politique de cache.
- Comptez les tentatives échouées, nouvelles tentatives, appels aux exécutants, coûts de préparation et tout abonnement à l’outil de réduction.
- Gardez la configuration uniquement si l’amélioration tient avec une qualité de tâche acceptable.
Un contenu local plus petit est une preuve utile sur un filtre. Un coût inférieur par tâche acceptée est une preuve sur le workflow. Avec un abonnement, mesurez aussi la capacité utilisable et l’effort de review au lieu de promettre un forfait mensuel plus bas.
La première partie traite du problème de contexte ; la deuxième de la maintenance. La référence contexte du guide suit l’écosystème plus large.
Gardez les économies de tokens à côté du coût par tâche acceptée. Incluez tentatives infructueuses, nouvelles tentatives, review et reprises ; gardez les minutes humaines séparées de l’argent sauf valorisation explicite. Si aucune tâche n’est acceptée, le ratio est indéfini. Une facture de contexte plus faible peut coexister avec une vérification plus coûteuse.
YSNK
- Les outils peuvent agir à plusieurs endroits d’une même session ; classez séparément mécanismes et périmètres d’intégration.
- Les estimations locales de RTK ne sont ni une facture ni le contrefactuel d’une session complète.
- Tokenade publie une configuration plus large et des résultats favorables obtenus par le fournisseur, tout en distribuant un moteur propriétaire.
- La découverte native des outils et le cache fournisseur influent sur le coût des outils tiers de réduction.
- Évaluez des tâches complètes, avec échecs et reprise, avant de combiner des outils.
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source