4/6 · Les responsabilités autour du context engineering
Une carte des responsabilités du context engineering : architecture, spécifications, identité des agents et évaluation, avec des pistes concrètes pour les compétences existantes.
Aller au résumé ↓ Florian Bruniaux
Context Engineering · Partie 4/6
TL;DR
Je pense que la plupart des gens gardent leur métier et y ajoutent une couche : la vague IA relève davantage le niveau attendu dans les rôles existants qu’elle n’en crée de nouveaux. Le context engineering comme discipline est absorbé par le harness engineering, mais je m’attends toujours à voir « context engineer » devenir un vrai titre de poste dans les deux ans, car ce travail a besoin de responsables. Ce qui compte, c’est le travail démontré et les compétences derrière les responsabilités, pas l’étiquette.
| Le déplacement | Prompt engineer était la première vague. Context engineer est le rôle décrit dans cette série |
| Le groupe | Des responsabilités qui se recouvrent autour des agents en production ; les titres ne sont pas standardisés |
| Harness engineer | Combat l’entropie IA : du code qui semble correct fichier par fichier, mais qui dérive à l’échelle du système |
| Spec engineer | Rend les exigences explicites et vérifiables ; une spécification ne garantit pas une implémentation correcte |
| Agent identity architect | Prend en charge l’authentification à portée limitée, les permissions et l’isolation des identifiants |
| AI eval engineer | Construit des évaluations structurées et calibre le jugement humain et automatisé |
Les trois premières parties couvraient le travail : pourquoi le contexte se dégrade, comment garder une configuration fidèle au réel et quels outils réduisent le coût. Celle-ci traite des personnes, et précisément des métiers du context engineering : de nouvelles étiquettes recouvrent des responsabilités déjà présentes dans les équipes d’ingénierie. Pour le côté exécution technique au quotidien de ces rôles, le playbook L0 à L5 est la version praticienne de ce même déplacement.
Le point de départ utile est le travail derrière le titre : quelqu’un conçoit les informations et outils reçus par le modèle, puis vérifie le comportement de cette configuration. Le guide rassemble les responsabilités et compétences associées sur cc.bruniaux.com/roles. Cet article cartographie ce travail ; il ne mesure ni volume d’embauches, ni distribution salariale, ni croissance des titres de poste.
L’histoire la plus intéressante est le groupe de rôles qui s’est formé autour.
De prompt engineer à context engineer
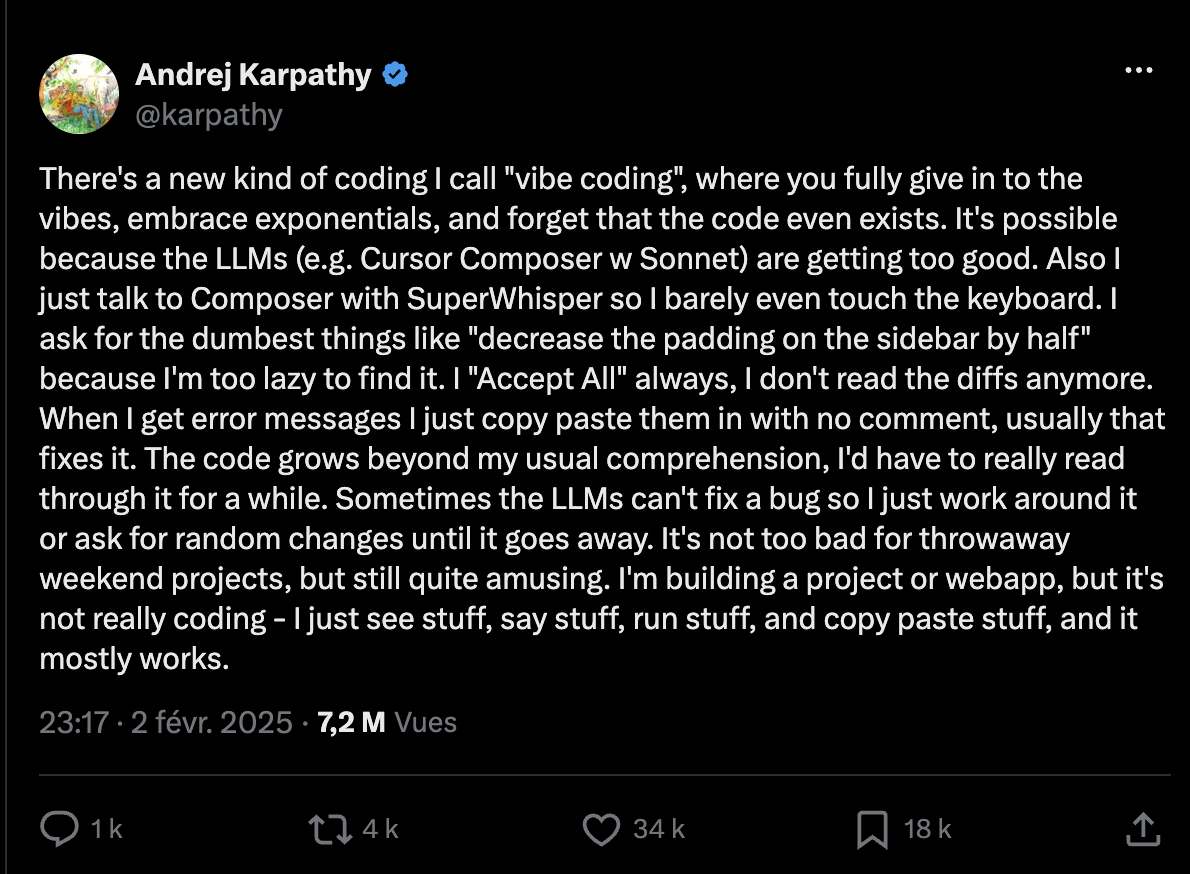
Andrej Karpathy a forgé « vibe coding » début 2025, puis soutenu un cadre plus précis pour la version sérieuse de ce travail : le context engineering, terme que Tobi Lütke venait de mettre en circulation. Philipp Schmid, chez Google, l’a formulé simplement : le context engineering consiste à fournir les bonnes informations et les bons outils, au bon format, au bon moment.
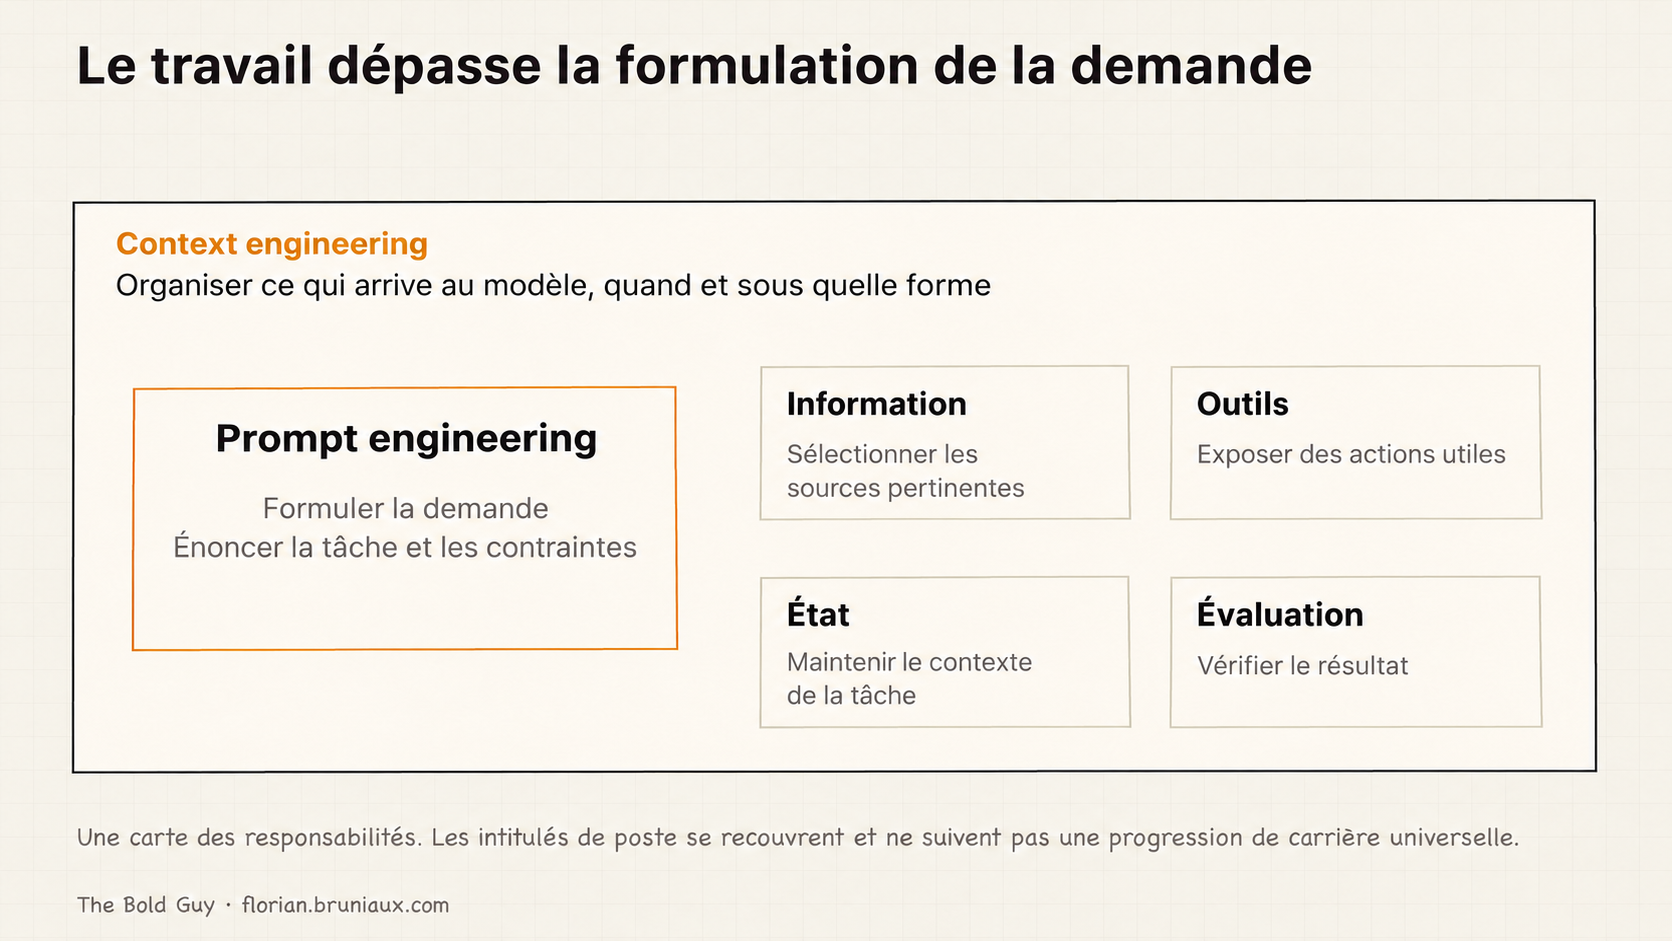
Le périmètre passe de la formulation d’une demande à l’organisation des informations, outils et états qui la sous-tendent. La conception des prompts reste une partie de ce travail. Les équipes peuvent confier ces responsabilités aux rôles existants de plateforme, produit ou staff engineering plutôt que créer un titre distinct.
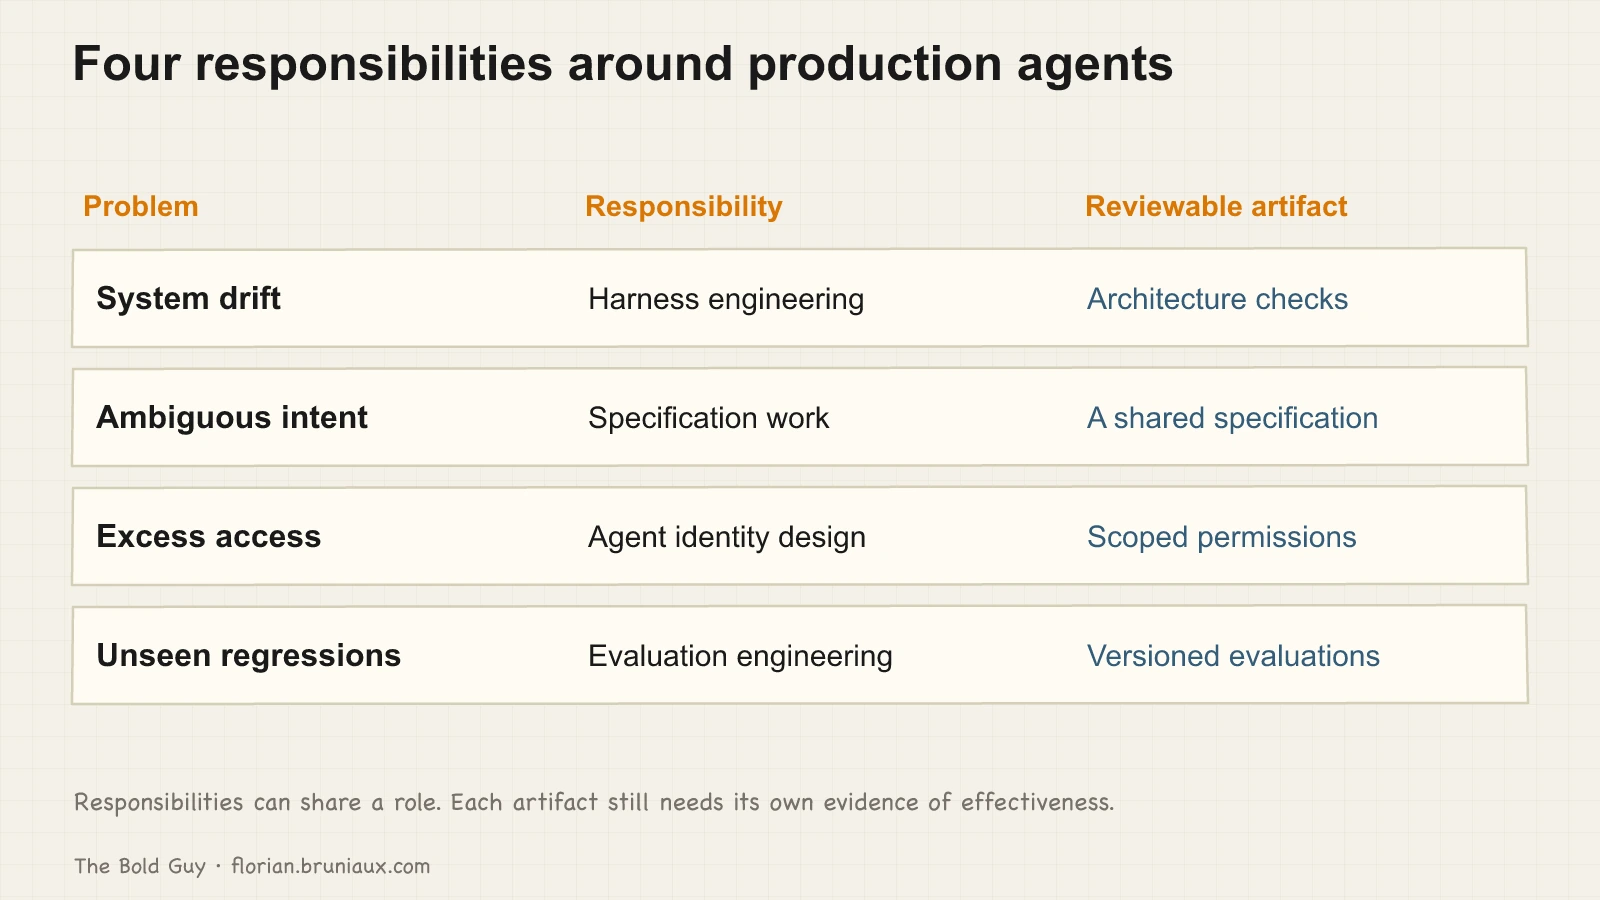
Quatre responsabilités autour des agents en production
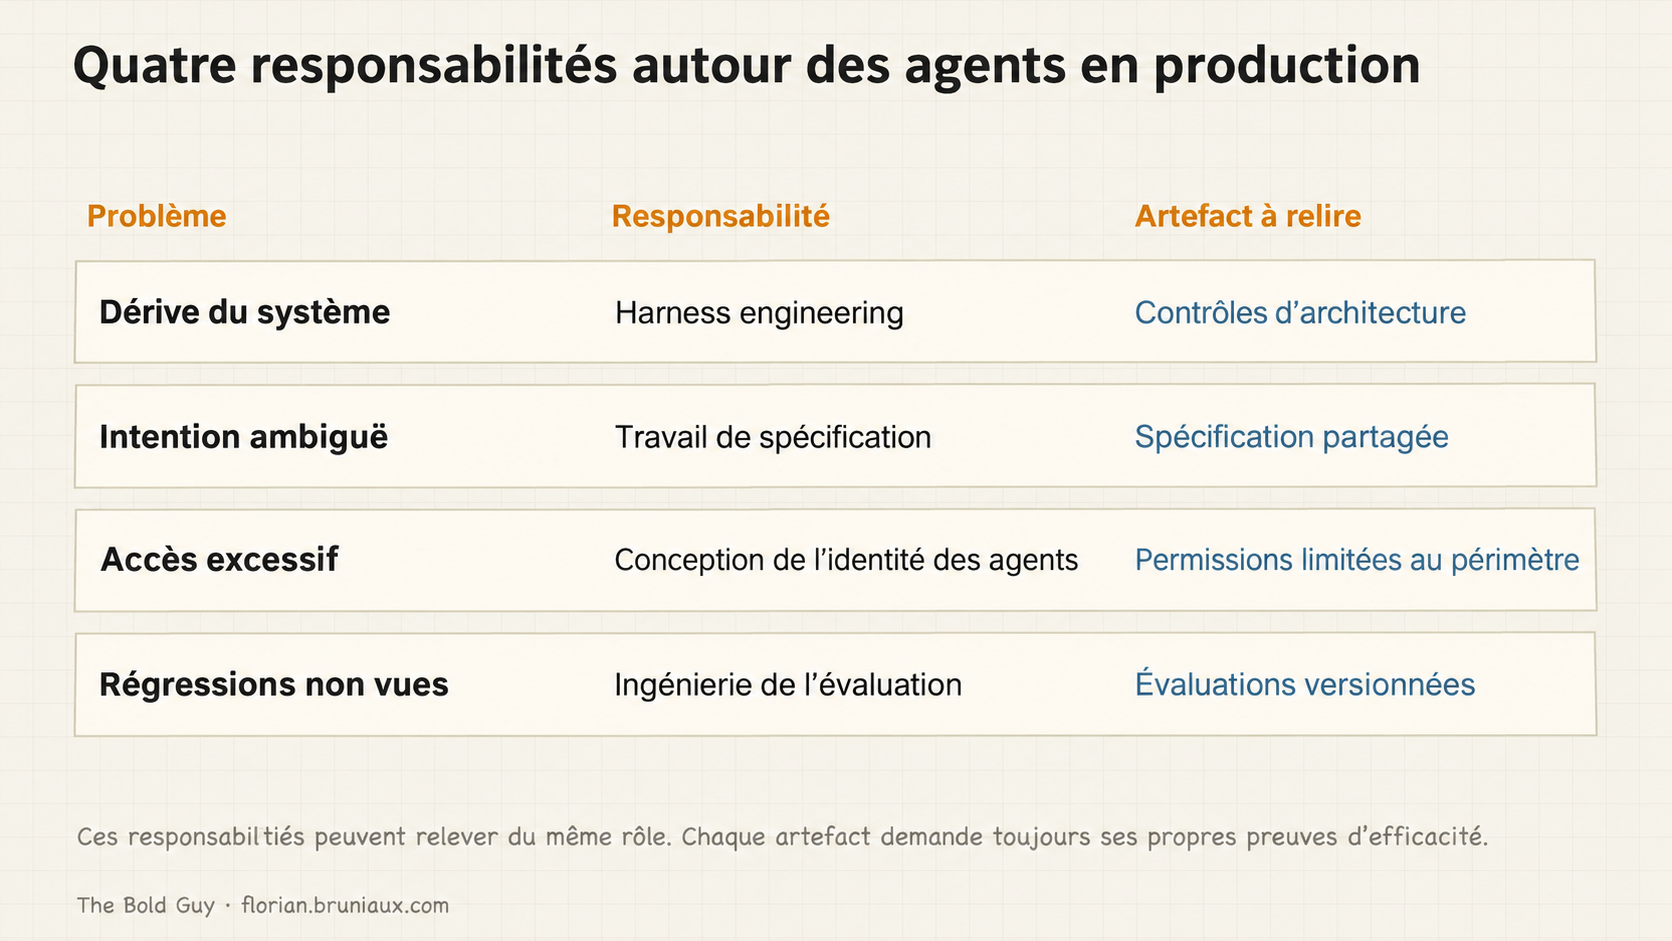
Quatre responsabilités aident à organiser les problèmes autour des agents en production. Les étiquettes ci-dessous sont des descriptions utiles, pas une classification professionnelle standardisée.
Le harness engineer. Martin Fowler a nommé ce rôle, et l’idée dispose désormais de sa propre littérature de synthèse (arXiv:2605.18747, « Code as Agent Harness », mai 2026 ; traduction : « Le code comme harnais d’agent »). Le problème traité est contre-intuitif. Le risque de l’IA dans une codebase n’est pas qu’elle écrive du mauvais code, mais qu’elle écrive du code qui semble correct fichier par fichier et qui dérive à l’échelle du système. Faites tourner assez d’agents et l’architecture s’érode sans qu’une modification particulière soit fausse. Le harness engineer construit l’infrastructure qui maintient le cap : watchdogs, linters d’architecture, mécanismes qui permettent à une flotte d’agents de produire quelque chose qu’un humain peut encore maintenir. Comme l’expliquait Fowler, un modèle brut n’est pas un agent ; il le devient une fois connecté à un harnais. Le titre n’est pas encore standardisé. Il est pour l’instant absorbé par les rôles de plateforme et de staff engineering, précisément là où vivent les titres précurseurs avant d’avoir leur ligne dans les offres d’emploi.
Le spec engineer. Une spécification donne à l’implémentation et aux reviewers une référence explicite : comportement attendu, contraintes et exemples d’acceptation. Un reviewer séparé peut comparer le résultat à cette référence. La spécification nécessite elle-même une review, et son existence n’implique pas un taux de réussite parfait. La responsabilité consiste à garder l’intention assez précise pour un agent, assez lisible pour l’équipe produit et assez stable pour la comparer au changement livré.
L’agent identity architect. Ce rôle est né d’une attaque documentée. Simon Willison a nommé la « lethal trifecta » (traduction : « triple combinaison mortelle ») : donnez à un agent accès à des données privées, exposez-le à du contenu non fiable, autorisez-le à communiquer à l’extérieur et vous obtenez un chemin d’exfiltration. Ce rôle existe parce que les entreprises ont remis les clés aux agents avant de construire les serrures. L’agent identity architect conçoit leur authentification, leur périmètre d’action et le blocage de l’escalade de privilèges lorsqu’un agent enchaîne ses appels d’outils avec ceux d’un autre. Guillaume Lours a décrit une implémentation concrète pour des agents très autonomes : une micro-VM avec injection des identifiants au niveau réseau, où l’agent reçoit les identifiants via un proxy man-in-the-middle sans jamais les voir directement (épisode 360). L’agent est contraint par ce que l’infrastructure accepte de lui remettre, pas par sa propre politique. Ce travail demande une connaissance approfondie de l’IAM et un responsable explicite des frontières d’authentification et de permissions.
L’AI eval engineer. Cette responsabilité rend les régressions observables avec des cas de test définis, des critères d’acceptation et des résultats versionnés. Review humaine et juges LLM peuvent contribuer, mais les deux nécessitent un calibrage. Un vérificateur séparé est un choix de conception de l’évaluation ; son indépendance et son taux d’erreur restent à vérifier. Le retour de Louis Pinsard dans IFTTD traite du jugement LLM asynchrone pour recueillir des retours de production sans placer chaque contrôle sur le chemin de réponse de l’utilisateur. La possibilité d’exécuter un contrôle de façon asynchrone dépend de ce qu’il doit empêcher.
Ce qu’est devenu votre rôle actuel
Le cas le plus clair est l’ingénieur logiciel qui devient AI engineer, un rôle combinant livraison logicielle, intégration de modèles et évaluation. Le travail reste reconnaissable : construire du logiciel, en ajoutant à la stack l’intégration LLM, l’évaluation et le jugement produit sur les limites des modèles. Ni chercheur qui entraîne des modèles, ni pur intégrateur.
Deux expressions ne doivent pas être confondues avec des métiers. « AI-native engineer » (traduction : « ingénieur natif de l’IA ») désigne un socle de plus en plus attendu de tous plutôt qu’un poste auquel candidater. « Vibe coder » est une méthode, et aucune entreprise sérieuse ne le met dans une demande de recrutement. La vague IA relève davantage le niveau attendu dans les métiers existants qu’elle ne crée de nouveaux métiers.
L’exception est le démarrage d’entreprise. Le founding AI engineer est un vrai hybride, à la fois ingénieur, responsable produit et cofondateur technique, visant généralement des personnes ayant 0 à 4 ans d’expérience, à l’aise pour porter une fonctionnalité de bout en bout et utilisant déjà ces outils chaque jour. L’effet de levier est fort dans les deux sens, ce qui en fait tout l’attrait et tout le risque.
Live AIDD : des fonctionnalités à la maintenance du harnais
À 42:00 du live AIDD du 16 octobre 2026, je décris ce déplacement dans mon propre travail. J’ai commencé comme premier développeur chez Méthode Aristote. À mesure que d’autres personnes ont rejoint l’équipe et produit davantage de changements, j’ai consacré plus de temps à maintenir le harnais, enquêter sur les échecs et décider quoi changer dans le workflow. Je continuais d’écrire des fonctionnalités pour combler un manque, réaliser une intégration ou traiter une tâche complexe.
Ce retour met du travail concret derrière le rôle : quelqu’un doit avoir du temps pour comprendre l’échec d’un contrôle et maintenir les outils dont les autres dépendent. Il décrit mes responsabilités dans une équipe, sans établir de tendance de recrutement ni de ratio d’effectif. Ces propos viennent du live AIDD, distinct de la conférence Dev With AI du 12 octobre, avec des sous-titres automatiques et quelques minutes d’ouverture manquantes.
Dans ma conversation IFTTD avec Bruno Soulez, je reviens sur qui construit ce système et sur la façon dont réduire la review ligne par ligne change le travail du mainteneur.
Une interface déployée peut encore passer à côté du travail de l’utilisateur
Léa Buendé, FDE chez Adobe, raconte dans l’épisode 373 d’IFTTD une mission auprès d’ingénieurs terrain habitués aux manuels papier. Sa proposition de chatbot ne correspondait pas à leur façon de chercher l’information. Elle la raconte dans le fil de sa carrière : ce n’est donc pas nécessairement une mission Adobe.
Cela définit une responsabilité concrète d’adoption : observer les utilisateurs réels accomplir une tâche, découvrir les informations qu’ils fournissent et vérifier que l’interaction convient à leur environnement. Une intégration fonctionnelle démontre l’implémentation. L’adoption nécessite des preuves d’usage.
Rendez les responsabilités attribuables : un mainteneur est responsable de chaque contrôle et de ses tests d’échec, un acteur autorisé est responsable de l’acceptation du changement et un responsable nommé protège la capacité de vérification. Une personne peut cumuler plusieurs responsabilités. L’organisation doit quand même expliquer qui traite une preuve périmée, une review contradictoire ou un résultat que personne ne peut vérifier pour l’instant.
Ce que cela signifie pour vous qui lisez
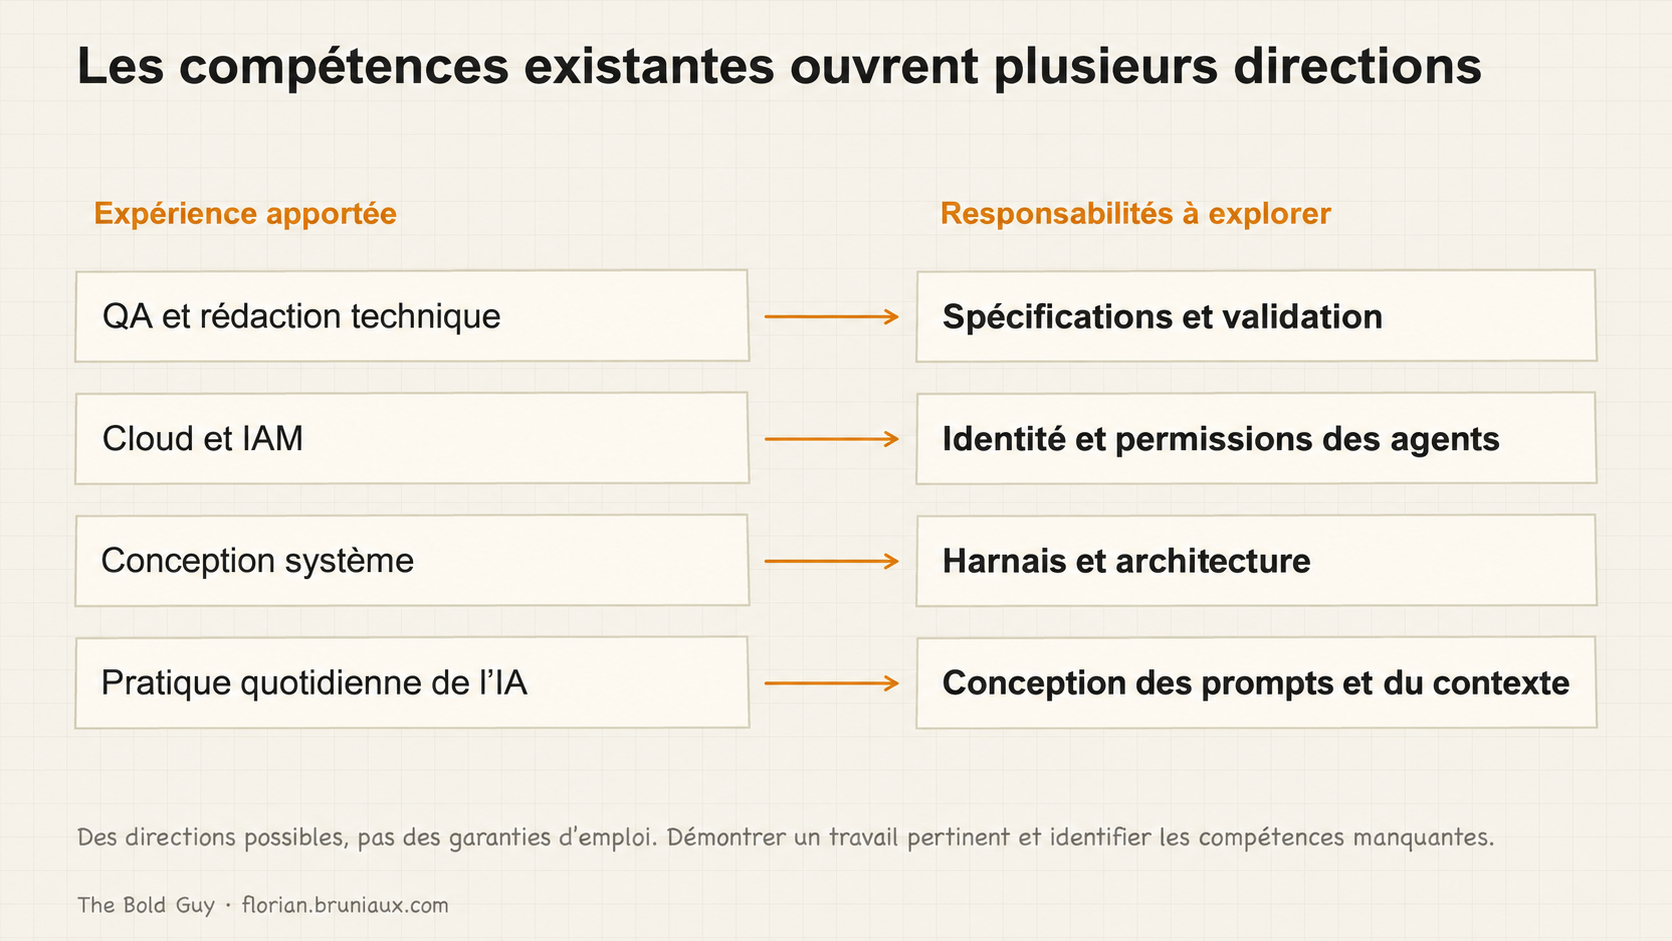
L’expérience existante fournit des points de départ utiles. QA et rédaction technique peuvent soutenir le travail de spécification et de validation ; cloud et IAM, la conception des identités ; conception système, le travail sur les harnais. Le travail démontré et les compétences manquantes comptent plus qu’une nouvelle étiquette.
Construisez un exemple borné, documentez les décisions, ajoutez une évaluation et consignez où vos compétences actuelles étaient insuffisantes. Pour le travail intellectuel non technique, le guide Cowork offre un autre point d’entrée.
Les trois premières parties donnaient la pratique : contexte, maintenance et outils. Ces responsabilités décrivent qui peut prendre en charge ce travail lorsque plusieurs personnes en dépendent.
La cinquième partie montre cette pratique quand six développeurs partagent le même système d’instructions : profils, pipeline de synchronisation, contrôles CI qui repèrent la dérive avant la production.
Retours du terrain via les transcriptions d’IFTTD : Louis Pinsard, épisode 338 sur le LLM-as-judge asynchrone en production ; Guillaume Lours, épisode 360 sur l’isolation des identifiants pour les agents autonomes ; Antonio Goncalves, épisode 357 sur le vocabulaire IA comme socle attendu en 2026.
Si vous avez pris l’un de ces rôles, ou vu votre métier se transformer discrètement en l’un d’eux, j’aimerais savoir quelle partie de la description correspondait et laquelle les recruteurs avaient mal comprise.
YSNK
(Ce que vous devriez maintenant savoir)
- Les responsabilités peuvent se recouvrir et vivre dans des postes existants ; les titres ne forment pas une échelle de carrière standardisée
- Une spécification est une référence à relire, pas la preuve d’une implémentation correcte
- Les permissions à portée limitée et l’isolation des identifiants nécessitent une application technique au-delà d’une instruction à l’agent
- Reviewers humains et juges automatisés nécessitent tous deux un calibrage ; un vérificateur indépendant n’est pas automatiquement fiable
- Les compétences existantes suggèrent des pistes, tandis que la pratique démontrée établit ce qu’une personne sait actuellement faire
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Ces ressources apportent des angles complémentaires. Elles ne représentent pas des niveaux de maturité.