1/6 · Résultats opposés avec l’IA : ce que le contexte peut expliquer
Anthropic a mesuré les PR fusionnées ; METR a mesuré la durée des tâches dans un autre cadre. Ce qu’établissent ces résultats et la recherche sur le contexte long, et ce qui reste une hypothèse.
Aller au résumé ↓ Florian Bruniaux
Context Engineering · Partie 1/6
TL;DR
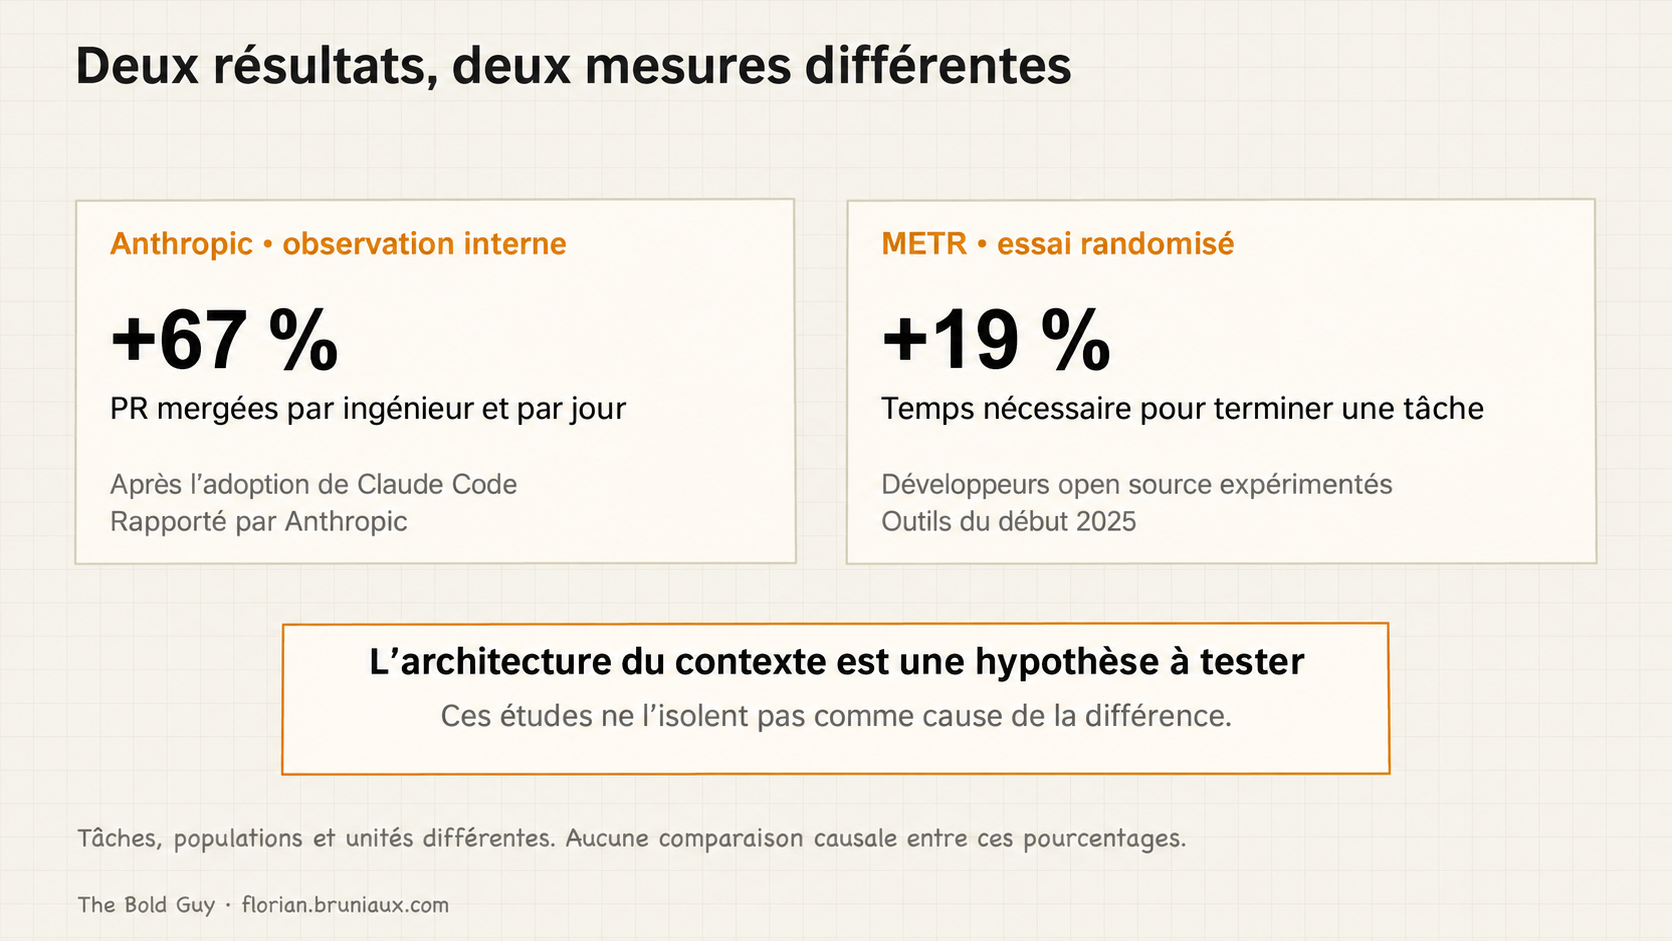
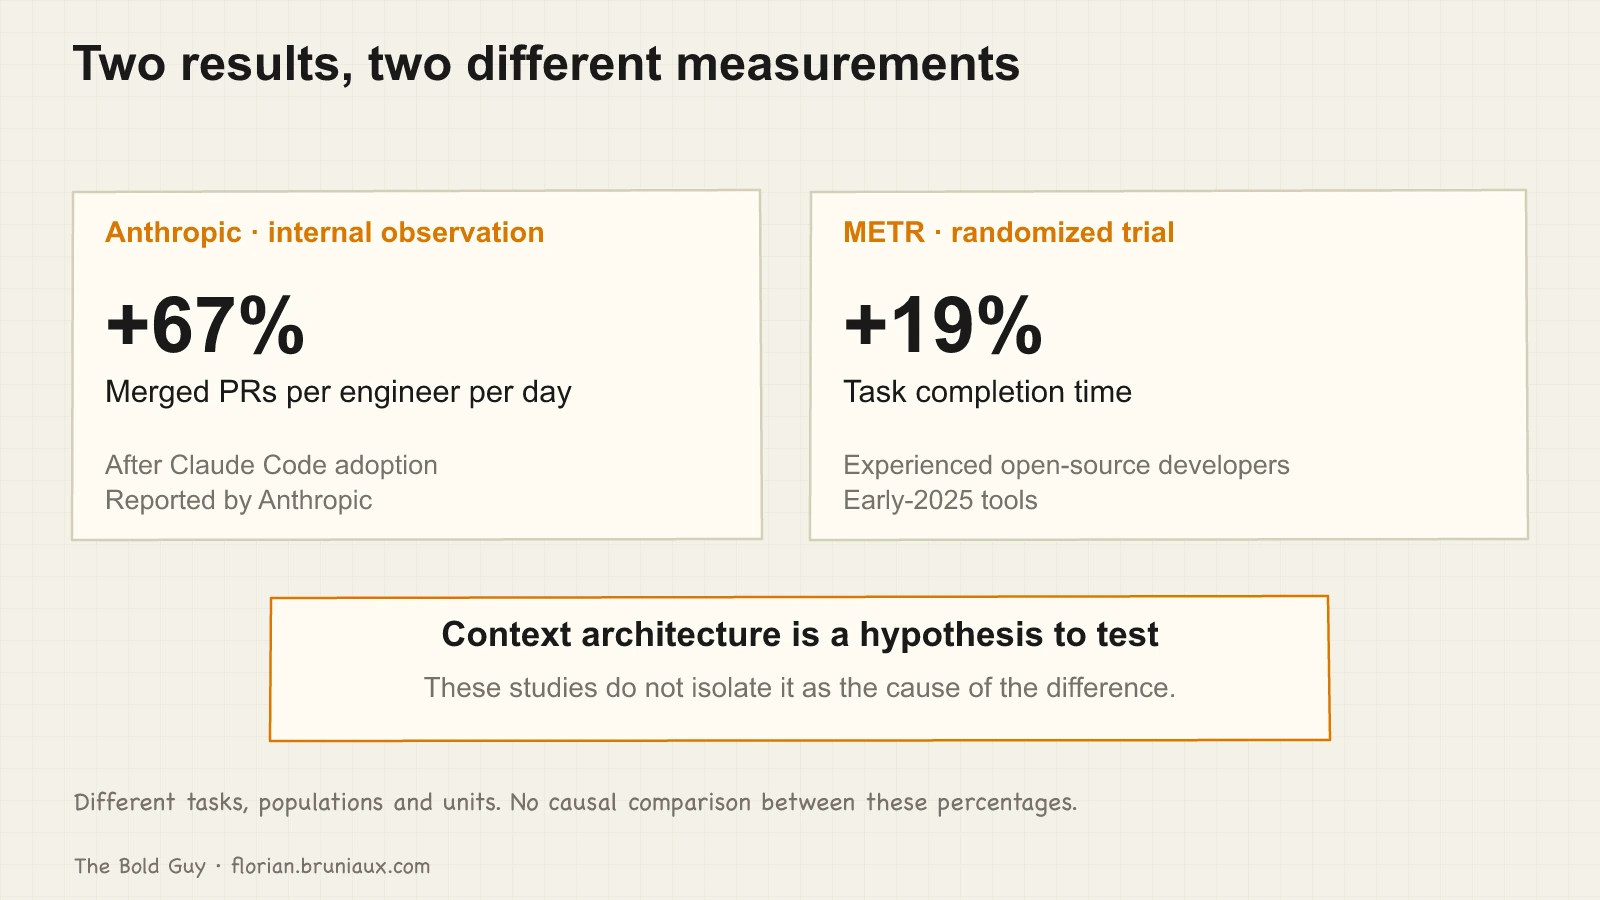
Je pense que le contexte explique une partie de l’écart entre les 67 % de PR fusionnées en plus chez Anthropic et les tâches 19 % plus longues chez METR, comme un facteur parmi d’autres, sans que ces deux études puissent dire dans quelle proportion. Le contexte fait partie du couple modèle-harnais évalué : je m’attends donc à ce que le context engineering soit absorbé par le harness engineering en tant que discipline. Dans les deux ans à venir, je m’attends tout de même à voir encore le titre de poste « context engineer », car cette discipline aura toujours besoin d’un responsable.
| Deux observations | Anthropic : davantage de PR fusionnées par ingénieur et par jour. METR : durée de réalisation des tâches plus longue |
| Limite de preuve | Populations, tâches et unités différentes ; les études n’isolent pas le contexte comme explication |
| Contexte long | La performance peut varier selon le modèle, la tâche, la longueur des entrées et la position des informations |
| Le déplacement | La conception des prompts s’inscrit dans le travail plus large de sélection des informations, des outils et de l’état de la tâche |
| Objectif pratique | Préserver les preuves nécessaires, exclure les détails sans rapport, puis vérifier la qualité et le coût |
Anthropic a rapporté 67 % de pull requests fusionnées en plus par ingénieur et par jour après l’adoption de Claude Code. Dans un essai randomisé distinct de METR, 16 développeurs open source expérimentés travaillant sur 246 tâches ont mis 19 % de temps en plus avec les outils IA du début 2025 autorisés dans l’expérience.
Ce sont des mesures différentes dans des cadres différents. Un débit de PR fusionnées n’est pas une durée de tâche, et une observation interne n’est pas une comparaison randomisée. Aucune étude n’établit que les participants utilisaient le même modèle, la même stack ou le même système de contexte. Elles ne montrent pas que les participants de METR repartaient d’un contexte projet vide chaque matin.
Mon hypothèse est que la façon dont une équipe assemble le contexte explique une partie de ces différences, parmi d’autres facteurs. La tester nécessite une comparaison qui garde stables le modèle et les conditions des tâches tout en changeant la configuration du contexte. Ces deux études ne fournissent pas cette expérience.
Ce qu’est réellement la dégradation du contexte
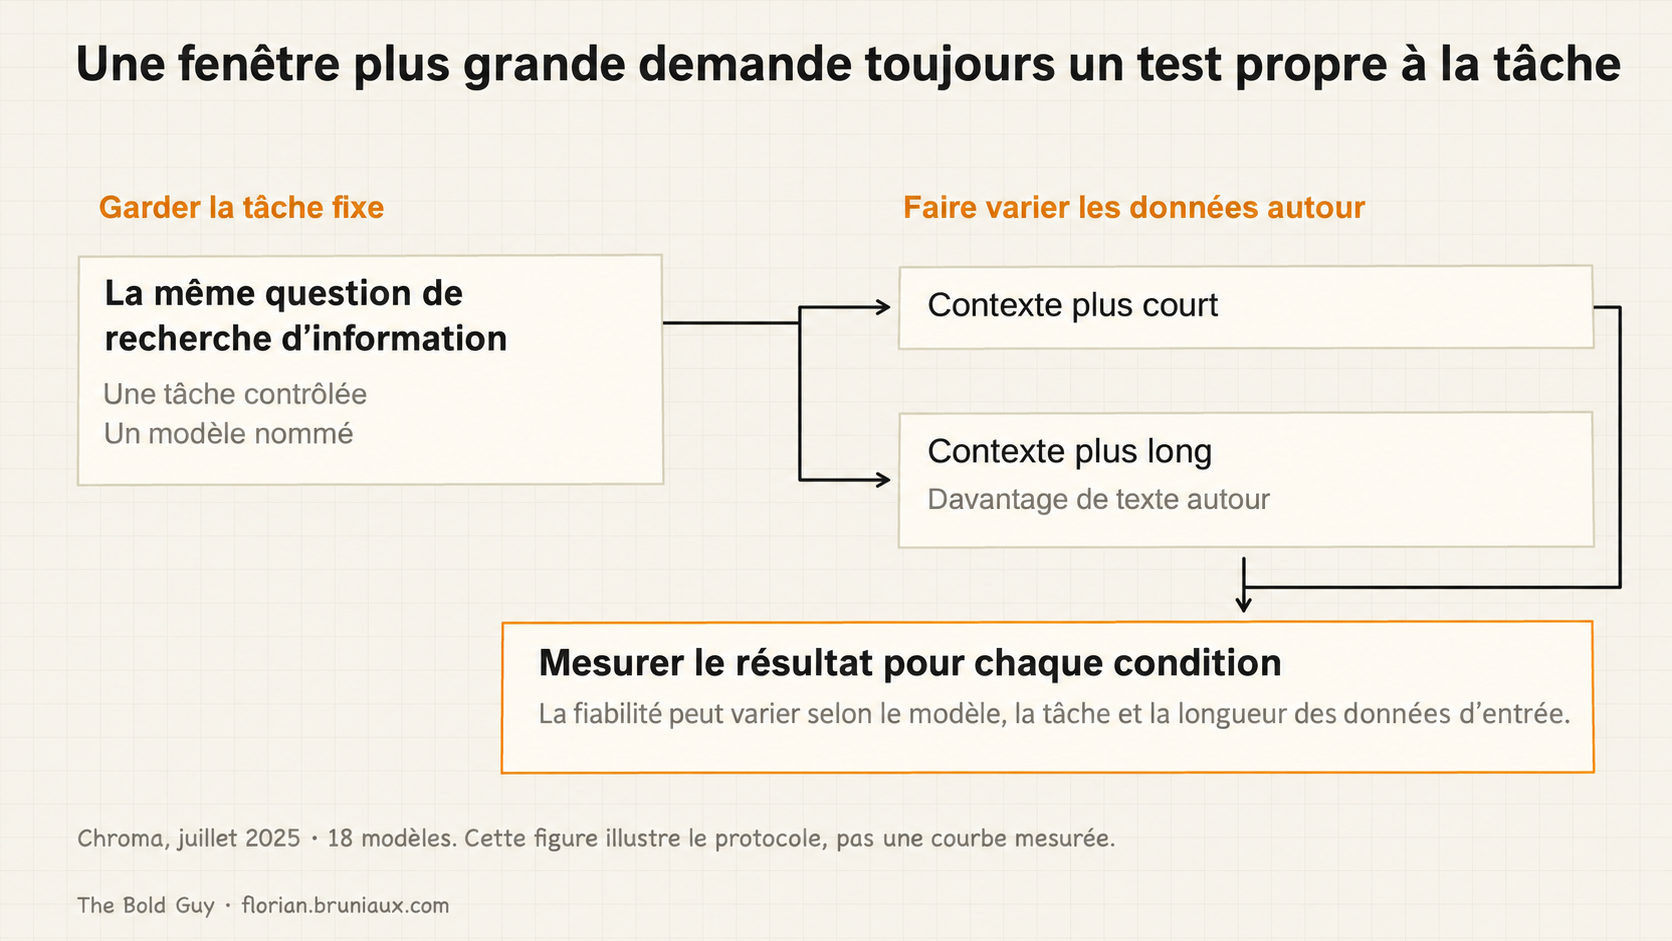
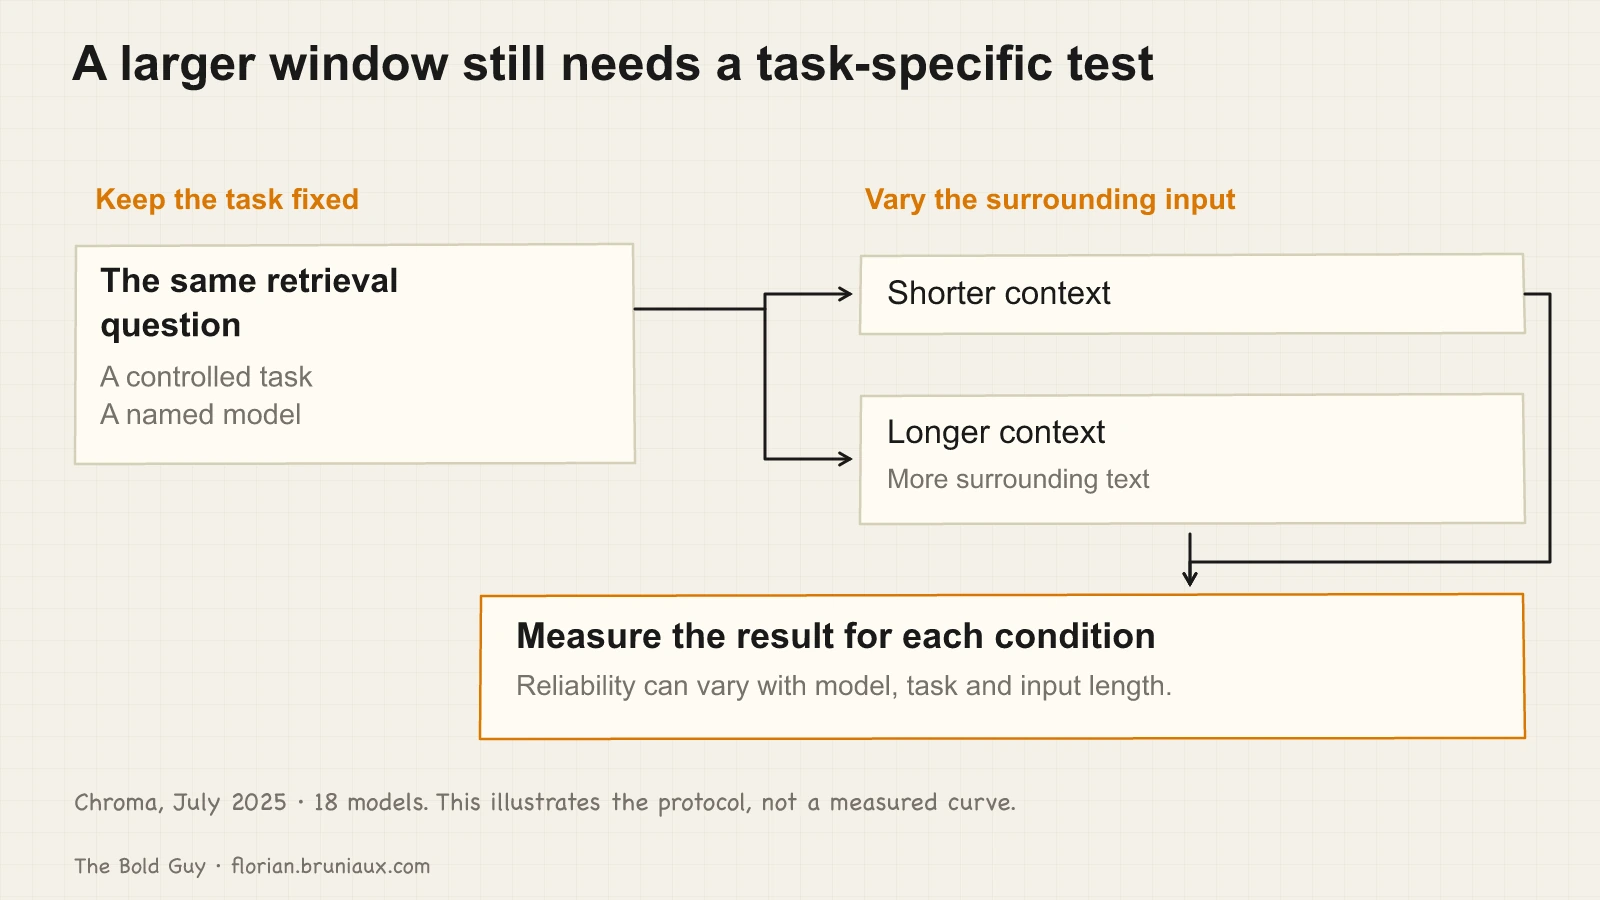
L’étude de Chroma Research de juillet 2025 a testé 18 modèles en faisant varier la longueur des entrées sur des tâches contrôlées. Elle a constaté que des entrées plus longues peuvent réduire la performance même quand l’information nécessaire reste présente. L’ampleur et la forme de l’effet varient selon le modèle et la tâche ; aucune courbe unique de précision ne décrit toutes les sessions.
La distinction porte sur l’acceptation d’une entrée et son utilisation fiable. Une fenêtre annoncée plus grande indique ce qui tient dedans. Elle ne dit pas, à elle seule, si un modèle répondra correctement à votre question précise.
Lost in the Middle de Liu et ses collègues a également constaté une sensibilité à la position de l’information pertinente pour des questions-réponses sur plusieurs documents et la récupération de paires clé-valeur. Ces résultats justifient de tester le placement et la longueur. Ils n’établissent ni seuil universel de tokens, ni zone fiable fixe, ni limite architecturale qu’aucune amélioration de modèle ne pourrait changer.
Capacité et usage effectif sont des mesures différentes
Pour une évaluation utile, nommez le modèle, la tâche, les longueurs d’entrée et le critère d’acceptation. Testez assez d’exemples pour voir si le résultat tient au-delà d’une réponse réussie. Une fenêtre effective propre à la tâche peut alors décrire où ce critère reste satisfait.
Cela ne prouve pas qu’une fenêtre de 128K gérée bat une fenêtre de 1M non gérée sur la plupart des travaux réels. Une fenêtre plus grande peut être nécessaire si les preuves elles-mêmes sont volumineuses ; la sélection du contexte doit encore être évaluée séparément.
La question pratique est de savoir quelles informations cette tâche nécessite et comment le modèle les utilise, plutôt que de comparer les capacités annoncées les plus grandes.
Prompt engineering et context engineering
J’utilise ici context engineering pour désigner la conception des informations, instructions, outils et états dont un modèle dispose pendant son travail. Le prompt engineering en fait partie : il formule la demande et ses contraintes. Le context engineering traite aussi de ce sur quoi la demande repose.
| Dimension | Prompt engineering | Context engineering |
|---|---|---|
| Périmètre | Une demande | Une session ou un système |
| Durée de vie | Peut être réutilisé ou révisé | Assemblé pour les tâches et maintenu au fil des interactions |
| Travail | Concevoir et tester la demande | Concevoir et tester ce sur quoi elle repose |
| Artefact | Une demande et des contraintes | Informations sélectionnées, outils, instructions et état |
Le prompt engineering, c’est griffonner une bonne note à un prestataire. Le context engineering couvre l’onboarding, le guide de style, la documentation d’architecture et les conventions d’équipe qui lui font comprendre le projet avant même de lire une note. L’un est une phrase. L’autre est un bâtiment. Le prompt engineering est un sous-ensemble du context engineering, et les équipes bloquées sur la qualité des réponses soignent souvent leurs phrases alors qu’elles doivent construire le bâtiment. Un modèle plus capable dans le même contexte insuffisant peut même aggraver les résultats. Guillaume Laforge a décrit un effet de « mansplaining » (traduction : « explication condescendante »), où un modèle suffisamment capable ignore le contexte injecté et génère plutôt à partir de ses acquis d’entraînement, produisant des réponses assurées mais fausses dans le contexte (épisode 361). La discipline complète, son budget, sa hiérarchie et son cycle de vie figurent dans la référence du guide sur le context engineering.
Garder assez de preuves, retirer les détails sans rapport
Qualité et coût nécessitent donc des observations séparées. Vérifiez le résultat au regard des critères d’acceptation de la tâche. Comparez les coûts à périmètre de facturation et charge de travail identiques ; une réduction locale des tokens ne donne pas automatiquement une facture d’abonnement plus faible ou une baisse proportionnelle du coût total de la tâche.
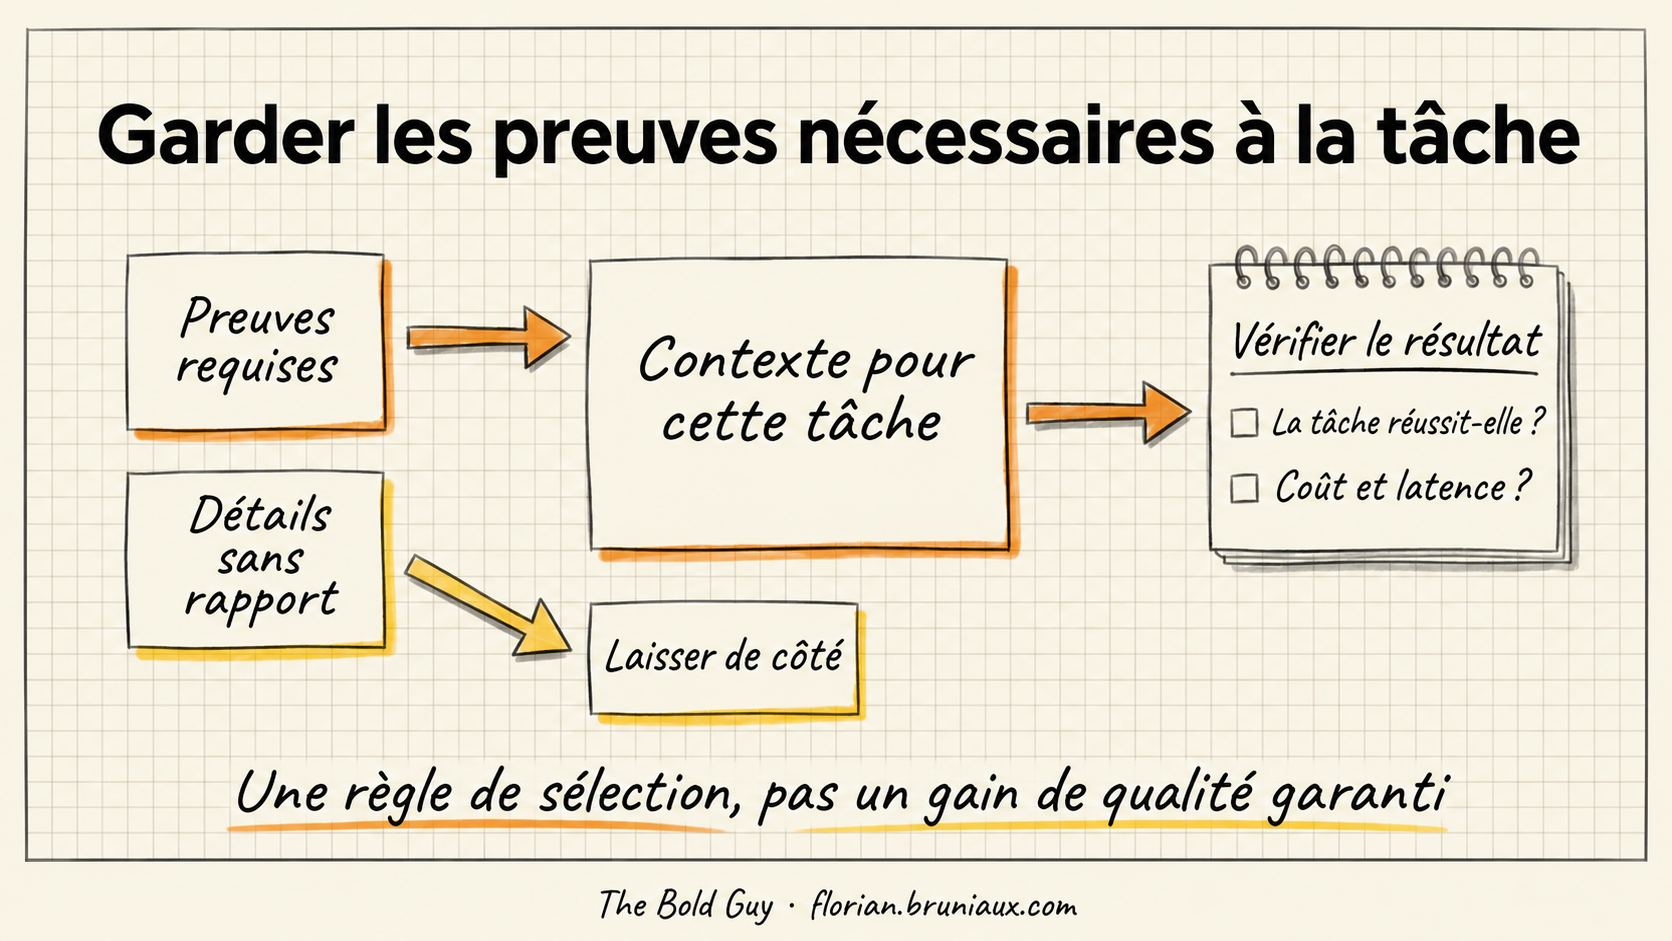
La suite de cette série traite de ces deux questions : comment maintenir et vérifier une configuration utile, et comment mesurer ce que changent les outils de réduction de tokens. Moins de contexte est une intervention à tester, pas une garantie de moins d’hallucinations.
Trois vérifications avant d’ajouter des outils
Trois choses méritent d’être faites avant de toucher à un outil.
- Consignez le modèle, la tâche et les conditions de contexte lorsqu’une session commence à produire des réponses incohérentes ou hors spécifications.
- Essayez de retirer le contenu sans rapport en préservant les preuves nécessaires pour vérifier la tâche ; comparez le résultat à la configuration initiale.
- Distinguez qualité des réponses, décomptes locaux de tokens, limites du compte et coût facturé avant de choisir une optimisation.
L’article suivant traite directement la pression sur la qualité : un modèle de maturité pour la configuration du contexte, pourquoi un CLAUDE.md qui fonctionne au premier jour commence à mentir sur votre projet trois mois plus tard et la boucle de vérification qui le détecte. Le troisième cartographie les outils : les mécanismes de réduction de tokens et les outils associés.
Retours du terrain, via les transcriptions d’épisodes d’IFTTD : Guillaume Laforge, épisode 361 sur la capacité du modèle face à l’ancrage contextuel ; Quentin Adam, épisode 341 sur l’orchestration de plusieurs modèles selon la taille de fenêtre de contexte.
Si vous avez vu le même modèle produire des résultats opposés dans votre équipe et dans une autre, je suis curieux de savoir quelle était la variable selon vous. Dites-moi où cela rejoint votre expérience et où ce n’est pas le cas.
Le contexte fait partie du couple modèle-harnais évalué. Le guide sur les harnais le relie aux outils, aux permissions, à la reprise après échec et à l’acceptation. Comparez ces changements sur les mêmes tâches et budgets avant d’attribuer un gain au seul contexte.
YSNK
(Ce que vous devriez maintenant savoir)
- L’observation d’Anthropic sur les PR fusionnées et l’expérience de METR sur la durée des tâches ont des unités et des populations différentes
- Ces études n’isolent pas l’architecture du contexte comme cause de leurs résultats différents
- Les évaluations de contexte long nécessitent un modèle nommé, une tâche, des conditions d’entrée et un critère d’acceptation
- Capacité, position de l’information et utilisation fiable sont des questions distinctes ; les études citées ici n’impliquent aucun seuil universel de zone fiable
- Gardez les preuves nécessaires, retirez les détails sans rapport et mesurez le résultat avant de revendiquer une amélioration
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source