De l'ajout secondaire à l'infrastructure : l'évolution de la configuration IA dans un vrai projet
Neuf mois de configuration IA dans un projet de production : responsabilités changeantes, génération par profils et réduction mesurée des lignes toujours actives.
Aller au résumé ↓ Florian Bruniaux
TL;DR
Je pense que la configuration IA ne se conçoit pas d’avance : on part d’un CLAUDE.md qui reflète honnêtement ce qu’on sait, et le reste apparaît avec les frictions. La systématisation devient nécessaire quand la collaboration l’impose, et à l’échelle d’une organisation cela signifie un repository central de configuration IA. J’en ai depuis construit un chez Méthode Aristote, et ma prédiction est que les équipes y résistent pendant des mois, puis le construisent vite quand la dérive de versions entre repos devient ingérable.
| Sujet | Détails |
|---|---|
| Projet | Plateforme EdTech Méthode Aristote, 9 mois (août 2025 → avril 2026) |
| Total historique de l’audit | 506 commits rapportés ; les lignes mensuelles totalisent 495, écart non réconcilié |
| Échelle actuelle | 407 fichiers dans .claude/, 34 règles, 15 hooks, 36 skills, 57 commandes, 17 agents |
| Répartition | Les décomptes mensuels listés montrent une concentration des commits de janvier à avril |
| 5 phases | Ajout secondaire → Documentation → Infrastructure → Pratique d’ingénierie → Amélioration continue |
| Context Diet | Avril 2026 : contexte toujours actif de 2 518 à 646 lignes (-74 %) ; les dénominateurs du score ont changé |
| Le big bang | 6 janvier 2026 : 86 fichiers créés en un jour (commit 1421e863) |
| Constat principal | La configuration IA ne se conçoit pas d’avance, ses besoins se découvrent au contact des frictions. |
C’est un retour sur l’évolution de la configuration IA pendant 9 mois d’usage soutenu sur une codebase de production, plutôt qu’un guide du CLAUDE.md parfait.
L’audit original utilisait git log --all --format="%ad" --date=format:"%Y-%m" -- CLAUDE.md .claude/ et rapportait 506 commits touchant la configuration IA, soit une part annoncée de 8,6 % de l’activité du repository, plus 149 changements de CLAUDE.md. Ce sont des affirmations historiques de l’audit, pas un recomptage récent. Les chiffres mensuels conservés ci-dessous totalisent 495. Cet écart reste non réconcilié ; le total rapporté ne doit pas être traité comme un dénominateur validé pour le tableau.
La répartition mensuelle historique
| Mois | Commits de configuration IA rapportés |
|---|---|
| Août 2025 | 5 |
| Septembre 2025 | 24 |
| Octobre 2025 | 34 |
| Novembre 2025 | 27 |
| Décembre 2025 | 27 |
| Janvier 2026 | 138 |
| Février 2026 | 81 |
| Mars 2026 | 116 |
| Avril 2026 | 43 (partiel) |
| Somme des lignes listées | 495 |
| Total original rapporté | 506, non réconcilié |
Janvier et mars sont les deux plus gros mois listés. Le récit ci-dessous relie ces pics à des décisions structurelles dans ce projet. Il n’établit pas de courbe universelle d’investissement.
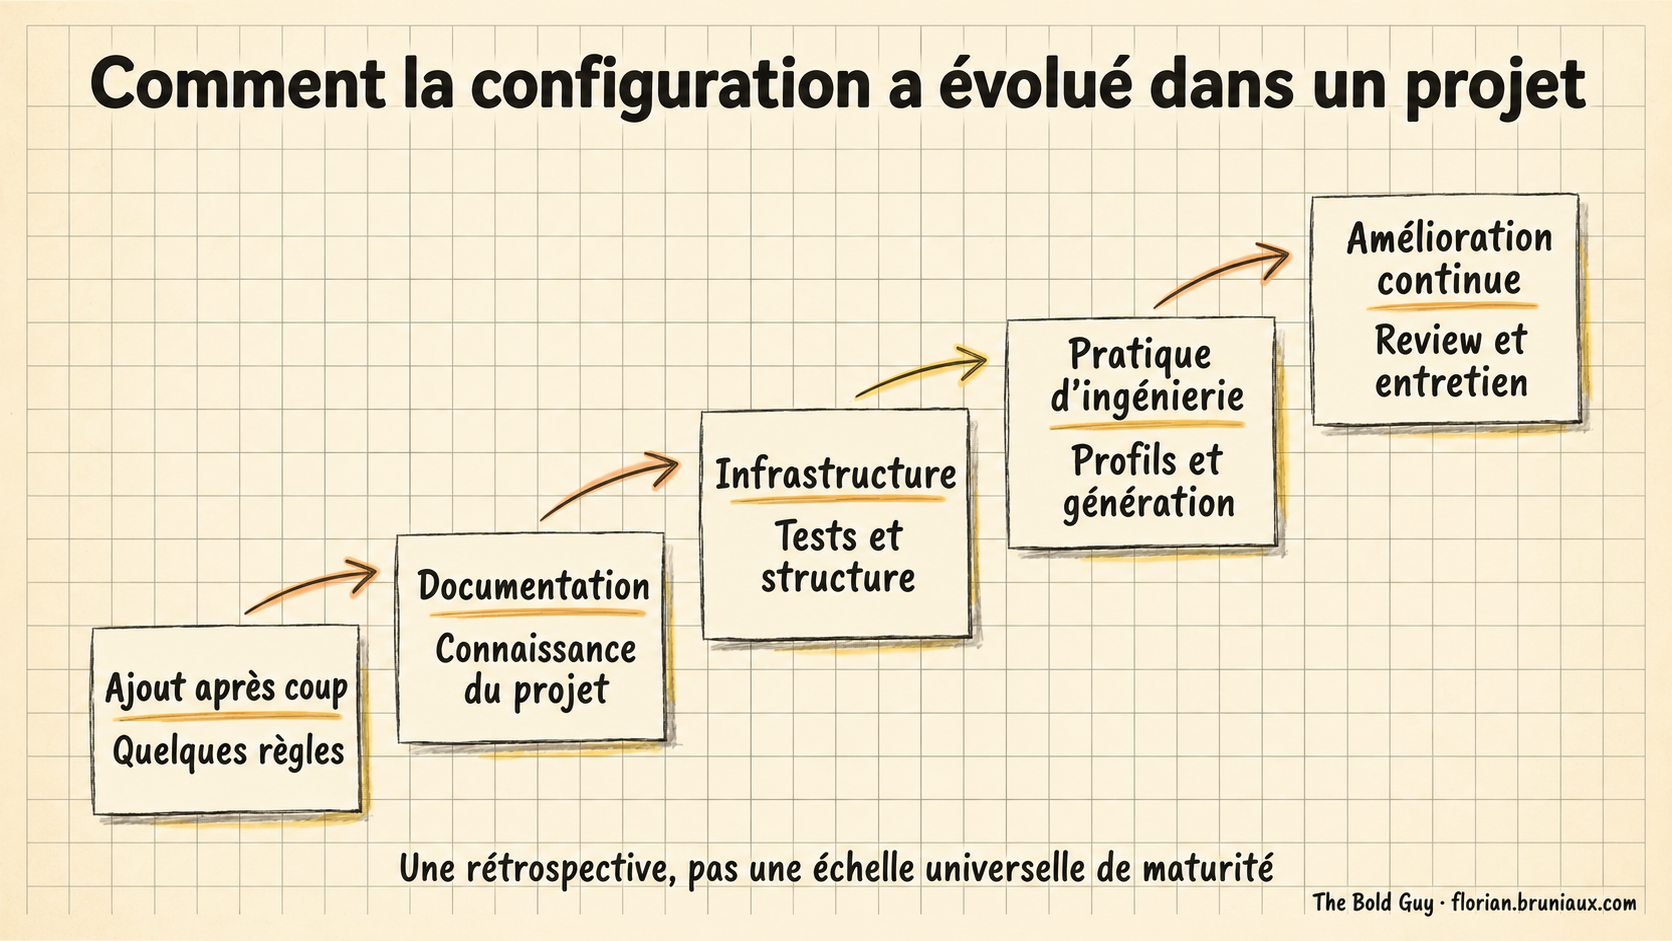
Phase 1 : la configuration comme ajout secondaire (août-septembre, 29 commits)
Le premier fichier de configuration IA. 22 août 2025, commit a48d5017b. CLAUDE.md, 282 lignes, livré dans la première release.
Le contenu était minimal. Identité du projet, stack T3 (Next.js, tRPC, Prisma), conventions de base. Un point de départ, pas un système.
Aug 22 ─── CLAUDE.md (282 lines) ──────── Born: AI config exists
Sep 05 ─── .claude/ directory ──────────── Dedicated structure
Sep 11 ─── .claude/commands/ ───────────── First slash commands
À ce stade, le modèle mental était simple : CLAUDE.md comme fichier de contexte, on écrit ce que l’IA doit savoir. Utile comme de la documentation, mieux que rien, mais pas encore un système.
L’IA avait les éléments évidents : stack du projet, conventions de nommage, intention architecturale de base. Tout ce qui comptait au quotidien manquait : le domaine métier, les schémas déjà établis, les raisons de décisions précises et ce qu’elle devait refuser de faire.
24 commits en septembre ont ajouté la structure du répertoire .claude/ et les premières commandes slash. Espaces de noms élémentaires : tech:commit, tech:PR, tech:review. Des raccourcis utiles pour les opérations répétitives.
À ce moment, une personne maintient informellement la configuration IA, la changeant quand quelque chose casse ou semble manquer. C’est encore un fichier auquel quelqu’un tient, plutôt qu’un système.
Phase 2 : la configuration comme documentation (octobre-décembre, 88 commits)
La phase 2 arrive quand l’IA commence à avoir besoin de contexte métier, pas seulement technique.
Oct 15 ─── .claude/agents/ (v0.8.0) ────── First custom agents
Oct 23 ─── knowledge-base.md (v0.10.0) ─── Business rules codified
Nov 04 ─── MCP Serena (v0.14.0) ─────────── Persistent memory
Nov 21 ─── CLAUDE.md -50% tokens ────────── First optimization pass
23 octobre : création de doc/knowledge-base.md. C’est alors que la configuration a commencé à encoder la connaissance métier plutôt que la seule installation technique. Mécanique des sessions (supervisées ou autonomes, tolérance de 15 minutes, décalages des doublets/triplets). Règles de cycle de vie des utilisateurs. Logique de rémunération des tuteurs. Glossaire des termes français du code.
Sans cela, l’IA était capable techniquement mais ignorante du métier. Elle savait écrire une méthode de repository, mais ne savait pas qu’une « session » dans cette codebase avait un sens précis (SUPERVISED : 1 h avec un tuteur, ou AUTONOMOUS : 30 min en solo), avec un cycle SCHEDULED → STARTED → COMPLETED.
4 novembre (v0.14.0) : intégration MCP Serena. Mémoire persistante entre sessions. L’IA pouvait désormais se souvenir des décisions architecturales des sessions précédentes sans qu’on les répète à chaque fois.
21 novembre (v0.15.6) : optimisation de CLAUDE.md, réduction de 50 % des tokens. Le fichier avait grandi organiquement et accumulé du bruit. Première passe délibérée de compression.
À la phase 2, le modèle mental avait changé : la configuration IA comme documentation d’onboarding, celle qu’on écrirait pour une nouvelle recrue senior. Règles métier, conventions, décisions architecturales, le pourquoi des schémas.
Phase 3 : la configuration comme infrastructure (janvier, 138 commits)
Janvier 2026 est le premier tournant. La configuration cesse d’être un fichier et devient un système, plus vite que toute migration planifiée ne l’aurait permis.
6 janvier 2026. Commit 1421e863. 86 fichiers créés en un jour.
Jan 06 ─── 12 agents + 5 hooks + settings.json ─── Big Bang (86 files, 1 day)
Jan 09 ─── .claude/rules/ ──────────────────────── Guardrails formalized (21 files)
Jan 16 ─── grepai MCP ──────────────────────────── Semantic code search
Jan 19 ─── Pre-push security hooks ─────────────── Defense at commit level
Jan 26 ─── Tasks API (450 lines doc) ────────────── Multi-session management
Jan 26 ─── Perplexity MCP, Jam.dev MCP ──────────── Expanded context sources
Jan 29 ─── SonarQube MCP ───────────────────────── Real-time quality analysis
Jan 29 ─── 283 tests added ─────────────────────── TDD enforcement in practice
Jan 29 ─── RTK enforcement hook ─────────────────── Token optimization mandatory
La croissance de l’équipe a déclenché l’explosion. Augustin arrivait, et la configuration qui fonctionnait pour un développeur (moi, sur macOS, avec un workflow précis) devait maintenant couvrir plusieurs personnes sur des installations, outils et niveaux d’expérience différents. Un CLAUDE.md monolithique ne pouvait pas absorber cela ; il fallait un système.
Skills : 12 agents et les premiers skills créés le 6 janvier. Le nombre de skills atteint 36 aujourd’hui. Chargés à la demande plutôt que consommant du contexte en permanence. Méthodologie TDD, procédures de sécurité, schémas de base de données, règles d’accessibilité, tous disponibles au déclenchement et silencieux sinon.
Hooks : 5 hooks créés le 6 janvier dans un seul commit : dangerous-actions-blocker.sh, security-gate.sh, activity-logger.sh, auto-format.sh, notification.sh. Contrôles de sécurité avant push, obligation d’optimiser les tokens (RTK imposé pour toutes les opérations CLI). Ils tournent automatiquement sans que le développeur doive s’en souvenir. Pour le détail des événements de hooks et de ce que chacun peut bloquer de façon déterministe, voir Claude Code sous le capot.
Règles : 3 premiers fichiers le 9 janvier, devenus 34 aujourd’hui. Des garde-fous actifs pendant les sessions de développement. Plus de catches silencieux, de fallbacks cachés ni d’accès nullable non validés. Un test en échec avant le code d’implémentation est obligatoire, d’où la version directe de la règle : « Write code before the test? Delete it and start over. » Traduction : « Du code écrit avant le test ? Supprimez-le et recommencez. »
6 serveurs MCP intégrés en 3 semaines : Serena (mémoire persistante), grepai (recherche sémantique de code), Perplexity (recherche web avec citations), Jam.dev (enregistrement de bugs), SonarQube (qualité du code), Postgres en lecture seule (requêtes directes en production pour le contexte).
Phase 4 : la configuration comme pratique d’ingénierie (février, 81 commits)
81 commits en 28 jours = 2,9 commits par jour sur la seule configuration IA.
Feb 03 ─── .cursor/ config ──────────────── Cursor support (Augustin)
Feb 05 ─── profiles/ + modules/ YAML ────── Modular system
Feb 09 ─── Zod validation + CI ──────────── Config has tests
Feb 11 ─── Cross-editor sync ────────────── Claude + Cursor synchronized
Feb 13 ─── Memory compression -6.2K tokens ─ Ongoing optimization
5 février (PR #598) : le système modulaire. Au lieu d’un CLAUDE.md que tout le monde lit, un pipeline de génération :
- 5 profils YAML (un par développeur)
- 14 modules (blocs de contenu composables)
- Un pipeline TypeScript qui les assemble avec validation Zod
- Des sorties générées : CLAUDE.md (703 lignes pour Florian, Claude Code, tous les modules) et .cursorrules (289 lignes pour Augustin, Cursor, modules minimaux)
9 février (PR #614) : les sorties générées ont leurs propres tests. Le pipeline valide qu’aucun placeholder ne reste non résolu. La CI détecte les régressions de configuration.
La configuration IA a maintenant les propriétés attendues du code de production :
- Versionnée (fichiers sources, pas les sorties générées)
- Validée (schéma Zod à 7 champs, 5 valeurs de ton valides, 6 modules fonctionnels valides)
- Testée (tests de pipeline, contrôles CI)
- Soumise à review (PR pour les changements de configuration, même processus que les PR de fonctionnalités)
- Documentée (450 lignes de documentation pour la seule API Tasks)
Phase 5 : la configuration comme amélioration continue (mars, 116 commits)
Mars 2026 a enregistré le deuxième plus grand nombre mensuel de commits du tableau conservé, après janvier.
Mar 04 ─── ACE pipeline + 12 ADRs ──────── Commit 3fc8c14f (43 files)
Mar 04 ─── Compound engineering patterns ── Architecture decisions codified
Mar ────── multi-agent-coordination.md ──── Agent orchestration rules
Mar ────── research-output.md ───────────── Structured research protocol
Mar ────── retex-review.md ──────────────── Post-task retrospective system
Le commit 3fc8c14f contenait le pipeline ACE complet, 12 Architecture Decision Records, des schémas de compound engineering et 43 fichiers. La configuration avait assez mûri pour commencer à encoder sa propre évolution.
La phase 5 dépasse l’ajout de règles. La configuration commence à capturer des méta-schémas : coordonner les agents, structurer la recherche avant l’implémentation, extraire les apprentissages après chaque tâche. Le système a commencé à codifier sa propre méthodologie. La méthode ultérieure de promotion des commentaires de review précise comment tester une leçon candidate avant d’en faire un contrôle partagé ; c’est une méthode proposée, pas un résultat mesuré de cette rétrospective.
Avril 2026 : le régime du contexte
L’inflexion suivante n’était pas un pic de commits. C’était une réduction délibérée.
En avril 2026, la configuration avait atteint 23 règles toujours actives chargées dans chaque session Claude, quel que soit le travail. 2 518 lignes de garde-fous inconditionnels, qu’on touche un composant React ou une migration Prisma. C’est un inventaire de lignes de contenu toujours actif, pas une part mesurée du contexte du modèle ou des tokens facturés.
Le travail sur la branche fix-improve-context s’est déroulé en 5 phases sur une semaine.
Phase 0, référence. J’ai construit un script de score (scripts/ai/score-ai-context.ts) avant de toucher quoi que ce soit, parce que « better » (traduction : « mieux ») devait signifier quelque chose de mesurable. La référence enregistrée était de 85/100, note A. Les contrôles ultérieurs ont changé le dénominateur ; le score brut final est donc un point de mesure distinct, pas un gain directement comparable.
Phase 1, triage. Chaque règle a été classée selon une question : Claude en a-t-il besoin sans qu’on le lui demande ? Trois catégories sont apparues. CONSTRAINT signifie toujours active, non négociable. PROCEDURE signifie des workflows pas à pas chargés à la demande. HYBRID est une directive courte accompagnée d’un protocole long. Sur les 23 règles toujours actives, 13 étaient en fait des procédures ou des hybrides déguisés en contraintes.
Phase 2, extraction. Neuf règles procédurales converties en skills : code-duplication.md est devenu /tech:dupes, defensive-code-audit.md est devenu /tech:audit, implementation-checklist.md est devenu /tech:checklist. Chaque version toujours active a été remplacée par un fragment de 5 à 15 lignes conservant la directive, tandis que le protocole passait à la demande. Un motif smart-suggest.sh a été ajouté à chaque skill extrait pour que Claude le propose quand le contexte pertinent apparaît, sans le charger en permanence.
Phase 3, compression. Les règles qui devaient rester actives mais étaient trop bavardes ont été raccourcies. rtk-enforcement.md a entièrement disparu, puisque RTK réside déjà dans le CLAUDE.md global, ce qui rendait la copie de projet redondante. debugging-methodology.md est passé de 112 à 43 lignes, avec trois autres règles réduites en parallèle. Résultat net : de 2 518 à 646 lignes de contexte toujours actif, soit 74 % de réduction.
Phase 3+, parité Cursor. Le fichier .cursorrules était devenu un monolithe de 703 lignes. Converti en fragment de 133 lignes (métadonnées et pointeurs), avec 23 règles .cursor/rules/*.mdc dont la portée dépend des chemins et qui contiennent le contenu proprement dit. Cursor charge désormais les règles seulement quand les chemins correspondent, et la même économie s’applique à Claude.
Phase 4, index lisible par machine. Trois nouveaux fichiers générés sont arrivés dans machine-readable/ :
ai-config.yaml(environ 270 lignes) : index structuré des 27 règles, 36 skills, 59 commandes, 16 agents, 15 hooks, liste des modules et des profils. Une référence@répond à « what’s available? » (traduction : « qu’est-ce qui est disponible ? ») dans une nouvelle session sans grep.llms.txt(environ 50 lignes) : format standard llms.txt pour les crawlers LLM et l’injection de contexte.llms-full.txt(environ 4 500 lignes) : concaténation complète des règles, modules et squelettes pour un recours hors ligne ou sans outils.
Tous trois générés par pnpm ai:sync. Trois nouveaux contrôles canaris (C18-C20) ont été ajoutés, valant +10 points au score de qualité.
Les chiffres finaux :
Always-on context:   2,518L → 646L       (-74%)
.cursorrules:          703L → 133L        (-81%)
ai:score:              85/100 → 125/145   (changed scoring denominator)
Canary checks:         17/17  → 20/20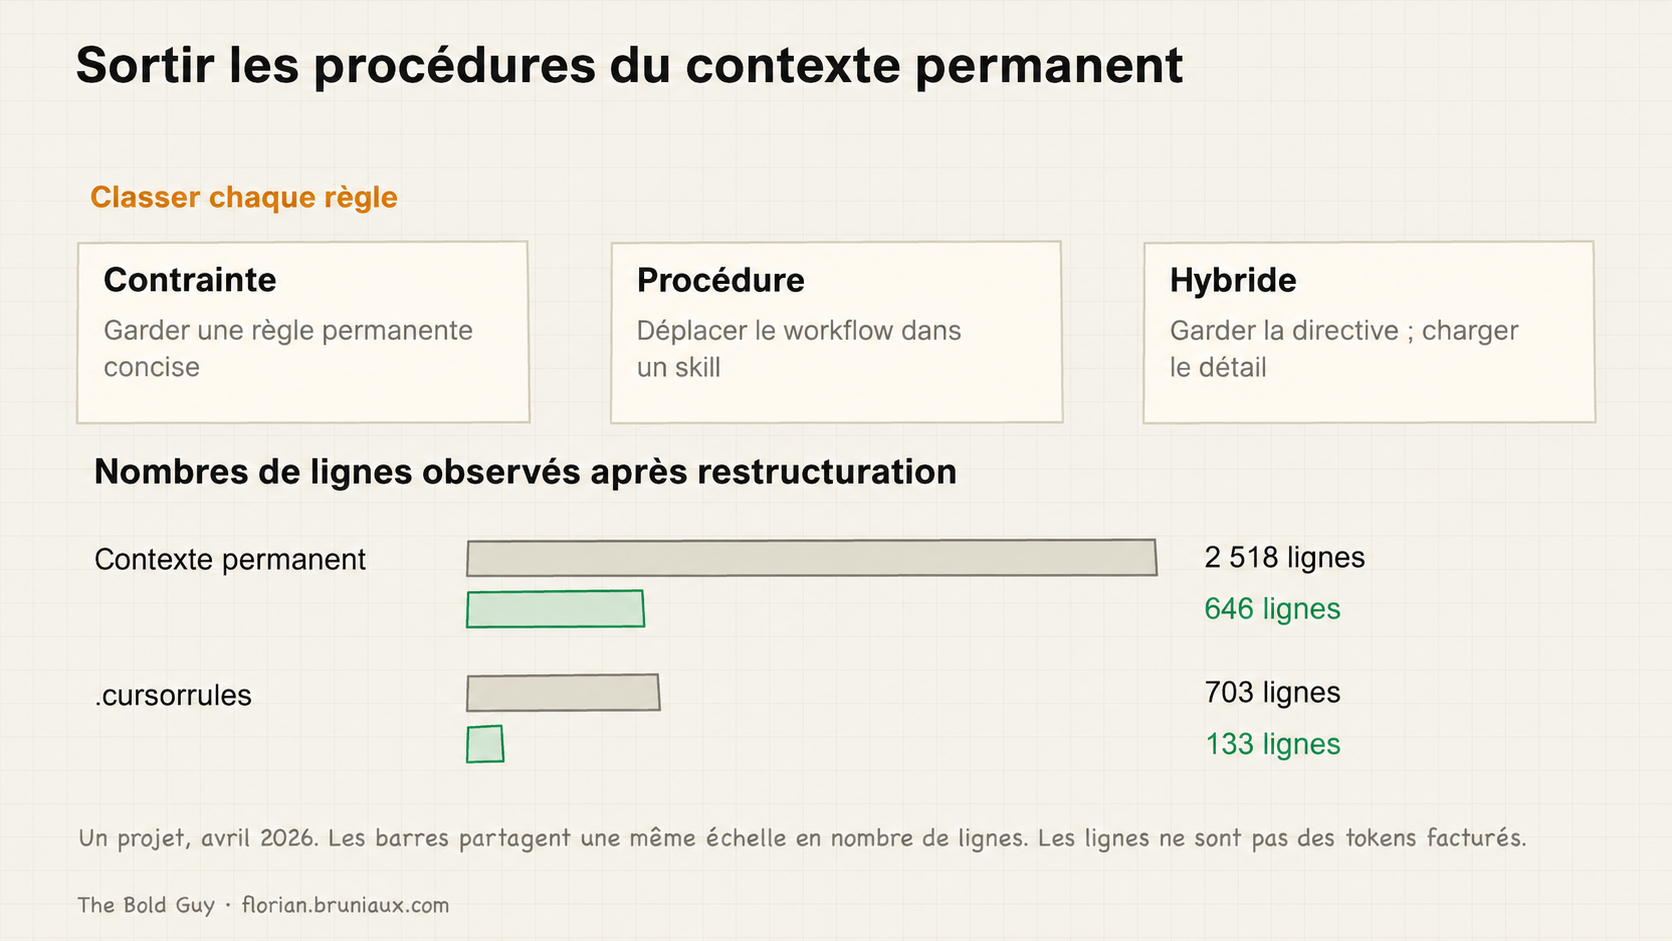
Les pics de janvier et mars ont suivi le même schéma. Les frictions ont rendu le coût visible, la mesure a rendu l’amélioration vérifiable, et les outils (script de score, contrôles canaris, index généré) détectent la dérive suivante avant qu’elle s’accumule. La note enregistre un point de mesure ; le script, les canaris et l’index détectent l’accumulation suivante avant qu’elle devienne un sprint de nettoyage.
Pourquoi deux pics sont apparus
Il n’y a pas ici d’échec de planification. On ne peut pas écrire les règles pour des problèmes qu’on n’a pas encore rencontrés.
Au premier jour, on ne sait pas ce que la configuration IA doit devenir. On le découvre en rencontrant les frictions.
Le pic de janvier venait de l’équipe. Les règles empêchant les catches silencieux sont apparues après avoir trouvé du code généré par IA qui faisait exactement cela. La règle imposant le TDD est arrivée après une période de livraison sans tests. Le système de profils est apparu lorsqu’un second développeur avec une autre installation a eu besoin de la configuration réglée pour une personne. Les garde-fous encodent des leçons, et on ne peut pas les écrire avant d’avoir rencontré le problème qu’ils résolvent.
Le pic de mars venait de l’échelle. Le système était devenu assez complexe pour demander une gouvernance architecturale. Les 12 ADR ont codifié des décisions prises implicitement pendant des mois. Les schémas de compound engineering sont issus de l’observation de ce qui fonctionnait sur 1 100 commits. La configuration a rattrapé la maturité de la codebase.
La taille de l’équipe façonne aussi la courbe d’investissement. La configuration des phases 1 et 2 convient à un développeur solo. Les phases 3 et 4 deviennent nécessaires quand quelqu’un rejoint l’équipe et que l’installation monolithique ne convient plus à sa machine ou son contexte. La collaboration finit par imposer la systématisation, tandis que l’usage solo la réclame rarement.
Les leçons de l’historique des commits
Si je repartais de zéro aujourd’hui, je n’essaierais pas de sauter à la phase 3. Ces abstractions encodent des leçons que je n’avais pas encore. Les règles décrivent des problèmes qui n’étaient pas encore survenus. Partez d’un CLAUDE.md qui reflète honnêtement ce que vous savez : stack, conventions, domaine métier compris jusque-là. Le reste apparaît au besoin. Cette montée d’un simple fichier à une infrastructure versionnée et testée est l’échelle que le guide de context engineering à six niveaux déroule niveau par niveau. Cet article est cette échelle vécue dans un repo pendant neuf mois ; le guide est la version sans archéologie des commits.
Je suivrais plus tôt les taux d’exécution des hooks et le nombre de tokens. Un score fait de « better » (traduction : « mieux ») autre chose qu’une impression. 703 lignes contre 289 est une différence mesurable de taille de configuration ; la facturation exige sa propre mesure. Avec le script de score, l’optimisation est devenue vérifiable plutôt qu’intuitive. J’ai ensuite construit ccboard pour surveiller précisément cela : activité des hooks, coût par session et santé des MCP dans une vue. C’est l’instrumentation que j’aurais aimé avoir à cette phase.
Les chiffres mensuels conservés montrent plus d’activité de janvier à avril que sur les cinq premiers mois, même si le total de l’audit reste non réconcilié. Dans ce repository, les besoins du système sont devenus visibles avec les frictions.
L’audit original rapportait 506 commits de configuration IA dans un repository de 5 820 commits. Sa part annoncée de 8,6 % et sa répartition mensuelle restent des affirmations historiques avec l’écart indiqué plus haut. Plus que ce qu’ont reçu la plupart des fichiers de logique métier. Si cela paraît beaucoup, l’alternative est un CLAUDE.md périmé et une IA qui dérive de la codebase qu’elle doit comprendre. La moitié factuelle de cette dérive, chemins, scripts et versions qui cessent silencieusement de correspondre au code, est ce que ctxharness vérifie automatiquement, pour détecter le CLAUDE.md périmé au lieu de le remarquer des mois plus tard.
Ce jeu de données donne une réponse concrète sur le moment : plus tard que ne le suggérerait un plan initial, puis bien plus vite qu’attendu lorsque la complexité de l’équipe le rend inévitable.
Au-delà de l’équipe de deux
Ce jeu de données porte sur un projet et une stack. Il est façonné par le passage d’un développeur à deux en janvier 2026. Les frictions qui ont façonné les 506 commits étaient à cette échelle : un second développeur arrivant, un monorepo à couvrir, un ensemble de conventions à encoder.
À l’échelle organisationnelle, les frictions changent de forme. Entre plusieurs repos, la même règle finit dupliquée dans N fichiers CLAUDE.md et dérive dès que quelqu’un en met un à jour sans les autres. Entre stacks, une règle sur les types TypeScript Result ne se traduit pas dans un repo Rust utilisant anyhow::Result. Avec plusieurs équipes, on passe de 5 profils YAML à 50, la plupart des différences ayant des raisons légitimes.
Le schéma est un repository dédié de configuration IA comme source de vérité, consommé par les projets en aval. Quelques formes possibles :
- Sous-module Git : le repo de configuration est épinglé à un commit, reproductible entre machines, indépendant de la stack. L’expérience utilisateur des sous-modules a un coût réel, mais gérable avec un script wrapper.
- Paquet publié (npm, cargo, pip) : versionné en semver, distribué par les workflows de release existants. Fonctionne bien dans une organisation homogène en stack, moins lorsqu’une équipe TypeScript et une équipe Rust ont besoin des mêmes règles de base. C’est la forme que j’ai utilisée pour une partie plus étroite du problème, hooks et templates réutilisables plutôt qu’une configuration organisationnelle complète : claude-code-plugins en fournit 181 sous forme de plugins installables, versionnés et importés par projet.
- CLI de configuration partagée qui récupère et assemble (comme les modules Terraform ou un gestionnaire de dotfiles) : dédiée, multistack, mais encore un outil à maintenir.
Quelle que soit la forme, le modèle mental est le même : modules d’organisation + modules d’équipe + modules de projet, composés par un pipeline. Le système modulaire apparu en phase 4 pour un projet a la même forme, un niveau plus haut.
J’ai depuis construit cette installation : le système d’instructions d’équipe chez Méthode Aristote, un pipeline de profils, modules et synchronisation. Il repose sur le principe qui a fait fonctionner les phases 3 et 4 : systématiser quand la collaboration l’exige, pas avant. À l’échelle organisationnelle, cette demande passe de l’intérieur d’un repo à plusieurs repos. La courbe d’investissement reflète probablement ce qui s’est passé ici, une longue accumulation lente suivie d’un pic quand un deuxième repo a besoin des règles réglées pour un seul.
Si vous êtes dans cette situation, la prédiction est concrète : vous résisterez au repo central pendant des mois parce que les configurations d’équipe semblent correctes, puis vous le construirez en deux semaines parce que la dérive des versions entre quatre repos sera devenue ingérable.
Si vous avez déjà atteint cette inflexion à l’échelle organisationnelle, je serais curieux d’en connaître la forme.
Single project (this article)        → CLAUDE.md + .claude/ scoped to one repo
Multi-repo org (logical next step)    → Shared AI config repo + per-project override
Pas de plan initial complet
La configuration IA est passée d’un fichier maintenu informellement à un système avec tests, pipeline de génération et processus de review des PR. Le travail de configuration rapporté historiquement venait de la mesure des outils et de la réponse aux frictions à mesure qu’elles apparaissaient. Chaque phase encodait un problème déjà rencontré. Partez d’un CLAUDE.md reflétant ce que vous savez, puis instrumentez les taux d’exécution des hooks, le nombre de tokens et un script de score assez tôt pour voir la friction suivante. Dans ce repository, l’investissement s’est concentré tardivement.
Le système modulaire d’instructions IA décrit ici (profils YAML, modules, pipeline de génération avec validation Zod) est documenté dans le Claude Code Ultimate Guide. Données sources de l’historique Git du repository Méthode Aristote (5 820 commits, v0.1.0 → actuel). La commande d’archéologie : git log --all --format="%ad" --date=format:"%Y-%m" -- CLAUDE.md .claude/ | sort | uniq -c.
YSNK
(Vous devriez maintenant savoir)
- Janvier et mars sont les deux plus gros mois listés ; le tableau totalise 495 alors que le total historique est de 506, donc sa répartition initiale en pourcentages n’est pas validée
- Classer chaque règle toujours active selon une question, Claude en a-t-il besoin sans demande, a révélé que 13 règles sur 23 étaient en fait des procédures ou des hybrides déguisés en contraintes
rtk-enforcement.mda entièrement disparu au nettoyage parce qu’il dupliquait une règle déjà présente dans le CLAUDE.md global, redondant dès que quelqu’un a vérifiépnpm ai:syncgénère désormais aussi un index lisible par machine (ai-config.yaml,llms.txt,llms-full.txt), pour qu’une nouvelle session réponde à « what’s available? » (traduction : « qu’est-ce qui est disponible ? ») avec une référence plutôt qu’en cherchant par grep dans le repo- À l’échelle organisationnelle, les mêmes frictions se répètent un niveau plus haut : une règle dupliquée dans N fichiers CLAUDE.md dérive dès qu’un seul est mis à jour, ce qui fait du repo dédié de configuration partagée la prochaine inflexion
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source