Claude est mon deuxième contributeur : ce que montrent les vraies statistiques Git
6 auteurs humains de commits et Claude dans notre historique Git (instantané de mai 2026). Les patterns de commits après des mois de Claude Code, au-delà des affirmations marketing.
Aller au résumé ↓ Florian Bruniaux
TL;DR
Le titre est une provocation délibérée. Claude n’est ni développeur ni septième auteur humain : c’est l’outil le plus productif que j’aie utilisé, et 70 % des PR fusionnées portent son attribution, ce qui en fait le deuxième contributeur de ce repository selon cette seule mesure. La répartition que j’observe se maintient : Claude implémente dans un périmètre défini par les humains, qui décident de ce qu’il faut construire ensuite. Ce qui bouge est le périmètre de « defined » (traduction : « défini ») : il est passé ici d’un fichier d’instructions à 77, et je m’attends à ce que mon attention continue de se déplacer du code répétitif vers le jugement.
| Sujet | Détails |
|---|---|
| Les chiffres (mai 2026) | 905 PR fusionnées. 74 releases. 9 mois depuis v1.0.0. |
| Part de Claude | 70 % des PR portent une attribution Claude dans le corps. Deuxième contributeur par attribution de PR, pas selon les auteurs des commits. |
| Ce que fait Claude | Génération de structures, refactoring, génération de tests, documentation, patterns répétitifs. Le système de configuration IA lui-même. |
| Ce que font encore les humains | Décisions d’architecture, débogage complexe, jugement produit, review de sécurité. Arbitrages d’infrastructure. |
| L’évolution | D’un CLAUDE.md manuscrit à 77 fichiers d’instructions IA, 13 workflows CI dont 3 de gouvernance IA. |
| Production open source | Claude Code Ultimate Guide (plus de 430 000 lignes), CC Bridge, CCBoard, contributions RTK. |
| Le bilan franc | Claude n’est pas développeur. C’est l’outil le plus productif que j’aie utilisé. La distinction compte. |
Commencé comme instantané de février 2026. Actualisé en mai 2026 avec les données du moment.
L’instantané de mai compte six contributeurs humains selon les commits. La participation de Claude est suivie séparément par attribution de pull requests, pas comme septième auteur humain.
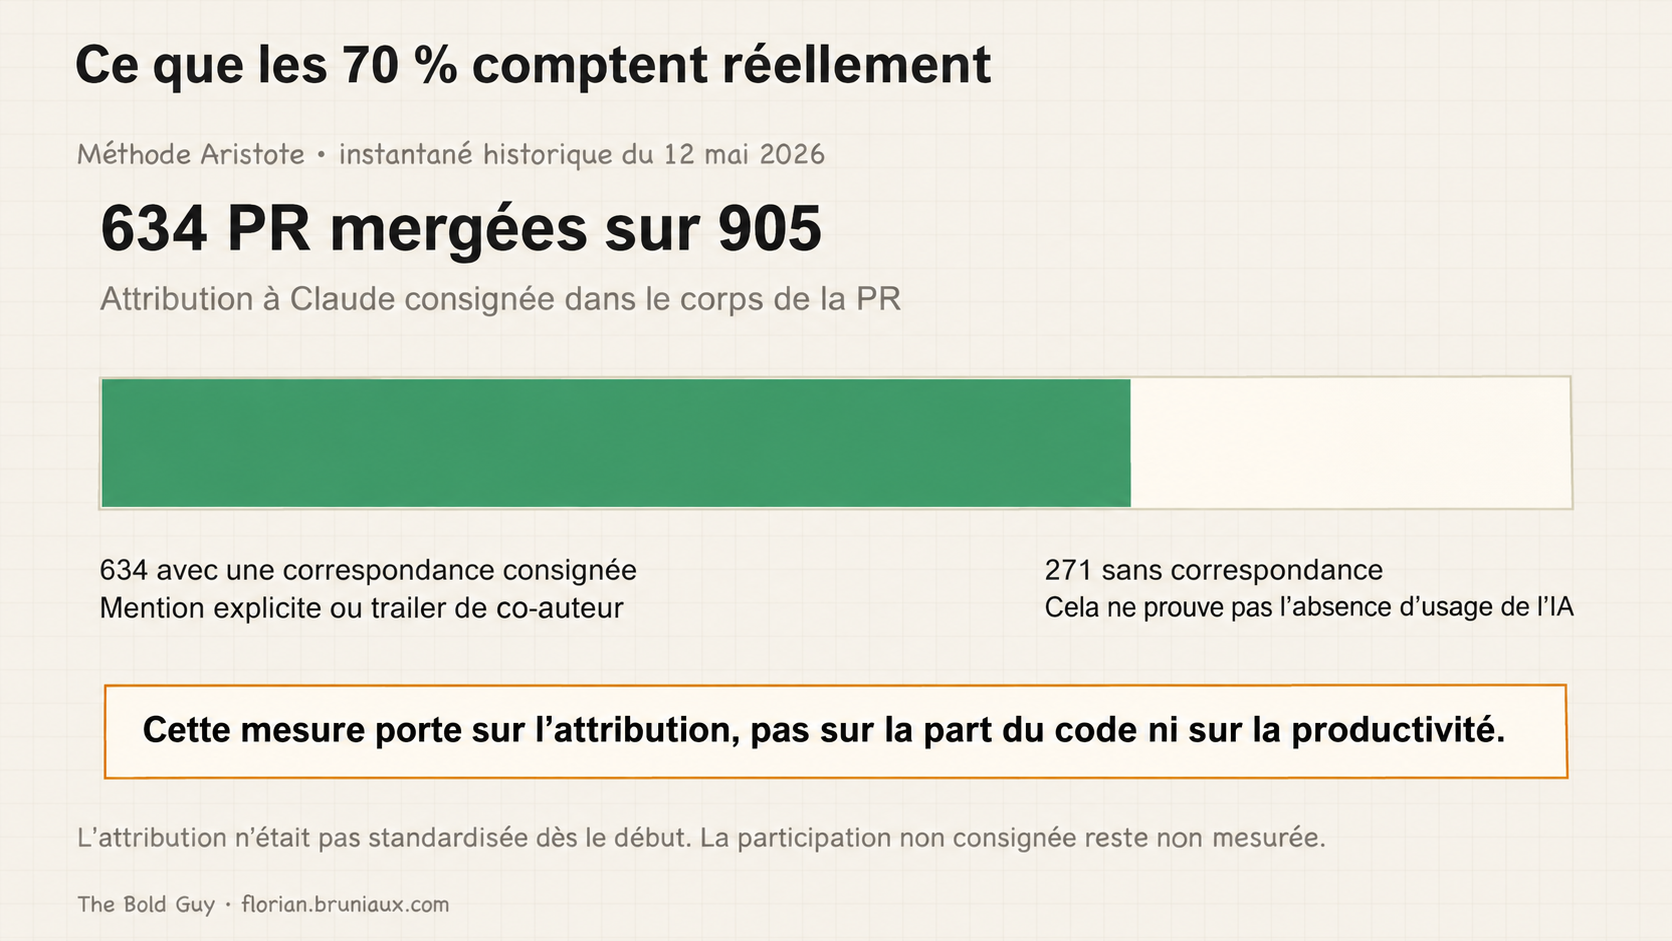
70 % des PR fusionnées portent une attribution Claude dans le corps. 905 pull requests au total, 894 depuis le début du projet en août 2025. Selon cette mesure, Claude est le contributeur le plus constamment présent dans cette codebase.
Ce que mesurent les statistiques de commits
Les 70 % comptent les PR dont le corps contient un trailer Co-Authored-By Claude, une référence « Generated with Claude Code » (traduction : « Généré avec Claude Code ») ou une attribution explicite. Le décompte est imparfait : l’attribution n’était pas standardisée dès le départ et les PR antérieures à octobre 2025 n’ont pas de trailers cohérents. Mais l’API GitHub permet de le vérifier, ce qui le rend plus fiable qu’une attribution des commits après coup.
Ce qu’incluent les 70 % :
- Nouveaux fichiers de services et repositories suivant le pattern en 3 couches (même structure, autre logique métier)
- Génération de tests unitaires pour les patterns établis
- Passes de refactoring sur plusieurs fichiers simultanément
- Génération et maintenance de documentation
- Le système d’instructions IA lui-même : 77 fichiers décrivant comment travailler avec Claude sur ce projet
Ce que cela ne capture pas : choix de ce qu’il faut construire, décisions d’architecture, débogage où le comportement était faux d’une façon invisible à Claude et portions importantes de code écrites indépendamment par des humains sans attribution.
Le nombre de PR est un signal plus propre que celui des commits pour cette analyse. Une session Claude peut produire 3 fichiers et apparaître comme un commit. Les PR sont des unités livrées, relues, validées et fusionnées. 70 % de ces unités portaient la trace d’une participation de Claude.
Ce que fait Claude
Générer les structures de nouveaux patterns
L’architecture en 3 couches de Méthode Aristote (Router = validation, Service = logique métier + permissions, Repository = CRUD uniquement) est cohérente sur plus de 70 services. Quand j’ai besoin d’un nouveau service, toute la chaîne est reproductible : routeur tRPC avec validation Zod, service à entrées typées et contrôles de permissions, repository avec requêtes Prisma.
Claude connaît le pattern car il est dans la codebase et le contexte CLAUDE.md. Créer le quinzième service ainsi est un travail qu’il fait bien et vite. Créer le premier nécessitait une décision architecturale à laquelle il n’a pas participé.
Génération de tests
En janvier 2026 : services (45 tests), repositories (174 tests), adaptateurs (64 tests), dans des sessions ciblées sur quelques semaines. Les tests unitaires de patterns établis sont précisément le travail répétitif et bien défini où l’IA produit vite et de façon fiable. En mai 2026, le repository compte 864 fichiers de tests sur toutes les couches.
Les tests nécessitaient une review. Certains cas limites manquaient. Certaines assertions étaient sémantiquement correctes, mais ne testaient pas la bonne chose. La review humaine les a détectées. La génération de base venait de Claude.
Refactoring à grande échelle
La duplication est passée de 55 % à 8 %. Beaucoup de fichiers à toucher, de patterns à identifier et consolider. Claude applique mécaniquement un refactoring sur plusieurs fichiers plus vite que tout workflow humain que j’ai trouvé. Identifier quoi refactorer, quels patterns consolider et quelles duplications apparentes étaient intentionnelles relevait du jugement humain.
Documentation
Le Claude Code Ultimate Guide : plus de 430 000 lignes dans plus de 1 000 fichiers. Maintenu avec l’aide de l’IA, car le maintenir manuellement à ce volume serait impossible. Structure, décisions éditoriales, exemples de production : les miens. Claude génère à partir de notes et brouillons.
Le système d’instructions IA lui-même
Le système de 77 fichiers dans doc/guides/ai-instructions/ (règles, modules, profils développeurs, index de skills) est largement généré par Claude depuis des séances de conception. Il décrit comment travailler avec Claude sur le projet. D’un fichier CLAUDE.md, il est devenu une couche documentaire structurée avec ses propres tests et sa validation CI. Plus de détails ci-dessous.
Ce que font encore les humains
Décisions d’architecture
L’architecture en 3 couches existe parce que je l’ai décidée. J’ai choisi Neon PostgreSQL plutôt que Supabase, tRPC plutôt que REST et Clerk pour l’authentification. Claude n’a pas fait ces arbitrages.
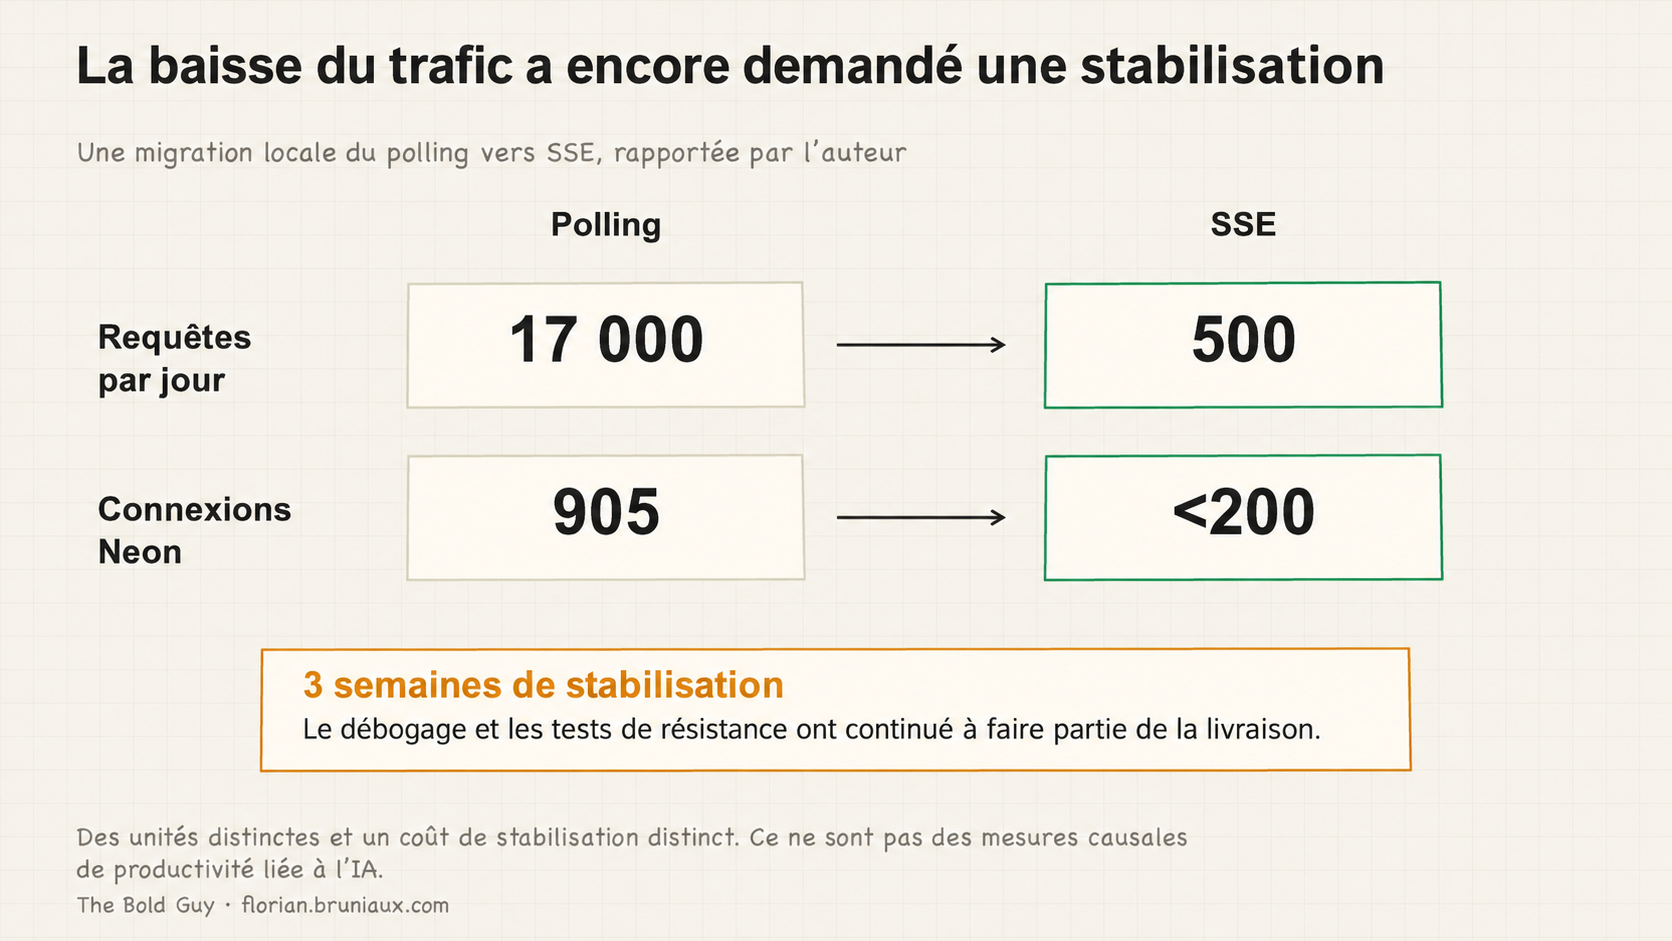
Quand le polling initial générait 17 000 requêtes par jour et saturait le pool Neon à 905 connexions, le diagnostic est venu de la lecture des logs, corrélation des événements Sentry et compréhension du cycle de connexion. Claude a aidé à implémenter la migration SSE après formulation de l’hypothèse. La formuler a demandé du travail humain.
Quelques mois plus tard, SSE avait ses limites (limites de débit, complexité d’authentification, gestion des connexions de longue durée), et passer à Pusher a été une autre décision d’architecture. Pas évidente. Un service temps réel géré a un vrai coût : dépendance fournisseur, tarification, intégration. Nous avons migré malgré tout. Claude a appliqué la migration dans la codebase après la décision.
Débogage complexe
Les 20 000 flux orphelins nettoyés en décembre 2025 ne se sont pas annoncés. Comprendre leur origine demandait logs, corrélation Sentry et connaissance du cycle de connexion. Claude devenait utile après formulation de l’hypothèse. La formuler était la partie difficile.
Review de sécurité
La correction IDOR (permissions ANY → TEAM/ASSIGNED) a résolu plus de 8 600 événements Sentry. Le correctif CVE-2025-55182. Les hooks de sécurité pre-push à chaque commit. Ils demandaient compréhension des surfaces d’attaque, raisonnement adversarial et connaissance de ce que les permissions devaient imposer. Claude opère dans le modèle de sécurité. Construire ce modèle et le relire relève du travail humain.
Jugement produit
Quoi construire ensuite, implications architecturales des retours utilisateurs, reconnaître une demande de fonctionnalité comme symptôme UX nécessitant une autre correction, décider quand livrer ou attendre.
Claude peut implémenter toute fonctionnalité que je décris, mais cela ne signifie pas qu’il sait laquelle compte.
L’infrastructure a continué d’évoluer
Entre février et mai 2026, deux changements ne sont pas visibles dans le nombre de commits.
La stack temps réel a encore changé
L’histoire de février se terminait sur SSE : polling (17 000 requêtes/jour) → SSE (moins de 500). C’était l’état gagnant en février. En mars, Pusher a remplacé SSE. Migration terminée mi-avril, code mort retiré juste après.
La décision Pusher impliquait de vrais arbitrages : passer d’un SSE auto-hébergé à un service tiers géré signifie coût récurrent, nouvelle intégration et dépendance externe. J’ai pris ces décisions. Claude a implémenté l’authentification des canaux, la gestion des abonnements et le traitement des erreurs dans toute la stack une fois l’approche fixée. Pusher est arrivé dans v1.7.1 le 10 mars ; migration terminée le 17 avril, 38 jours de la décision au retrait du code mort.
Chaque changement d’infrastructure suivait la même répartition. J’explicitais la décision d’adoption et ses raisons, puis Claude l’appliquait dans toute la codebase.
La CI a acquis des contrôles propres à l’IA
En août 2025, un workflow : claude.yml écrit à la main, copié de la marketplace GitHub. En mai 2026, 13 workflows totalisant environ 2 700 lignes YAML. Trois concernent la gouvernance IA :
claude-code-review.yml(87 lignes) : review Claude Code automatique sur chaque PRai-config-check.yml(83 lignes) : validation de l’absence de dérive des instructions IA face à la codebaseclaude.yml(50 lignes) : workflow général Claude Code d’origine
Le workflow ai-config-check.yml exécute ctxtest (13 faits vérifiables sur la codebase : version Next.js, patterns de base de données, conventions d’équipe). Si contexte IA et codebase divergent, la CI échoue. Suite de tests des instructions données à Claude, pas du code applicatif. La CI imposait déjà la qualité du code ; elle impose maintenant celle du contexte IA.
La config IA est devenue infrastructure
En février 2026, l’approche CLAUDE.md était un gros fichier, maintenu manuellement, actualisé en cas de panne. En mai, c’est un autre système.
doc/guides/ai-instructions/ contient 77 fichiers. Règles par domaine (architecture, conventions de code, workflow Git, sécurité, React, TypeScript, TDD). Modules de référence pour des contextes précis (notifications Knock, Storybook, métier). Cinq profils développeurs, un par humain de l’équipe, configurant les règles applicables et fichiers modifiables.
Le total est d’environ 5 900 lignes de documentation d’instructions IA, maintenues comme système structuré avec validation propre. Quand un profil dit qu’Augustin est responsable du parcours de tutorat, le hook pre-commit signale toute modification par Claude de ces fichiers dans la session d’un autre développeur. En avril 2026, le score de qualité du contexte a atteint A+ (150/150 à l’évaluation interne). Chiffre généré par pnpm ai:validate, qui vérifie complétude, exactitude et fraîcheur des instructions face à la codebase réelle.
Les humains écrivent les règles, Claude opère dedans, la CI impose leur exactitude et pnpm ai:sync documente le système. La maintenance consiste désormais à passer le contrôle CI plutôt qu’à modifier manuellement CLAUDE.md seulement en cas de panne.
La production open source
Au-delà de Méthode Aristote, j’ai livré 9 projets distincts sur la même période. En parallèle, pendant que la plateforme principale tournait. Le schéma est le même partout.
La couche d’outils IA
Claude Code Ultimate Guide (GitHub) (22 000 lignes, 204 modèles, 271 questions de quiz, base de menaces suivant 15 CVE et 655 skills malveillants) : le domaine évolue assez vite pour rendre sa maintenance manuelle équivalente à un temps plein. Claude génère depuis notes et brouillons. Structure, décisions éditoriales et exemples de production : les miens.
ctxharness vient directement du workflow ctxtest de Méthode Aristote. Votre CLAUDE.md dit Prisma 7.5. Votre package.json contient ^7.7.0. L’agent raisonne silencieusement sur des faits périmés à chaque session. ctxharness le détecte : 20 extracteurs, 15 scanners, 3 couches de tests de context engineering. Construit parce que j’avais d’abord le problème.
CCBoard (GitHub) est un tableau de bord TUI et web en temps réel des sessions Claude Code. Consommation de tokens, temps de réponse, historique des sessions, exécution des hooks, santé des serveurs MCP. Construit en Rust. L’infrastructure de suivi que je voulais sans l’avoir.
cc-sessions est un CLI Rust rapide pour rechercher, parcourir et analyser l’historique des sessions Claude Code. Je n’aurais pas abordé un projet Rust sans le workflow Claude Code qui le rendait viable.
cc-copilot-bridge (GitHub) résout un problème précis : crédits Claude épuisés, crédits Copilot inutilisés. Le pont route Claude Code via l’abonnement Copilot. Décision d’architecture et identification du problème : les miennes. Implémentation : Claude.
Claude Cowork Guide (GitHub) couvre le versant non-développeurs : 28 workflows métier et 70 prompts à copier-coller pour Claude Desktop. RH, finance, marketing, vente. Complémentaire du guide développeur, public entièrement différent.
Les outils développeurs
dep-scope répond à ce que Knip et Depcheck laissent ouvert : symboles utilisant un package, fréquence, nombre de fichiers et possibilité de le supprimer via une alternative native. Il a 195 correspondances vers des alternatives natives, 371 tests et une génération de prompts de migration pour LLM transmissibles directement à Claude Code par pipe. Le problème existait longtemps avant le workflow permettant de construire l’outil.
StarMapper (GitHub) transforme l’URL d’un repository GitHub en carte mondiale des développeurs lui ayant attribué une étoile. Sans connexion, avec URL et token GitHub. Construit en un week-end parce que les données étaient intéressantes et le workflow assez rapide pour tenter.
RTK est le projet de Patrick. Proxy CLI réduisant de 60 à 90 % les tokens des commandes de développement en filtrant le bruit avant le modèle. Après avoir vu l’approche, je suis devenu contributeur. RTK est dans mon workflow quotidien et mentionné ailleurs dans cet article comme couche 1 de la stack de context engineering.
Mise à jour du 6 novembre 2026. Ma contribution à RTK décrite ici appartient à cette période. Je ne travaille plus activement sur sa base de code, mais je suis toujours de près le travail de Patrick, Thomas, Adrien et de l’équipe.
Claude est-il développeur ou outil ?
La question revient régulièrement. Claude est un outil, et la distinction compte.
Claude n’a ni objectifs ni intérêt propre dans le bon fonctionnement du produit. Les approches échouées ne comptent que si elles restent dans la fenêtre de contexte. Un débogage qui tourne en rond ne le frustre pas, car la frustration suppose de se soucier du résultat.
Ce sont des propriétés du système. Elles le rendent extrêmement utile pour l’implémentation bien définie, au pattern clair, au périmètre borné et à la sortie pouvant être relue.
Les 70 % d’attribution de PR sont réels. Ils signifient qu’une part importante du travail d’implémentation sur cette codebase a été produite par une IA en suivant les spécifications et patterns définis par les humains. Cela change la forme que prend la productivité individuelle d’un développeur, pas la valeur du jugement, de l’expérience et du sens produit.
Les comptes complets
9 mois de développement en production, en mai 2026 :
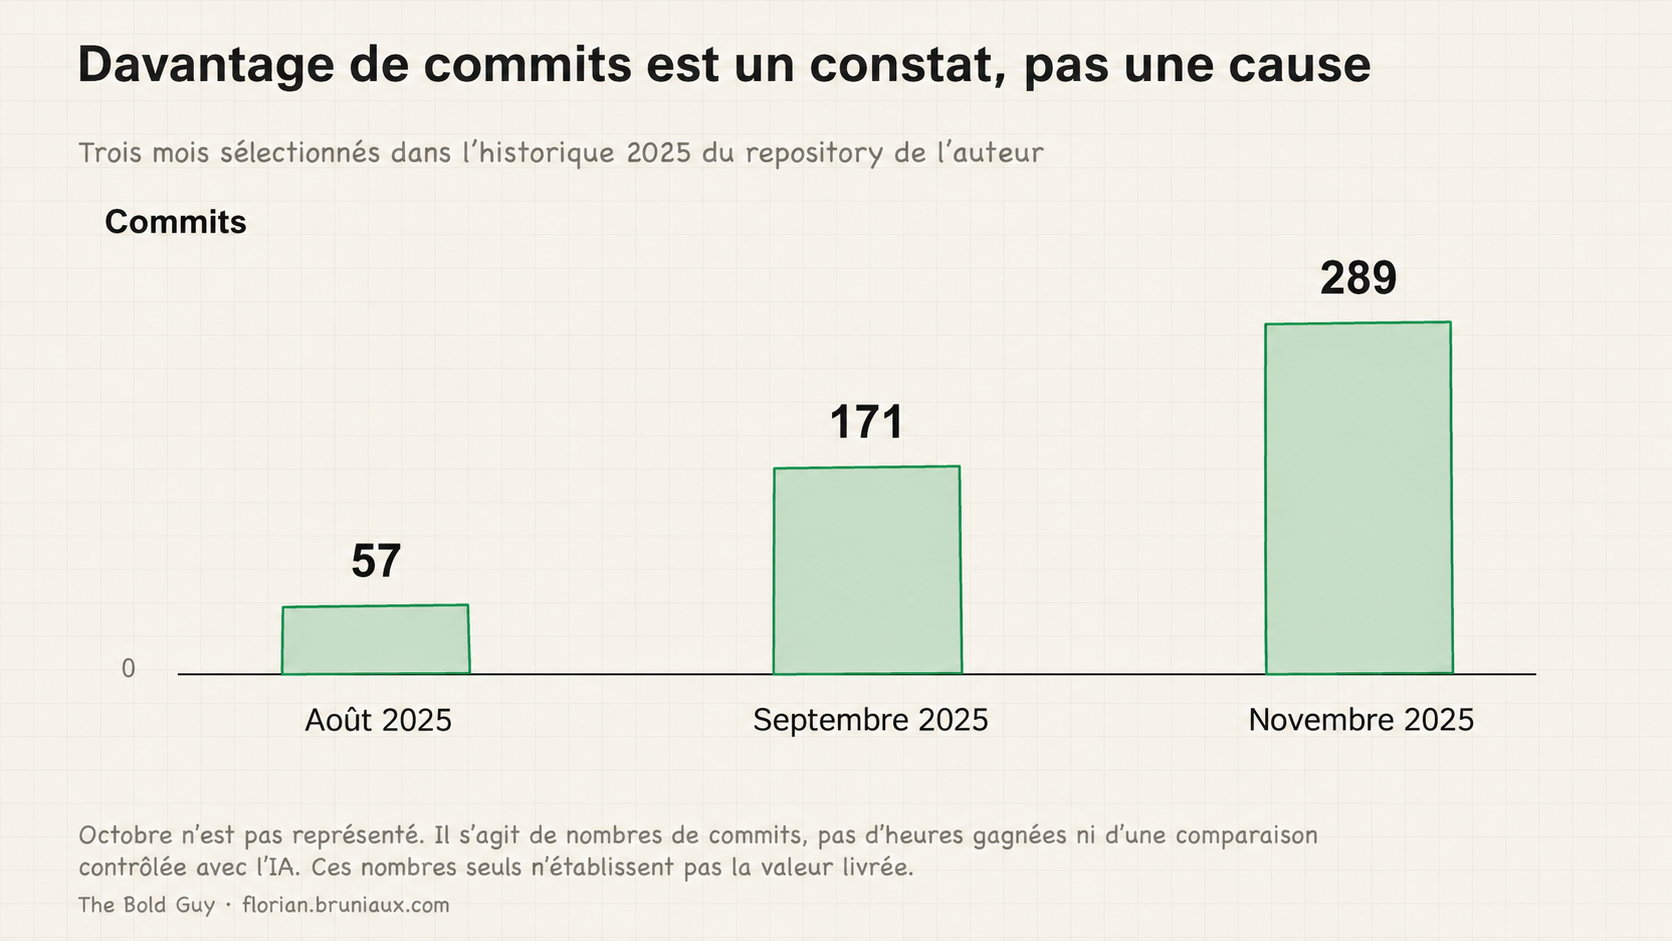
- 905 PR fusionnées (894 depuis août 2025). 408 les 3 derniers mois, contre 497 les sept premiers : production à peu près équivalente en moins de moitié du temps. Avril 2026 est le mois le plus actif avec 178 PR. La vélocité monte, elle ne plafonne pas.
- 74 releases, de v1.0.0 le 27 août 2025 à v1.15.3 le 11 mai 2026
- 6 contributeurs humains selon les commits : Florian (1 338), Nicolas (455, ×6,7 depuis février), Augustin (237), plus Jacques, Mathis et Victor
- 1 contributeur IA : attribution de 70 % des PR (634 sur 905), sans auteur de commit séparé, présent dans la majorité du travail livré
- 13 workflows CI (environ 2 700 lignes YAML), dont 3 de gouvernance IA
La répartition stable est claire. Claude gère l’implémentation dans un périmètre défini. Les humains décident de ce qu’il faut construire ensuite et de la façon de résoudre un conflit à l’échelle du système.
Le périmètre de « defined » (traduction : « défini ») a changé. Le pattern en 3 couches était défini tôt et Claude le génère de façon fiable. Les instructions sont passées d’un fichier à 77, qu’il génère et maintient depuis les séances de conception. L’IA relit chaque PR, et le contexte a un contrôle CI échouant en cas de dérive. L’infrastructure pour travailler avec Claude est devenue aussi conséquente que l’infrastructure applicative.
La distinction utile sépare six humains, activité automatique des dépendances et PR attribuées à Claude. Ce sont des catégories différentes, pas des entrées interchangeables d’un classement. Claude aide à implémenter le travail dont les humains donnent la direction. Ce qui a changé, c’est ce à quoi je consacre mon attention : moins de temps à générer du code répétitif, davantage aux problèmes où expérience et jugement comptent réellement.
Statistiques du repository Méthode Aristote au 12 mai 2026. Attribution des PR via API GitHub (Co-Authored-By et mentions Claude Code dans le corps). Projets open source sur github.com/FlorianBruniaux. Pour les mécanismes Claude Code et son système de configuration, Claude Code sous le capot couvre l’architecture.
YSNK
(Ce que vous devriez maintenant savoir)
ai-config-check.ymlexécutectxtest, 13 faits vérifiables sur la codebase, et fait échouer la CI si les instructions IA dérivent du réel. Une suite de tests du contexte fourni à Claude, pas de l’application- Les profils limitent ce que Claude peut modifier : si un collègue est responsable d’un parcours, un hook pre-commit signale les modifications que Claude fait à ces fichiers dans la session d’un autre développeur
- La migration Pusher a pris 38 jours de la décision au retrait du code mort, deuxième réécriture temps réel après SSE. Même répartition : décision humaine, exécution Claude
- ctxharness et dep-scope existent parce que les problèmes sont apparus d’abord dans cette codebase : faits CLAUDE.md périmés et dépendances mortes non détectées
- La qualité du contexte IA a atteint A+ (150/150) en avril 2026 via
pnpm ai:validate, chiffre existant seulement parce que les instructions sont désormais testées comme le code
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source