Mémoire persistante : les six échecs qui ne lèvent jamais d'erreur
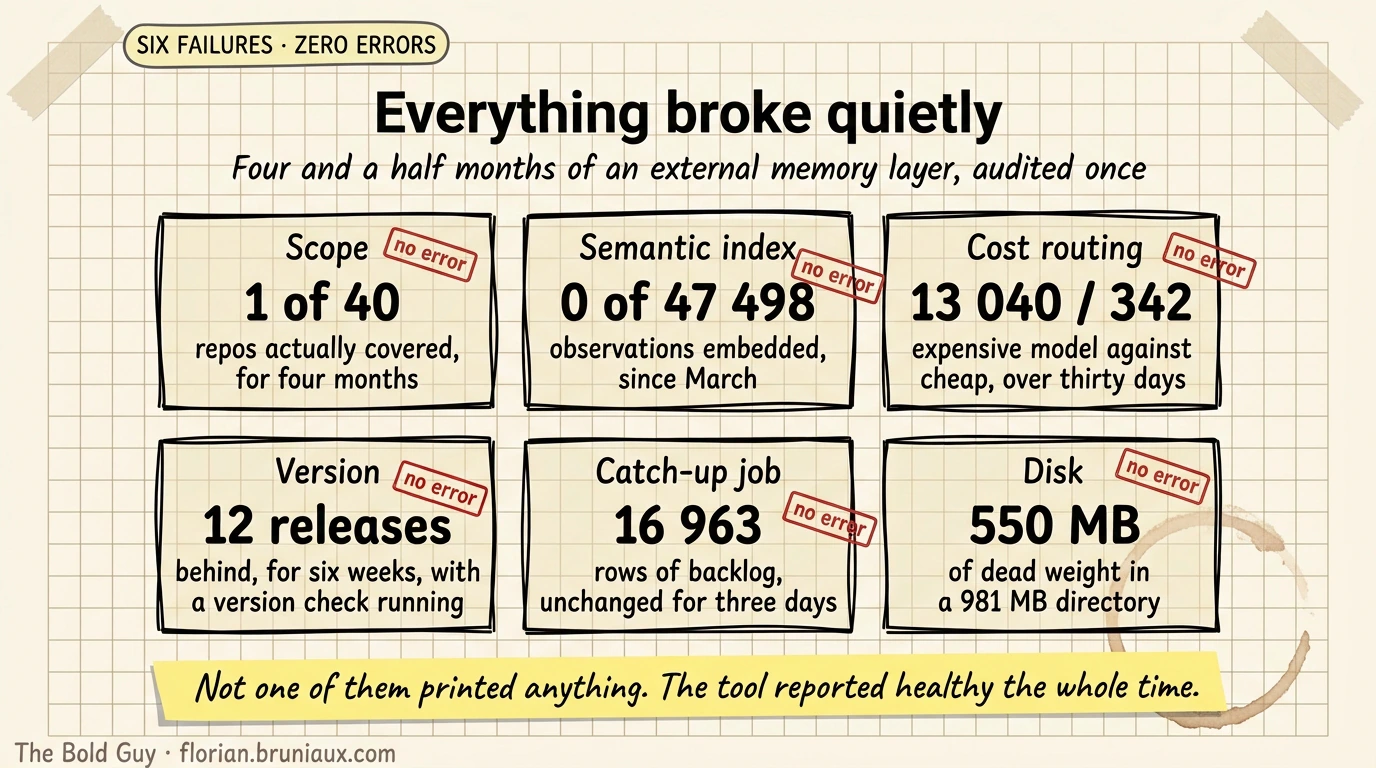
J'ai utilisé claude-mem pendant quatre mois et demi. Six choses étaient cassées, dont quatre depuis mars, et aucune n'avait jamais levé d'erreur.
Aller au résumé ↓ Florian Bruniaux
Ce que vous en retirez
- ✓ Une règle de décision entre mémoire native et couche externe
- ✓ Une couche de mémoire externe installée et applicable à tous les repos, pas un seul
- ✓ Six contrôles qui révèlent des échecs ne levant jamais d'erreur
- ✓ Un canari mémoire qui s'exécute en dix secondes
Prérequis
- → Claude Code installé avec un CLAUDE.md (niveau 0 du guide de configuration)
- → sqlite3 disponible en ligne de commande
TL;DR
Je recommande la mémoire native, sauf si vous avez besoin de répondre à « how did we solve this last time » (traduction : « comment avons-nous résolu cela la dernière fois ? ») sur du travail que vous ne vous souvenez plus avoir fait ; des sessions courtes et peu de projets ne justifient pas une couche externe. Je garde claude-mem, et ce qui rend cet usage sûr pour moi est un canari hebdomadaire : dans mon installation, six choses étaient cassées, dont quatre depuis mars, et aucune n’avait levé d’erreur. Si vous utilisez une couche externe, vérifiez-la par des requêtes actives sur la portée, la couverture de l’index, le routage des coûts, la version, le retard et le disque ; ne lisez pas un journal d’erreurs propre comme une preuve de fonctionnement. Ce guide couvre seulement un stockage local mono-utilisateur ; les stockages partagés en équipe sont une question séparée que je n’ai pas évaluée.
Votre CLAUDE.md peut ne pas se charger sans le dire. C’est pourquoi le guide de configuration place une ligne canari en tête du fichier : un écho manquant est un contrôle de réponse en échec. Des preuves de chargement sont nécessaires pour établir si le fichier était absent.
claude-mem avait la même propriété, mais je n’avais pas de canari pour lui.
J’ai utilisé une couche de mémoire externe pendant quatre mois et demi. Elle a produit 49 902 observations, occupé 1,6 Go sur disque et semblé saine tout du long. Quand je l’ai enfin auditée, six choses distinctes étaient cassées. Quatre l’étaient depuis mars. Aucune n’avait jamais affiché d’erreur, dégradé une réponse d’une façon que j’aurais remarquée ou figuré dans une sortie de statut que j’avais pensé à vérifier.
Ce guide couvre la décision d’adoption, l’installation et les six contrôles. Chacun tient en deux lignes de shell et a révélé un échec.
La mémoire native et son plafond
Claude Code intègre une mémoire. Le contexte du projet réside sous ~/.claude/projects/<project>/memory/, Claude y écrit au fil de ses découvertes et il revient au début des sessions suivantes. Vous la gérez avec /memory. Le niveau 2 du guide de configuration couvre ce qui doit y figurer.
Trois propriétés définissent ce qu’elle peut faire ou non.
Le chargement au démarrage est borné. La documentation mémoire vérifiée le 15 octobre 2026 charge les 200 premières lignes ou 25 Ko de MEMORY.md, selon la première limite atteinte. Le contenu au-delà reste sur disque mais est absent du contexte initial. Gardez un index concis avec des liens vers des fichiers thématiques et placez les conventions partagées dans CLAUDE.md.
Elle est propre à l’utilisateur et jamais commitée. Cela en fait le bon endroit pour les pratiques personnelles de workflow et le mauvais pour les conventions d’équipe, qui vont dans CLAUDE.md où tout le monde les voit.
Claude écrit les éléments qu’il juge dignes d’être retenus. Dans mon usage, ce jugement était généralement bon, donc le stockage conservait les décisions sans préserver un compte rendu complet des événements.
Une couche externe capture chaque appel d’outil : chaque Read, Edit et Bash, compressé par un modèle en observation typée puis stocké dans SQLite. Quatre mois de cela forment un journal exhaustif de ce que vous avez construit et pourquoi, interrogeable par mots-clés et par sens.
La règle de décision est étroite. Prenez la couche externe lorsque vous devez répondre à des questions de type « how did we solve this last time » (traduction : « comment avons-nous résolu cela la dernière fois ? ») sur du travail dont vous ne vous souvenez plus. Avec des sessions courtes et peu de projets, la mémoire native vous couvre déjà ; la couche externe représente alors 1,6 Go et une facture de compression inutiles.
Les stockages externes partagés sont une surface d’écriture sans contrôle d’accès significatif dans la plupart des outils disponibles. Ce guide suppose un stockage local mono-utilisateur.
Le guide des systèmes de mémoire compare mémoire native, outils intersessions, partage en équipe et schémas multi-agents. Celui-ci couvre les contrôles opérationnels d’une installation locale mono-utilisateur de claude-mem.
La mise en place
L’implémentation de référence ci-dessous est claude-mem (Apache-2.0). Les commandes ciblent claude-mem, tandis que les schémas d’échec s’appliquent plus largement.
Deux commandes dans Claude Code, puis redémarrage :
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
Un piège demande vingt minutes de diagnostic. npm install -g claude-mem n’installe que la bibliothèque SDK. Il n’enregistre aucun hook, ne démarre aucun worker et n’émet aucune erreur. Installez via /plugin ou npx claude-mem install.
Vérifiez que le worker est actif :
curl -s http://127.0.0.1:37777/api/health | python3 -m json.toolVous voulez "status": "ok" et un numéro de version. Les réglages sont dans ~/.claude-mem/settings.json. Trois méritent d’être définis dès le premier jour :
{
  "CLAUDE_MEM_SKIP_TOOLS": "ListMcpResourcesTool,SlashCommand,Skill,TodoWrite,AskUserQuestion",
  "CLAUDE_MEM_CONTEXT_OBSERVATIONS": "30",
  "CLAUDE_MEM_EXCLUDED_PROJECTS": "*/scratchpad/*"
}
SKIP_TOOLS retire les outils dont les observations n’apprennent rien. CONTEXT_OBSERVATIONS fixe le nombre d’observations réinjectées par session ; 50 coûte environ 22 000 tokens de lecture à chaque démarrage, et 30 est le meilleur compromis. EXCLUDED_PROJECTS garde les répertoires temporaires hors du stockage.
Le réglage qui pilotait le coût dans cette installation était le modèle de compression. Les lots d’appels d’outils déclenchaient des appels d’observation via le chemin d’abonnement Claude configuré, sans apparaître dans les statistiques de ma session principale. Un fournisseur via API a une facturation séparée. La comparaison de septembre utilisait les tarifs de Haiku 4.5, Sonnet 5 et Opus 5.5 ; ce n’est plus une sélection actuelle de modèles.
Au 15 octobre 2026, Haiku 5.5 est un autre candidat hébergé : les entrées/sorties standard coûtent 0,10/0,50 $ par million de tokens pour les prompts jusqu’à 100 000 tokens, et 0,50/2,50 $ au-delà. Des tokens moins chers n’établissent ni la qualité des observations ni la compatibilité du plugin. Consignez le modèle effectif, le fournisseur et le parcours de facturation avant comparaison. L’étude de cas sur l’observateur mémoire local conserve la comparaison mesurée Sonnet 5 contre Qwen2.5-Coder, avec ses limites de timeout et de qualité.
Les six échecs silencieux
Chacun est présenté par le contrôle qui l’expose, car le contrôle est le livrable. Exécutez les six. Dans mon installation, chacun a trouvé un problème, raison pour laquelle je les lance ; la vôtre peut différer.
1. Il ne tourne que sur un repo
Le contrôle :
python3 -c "
import json,pathlib
d=json.loads((pathlib.Path.home()/'.claude/settings.json').read_text())
print(d.get('enabledPlugins',{}).get('claude-mem@thedotmack','ABSENT'))"
True signifie qu’il tourne partout. ABSENT signifie qu’il tourne, au mieux, sur les projets dont le propre .claude/settings.json l’active.
Ce que j’ai trouvé : ABSENT. J’avais activé le plugin dans exactement un fichier de projet, celui de mon repo de travail principal. Il y tournait depuis mars et accumulait 47 498 observations, tandis que 39 repos personnels et tous les repos clients ne produisaient rien. Le stockage contenait quelques observations égarées d’autres projets, la plus récente datée du 23 juin, sept semaines avant l’audit.
Pourquoi c’est silencieux : depuis l’intérieur du projet, un plugin limité au projet se comporte comme un plugin global. Chaque session que je lançais était dans le repo où il fonctionnait. L’échec n’apparaît qu’en comparant ce repo à ceux où claude-mem est inactif.
La correction tient en une ligne, et /plugin install l’écrit pour vous à portée utilisateur. Il ne corrigera pas rétroactivement une installation à portée projet faite des mois plus tôt.
2. L’index sémantique est vide
Une couche de mémoire externe exécute généralement deux parcours de recherche : plein texte sur le contenu brut et vectoriel sur les embeddings. Le premier est bon marché et fonctionne toujours. Le second permet de répondre à « how did we solve this » (traduction : « comment avons-nous résolu cela ? ») quand vous ne vous souvenez plus des mots utilisés.
Le contrôle :
DB=~/.claude-mem/claude-mem.db; VEC=~/.claude-mem/chroma/chroma.sqlite3
q() { sqlite3 "$VEC" "SELECT COUNT(*) FROM embedding_metadata WHERE key='$1' AND string_value='$2';"; }
echo "observations $(sqlite3 $DB 'SELECT COUNT(*) FROM observations;') / $(q field_type narrative)"
echo "summaries    $(sqlite3 $DB 'SELECT COUNT(*) FROM session_summaries;') / $(q field_type request)"
echo "prompts      $(sqlite3 $DB 'SELECT COUNT(*) FROM user_prompts;') / $(q doc_type user_prompt)"
Chaque ligne affiche stocké sur indexé, et les deux devraient être proches.
La troisième ligne utilise une autre clé. Une observation reçoit un embedding narrative et un résumé un embedding request, mais les documents de prompts n’ont aucun field_type ; il faut donc les compter par doc_type. J’ai d’abord utilisé le même motif de requête, qui rapportait zéro prompt indexé et m’aurait fait chercher un échec inexistant. Inspectez les étiquettes de métadonnées de claude-mem avant de croire un contrôle qui suppose un schéma.
Vérifiez observations, résumés de session et prompts. J’ai audité uniquement le nombre d’observations pendant deux jours et conclu qu’un rattrapage était bloqué, alors que claude-mem traitait résumés et prompts tout du long. Ces deux tables portaient leur propre retard de plusieurs mois, et un contrôle d’une seule table y est aveugle par construction.
Ce que j’ai trouvé : claude-mem avait stocké 47 498 observations sans en vectoriser aucune. Il avait indexé des milliers de résumés et prompts, laissant quatre mois de recherche sémantique interroger une collection d’observations vide.
Pourquoi c’est silencieux : la recherche plein texte continuait de renvoyer des résultats, masquant la perte du rappel sémantique. Ce rappel n’a pas de vérité de référence vérifiable à l’œil ; les résultats semblaient donc plausibles.
Deux fausses pistes m’ont coûté une heure parce qu’elles ressemblent à des contrôles raisonnables.
Dans le mode local par défaut de claude-mem, le stockage vectoriel tourne comme sous-processus via stdio, et les réglages HOST et PORT ne s’appliquent qu’au mode distant. Un curl sur le port échoue identiquement sur une installation saine ou cassée, ce qui le rend pire qu’une absence de contrôle. Utilisez plutôt la sonde de claude-mem :
curl -s "http://127.0.0.1:37777/api/chroma/status?deep=1" | python3 -m json.toolElle effectue un aller-retour complet de recherche et rapporte la latence. La mienne revenait saine en 56 ms alors que la collection était vide. La sonde mesure seulement la disponibilité de la recherche.
chroma-sync-state.json contient un point haut par projet, le plus grand identifiant de ligne que la synchronisation croit avoir traité. Leur somme me donnait 1 876 794 pour 49 217 observations stockées, comparaison invalide. Par projet, c’est le fichier qui révèle l’échec n° 5.
3. Le routage des coûts ne se déclenche jamais
Le routage par niveaux envoie le travail bon marché vers un modèle bon marché et réserve le coûteux au travail qui en a besoin. Le mien était activé, avec les deux niveaux dirigés vers le modèle bon marché.
Le contrôle :
sqlite3 ~/.claude-mem/claude-mem.db \
  "SELECT generated_by_model, COUNT(*) FROM observations
WHERE created_at > date('now','-7 days') GROUP BY 1;"Pourquoi c’est silencieux : le routage fonctionnait exactement comme écrit. Dans le code source, à SessionRoutes.ts:664, le niveau bon marché n’est sélectionné que si chaque message du tampon en attente est une observation dont l’outil est Read, Glob, Grep, LS ou ListMcpResourcesTool. Un seul Edit, Write ou Bash n’importe où dans le lot envoie le lot entier au modèle par défaut. Dans une vraie session d’édition, cette condition n’est presque jamais vraie.
Le routage suit sa condition documentée, il n’y a donc pas de bug à signaler. En session d’édition, cette condition laisse le modèle par défaut gouverner la facture ; la configuration par niveaux n’a pas d’effet pratique.
Comparez les routes configurées aux décomptes generated_by_model. Une configuration valide peut tout de même n’envoyer aucun lot au modèle bon marché.
4. Douze releases de retard
Le contrôle :
curl -s http://127.0.0.1:37777/api/health | python3 -c "import json,sys; print(json.load(sys.stdin)['version'])"
npm view claude-mem version
Ce que j’ai trouvé : la 13.9.2 active, épinglée à un commit du 30 juin. La dernière était la 13.15.0. Douze releases, six semaines, aucune notification, malgré un script de vérification de version lancé comme hook Setup à chaque session.
Pourquoi cela compte plus que d’habitude : la mise à jour a résolu directement l’échec n° 2. Le changement de version a déclenché un rattrapage commençant à vectoriser quatre mois d’observations jamais indexées. Je me préparais à déboguer un build de juin.
Avant de déboguer un plugin, vérifiez sa version. J’avais sauté ce contrôle pendant six semaines.
5. Le rattrapage croit un point haut qu’il ne vérifie jamais
L’échec n° 5 n’est devenu visible qu’après correction du n° 4.
La mise à jour a lancé un rattrapage. Il a atteint environ 65 % puis s’est arrêté. Je le pensais encore actif, puisque le fichier de base de données était écrit chaque minute.
Le contrôle est celui du n° 2, exécuté deux fois à un jour d’écart. Comparez l’écart.
Ce que j’ai trouvé :
| Jour 1 | Jour 2 | Variation | |
|---|---|---|---|
| Observations stockées | 49 217 | 49 343 | +126 |
| Observations indexées | 32 254 | 32 380 | +126 |
| Écart | 16 963 | 16 963 | 0 |
L’écart d’observations était identique les deux jours. Les résumés de session avaient le même écart figé, 2 104 les deux jours. Les prompts aussi, à 5 482. Les trois écarts sont restés inchangés pendant 24 heures.
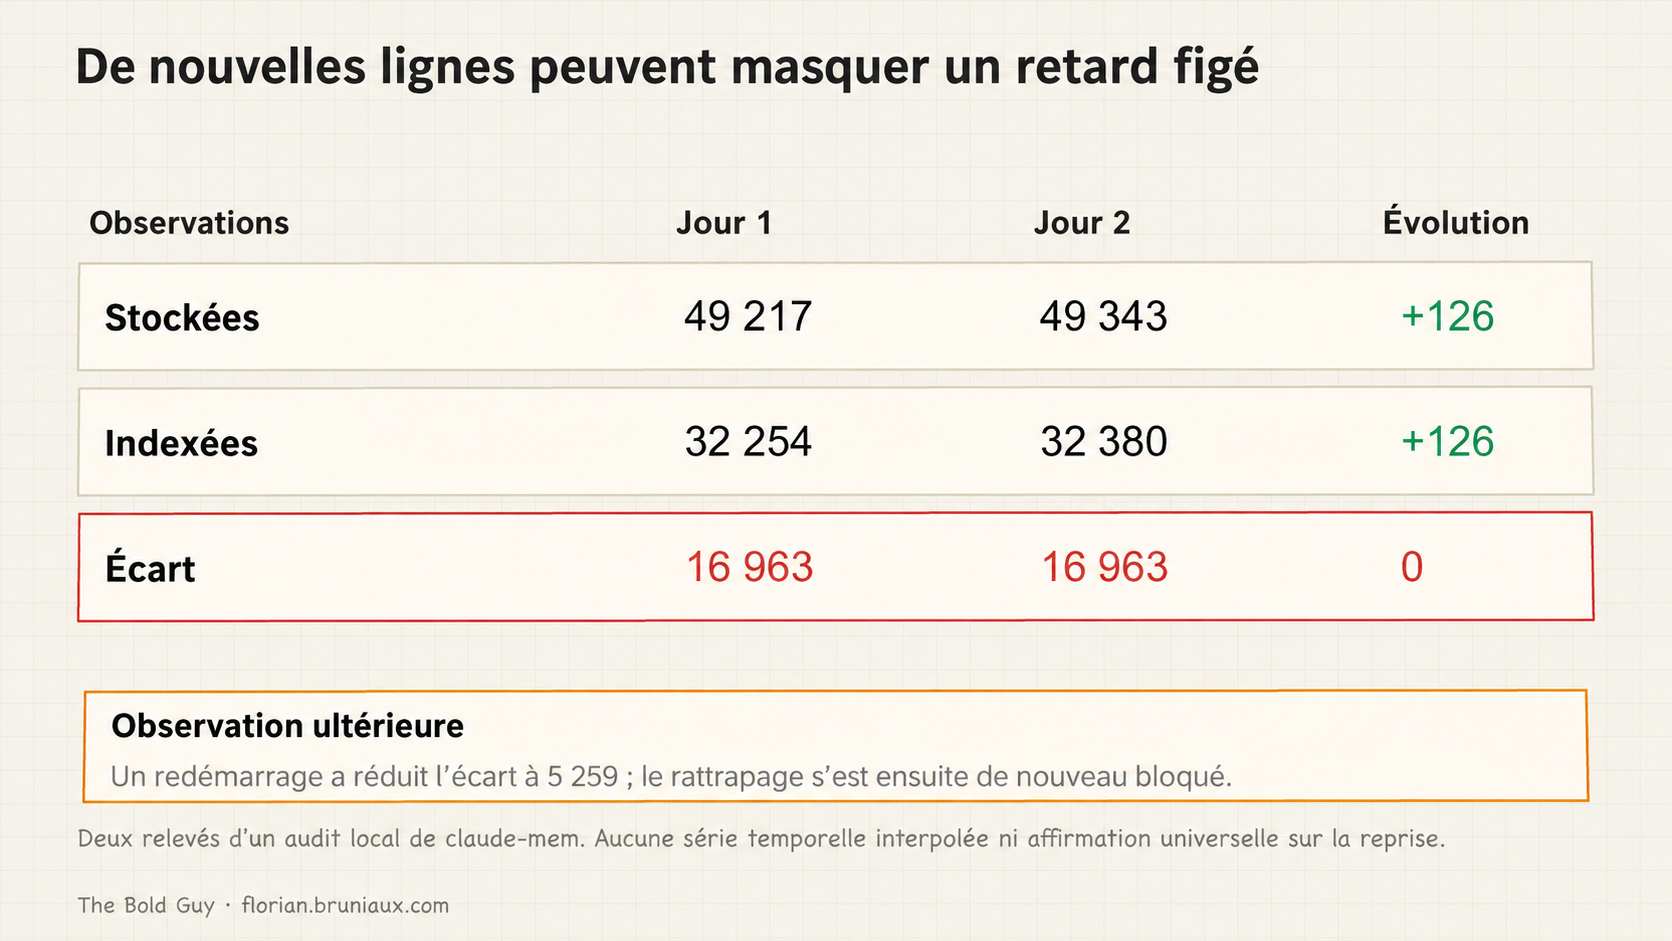
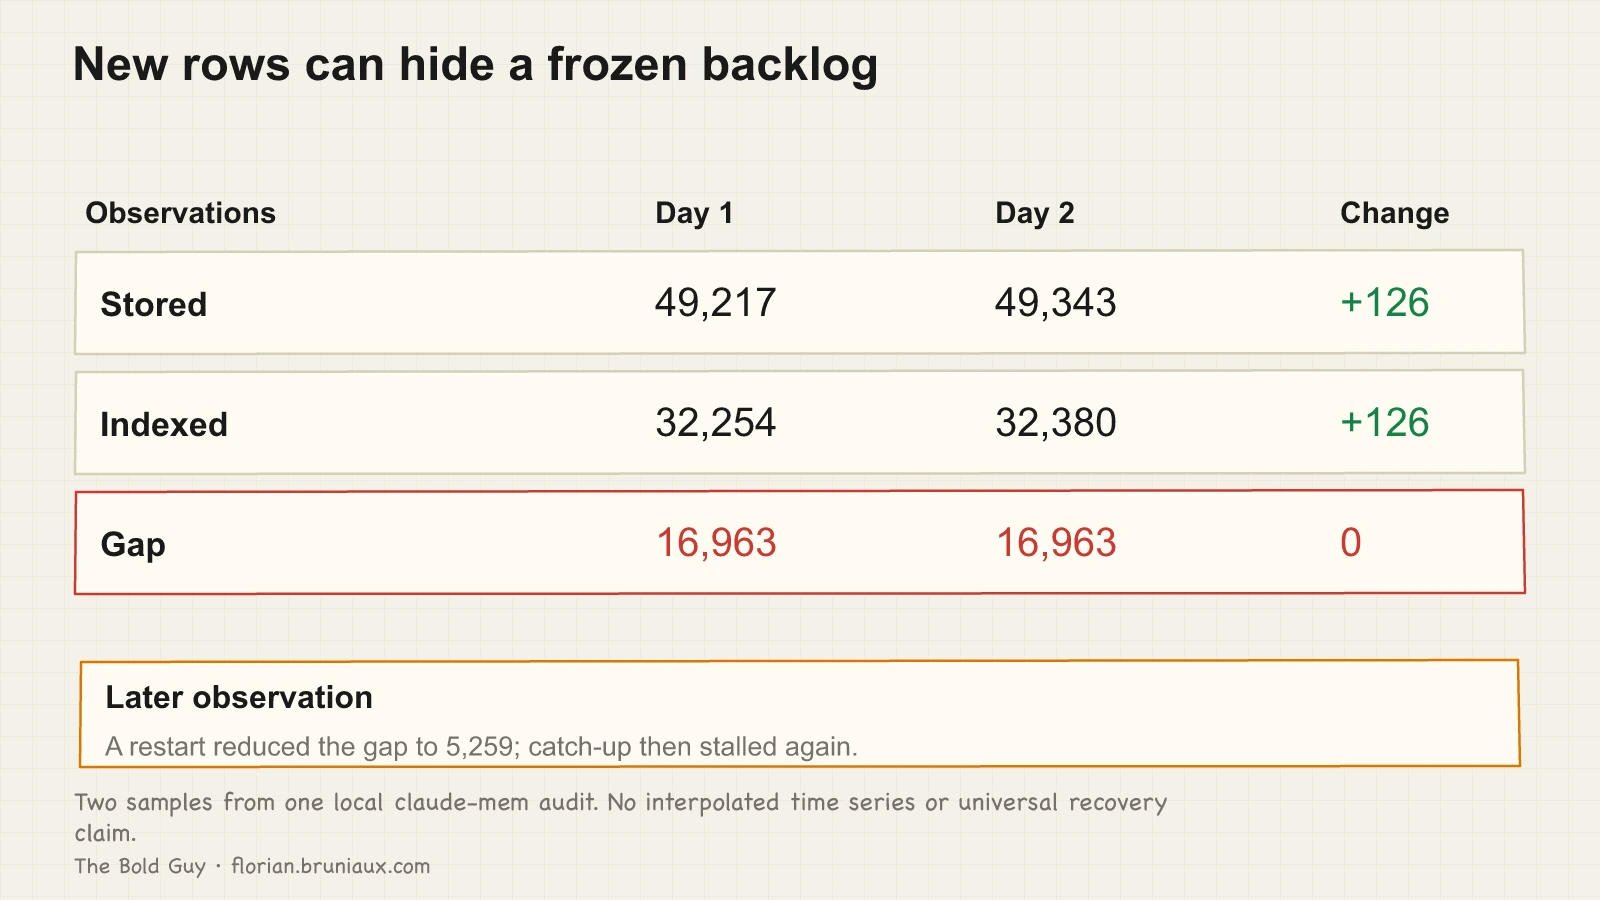
La synchronisation incrémentale était parfaite : 126 nouvelles observations créées, 126 indexées en temps réel. C’est ce que j’avais pris pour un rattrapage actif. Le parcours courant indexait les nouvelles lignes tandis que le job de rattrapage s’était arrêté.
Première cause : le rattrapage ne tourne qu’au démarrage du worker. Il ne se réarme jamais pendant la vie du processus. Mon worker était actif sans interruption depuis la mise à jour et gardait donc son retard indéfiniment. Le redémarrer vidait le retard à environ 215 observations par minute :
claude-mem restartL’écart de 16 963 qui tenait depuis trois jours est descendu à 15 655 en deux minutes. Puis à 5 259, avant un nouvel arrêt, et un second redémarrage ne l’a pas fait bouger. Les 5 259 lignes restantes indiquent une seconde cause.
Seconde cause, masquée par la première : le rattrapage est piloté par un point haut, qui peut avancer au-delà du contenu jamais indexé.
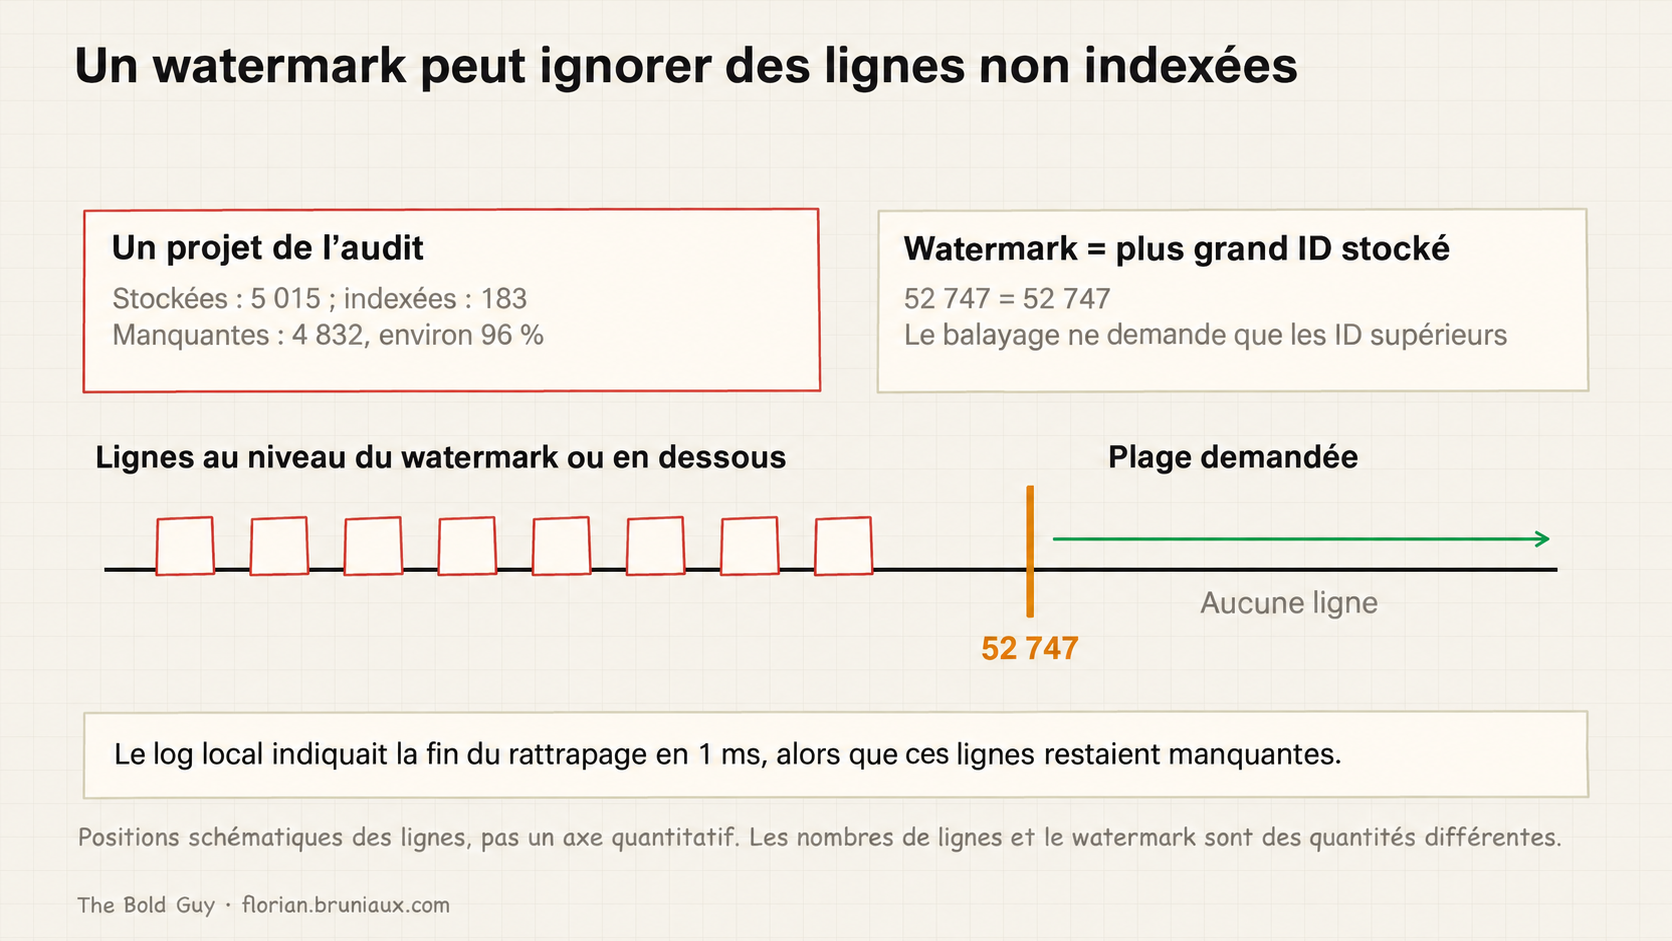
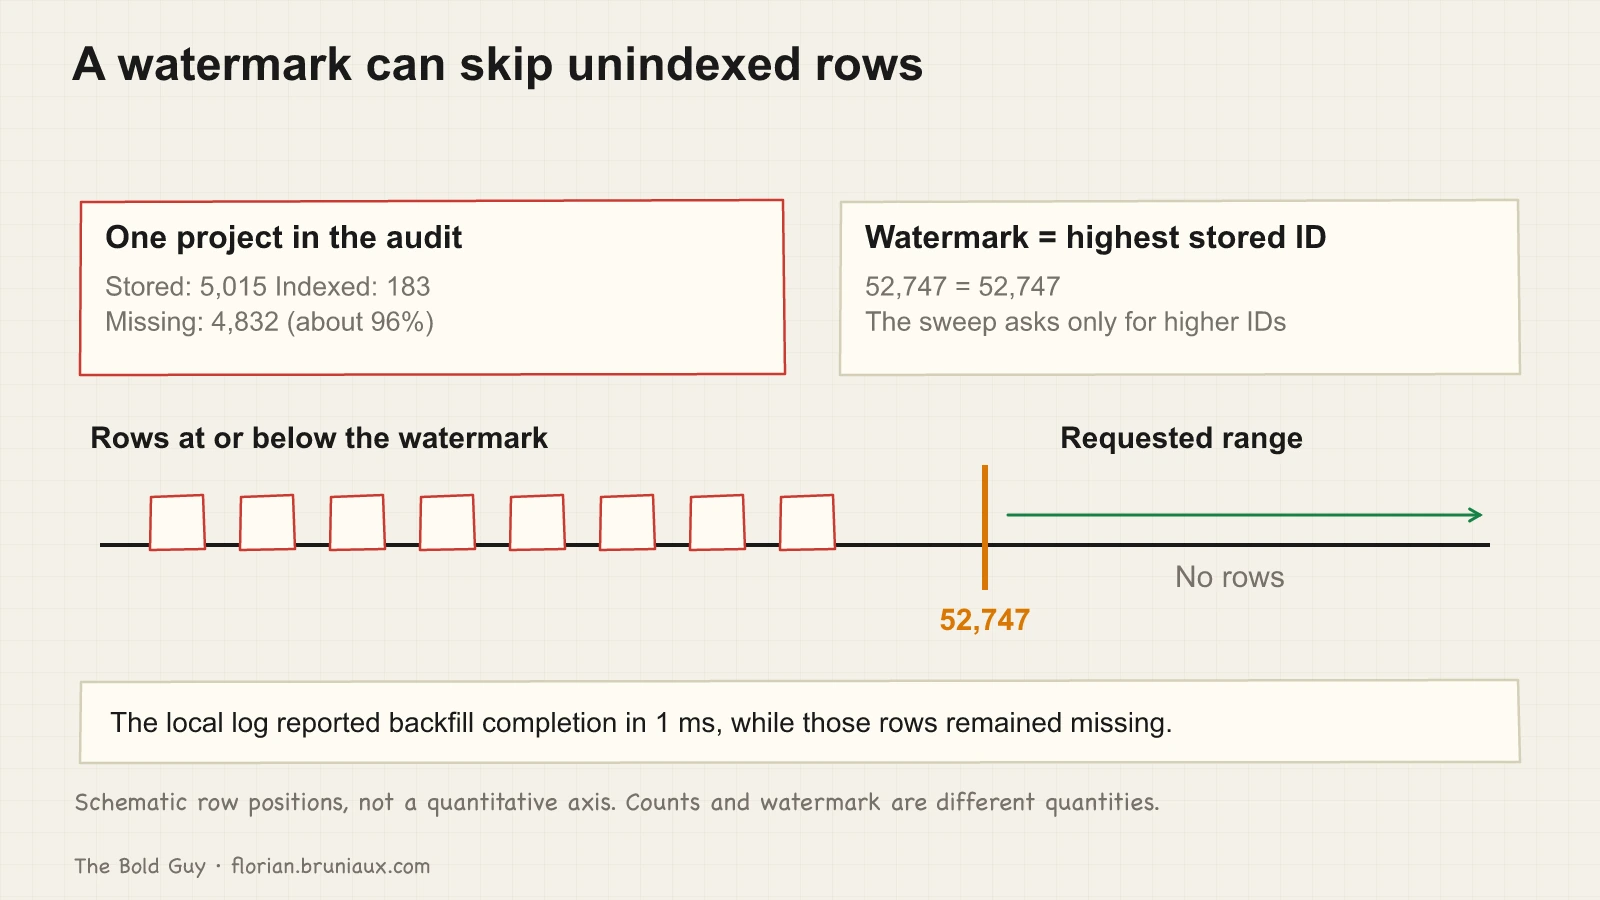
Par projet, chroma-sync-state.json contient le plus grand identifiant de ligne que la synchronisation croit avoir traité. Le balayage demande les lignes au-dessus de cette marque. Pour un projet, l’entrée était observations: 52747, et le plus grand identifiant d’observation du projet est 52747. Correspondance exacte. Le balayage n’avait donc rien à demander, et les logs montrent à quoi cela ressemble :
08:50:57.794 [CHROMA_SYNC] Starting smart backfill {project=app/feature-poc-meet}
08:50:57.795 [CHROMA_SYNC] Smart backfill complete {project=app/feature-poc-meet, synced=[object Object]}
Une milliseconde, rapportée comme succès. Pendant ce temps, le projet avait 5 015 observations stockées et 183 indexées.
Une comparaison par projet a localisé tout le résidu à deux endroits :
| Projet | Stocké | Indexé | Écart |
|---|---|---|---|
app/feature-poc-meet | 5 015 | 183 | 4 832 |
app | 27 626 | 27 482 | 144 |
claude-code-ultimate-guide | 105 | 55 | 50 |
Les 144 sur app sont du travail en cours. Les deux autres sont des points hauts périmés : 96 % et 48 % de ces projets ne seront jamais indexés, quel que soit le nombre de redémarrages, parce qu’on a dit au balayage qu’il n’y avait rien à faire.
Le contrôle par projet, celui qui mérite d’être exécuté, puisqu’un écart global masque complètement cela :
python3 -c "
import json,pathlib,sqlite3
w=json.loads((pathlib.Path.home()/'.claude-mem/chroma-sync-state.json').read_text())
db=sqlite3.connect(pathlib.Path.home()/'.claude-mem/claude-mem.db')
for proj,maxid,n in db.execute('SELECT project,MAX(id),COUNT(*) FROM observations GROUP BY project'):
    mark=w.get(proj,{}).get('observations',0)
    if mark>=maxid and n>50: print(f'{proj:44} watermark burnt, {n} rows at risk')"
La source contient déjà l’amorçage de récupération, mais sa garde l’empêche de tourner. Cet amorçage recalcule chaque point haut depuis le stockage vectoriel et consigne les identifiants manquants sous chaque marque, pour que le balayage suivant les reprenne. Il se déclenche à une condition :
if (!ChromaSyncState.exists()) {
  logger.info('CHROMA_SYNC', 'Watermark cache missing — bootstrapping from Chroma (one-time)')
Dans le build audité, il ne tournait qu’en l’absence du fichier d’état. Ce build traitait un fichier existant d’un ancien build, portant des marques jamais vérifiées, comme preuve d’une vérification déjà faite. Le mien se trahissait par l’absence de toutes les clés pending écrites par le code audité. Vérifiez la version installée avant de prolonger ce diagnostic.
Supprimer le cache suit les propres termes du log et récupère tous les projets à la fois :
rm ~/.claude-mem/chroma-sync-state.json && claude-mem restartConfirmez le déclenchement avant de vous y fier :
grep "bootstrapping from Chroma" ~/.claude-mem/logs/claude-mem-$(date +%F).logTout worker de fond durable avec une réconciliation limitée au démarrage garde le retard accumulé tout en ayant l’air actif. Une réconciliation qui croit un point haut stocké hérite de ses erreurs, parce que la marque désactive le mécanisme qui les détecterait. Suivez l’écart stocké-indexé dans le temps. Une écriture de fichier confirme que le processus vit. L’écart montre s’il résorbe le retard.
Sous l’isolation macOS de Claude Code, ps, pgrep et pkill échouent avec sysmond service not found ; les contrôles de processus y induisent donc en erreur. Utilisez lsof -nP -iTCP:<port> -sTCP:LISTEN pour voir ce qui écoute, et claude-mem restart plutôt que des signaux.
6. Rien n’est jamais nettoyé
Le contrôle :
du -sh ~/.claude-mem && du -sh ~/.claude-mem/* | sort -rh | head -5Ce que j’ai trouvé : 981 Mo, dont environ 550 Mo de poids mort. Les logs représentaient 397 Mo dans 116 fichiers sans rotation, un fichier journalier pesant 66 Mo. Deux sauvegardes de migration orphelines prenaient 269 Mo de plus, l’une de mars et l’autre de juillet, toutes deux dépassées depuis des semaines.
L’installation auditée n’avait pas de réglage de conservation pour ces fichiers. Les logs s’accumulaient jusqu’à suppression et les migrations de schéma laissaient des copies complètes de la base. Inspectez la release installée et la politique de sauvegarde avant de supposer ce comportement encore applicable.
find ~/.claude-mem/logs -name "*.log" -mtime +30 -delete
rm -f ~/.claude-mem/claude-mem.db.bak-* ~/.claude-mem/backups/claude-mem-pre-*.db
Cela m’a fait passer de 981 à 431 Mo.
Une fois l’indexation fonctionnelle, l’index vectoriel devient la plus grosse source de croissance. Le mien est passé de 125 Mo à 1,3 Go en cinq jours à mesure du rattrapage, pour 49 902 observations et une base source de 245 Mo. Prévoyez un index de quatre à cinq fois la taille des données indexées. Toute cette croissance venait des données d’index.
Le canari mémoire
Six contrôles, c’est cinq de trop à lancer à la main. Une commande en combine une partie. Conservez les contrôles par projet et par table, ainsi que les mesures répétées des écarts ci-dessus. Adaptez les chemins si votre couche diffère ; les quatre questions se généralisent à toutes.
#!/usr/bin/env bash
# memory-canary.sh (run weekly)
DB=~/.claude-mem/claude-mem.db
VEC=~/.claude-mem/chroma/chroma.sqlite3

echo "== scope =="
python3 -c "
import json,pathlib
d=json.loads((pathlib.Path.home()/'.claude/settings.json').read_text())
print('global:', d.get('enabledPlugins',{}).get('claude-mem@thedotmack','ABSENT'))"

echo "== coverage =="
S=$(sqlite3 "$DB" 'SELECT COUNT(*) FROM observations;')
I=$(sqlite3 "$VEC" "SELECT COUNT(*) FROM embedding_metadata WHERE key='field_type' AND string_value='narrative';")
echo "stored=$S indexed=$I gap=$((S-I))"

echo "== cost =="
sqlite3 "$DB" "SELECT generated_by_model, COUNT(*) FROM observations
  WHERE created_at > date('now','-7 days') GROUP BY 1;"

echo "== version =="
curl -s http://127.0.0.1:37777/api/health \
  | python3 -c "import json,sys; print('running', json.load(sys.stdin)['version'])"
npm view claude-mem version 2>/dev/null | sed 's/^/latest  /'

echo "== disk =="
du -sh ~/.claude-mem
Pour lire la sortie, comparez le même écart stocké/indexé dans le temps et par projet ; un grand échantillon seul peut aussi représenter du travail en cours. Lancez claude-mem restart, puis le canari à nouveau et vérifiez que l’écart a bougé. Sinon, lancez le contrôle par projet du n° 5, parce qu’un écart global masque un point haut périmé. Une ligne de coût dominée par le modèle coûteux alors que vous avez configuré un routage par niveaux signifie que ce routage ne se déclenche jamais. Si la version active est en retard, mettez claude-mem à jour avant toute autre investigation.
Exécutez-le régulièrement et comparez les résultats successifs. Ce canari abrégé n’établit pas à lui seul la couverture de tous les types de documents, projets ou écarts historiques.
Le problème de l’accès en écriture
Les stockages de mémoire partagés sont des cibles d’écriture durables. Une entrée empoisonnée revient comme contexte de confiance dans chaque session future jusqu’à son retrait par un utilisateur. Ce guide couvre les stockages locaux mono-utilisateur. Il n’a pas étudié les protections des stockages partagés en équipe ; ces déploiements demandent donc une review séparée des permissions d’écriture.
Le guide des six niveaux de context engineering traite une décision antérieure : quel contexte atteint Claude avant que la mémoire persistante le stocke.
Pourquoi je faisais confiance à claude-mem
J’ai fait confiance à claude-mem pendant quatre mois. Je lui demandais ce que nous avions décidé sur une migration en mai et obtenais une réponse utile, alors j’ai cessé de le remettre en question. Cette confiance était calibrée sur claude-mem couvrant un repo sur quarante, avec un index sémantique vide, sur un build de juin.
La recherche plein texte sur les 47 498 observations de mon repo principal donnait des réponses utiles, et toutes mes questions tombaient dans la partie qui fonctionnait. Les réponses manquantes restaient invisibles parce que je n’avais pas de raison de penser que claude-mem aurait pu répondre à ces questions.
Les contrôles tiennent chacun en deux lignes de SQL. Je les ai sautés pendant six semaines parce que claude-mem ne m’avait jamais donné de raison de regarder.
Lancez les six contrôles avant de traiter un journal d’erreurs propre comme preuve que le stockage fonctionne. J’ai gardé claude-mem après l’audit et lance désormais le canari chaque semaine.
YSNK
(Vous devriez maintenant savoir)
- Un stockage vectoriel en mode local n’a pas de port HTTP ; un contrôle de santé
curlsur un port échoue donc identiquement sur une installation saine ou cassée. Utilisez la sonde approfondie de claude-mem, qui effectue un aller-retour complet de recherche - Un fichier d’état de synchronisation ressemblant à un compteur est généralement un point haut. Additionné entre projets, le mien donnait 1 876 794 pour 49 217 lignes stockées, ce qui ne signifie rien. Par projet, c’était le plus grand identifiant traité, le nombre le plus utile du répertoire
- Un point haut qui dépasse du contenu non indexé survit à chaque redémarrage, car le balayage ne demande que les lignes au-dessus. Un projet journalisait
Starting smart backfilletSmart backfill completeà une milliseconde d’écart, rapportés comme succès, avec 4 832 de ses 5 015 lignes non indexées - Une réparation ponctuelle conditionnée par
if (!stateFile.exists())ne tourne jamais sur les installations qui en ont besoin, puisque l’état corrompu est lui-même un fichier. Supprimer un cache est souvent le parcours de récupération pris en charge, et lire la garde l’indique plus vite que lire la documentation - Un job de réconciliation limité au démarrage dans un worker durable conserve son retard indéfiniment pendant que le processus a l’air actif. Mesurez le même écart à 24 heures d’intervalle et par projet. Les écritures de fichiers ne montrent pas que la réconciliation résorbe le retard
- Un routage par niveaux exigeant que chaque message d’un lot soit un appel d’outil en lecture seule ne se déclenchera pratiquement jamais en session d’édition. 13 040 observations sur le modèle coûteux contre 342 sur le bon marché, avec les niveaux activés tout du long
ps,pgrepetpkillrenvoientsysmond service not foundsous l’isolation macOS de Claude Code. Utilisezlsof -nP -iTCP:<port> -sTCP:LISTENpour ce qui écoute etclaude-mem restartplutôt que des signaux- Prévoyez un index vectoriel de quatre à cinq fois la taille de la base indexée. Le mien atteignait 1,3 Go pour une source de 245 Mo. L’index vectoriel expliquait cette croissance
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source