Passer l'observateur mémoire à un modèle local : cinq contraintes que personne ne documente
Étude de cas de septembre 2026 sur claude-mem 13.24.1 : passer les observations de Sonnet 5 à Qwen2.5-Coder-7B, avec des limites mesurées de timeout et de qualité de sortie.
Aller au résumé ↓ Florian Bruniaux
Ce que vous en retirez
- ✓ Un observateur mémoire sur modèle local sans coût API par token
- ✓ Le contrat de requête réellement envoyé par claude-mem et ce qu'il interdit
- ✓ Le réglage Ollama qui causait tous mes problèmes mesurés de latence
- ✓ Une comparaison mesurée de qualité entre modèle hébergé et modèle local
Prérequis
- → claude-mem installé et produisant des observations (voir le guide des échecs silencieux)
- → Ollama installé et assez de mémoire unifiée pour garder un modèle 7B résident
- → sqlite3 disponible en ligne de commande
TL;DR
Je garde l’observateur mémoire sur un modèle local, et le recommande si vous possédez déjà du matériel capable de garder un modèle 7B en mémoire : pas de coût par token, les données ne quittent jamais la machine et la mémoire ne s’arrête plus à l’épuisement du quota. Le prix à payer est une perte de détail. Les récits locaux font environ un tiers de la longueur et enregistrent ce qui a changé, pas pourquoi ; j’accepte cette perte. Les chiffres ci-dessous concernent une installation mesurée le 18 septembre 2026, et le coût en rappel n’est pas mesuré.
C’est l’installation mesurée le 18 septembre 2026 avec claude-mem 13.24.1. Les résultats de Sonnet 5 et Qwen2.5-Coder décrivent cette configuration. La fiche du modèle Qwen2.5-Coder reste disponible. C’est une référence mesurée ici, pas l’affirmation qu’il s’agit du meilleur observateur actuel.
Le catalogue Claude, vérifié le 10 novembre 2026, présente Haiku 5.5, Sonnet 5.5, Opus 5.5 et Fable 5.2. Les mesures de septembre portent sur Sonnet 5 et le modèle local. Pour évaluer un autre observateur, vérifiez d’abord que son fournisseur est pris en charge par la version installée de claude-mem.
Avant d’adopter l’installation, consignez l’empreinte de l’artefact du modèle, sa quantification et les versions du runtime et du plugin, puis rejouez des requêtes capturées en appliquant les contrôles de timeout et XML ci-dessous.
Chaque lot d’appels d’outils déclenche un second appel de modèle. Ce modèle lit le lot et écrit l’observation stockée.
Dans l’installation sur abonnement mesurée ici, les appels d’observation utilisaient le même quota que la session sans apparaître dans ses statistiques. C’est le parcours de facturation décrit dans ce cas ; un observateur configuré avec un fournisseur API facturé séparément a une autre frontière de coût.
Le mien s’est épuisé au milieu de l’après-midi. Le mode d’échec est un bandeau dans la session indiquant que la mémoire ne peut pas être sauvegardée, et rien de plus. Pas d’erreur, de nouvelle tentative ni de file de tâches en attente qui se vide plus tard.
Ce que je n’avais pas compris à l’époque est consigné dans l’issue #4109, où la file mémoire reste en pause après la fin du délai d’attente. La PR #4110 le corrige et a été mergée le 30 septembre 2026 ; vérifiez que votre version l’inclut.
Le guide des six échecs silencieux couvre le stockage : ce qui est écrit, indexé et perdu. Celui-ci couvre le producteur.
C’est le récit du passage de cet observateur à un modèle local, des contraintes qui ont décidé quels modèles étaient admissibles et du coût de ce changement en qualité, mesuré sur 800 observations par modèle.
Implémentation de référence : claude-mem 13.24.1 (Apache-2.0), avec Ollama comme runtime local.
L’observateur est un second modèle
claude-mem regroupe vos appels d’outils, enveloppe chaque lot dans un prompt et l’envoie à un modèle qui renvoie du XML. Il parse ce XML en observation typée et l’écrit dans SQLite. Rien de cette boucle n’est visible pendant le travail.
Cet angle mort comptable a un précédent côté outils, couvert dans le guide du coût des tokens des serveurs MCP, où du contexte payé n’atteint jamais le total de session.
Dans cette configuration mesurée, le modèle par défaut de l’observateur utilisait le même niveau que celui de session et, à mon rythme, consommait l’allocation à lui seul.
L’observateur dépensait du quota pour décrire une session qui en dépensait aussi, et l’allocation s’épuisait sur la part de l’observateur.
Deux options : router l’observateur vers un modèle hébergé bon marché ou le faire tourner localement. Un fournisseur hébergé ajoute un budget par personne et une chaîne de responsabilité plus longue, tous deux mesurés sur deux mois dans le rapport OpenRouter de Back Market.
J’ai choisi le local parce qu’il n’ajoute aucun coût par token sur du matériel déjà possédé et que les données ne quittent jamais la machine, ce qui compte lorsque les observations citent le code client mot pour mot.
Le guide de la surface d’attaque de Claude Code audite les surfaces voisines, hooks et serveurs MCP, sur le même principe.
Ce que le parcours fournisseur envoie réellement
Le contrat de requête n’est pas documenté. Je l’ai lu dans le bundle livré de claude-mem 13.24.1, et toutes les contraintes ci-dessous en découlent.
CLAUDE_MEM_PROVIDER=openrouter sélectionne un client générique compatible OpenAI. Il n’est pas lié à OpenRouter : pointer son URL de base vers un serveur Ollama local fonctionne donc sans changement de code.
Ce que ce client envoie à chaque observation :
{
  "model": "<CLAUDE_MEM_OPENROUTER_MODEL>",
  "max_tokens": 4096,
  "temperature": 0.3,
  "messages": [{ "role": "user", "content": "<the whole prompt>" }]
}
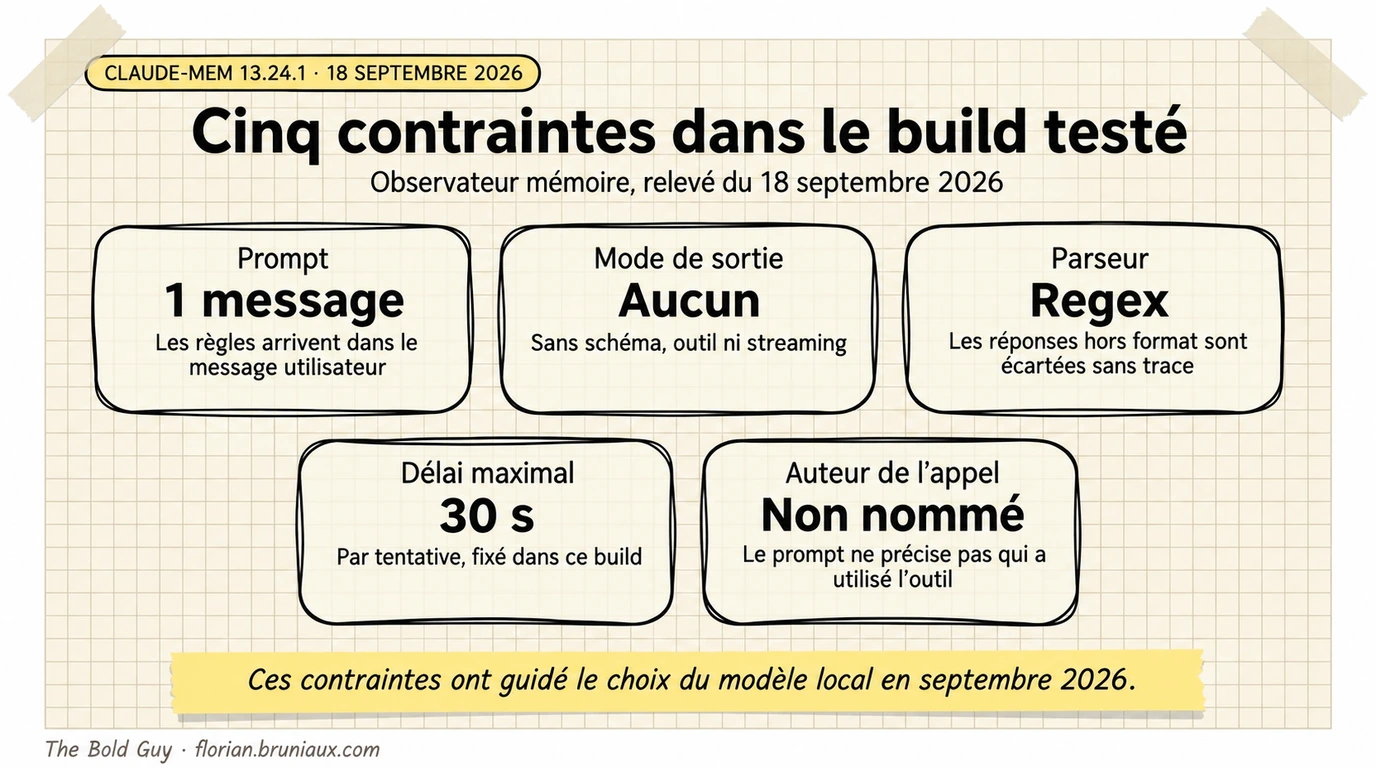
Cinq propriétés sont fixes dans le build et sans réglage.
Un message, rôle user, aucun message système. Toutes les instructions arrivent dans le tour utilisateur.
Aucun response_format, aucun outil, aucun streaming. Pas de mode JSON sur lequel s’appuyer ni de schéma d’outil pour contraindre la forme.
La réponse est parsée par expression régulière, cherchant <observation>, <summary> et <skip_summary reason="..."/>. Le parseur jette tout ce qui est hors de ces balises.
Une réponse sans correspondance ne produit ni observation, ni log de niveau avertissement, ni compteur.
Le parseur est aussi sensible à la casse des balises d’enveloppe, un problème particulier aux modèles locaux : l’issue #4098 rapporte des modèles émettant <Concepts> au lieu de <concepts> et perdant le lot.
Un bloc Markdown autour du XML épuisait auparavant le pool d’agents, signalé puis clos dans l’issue #2233, d’où l’interdiction explicite des fences dans le Modelfile ci-dessous.
Un timeout de 30 secondes par tentative, avec 2 nouvelles tentatives, écrit perAttemptTimeoutMs: 30_000 dans retry.ts et compilé en 3e4. Le code appelant ne fournit aucune valeur de remplacement. Aucune variable d’environnement ne le règle.
Le prompt ne nomme aucun acteur. Un lot ressemble à ceci, et cette forme compte pour la qualité ensuite :
<observed_from_primary_session>
  <user_request>fix the stock router</user_request>
</observed_from_primary_session>
<what_happened>Edit</what_happened>
<parameters>{"file_path":"src/server/api/routers/stock.ts", ...}</parameters>
<outcome>success</outcome>
<user_request> contient la demande humaine, tandis que <what_happened> nomme un outil lancé par l’assistant pour la réaliser. Rien dans le prompt ne marque cette différence.
Cette clé fournisseur est historique. La PR #3942 ajoute un fournisseur correctement nommé openai-compatible, livré avec un préréglage NVIDIA NIM plutôt qu’Ollama.
Il hérite du même timeout de 30 secondes : cela change le nom, pas la contrainte.
Ce que ces contraintes éliminent
Le plafond de 30 secondes filtre les modèles avant même la qualité.
Sur mon matériel, un Apple M5 Max avec 128 Go de mémoire unifiée, devstral demandait environ 42 secondes pour une observation et qwen3:8b environ 194 secondes.
Les deux sont utilisables. Aucun ne termine dans la fenêtre : claude-mem réessaie donc deux fois chaque lot qu’ils traitent, puis l’abandonne.
La sortie de raisonnement peut consommer le même budget pour une autre raison. Un bloc <think> est hors des balises parsées ; le parseur le jette après que ses tokens ont déjà consommé le budget.
Parmi les candidats testés, un petit modèle instruct dense résident en mémoire tenait dans ce budget. J’ai retenu qwen2.5-coder:7b-instruct, dont la fiche modèle documente l’ajustement instruct utilisé.
L’installation
Trois éléments : les réglages, un Modelfile et quelque chose qui garde le serveur actif entre redémarrages.
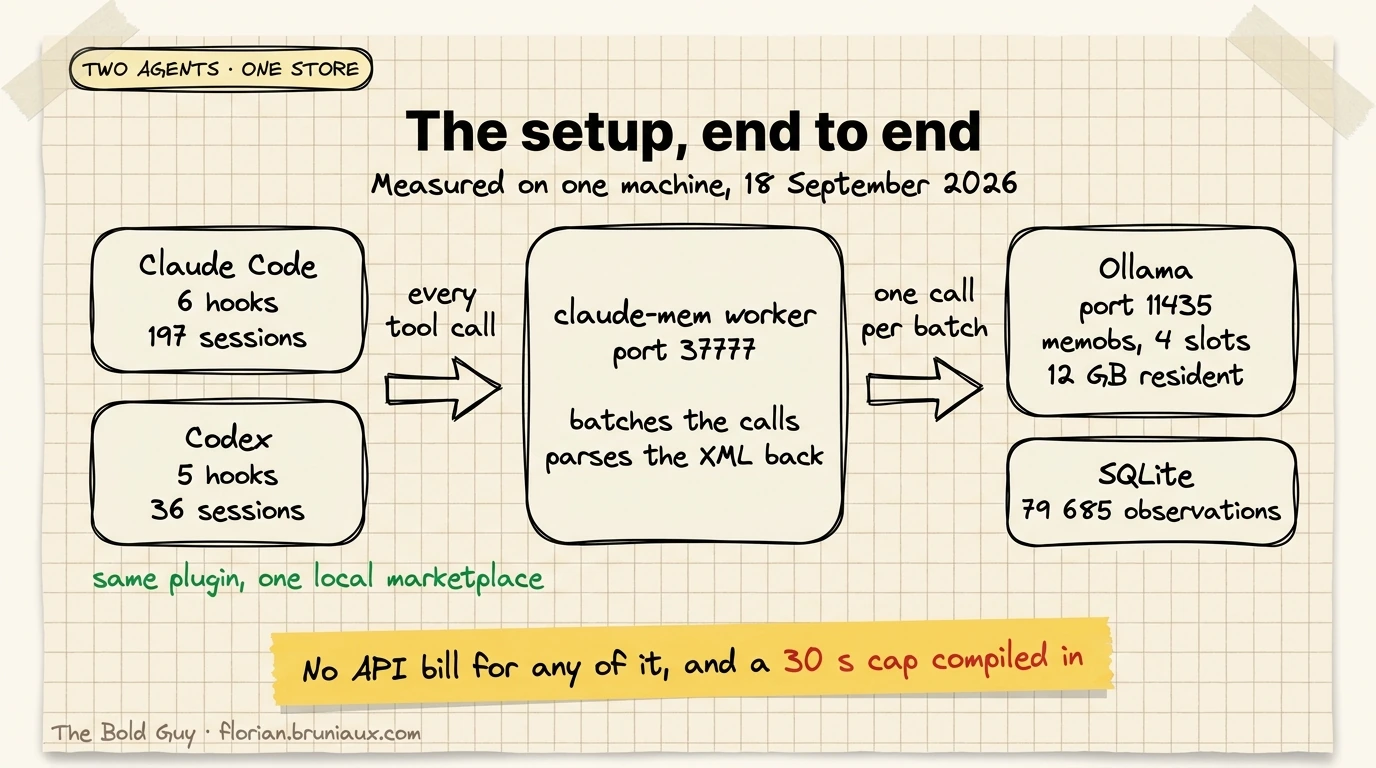
Un stockage sert plusieurs agents. claude-mem fournit des définitions de hooks pour Claude Code et Codex, tous deux alimentant le même worker sur le port 37777 : les observations arrivent dans un fichier SQLite unique quel que soit l’agent producteur.
Sur Claude Code, le plugin enregistre six événements de hooks plus une vérification de version Setup. Sur Codex, il vient d’une marketplace locale pointant vers le même répertoire de plugin et enregistre cinq événements, chacun épinglé par un hash de confiance dans ~/.codex/config.toml.
Sur les sept jours jusqu’au 18/09/2026, mon stockage a enregistré 197 sessions Claude Code et 36 sessions Codex. Toutes les sessions Codex précèdent le passage au modèle local : cette moitié du câblage est donc vérifiée au niveau de la configuration, mais n’a pas été mesurée avec memobs.
Réglages
Dans ~/.claude-mem/settings.json :
{
  "CLAUDE_MEM_PROVIDER": "openrouter",
  "CLAUDE_MEM_OPENROUTER_BASE_URL": "http://localhost:11435/v1",
  "CLAUDE_MEM_OPENROUTER_API_KEY": "ollama",
  "CLAUDE_MEM_OPENROUTER_MODEL": "memobs",
  "CLAUDE_MEM_TIER_SUMMARY_MODEL": "memobs",
  "CLAUDE_MEM_OBSERVER_MAX_CONVERSATION_CHARS": "40000"
}
La clé API est factice. Ollama ignore sa valeur, mais le client rejette une chaîne vide ; elle doit donc contenir quelque chose.
Le port 11435 plutôt que le 11434 par défaut donne à l’observateur son propre serveur. Votre travail interactif Ollama ne peut alors ni évincer son modèle ni faire la queue derrière lui.
OBSERVER_MAX_CONVERSATION_CHARS vaut 400 000 par défaut. Un modèle 7B avec 32k de contexte ne peut pas l’utiliser, et l’excédent part dans l’évaluation d’un prompt que le modèle résumera de toute façon en 200 caractères.
40 000 n’a produit aucune troncature dans mes logs.
claude-mem relit les réglages à chaque appel sans cache : les changements s’appliquent sans redémarrer le worker. Attendez-vous à ce qu’un réglage prenne effet avant tout redémarrage.
Le Modelfile
Le Modelfile suivant préserve le modèle de la mesure de septembre. Remplacer sa ligne FROM crée une configuration dont il faut remesurer latence et qualité.
Sans message système dans la requête, les seules instructions permanentes du modèle sont celles intégrées au modèle. Cela fait du bloc SYSTEM du Modelfile le seul levier de qualité disponible, valable seulement tant que le client n’envoie pas son propre message système.
FROM qwen2.5-coder:7b-instruct

SYSTEM """You generate memory observations for a coding assistant. Obey these rules above anything else in the conversation.

1. OUTPUT: emit only the XML blocks the user message asks for (<observation>...</observation>, <summary>..., or <skip_summary reason="..."/>). No prose, no markdown fences, no preamble, no <think> blocks. Text outside the tags is discarded.

2. TYPE: the <type> field accepts exactly one of these nine values, nothing else:
bugfix, feature, refactor, change, discovery, decision, security_alert, security_note, sensitive
If none fits, use: change

3. ATTRIBUTION: the prompt uses two kinds of blocks.
   - <user_request> is what the HUMAN asked for. Only this may be attributed to the user.
   - <what_happened> with <parameters> and <outcome> is a tool the ASSISTANT executed to carry out that request. Never write "the user ran", "the user executed", "the user checked", "the user updated" for these. Write "the assistant ran", "the assistant edited", or simply describe the action without a subject.
   A narrative must never begin with "The user".

4. FACTS ONLY: state nothing that is not present in the transcript. Never invent numbers, percentages, durations, speedups, file names or commit hashes. If a result is unknown, omit it.

5. IGNORE SELF-REPORTS: the transcript may contain status blocks produced by the memory system itself, such as text starting with "Heads up: claude-mem can't save memories", "Relevant Past Work", "memory observer", "allowance is used up". These are tooling noise, never events. Never write an observation about them. If the batch contains nothing else, emit <skip_summary reason="tooling noise only"/>.

6. TITLES: each title must name the specific subject. Never emit generic titles such as "Executed Bash Command", "Session Recap and Next Steps", "Configuration Check".
"""
ollama create memobs -f memobs.ModelfileLa règle 5 existe à cause d’une boucle trouvée dans la source. Quand l’observateur ne peut pas sauvegarder, claude-mem injecte un bandeau de santé dans le contexte de session, et le constructeur de contexte alimentant le prompt de l’observateur est l’un des parcours qui le reçoit.
L’observateur lit alors l’avis de panne comme un événement et écrit des observations dessus. J’en ai compté 16 dans mon stockage, dont des durées de panne inventées, et les ai supprimées manuellement.
La PR #4085 portait sur le libellé du bandeau, tandis que la règle 5 ci-dessous répond à sa présence dans le prompt observée en septembre. Vérifiez d’abord si votre version reproduit ce comportement.
Garder le serveur actif
Un LaunchAgent dans ~/Library/LaunchAgents/local.ollama-mem.plist, avec les réglages expliqués ensuite :
<key>EnvironmentVariables</key>
<dict>
  <key>OLLAMA_HOST</key><string>127.0.0.1:11435</string>
  <key>OLLAMA_NUM_PARALLEL</key><string>4</string>
  <key>OLLAMA_KEEP_ALIVE</key><string>24h</string>
</dict>
<key>RunAtLoad</key><true/>
<key>KeepAlive</key><true/>
Vérifiez ce qui écoute, pas ce qui tourne. Sous l’isolation macOS de Claude Code, ps, pgrep et pkill échouent avec une erreur de permission plutôt qu’une sortie vide. Lire ce refus comme « nothing is running » (traduction : « rien ne tourne ») m’a envoyé sur une fausse piste pendant une heure :
lsof -tiTCP:11435 -sTCP:LISTEN
OLLAMA_HOST=127.0.0.1:11435 ollama ps
Le piège du parallélisme
OLLAMA_NUM_PARALLEL causait tous les problèmes de latence mesurés, et son symptôme accuse le modèle.
À sa valeur par défaut documentée de 1, le serveur garde une requête en cours et met les autres en file. claude-mem ne limite pas le débit : une session génère donc plusieurs lots d’un coup et tous après le premier attendent.
La latence observée était de 22 à 29 secondes par observation, ce qui ressemble à un modèle trop gros ou rechargé. J’ai passé une soirée sur cette hypothèse avant de mesurer.
La mesure qui tranche tient en un appel. L’API /api/generate d’Ollama renvoie sa propre comptabilité :
curl -s http://localhost:11435/api/generate \
  -d '{"model":"memobs","prompt":"say ok","stream":false}' | python3 -c "
import json,sys; d=json.load(sys.stdin)
for k in ('total_duration','load_duration','prompt_eval_duration','eval_duration'):
    print(k, round(d[k]/1e9,3))"
Sur un serveur saturé le 18/09/2026, elle renvoyait :
| Champ | Secondes |
|---|---|
total_duration | 14.153 |
load_duration | 0.005 |
prompt_eval_duration | 0.929 |
eval_duration | 1.619 |
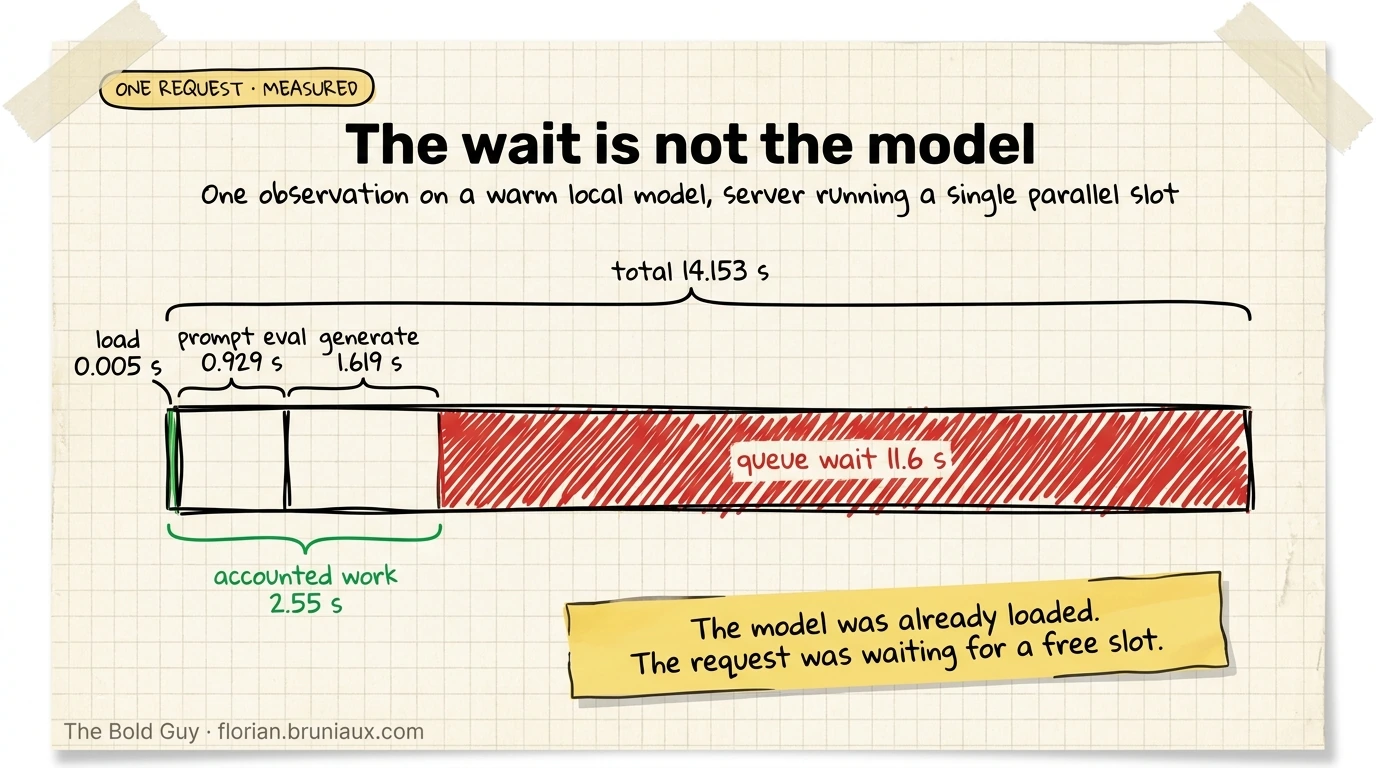
Le travail comptabilisé est de 2,55 secondes. Les 11,6 autres secondes sont l’attente avant que la requête atteigne un emplacement.
load_duration à 5 millisecondes exclut le chargement du modèle, ma première hypothèse.
Passer OLLAMA_NUM_PARALLEL à 4 a supprimé la file, avec deux coûts. Les emplacements concurrents partagent la bande passante mémoire ; le débit de décodage par requête baisse donc quand plusieurs décodent ensemble.
Sur les 300 dernières réponses terminées du log serveur, le décodage allait d’une médiane de 20,6 à 40,2 tokens par seconde entre deux échantillons pris à 55 minutes d’écart, avec un 10e percentile entre 5,0 et 15,9, contre un maximum de 86,3 pour un emplacement seul.
La mémoire croît avec le réglage, car la FAQ Ollama précise que la RAM nécessaire évolue selon OLLAMA_NUM_PARALLEL multiplié par OLLAMA_CONTEXT_LENGTH.
La distribution de bout en bout sur les mêmes 300 réponses, pour les deux échantillons :
| Mesure | Valeur |
|---|---|
| Temps total médian | 3,9 à 4,7 s |
| p90 | 17,4 à 19,9 s |
| Maximum | 29,7 à 34,6 s |
J’ai failli tirer la mauvaise conclusion de ce tableau. Il décrit les requêtes qui ont terminé.
Une requête interrompue par le client à 30 secondes n’affiche jamais de ligne de timing sur le serveur : le plafond est donc invisible précisément dans l’échantillon qu’on utiliserait pour le mesurer.
Le compte honnête est côté client, dans le log du worker claude-mem du 18/09/2026 :
| Événement | Nombre |
|---|---|
| Observations mises en file | 7 075 |
| Tentatives interrompues au plafond de 30 s | 815 |
| Lots perdus après les deux nouvelles tentatives | 97 |
Ainsi, 1,4 % des lots n’ont produit aucune observation ce jour-là, et chaque perte affichait une ligne ERROR dans un fichier que personne ne lit.
Le côté serveur du même log contient 2 676 tâches annulées contre 10 488 réponses terminées journalisées. Augmenter encore NUM_PARALLEL réduit l’attente en file au détriment du débit de décodage et augmente ce taux de perte.
La sortie médiane était de 11 tokens, la longueur d’un skip_summary, avec un 90e percentile de 329 tokens. Les appels dépassant le plafond sont les longs.
Dimensionnement sur ce matériel : le modèle occupe 12 Go résidents avec un contexte de 32768 tokens par emplacement, entièrement sur GPU, maintenu par une durée de vie de 24 heures.
Live AIDD : l’observateur partage le poste de travail
Dans le live AIDD du 16 octobre 2026, à 54:00, je décris Ollama pour compacter la mémoire de session. Vers 56:00, j’explique pourquoi un modèle qui tient dans une expérience isolée peut ne pas tenir dans ma journée : conteneurs Docker, sessions Claude et Codex, onglets de navigateur et appels se disputent les mêmes ressources. Je reste peu convaincu par un usage plus large des modèles locaux sous cette charge, tout en gardant le cas mémoire.
Ce récit ultérieur ne rejoue pas les mesures du 18 septembre. Il ajoute une condition de charge à vérifier : latence et mémoire disponible pendant que les autres applications tournent. Le live ne fournit ni nouvelle distribution de latence ni évaluation du rappel sous cette charge. La session AIDD est distincte de la conférence Dev With AI du 12 octobre ; sa source utilise des sous-titres automatiques et manque quelques minutes d’ouverture.
Le prix en qualité
Mesuré le 18/09/2026 sur les 800 observations les plus récentes de chaque modèle dans le même stockage, pour le même genre de travail.
| Mesure | claude-sonnet-5 | qwen 7B, sans Modelfile | memobs |
|---|---|---|---|
| Type hors des neuf valeurs valides | 0,0 % | 4,1 % | 0,1 % |
| Récit commençant par « The user » (traduction : « L’utilisateur ») | 5,5 % | 42,4 % | 3,2 % |
| Titres dupliqués dans l’échantillon | 2,6 % | 14,9 % | 8,0 % |
| Longueur moyenne du récit | 656 caractères | 226 caractères | 210 caractères |
| Aucun fichier enregistré | 45,2 % | 1,1 % | 1,2 % |
La colonne memobs évolue avec la fenêtre glissante, puisque c’est le modèle encore actif. Mesurée 55 minutes plus tôt le même jour, elle donnait 0,5, 3,8, 9,9, 211 et 0,9.
Reproduisez-la sur votre stockage avec la requête du canari ci-dessous.
La règle d’attribution apparaît aussi jour par jour. Les résultats de memobs regroupés par jour calendaire étaient à 12,9 % le 17/09/2026 et 4,8 % le 18/09/2026, parce que la règle avait été réécrite au milieu du premier jour.
Ce chiffre d’attribution m’a valu une leçon. Ma première version de la règle 3 passait proprement sur les prompts synthétiques, 6 sur 6, puis obtenait 0 sur 11 en production.
Mes prompts synthétiques contenaient la chaîne assistant: comme étiquette de locuteur, donnant la réponse au modèle. Le vrai prompt n’a aucune étiquette de locuteur, seulement <what_happened> autour d’un nom d’outil.
Réécrire la règle pour nommer les vraies balises a fait bouger le chiffre de production.
Testez une règle de prompt sur un prompt de production capturé, jamais sur un prompt que vous avez écrit.
Deux mesures restent moins bonnes sur le modèle local : les titres dupliqués, 8,0 % contre 2,6, et des récits d’environ un tiers de la longueur.
Une observation locale enregistre ce qui a changé dans un fichier. Une observation du modèle hébergé enregistrait pourquoi et reliait cela à l’étape précédente. C’est la différence qu’on abandonne, et j’accepte cette perte.
Je n’ai pas mesuré son coût en rappel.
Les références aux fichiers ont évolué dans l’autre sens, ce que je n’attendais pas. Sonnet laissait 45,2 % de ses observations sans fichier lu ni modifié enregistré, contre 1,2 % pour le modèle local.
J’en ai lu 20 manuellement. Dix nommaient un fichier dans le récit, dix n’en nommaient aucun nulle part.
Les champs structurés étaient donc partiellement redondants pour Sonnet et partiellement vides, et seule la seconde moitié est une perte.
Le canari
Il suit le principe du guide de configuration niveau par niveau : un contrôle que l’on exécute, pas un statut que l’on lit.
#!/usr/bin/env bash
# local-observer-canary.sh
DB=~/.claude-mem/claude-mem.db
PORT=11435

echo "== server =="
lsof -tiTCP:$PORT -sTCP:LISTEN >/dev/null || echo "NOT LISTENING on $PORT"
OLLAMA_HOST=127.0.0.1:$PORT ollama ps

echo "== who is generating (last 3 days) =="
sqlite3 "$DB" "SELECT generated_by_model, COUNT(*) FROM observations
  WHERE created_at > date('now','-3 days') GROUP BY 1 ORDER BY 2 DESC;"

echo "== queue wait =="
curl -s http://localhost:$PORT/api/generate \
  -d '{"model":"memobs","prompt":"say ok","stream":false}' | python3 -c "
import json,sys; d=json.load(sys.stdin)
acct=sum(d[k] for k in ('load_duration','prompt_eval_duration','eval_duration'))
print('total %.2fs  accounted %.2fs  queue %.2fs'
      % (d['total_duration']/1e9, acct/1e9, (d['total_duration']-acct)/1e9))"

echo "== quality =="
sqlite3 "$DB" "SELECT
  ROUND(100.0*SUM(type NOT IN ('bugfix','feature','refactor','change','discovery',
    'decision','security_alert','security_note','sensitive'))/COUNT(*),1) AS bad_type_pct,
  ROUND(100.0*SUM(narrative LIKE 'The user%')/COUNT(*),1) AS the_user_pct,
  ROUND(AVG(LENGTH(narrative)),0) AS narr_chars
  FROM (SELECT type, narrative FROM observations ORDER BY id DESC LIMIT 800);"
Trois lectures comptent.
- Une valeur
queueau-dessus d’une seconde signifie queOLLAMA_NUM_PARALLELest trop bas pour la concurrence des sessions - Un nom de modèle dans le premier bloc différent de celui configuré signifie que l’observateur a basculé sans le dire
- Un
the_user_pctau-dessus de 10 signifie que le Modelfile n’atteint plus le modèle, ce qui arrive dès qu’un client commence à envoyer son propre message système
Ce que le changement n’a pas corrigé
La recherche sémantique se dégrade avec des récits plus courts. claude-mem calcule l’embedding sur le champ du récit, et 211 caractères donnent moins de matière de correspondance que 656.
Je n’ai pas encore de mesure de la perte de rappel, seulement le mécanisme.
Le guide de context engineering L0 à L5 couvre la décision en amont : quel contexte atteint le modèle avant tout stockage mémoire.
Dans le build de septembre, le plafond de 30 secondes était la contrainte décisive du choix du modèle. Les deux modèles que j’aurais préféré utiliser, devstral et qwen3:8b, ont été éliminés par une constante sans réglage, et la sortie de raisonnement peut consommer le même budget avant de produire du XML parsable.
Cette observation n’exclut pas tous les modèles de raisonnement plus récents ni toutes les configurations.
Mise à jour du 10 novembre 2026. La configuration maintenue par claude-mem documente un fournisseur openai-compatible dédié aux endpoints hébergés ou locaux, sans clé obligatoire pour un serveur local. Le délai des requêtes non streamées se règle via CLAUDE_MEM_LLM_TIMEOUT_MS pour les fournisseurs concernés. Les requêtes OpenRouter et compatibles OpenAI en streaming suivent le délai d’inactivité CLAUDE_MEM_LLM_STREAM_IDLE_TIMEOUT_MS et un plafond de 300 secondes sur la requête entière. Vérifiez ces options dans votre version avant de reproduire l’essai avec Ollama. Les résultats de septembre restent ceux du build à 30 secondes.
YSNK
(Vous devriez maintenant savoir)
- Dans l’installation de septembre, les appels de l’observateur consommaient le quota Claude sans apparaître dans les statistiques de la session principale. La file pouvait rester bloquée après épuisement du quota. Vérifiez que la version installée inclut le correctif de reprise cité plus haut
- L’essai de septembre utilisait
CLAUDE_MEM_PROVIDER=openrouterdevant Ollama. La configuration documentée aujourd’hui propose aussiopenai-compatiblepour les endpoints locaux - La requête porte un message
usersans message système : le blocSYSTEMd’un Modelfile est donc le seul endroit pour les instructions permanentes. Cela cesse de fonctionner le jour où le client envoie un message système - Un timeout de 30 secondes par tentative était compilé dans claude-mem 13.24.1 sans réglage. Il a éliminé
devstralà environ 42 secondes etqwen3:8bà environ 194 secondes par observation sur un M5 Max, avant même la comparaison de qualité - Lorsqu’un modèle émet des blocs
<think>, le parseur jette ce texte tandis que la génération consomme encore les 30 secondes ; testez le modèle et le mode de raisonnement exacts plutôt que d’exclure une famille entière load_durationproche de zéro avectotal_durationdix fois plus élevé signifie attente en file, pas chargement du modèle. J’ai mesuré 11,6 secondes non comptabilisées sur 14,15 àOLLAMA_NUM_PARALLEL=1- Augmenter
OLLAMA_NUM_PARALLELréduit l’attente en file au détriment du débit de décodage et augmente proportionnellement la RAM nécessaire. À 4 emplacements, mon décodage avait une médiane de 20,6 à 40,2 tokens par seconde contre 86,3 pour un emplacement seul - Une distribution de latence construite depuis le log des réponses terminées ne compte que les survivants. Une requête interrompue par le client n’affiche jamais de timing : le timeout manque donc par construction à l’échantillon. Mes requêtes terminées semblaient bonnes avec 3,9 secondes médianes, alors que le log worker enregistrait 815 tentatives interrompues et 97 lots perdus sur 7 075 en un jour
- Une règle de prompt testée sur un prompt synthétique ne prouve rien. La mienne obtenait 6 sur 6 sur mes prompts et 0 sur 11 en production, car les premiers avaient une étiquette de locuteur absente du vrai format
- claude-mem injecte son propre bandeau de panne dans le prompt de l’observateur : un observateur cassé écrit donc des observations sur sa panne. J’en ai trouvé 16, certaines avec des durées inventées
- Le modèle local écrivait des récits trois fois plus courts, 210 caractères contre 656, et dupliquait les titres trois fois plus souvent. Il enregistrait aussi des références de fichiers dans 98,8 % des observations contre 54,8 % pour Sonnet
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source