Votre CLAUDE.md est trop long
Deux retours de conférence décrivent le gonflement de CLAUDE.md. Comment répartir faits du projet, procédures et préférences de réponse, puis vérifier chargement et comportement.
Aller au résumé ↓ Florian Bruniaux
TL;DR
La plupart des fichiers CLAUDE.md sont trop longs, et la raison n’est pas un nombre magique de lignes : les règles s’accumulent sans que personne les relise, jusqu’à ce que certaines se contredisent. Mon objectif de travail est un fichier racine de moins de 150 lignes, avec le contexte local limité aux répertoires, les procédures dans des skills et les préférences de réponse dans un Output Style.
| Sujet | Détails |
|---|---|
| Problème | L’accumulation d’instructions peut ajouter du contexte sans rapport et des règles contradictoires ; testez le respect des règles au lieu de le déduire du nombre de lignes |
| Source | Allainmat + Gallet et Dahan (Dev With AI), deux conférences qui convergent indépendamment sur ce schéma |
| Mécanisme | Une config dense consomme le contexte effectif, les règles accumulent des contradictions |
| Correction | Cible de l’auteur : racine sous 150 lignes ; limiter le contexte local et revoir les règles obsolètes. Aucun seuil universel de taille |
Les deux conférences Dev With AI citées ci-dessous décrivent un problème de maintenance dans les fichiers de configuration IA. Elles n’établissent pas de plafond universel de taille pour Claude Code.
Une configuration peut grossir par ajouts justifiés jusqu’à rendre ses règles difficiles à relire ensemble. La longueur du fichier rend ce problème de maintenance visible. Elle n’établit pas pourquoi un agent a échoué sur une tâche précise.
Là où davantage de contexte cesse d’aider
La recommandation habituelle est simple : plus de contexte produit de meilleures réponses. Donnez à Claude votre stack, vos conventions, contraintes et patterns préférés. Ce conseil est vrai jusqu’à un certain point. Florian Allainmat a consacré une partie de sa conférence Dev With AI (Bonjour Claude, dessine-moi un projet, avril 2026) à cette limite : la qualité du contexte se dégrade à mesure que la session grandit, Claude lui-même vous avertit de compacter et les instructions projet chargées dans la conversation sont un endroit évident où retirer le contenu sans rapport. Sa formulation, traduite en anglais dans la source : « the token war with Claude Code is a daily fight » (traduction française : « la guerre des tokens avec Claude Code est un combat quotidien »).1 Des instructions générales denses peuvent concurrencer la tâche précise et accumuler des contradictions. C’est une raison d’examiner la configuration et de tester le respect des instructions, pas la preuve d’une frontière physique précise à un certain nombre de lignes.
Samuel Gallet et Geslain Dahan ont identifié le gonflement de CLAUDE.md comme facteur contribuant à leur baisse de vélocité dans leur postmortem « What Worked, What Didn’t, What We Learned » (traduction : « Ce qui a fonctionné, ce qui n’a pas fonctionné, ce que nous avons appris »), présenté à la même conférence en mars 2026. Ils avaient ajouté des règles progressivement pendant plusieurs mois. Le fichier semblait complet et détaillé. Les réponses étaient discrètement devenues moins prévisibles, et retracer la cause a pris du temps car la dégradation était progressive plutôt que soudaine. Leur postmortem nomme deux causes qui se renforcent : déléguer des user stories entières à un agent sans garde-fou et un CLAUDE.md devenu trop gros pour être relu. Le gonflement n’a pas fait chuter la vélocité à lui seul. Il a retiré le garde-fou qui aurait pu détecter le premier problème avant qu’il ne s’amplifie.
Pourquoi cela arrive
Un fichier CLAUDE.md volumineux consomme le contexte de la conversation et peut inclure des instructions sans rapport avec la tâche en cours. La première partie distingue les résultats sur le contexte long des hypothèses sur la configuration. Les expressions smart-zone / dump-zone d’Emmanuel Sciara sont une métaphore pratique issue d’une conférence, pas une partition mesurée de l’attention de tous les modèles. Placer une tâche plus tôt ou raccourcir un fichier ne garantit pas que le modèle la suivra correctement.
Guillaume Laforge décrit un autre échec dans l’épisode 361 d’IFTTD : un modèle capable peut répondre depuis ses connaissances générales d’entraînement en ignorant le contexte fourni. Une instruction explicite d’ancrage dans le contexte et une vérification des sorties sont des interventions possibles. Ni cette instruction ni l’allègement du fichier ne garantissent la disparition de l’échec.
Les règles s’accumulent aussi sans élagage. Une règle ajoutée en janvier pour empêcher un pattern précis peut désormais contredire subtilement une règle ajoutée en avril pour résoudre un autre problème. Aucune n’est fausse isolément. Ensemble, elles rendent le comportement du modèle sur les tâches ambiguës plus difficile à prévoir, car l’ensemble d’instructions est trop vaste pour qu’il s’y conforme proprement. Le modèle tente de satisfaire des contraintes qui n’ont jamais été conçues pour coexister.
Les recherches publiées vont dans le même sens. « Lost in the Middle » de Liu et ses collègues (TACL 2024 ; traduction du titre : « Perdu au milieu ») a mesuré une utilisation inégale des contextes longs par les modèles de langage, avec un rappel dégradé selon la position de l’information, sans seuil universel net. La documentation d’Anthropic sur la mémoire recommande de viser moins de 200 lignes par fichier CLAUDE.md, car les fichiers plus longs consomment davantage de contexte et peuvent réduire le respect des instructions. C’est une recommandation, pas un plafond imposé ni un seuil universel de qualité. Un fichier de config gonflé gaspille des tokens et oblige le modèle à peser des contraintes sans rapport avec la tâche demandée.
Evaluating AGENTS.md fournit une comparaison directe sur des tâches de repositories Python. Les fichiers générés augmentaient souvent le coût sans améliorer la résolution ; les fichiers écrits par des humains apportaient des bénéfices variables selon les agents. Ces résultats évaluent des fichiers et tâches particuliers, pas une limite universelle de longueur ni une règle disant que tout fichier généré est nuisible.
Ce que recommande le guide Claude Code
Le chapitre sur les systèmes de mémoire du guide Claude Code documente une structure précise : garder le CLAUDE.md racine concis et utiliser des fichiers imbriqués à portée limitée dans les sous-répertoires pour le contexte propre à certaines parties de la codebase. La racine traite de l’identité du projet, des contraintes non négociables, des conventions universelles et des renvois vers les règles spécifiques. Les fichiers par répertoire portent le contexte local qui gonflerait autrement la racine.
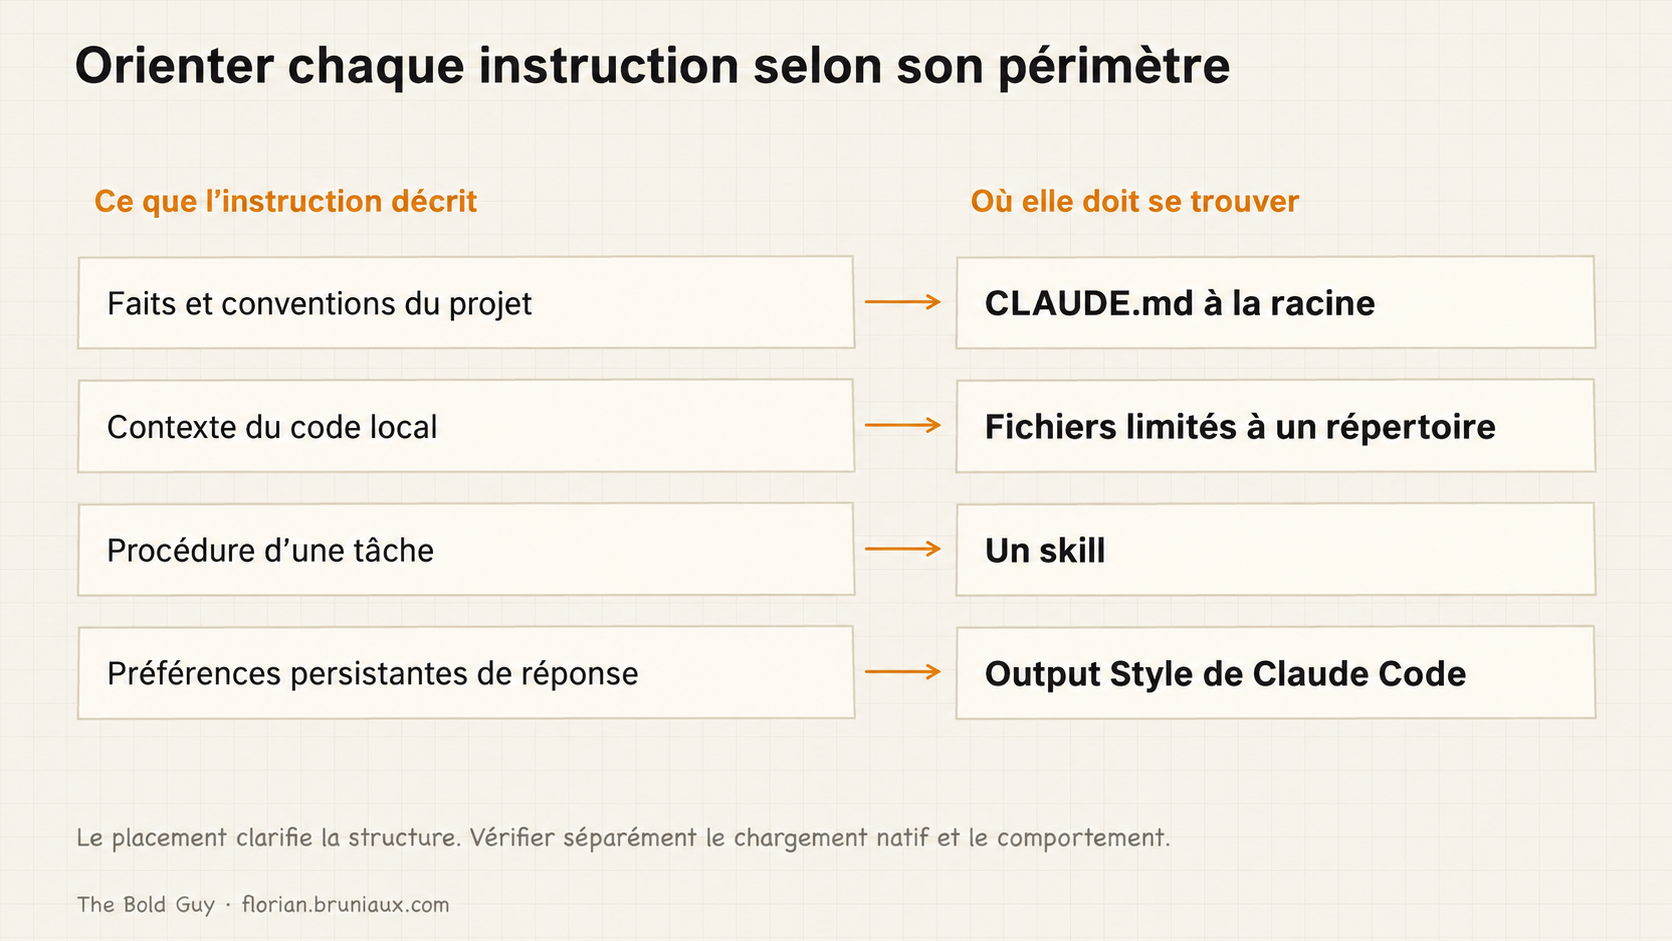
L’ensemble d’instructions devient plus facile à relire. Un fichier racine court et informatif est beaucoup plus facile à appliquer de façon constante qu’un document de 800 lignes où chaque paragraphe se dispute l’attention. Le guide de context engineering de ce site déroule cette restructuration niveau par niveau, avec des étapes concrètes de réorganisation et de vérification. L’architecture facilite aussi l’élagage : une règle sur le module payments/ vit dans payments/CLAUDE.md, pas enfouie à la ligne 340 de la racine. Elle est donc visible lorsque vous travaillez dans ce répertoire et peut être ignorée sinon.
Alléger un fichier Claude Code résout un problème de budget de contexte, pas de distribution entre hôtes. Je distingue ces sujets dans Une configuration d’agents portable est un système de release, pas un dossier partagé, qui cartographie source canonique, projections Claude Code et Codex, installation et preuve d’exécution.
Pourquoi élaguer est difficile
Chaque règle a été ajoutée parce qu’elle résolvait un vrai problème. C’est vrai. Mais les règles n’expirent pas automatiquement. Le problème qu’une règle devait prévenir peut ne plus exister : la bibliothèque a été mise à jour, le membre de l’équipe qui avait besoin du garde-fou est parti, le pattern visé a disparu dans un refactoring. La règle reste. Multipliez cela par 18 mois d’itération et vous obtenez un fichier de contraintes raisonnables localement, mais incohérentes ensemble.
Élaguer demande de savoir pourquoi chaque règle a été ajoutée, ce que la plupart des équipes ne suivent pas. Une pratique utile est un bref commentaire à la fin de chaque règle, indiquant le problème traité et sa date d’ajout. Restez bref, avec assez de détail pour évaluer si la condition initiale tient toujours. Une règle sans justification consignée est presque impossible à retirer sans risque, donc elle reste indéfiniment. C’est précisément le problème pour lequel j’ai créé ctxharness : il signale les règles de votre CLAUDE.md qui ont dérivé du code décrit, pour que l’élagage ne dépende plus de la mémoire.
À quoi ressemble un fichier bien maintenu
Mon objectif de travail est un CLAUDE.md racine de moins de 150 lignes contenant quatre choses : une description du projet en un paragraphe couvrant la stack et le cas d’usage principal, une courte liste de contraintes non négociables (règles de sécurité, cibles de déploiement, langue de sortie), un bloc de conventions sur le nommage et le format des commits, et des renvois explicites aux fichiers par répertoire pour le contexte spécialisé. Tout le reste appartient à un endroit plus proche du code concerné.
Évaluez une version plus courte face au fichier actuel sur des tâches représentatives, y compris des cas qui sollicitent la règle que vous comptez retirer. Gardez le modèle et les entrées de tâche fixes, conservez les échecs et examinez à la fois le respect des règles et la consommation de ressources. Moins de lignes prouve que le fichier est plus petit ; une amélioration nécessite des résultats observés.
L’état des lieux des harnais de Marmelab recommande aussi de retirer les composants obsolètes. Consignez l’incident d’origine, le responsable et la condition de révision de chaque règle pour que l’élagage reste raisonné. Un faible usage quotidien ne rend pas obsolète une contrainte de sécurité rare.
Pour décider d’un retrait, utilisez le protocole d’évaluation appariée du guide : comparez le fichier actuel, une version ciblée et une référence sans fichier sur des tâches réservées ayant le même état initial pertinent. Incluez les règles obligatoires rares. Un prompt plus court ou une moyenne inchangée ne suffit pas à établir qu’une règle est inutile.
YSNK
(Ce que vous devriez maintenant savoir)
- Le postmortem de Gallet et Dahan nomme deux causes qui se renforcent, pas une seule : déléguer une user story entière à un agent sans garde-fou et un CLAUDE.md trop gonflé pour être relu. Le gonflement n’a pas fait chuter la vélocité seul, il a retiré le garde-fou qui aurait détecté le premier problème
- Un modèle peut ignorer le contexte fourni ; les instructions d’ancrage et une vérification séparée des sorties sont des interventions à tester, pas des remèdes garantis
- Une règle ajoutée en janvier pour bloquer un pattern peut discrètement contredire une règle ajoutée en avril pour résoudre un autre problème. Aucune n’est fausse seule ; ensemble, elles rendent le comportement sur les tâches ambiguës plus difficile à prévoir
- Sans raison consignée, une règle est presque impossible à retirer sans risque, donc elle reste indéfiniment. Un commentaire d’une ligne, avec le problème traité et la date, rend l’élagage possible ensuite
- Mon modèle de fichier racine garde la description du projet, les contraintes non négociables, un bloc de conventions et des renvois vers les règles locales. Testez le placement et l’utilité de chaque instruction sur les tâches qu’elle régit
Footnotes
-
Français original : « la guerre du token quand on utilise Claude Code, c’est une guerre du quotidien ». Source : Bonjour Claude, dessine-moi un projet (Dev With AI, avril 2026). ↩
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source