TDD avec Claude Code
Séparer création des tests et implémentation, vérifier l'échec attendu et donner aux nouvelles tentatives TDD automatiques une sortie explicite.
Aller au résumé ↓ Florian Bruniaux
Ce que vous en retirez
- ✓ Prompts RED/GREEN/REFACTOR à copier-coller pour pytest (Django) et Vitest (React)
- ✓ Un hook PostToolUse qui exécute le fichier de test correspondant après une modification
Prérequis
- → Claude Code installé et configuré (au minimum le niveau 1 du guide de configuration)
TL;DR
Je recommande de demander le test en échec et l’implémentation dans deux requêtes distinctes, et de lire la raison de l’échec avant d’accepter le résultat vert. Gardez les tests hors de portée du modèle une fois qu’ils existent, avec un hook quand l’habitude ne suffit pas, et donnez à toute boucle de nouvelles tentatives automatiques une sortie explicite, parce que la mienne a tourné des mois sans cela. Je m’attends à ce que le cycle passe de la discipline des prompts à des hooks qui l’imposent, car une habitude ne suffit pas à faire respecter cette limite. Ce guide ne repose sur aucun échantillon mesuré, seulement sur l’usage répété de ma propre installation.
Dans mon usage, une demande ambiguë d’écrire un test produisait souvent un test passant accompagné de l’implémentation. Cela ressemble à du TDD sans démontrer que le test détecte le comportement manquant. Séparez les phases et inspectez l’échec avant de vous fier au résultat vert.
Le problème structurel
Les demandes « write a test for X » et « write a FAILING test for X; do not implement yet » expriment des frontières de tâches différentes. Traduction : « écrire un test pour X » et « écrire un test EN ÉCHEC pour X ; ne pas encore implémenter ». La seconde demande le contrat d’abord. Elle exige quand même de vérifier la sortie.
La phase RED doit échouer pour la raison attendue. Une interface manquante peut justifier une ImportError pour une nouvelle fonctionnalité ; une dépendance manquante sans rapport ne peut pas établir une régression. Si le test passe déjà, cherchez ce qu’il exerce réellement avant de passer à GREEN.
Un test en échec n’agit comme spécification que s’il échoue pour la raison attendue. Un test passant vérifie une implémentation par rapport à cette spécification. Séparer ces rôles compte parce que du code généré en moins d’une minute peut donner l’impression qu’une interface est fixée avant que quiconque ait défini ses entrées, sorties, erreurs et comportements aux limites.
Écrire le test d’abord oblige à expliciter cette décision d’interface. Si le comportement attendu ne peut pas être exprimé sous forme d’assertion, la demande d’implémentation n’est pas prête. C’est la pression de conception utile du TDD ; une couverture produite après l’implémentation ne donne pas le même signal.
Le même schéma apparaît partout où l’on confie un travail réel à un LLM : un modèle ne se contraindra pas lui-même. La contrainte doit être construite. La page workflow TDD du guide couvre la même discipline comme workflow général de Claude Code, avec des étapes RED/GREEN/REFACTOR intégrées au projet dès le départ plutôt qu’appliquées prompt après prompt.
Deux mots pour définir la frontière des phases
Le premier mot est FAILING, en majuscules. En pratique, l’écrire en majuscules a réduit les cas où Claude glissait une implémentation pendant RED, même s’il s’agit d’une observation d’usage répété, pas d’un résultat mesuré sur un grand échantillon. « Write a failing test » (traduction : « écrire un test en échec ») est assez ambigu pour que Claude produise encore un test qui échoue techniquement, mais seulement à cause d’une assertion artificielle. FAILING mis en relief tout seul lève cette ambiguïté.
Le second est Stop. à la fin du prompt, ou l’équivalent Do NOT implement yet. Sans lui, « write a test for the subscription endpoint » est syntaxiquement la première moitié de « write a test for the subscription endpoint, then implement it ». Traduction : « écrire un test pour l’endpoint d’abonnement » et « écrire un test pour l’endpoint d’abonnement, puis l’implémenter ». L’entraînement de Claude optimise l’accomplissement des tâches. Dans mon usage, il continue souvent au-delà de la phase voulue. Stop. est la frontière explicite.
Utilisez les deux mots dans la même demande :
Write a FAILING test for [feature]. Do NOT implement yet. Stop.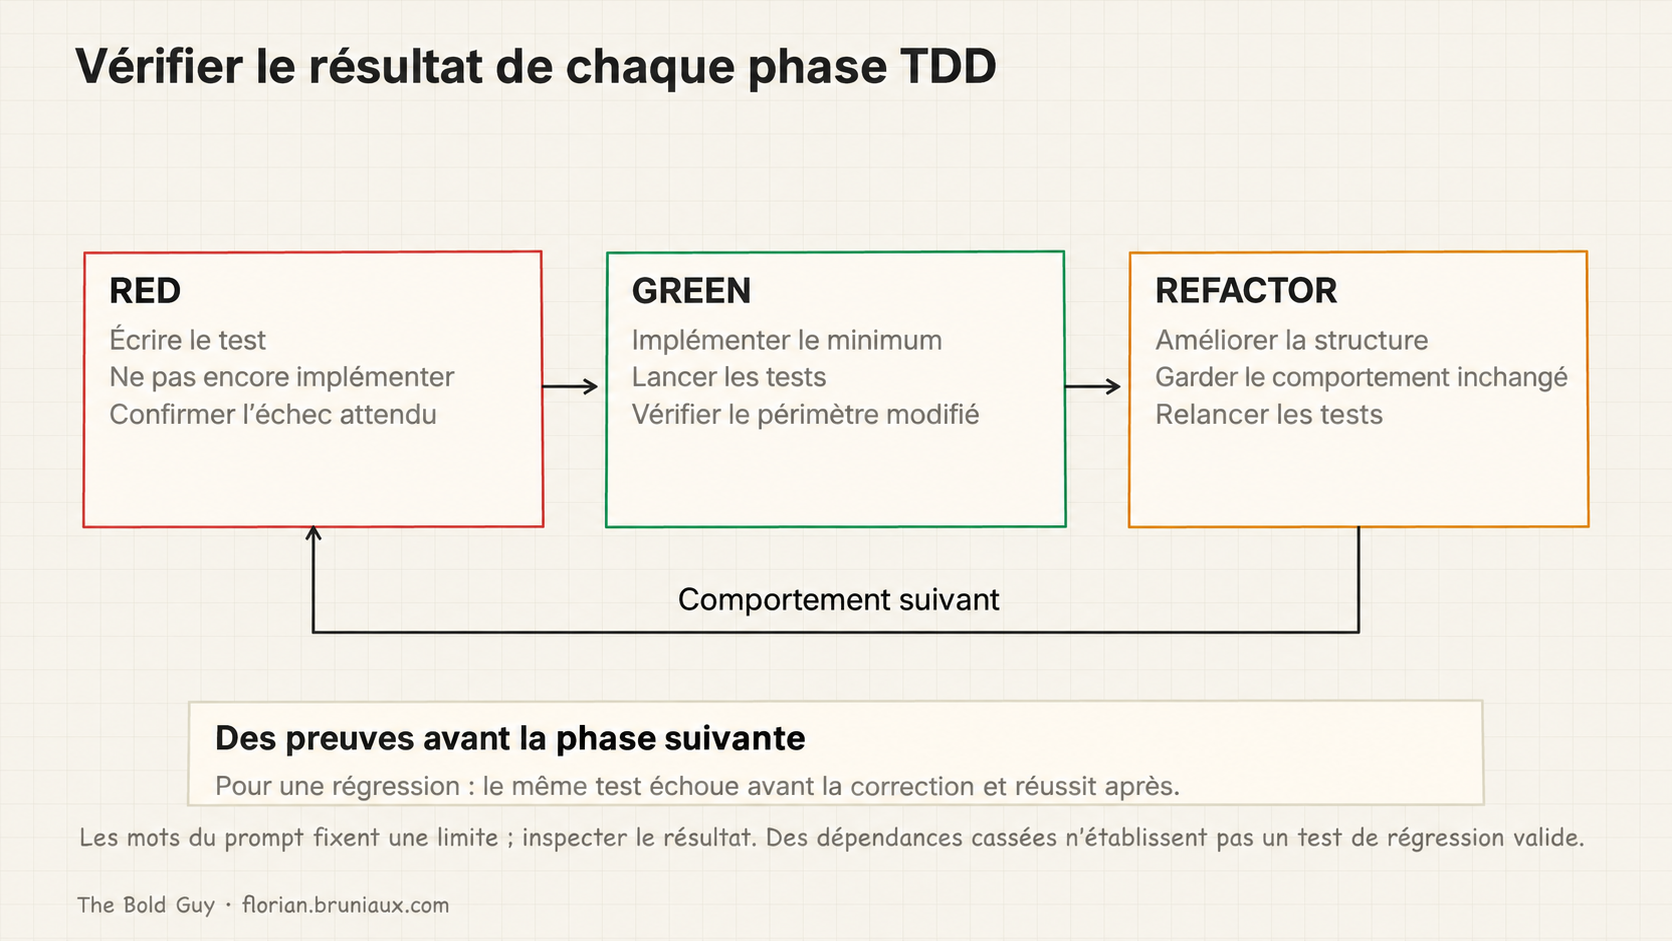
Trois prompts par phase
Copiez-les tels quels. Adaptez la description de fonctionnalité et les chemins de fichiers, laissez le reste intact.
Phase RED
Write a FAILING test for [feature description].
File: [test file path]
Do NOT implement the feature. Do NOT create any implementation files. Stop.

Run the test and confirm that it fails because the requested behavior or interface is missing.
Do not accept a broken dependency, fixture, or test setup as RED evidence.
Report the actual failure reason; the exception class alone is not sufficient.
Pour la variante Django/pytest (tests/api/test_subscriptions.py, APITestCase de DRF) :
Write a FAILING test for POST /api/v1/subscriptions/ creating a new subscription.
File: tests/api/test_subscriptions.py
Use APITestCase. Assert response.status_code == 201 and response.data["id"] is not None.
Do NOT create views.py or urls.py. Do NOT implement anything.
Run the test and identify the expected failure from the missing endpoint or behavior.
Exclude unrelated dependency, fixture, and test-setup failures. Stop.
Pour la variante React/Vitest :
Write a FAILING test for SubscriptionCard displaying the plan name and price.
File: src/components/SubscriptionCard.test.tsx
Use @testing-library/react. Assert the plan name and formatted price are in the document.
Do NOT create SubscriptionCard.tsx.
Run the test and identify the expected failure from the missing component or behavior.
Exclude unrelated dependency and test-setup failures. Stop.
Phase GREEN
The test at [test file path] is failing with [paste the actual error output].
Write the minimum implementation to make it pass. Nothing else.
File: [implementation file path]
« Minimum » porte une exigence ici. Sans ce mot, dans mon usage, Claude implémente souvent la fonctionnalité, traite les cas limites, ajoute la gestion d’erreurs et renvoie une couche de service complète. Tout cela relève de cycles ultérieurs.
Phase REFACTOR
The tests at [test file path] are passing.
Refactor [implementation file path] for readability and structure.
Do not change behavior. Run the tests to confirm they still pass after each change.
Vérifier que le cycle fonctionne
Chaque phase a une signature de réussite précise. Si vous voyez autre chose, le cycle est rompu.
GREEN : tous les tests passent et Claude a créé exactement les fichiers demandés, rien de plus. Si Claude a ajouté un serializer non demandé, il a extrapolé. Ce travail relève du cycle suivant, avec son propre test écrit d’abord.
REFACTOR : tous les tests passent toujours après le refactoring. Si un test casse, le refactoring a changé le comportement. Annulez les changements et recommencez la phase avec un prompt plus contraint.
Live AIDD : la procédure peut cesser de produire des tests
À 1:03:00 dans le live AIDD du 16 octobre 2026, je raconte avoir cassé mon skill TDD en le modifiant. Ni moi ni les personnes qui s’y fiaient ne l’avons remarqué immédiatement, et le développement a continué sans tests. L’anecdote rapporte un échec de la procédure de développement, sans en mesurer la fréquence ni montrer qu’un hook précis l’aurait évité.
Je conserverais une petite tâche de régression pour la procédure elle-même : vérifier qu’elle produit un test, l’exécute jusqu’à un RED attendu avant l’implémentation et signale un test sauté comme preuve manquante. Ce contrôle proposé est distinct de la suite applicative qui passe et n’a pas été démontré dans le live. L’article sur les contrôles récurrents situe l’incident dans la boucle de maintenance plus large. Le live est distinct de la conférence Dev With AI du 12 octobre ; sa source a des sous-titres automatiques et un début incomplet.
Le hook d’exécution automatique PostToolUse
Après un Edit ou Write correspondant sur un fichier de test, ce hook lance pytest ou Vitest sur ce fichier et renvoie la sortie capturée. Il n’exécute pas la suite complète et ne couvre pas chaque modification de fichier source.
Créez .claude/hooks/run-tests.sh :
#!/bin/bash
INPUT=$(cat)
TOOL=$(echo "$INPUT" | jq -r '.tool_name')
if [[ "$TOOL" != "Edit" && "$TOOL" != "Write" ]]; then exit 0; fi

FILE=$(echo "$INPUT" | jq -r '.tool_input.file_path // ""')
if [[ -z "$FILE" ]]; then exit 0; fi

# Only fire on test files
if ! echo "$FILE" | grep -qE "(test_|\.test\.|\.spec\.)"; then exit 0; fi

ROOT=$(git rev-parse --show-toplevel 2>/dev/null || pwd)
cd "$ROOT"

if echo "$FILE" | grep -qE "\.py$"; then
  OUTPUT=$(pytest "$FILE" -x -q 2>&1 | tail -20)
elif echo "$FILE" | grep -qE "\.(ts|tsx|js|jsx)$"; then
  OUTPUT=$(npx vitest run "$FILE" --reporter=verbose 2>&1 | tail -20)
else
  exit 0
fi

# A PostToolUse hook that just prints and exits 0 sends its output to the debug
# log, not to the model. additionalContext is what reaches Claude.
jq -n --arg ctx "$OUTPUT" \
  '{hookSpecificOutput: {hookEventName: "PostToolUse", additionalContext: $ctx}}'
exit 0
Enregistrez-le dans .claude/settings.json :
{
  "hooks": {
    "PostToolUse": [
      {
        "matcher": "Edit|Write",
        "hooks": [
          {
            "type": "command",
            "command": "$CLAUDE_PROJECT_DIR/.claude/hooks/run-tests.sh",
            "timeout": 30
          }
        ]
      }
    ]
  }
}
chmod +x .claude/hooks/run-tests.shLa ligne jq à la fin fait parvenir le résultat à Claude. Un hook PostToolUse qui écrit sur stdout et termine avec 0 envoie sa sortie dans le journal de débogage, où le modèle ne la lit jamais. Ces formes courantes de sortie ont des effets différents :
| Sortie du hook | Ce que reçoit Claude |
|---|---|
exit 0 + stdout brut | rien (journal de débogage seulement) |
exit 0 + JSON additionalContext | le texte, injecté comme contexte |
exit 2 + stderr | un retour ; l’outil a déjà été exécuté |
Ce hook utilise additionalContext pour fournir la sortie des tests après les modifications correspondantes des fichiers de test. Il termine avec 0 et ne bloque pas ; d’autres hooks configurés peuvent avoir leurs propres décisions. PostToolUse ne peut ni annuler ni empêcher cette modification, y compris avec un code de sortie 2. Utilisez une décision PreToolUse pour refuser une action ultérieure ou une politique Stop testée pour contrôler les nouvelles tentatives. Voir le comportement officiel propre à chaque événement.
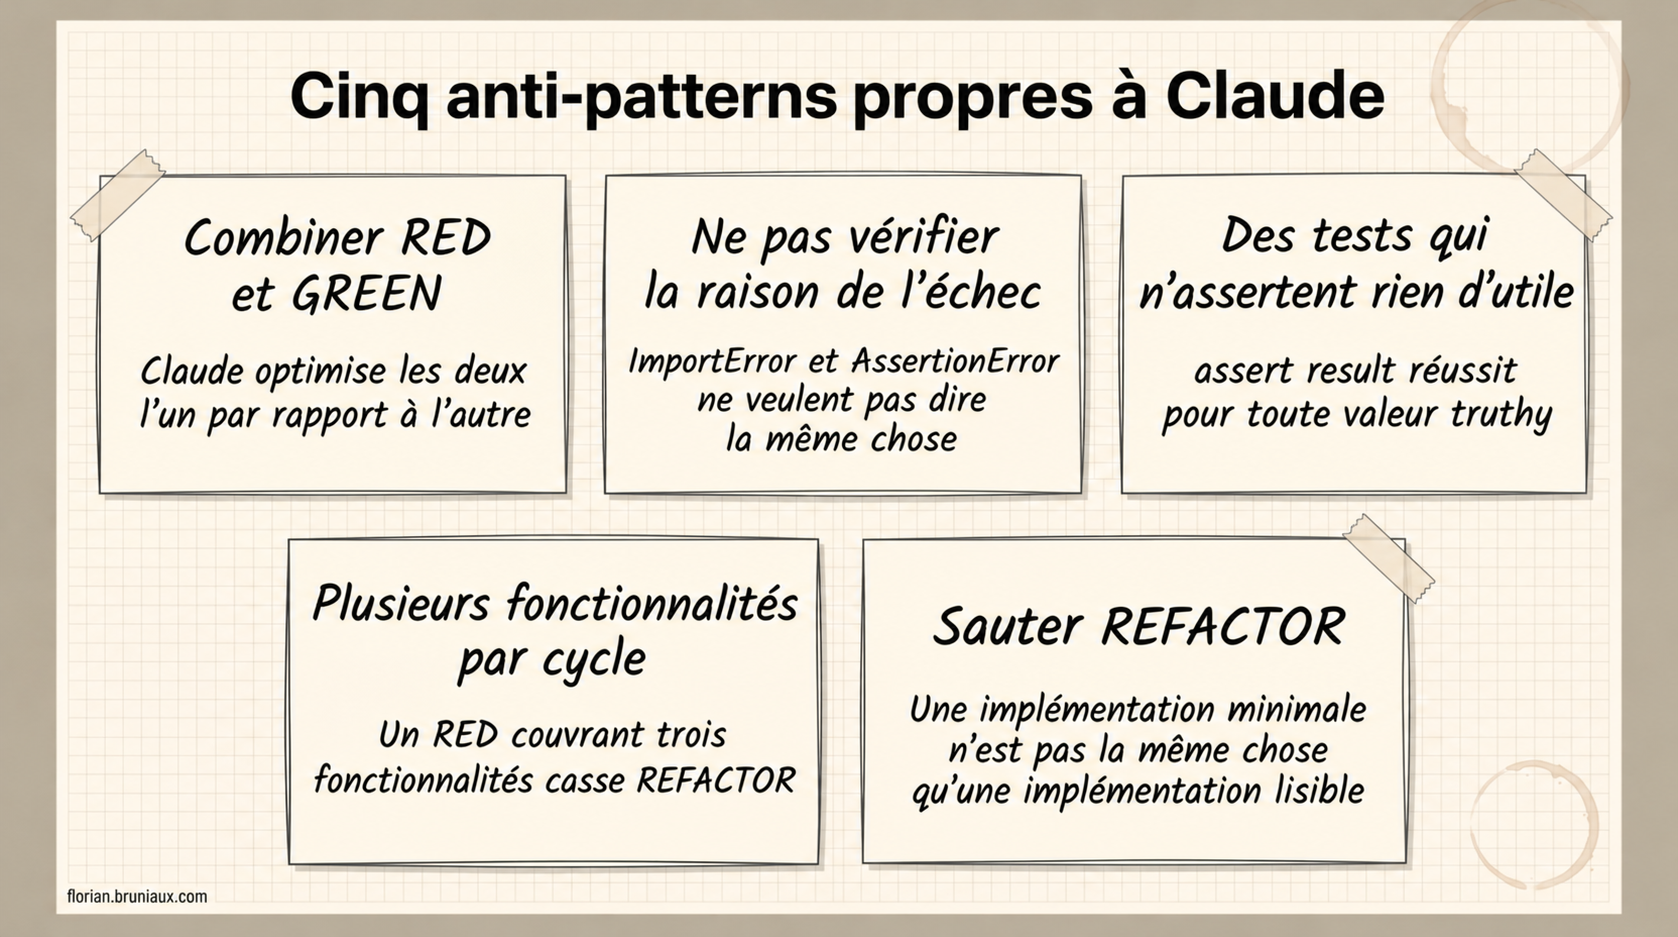
Cinq anti-patterns propres à Claude
Combiner RED et GREEN dans un prompt. « Write a failing test and then implement it » (traduction : « écrire un test en échec puis l’implémenter ») demande une séquence dans une seule unité. Dans mon usage, Claude écrit souvent les deux et les optimise l’un par rapport à l’autre. Le test sera exactement aussi difficile à faire échouer que l’implémentation sera facile à écrire.
Ne pas vérifier la raison de l’échec. Une ImportError peut être attendue pour une nouvelle interface ou indiquer une dépendance cassée. Une AssertionError rapporte un écart ; une valeur proche du résultat attendu n’établit pas qu’une implémentation a été ajoutée pendant RED. Inspectez le diff et la trace d’erreur pour confirmer que le test échoue pour la raison visée.
Des tests qui n’affirment rien d’utile. assert result passe tant que result est évalué comme vrai. assert result.status_code == 201 détecte les régressions. Claude choisit le premier par défaut quand le prompt RED est vague. Précisez explicitement la forme de l’assertion dans le prompt.
Plusieurs fonctionnalités par cycle. « Write tests for user registration, login, and password reset » (traduction : « écrire des tests pour l’inscription, la connexion et la réinitialisation du mot de passe ») mène à un RED couvrant trois fonctionnalités, un GREEN implémentant les trois d’un coup et un REFACTOR touchant trop de choses pour raisonner sereinement. Gardez une fonctionnalité par cycle pour éviter le temps de débogage qui suit.
Sauter REFACTOR. Claude écrit des implémentations minimales qui passent les tests, et minimal ne signifie pas lisible. L’étape REFACTOR transforme « technically correct » en « maintainable » (traduction : « techniquement correct » en « maintenable »). La sauter signifie commencer le cycle suivant avec du code déjà difficile à modifier.
Les cinq se ramènent à une règle, formulée par Quentin Adam dans l’épisode 341 d’IFTTD et confirmée indépendamment à Devoxx Belgium 2025 (Chris Simon, TDD & DDD From the Ground Up) : verrouiller les tests avant de toucher à l’implémentation et ne jamais laisser le LLM modifier un test pour le faire passer. La formulation d’Adam est celle qui reste.
Dites au modèle que les tests doivent passer et il se comporte comme Ultron décidant que le problème de la planète est l’humanité : il supprime vos tests et annonce du vert. Un test affaibli pour obtenir du vert ne protège rien. Quand une habitude ne suffit pas à faire respecter cette limite, un hook peut le faire.
La documentation de nizos/tdd-guard, vérifiée le 15 octobre 2026, dirige désormais les nouveaux projets vers Probity, son successeur pour Claude Code, Codex et GitHub Copilot CLI. TDD Guard reste maintenu pour ses utilisateurs existants. Sa configuration du modèle nomme encore claude-sonnet-4-6 comme valeur par défaut, un réglage du paquet plutôt que le modèle par défaut actuel d’Anthropic. Inspectez la release installée et le circuit de validation avant de la modifier.
La distinction reste utile : un refus PreToolUse est appliqué par l’hôte, tandis que la décision d’un LLM sur le respect du TDD par une modification peut être fausse. Je n’ai pas évalué Probity ici. Claude Code sous le capot explique la frontière des hooks.
Quand la boucle ne passe pas au vert
Une boucle TDD qui réessaie toute seule a besoin d’une limite, et la mienne a tourné sans cela pendant des mois. Le hook Stop qui relançait la suite renvoyait Claude dans le cycle à chaque rouge, avec un plafond de dix itérations, et à ce plafond il abandonnait en silence. Rien ne remontait. Les tokens étaient déjà dépensés.
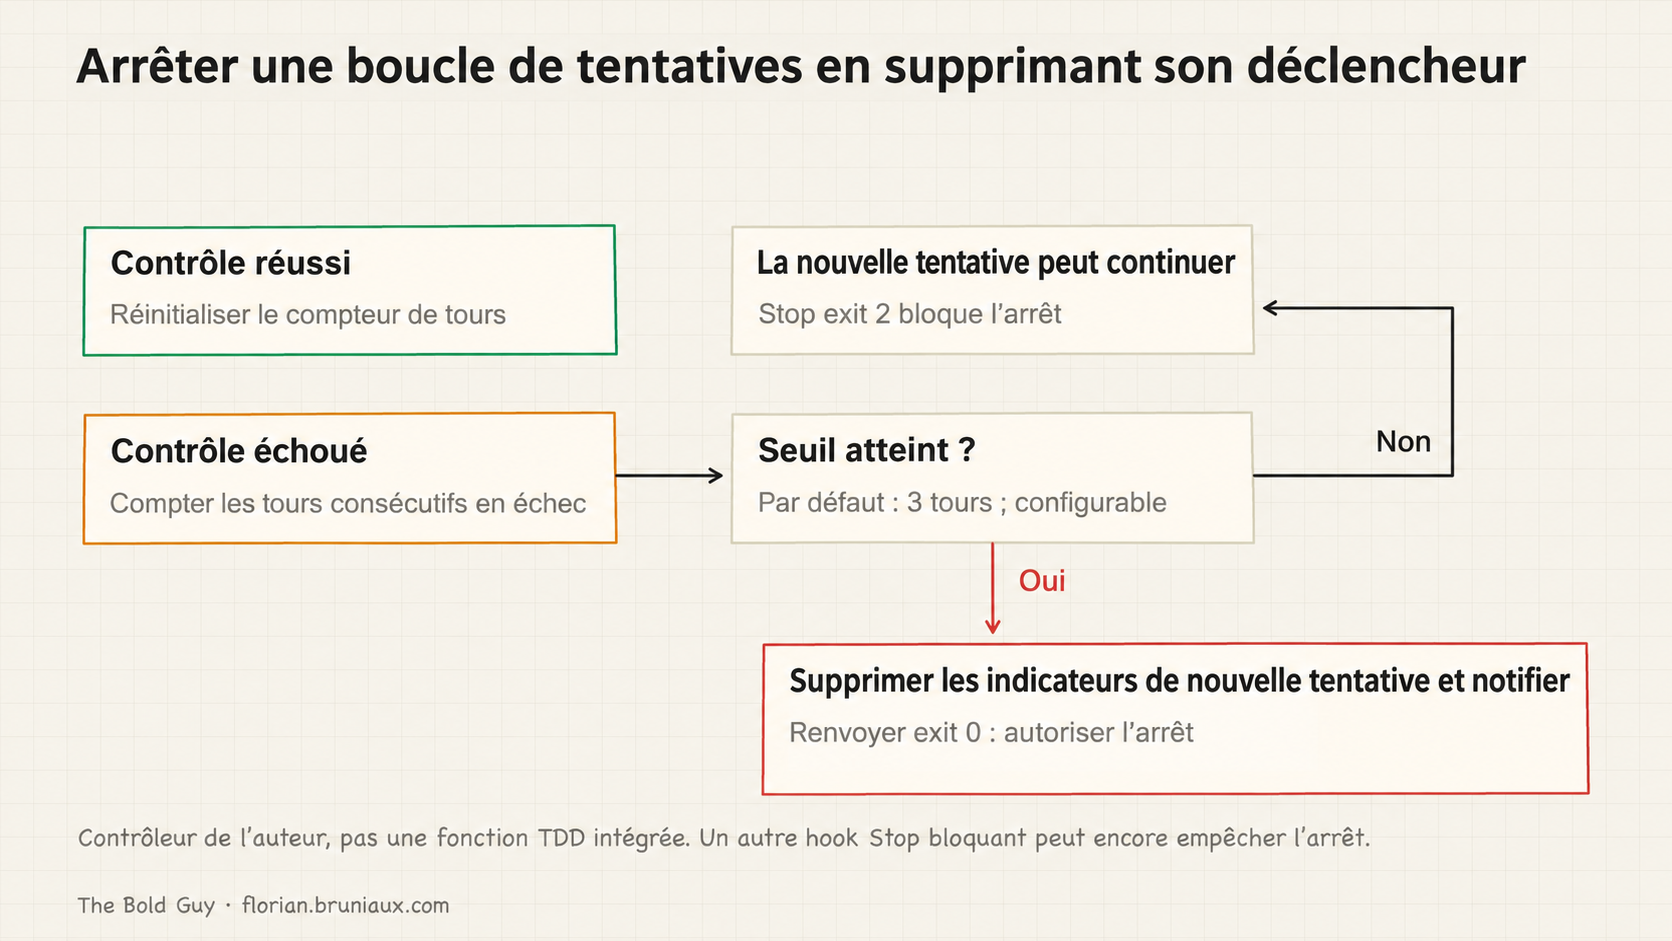
Dans mon installation, un second hook Stop fournit la condition de sortie. Pour cet événement, les codes de sortie ont les sens suivants :
| Code de sortie | Effet sur un hook Stop |
|---|---|
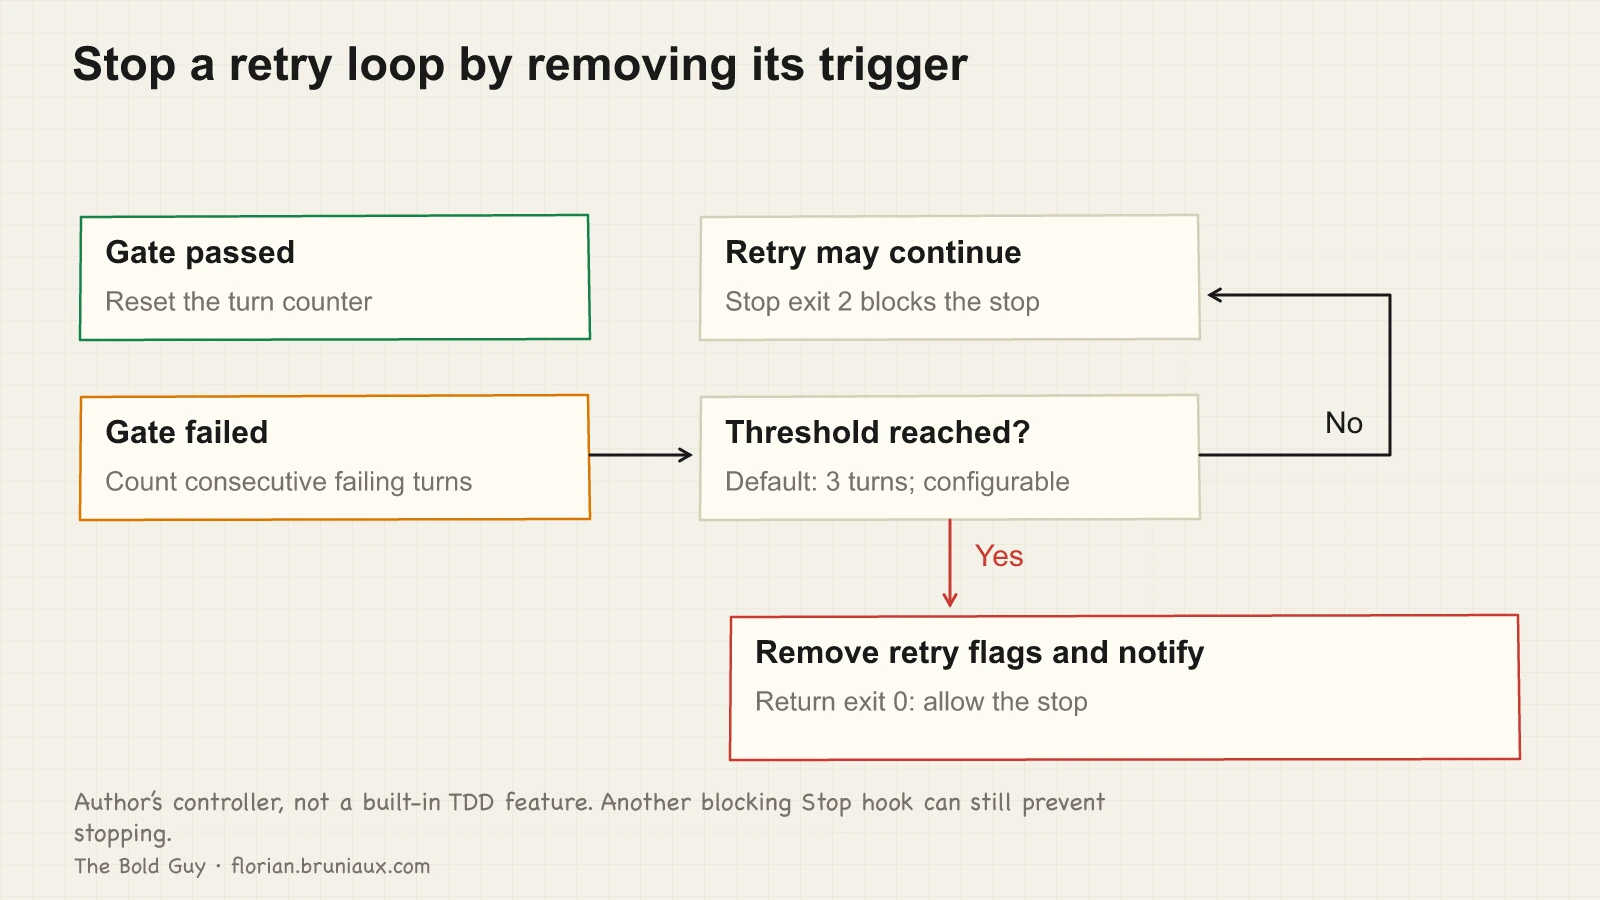
exit 0 | laisser Claude s’arrêter |
exit 2 | bloquer l’arrêt, Claude continue |
Un cordon andon, la corde qui arrête la chaîne d’assemblage, ne peut donc pas fonctionner en bloquant. Il doit terminer avec exit 0. Le mien arrête plutôt la chaîne en retirant le carburant : il supprime les fichiers indicateurs que le hook de boucle TDD lit avant de décider de terminer avec exit 2, m’envoie une notification et écrit la raison sur stderr. Dans ce contrôleur, trois tours consécutifs se terminant sur une commande de contrôle en échec (tsc, vitest, eslint) déclenchent la condition de sortie. C’est ma configuration, pas une garantie TDD intégrée ; un autre hook Stop bloquant peut encore empêcher l’arrêt.
Deux détails justifient leur place. Le seuil et le coupe-circuit sont des variables d’environnement (CLAUDE_ANDON_THRESHOLD, valeur par défaut 3, et CLAUDE_ANDON_SKIP=1), parce que la première chose voulue pendant le débogage du hook est un moyen de le désactiver. Et le compteur se réinitialise à chaque contrôle réussi, pour qu’un test instable ne vous fasse pas atteindre le seuil au fil de l’après-midi.
J’ai livré cela le 20 juillet 2026, huit jours après qu’un audit de mon propre pipeline a trouvé ce plafond de dix itérations se terminant en silence. Il fonctionnait ainsi depuis longtemps et je ne l’avais jamais remarqué, parce que rien n’était prévu pour me le signaler.
Garder les critères d’acceptation hors de la boucle de réparation
La discussion IFTTD avec Yacine Hmito traite la reproduction et la correction comme des artefacts distincts. Appliquez cette frontière lorsqu’un agent répare un test en échec : conservez le comportement attendu original et inspectez les changements de l’implémentation comme des tests.
Pour corriger une régression, vérifiez que le nouveau test échoue sur l’implémentation inchangée pour la raison comportementale attendue, puis passe avec la correction. Une dépendance manquante n’est pas une phase rouge valide. Si le besoin lui-même était faux, faites approuver la correction par son responsable et consignez pourquoi ; affaiblir silencieusement une assertion ne prouve rien sur le défaut original. Cela complète le modèle de tests protégés déjà décrit ici.
Tests de mutation
Une fois la suite passante, demandez à Claude de vérifier que les tests détectent réellement les régressions :
In [implementation file path], make one mutation: change a > to >=,
remove a condition, or flip a boolean. Run the tests. Report whether they
catch it. Then revert and try a different mutation.
Si les tests passent malgré une modification significative, ils ne couvrent pas ce que vous pensez. Claude peut exécuter plusieurs mutations à la suite et signaler celles qui passent, plus vite qu’une lecture ligne par ligne du fichier de test. Une suite qui survit au remplacement de > par >= sur une condition limite manquera la même régression en production.
Cela fonctionne parce que la réussite ou l’échec du test après une mutation constitue un signal binaire déterministe. L’exécution du test juge le résultat ; Claude exécute la boucle et lit ce résultat.
Le prompt manuel convient à une fonction à la fois. Pour une campagne plus large, le plugin de tests de mutation de Trail of Bits, vérifié le 15 octobre 2026, documente désormais un skill pour préparer une campagne, analyser les survivants et investiguer les bugs. Il configure mewt ou muton et distingue les mutations équivalentes des tests manquants. Une mutation survivante ne prouve pas à elle seule un bug : inspectez son sens et reproduisez tout défaut signalé. Les contrôles de fixtures du plugin sont distincts de la preuve qu’il améliore la suite de tests d’un vrai projet.
YSNK
(Vous devriez maintenant savoir)
- Pour PostToolUse, stdout brut avec exit 0 va généralement dans la sortie de débogage ;
additionalContextatteint Claude, tandis qu’exit 2 fournit un retour après l’exécution de l’outil. Cela n’empêche ni n’annule la modification - Le blocage de tdd-guard est déterministe, un hook PreToolUse qui refuse refuse réellement, mais la décision qui le déclenche vient d’un LLM jugeant la modification. Un contrôle strict autour d’un jugement souple, d’où ses faux positifs occasionnels
- Pour l’événement Stop,
exit 0laisse Claude s’arrêter,exit 2bloque l’arrêt et le fait continuer. Une boucle automatique qui exige un coupe-circuit ne peut pas sortir en bloquant, elle doit retirer le carburant (supprimer le fichier indicateur que lit la boucle) et terminer avec 0 - Un plafond de dix itérations qui abandonne silencieusement en cas d’échec est pire qu’une absence de plafond : les tokens sont déjà dépensés et rien ne remonte si rien n’est prévu pour le signaler
- Les tests de mutation détectent les suites qui ne testent pas ce qu’elles prétendent : remplacez un
>par>=sur une condition limite, relancez, et si les tests passent toujours, ils ne couvrent pas du tout cette limite
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source