La vélocité de l’IA va dans les deux sens
Tout le monde parle de livrer 10 fois plus vite avec l’IA. Personne ne parle d’accumuler de la dette 10 fois plus vite. 7 mois de données de production d’une véritable plateforme EdTech.
Aller au résumé ↓ Florian Bruniaux
TL;DR
Je pense que l’IA est un multiplicateur dans les deux sens : elle accélère les processus solides et amplifie les lacunes au même rythme, donc la dette grandit aussi vite que les fonctionnalités. Dans mon équipe, les garde-fous sont arrivés après le premier incident, et je n’ai pas trouvé de moyen de les faire arriver plus tôt. Ce que je retiens de sept mois de données, c’est de traiter les garde-fous comme une partie du travail sur la vélocité dès le départ, pas comme une réaction.
| Quoi | Détails |
|---|---|
| Contexte | 7 mois de construction d’une plateforme EdTech chez Méthode Aristote. En solo au début, une équipe de 5 en mars 2026. 1 100 commits, 49 releases. |
| Ce que tout le monde affirme | L’IA vous fait livrer plus vite. Vrai. |
| Ce que personne ne mentionne | L’IA vous fait aussi accumuler de la dette plus vite. Vrai aussi. |
| 3 accélérateurs négatifs | Séquelles de la migration SSE, vélocité des bugs égale à la vélocité des fonctionnalités, bascule de contexte amplifiée par des projets parallèles. |
| Garde-fous mis en place | Règle « Never merge without approval » (traduction : « Ne jamais merger sans approbation »), garde-fou Critical Thinking, protocole UVAL. |
| Le cadre | Bonne vélocité = fonctionnalités livrées avec compréhension. Mauvaise vélocité = fonctionnalités livrées avec coût caché. |
Le récit dominant autour du développement assisté par l’IA se concentre sur la productivité. On livre plus vite, on fait plus avec moins, et on passe de l’idée à la production en jours au lieu de semaines. Je l’ai vécu.
En septembre 2025, un développeur de l’équipe a poussé 171 commits. Août en comptait 57. Même personne, même codebase, et le seul changement était l’adoption de Claude Code en milieu d’août et le fait de passer ses soirées à ajuster la config au lieu de simplement suivre les suggestions par défaut.
Personne ne le disait à voix haute, mais tout avait accéléré, y compris le bon et le mauvais.
Le mythe dominant
La plupart des contenus sur la productivité avec l’IA traitent le gain comme additif : vélocité des fonctionnalités, qualité du code, itération plus rapide. Le modèle implicite suppose que l’IA rend le travail existant strictement meilleur.
Ce modèle est faux.
L’IA agit comme un multiplicateur. Elle augmente la production dans toutes les directions : les processus solides produisent plus de code solide plus vite, tandis que les lacunes s’accumulent en parallèle des fonctionnalités.
Ce n’est pas un argument contre le développement assisté par l’IA. C’est un argument pour y entrer les yeux ouverts.
Les 3 accélérateurs négatifs que j’ai observés en production
1. Séquelles de migration : -97% de trafic, +3 semaines de débogage
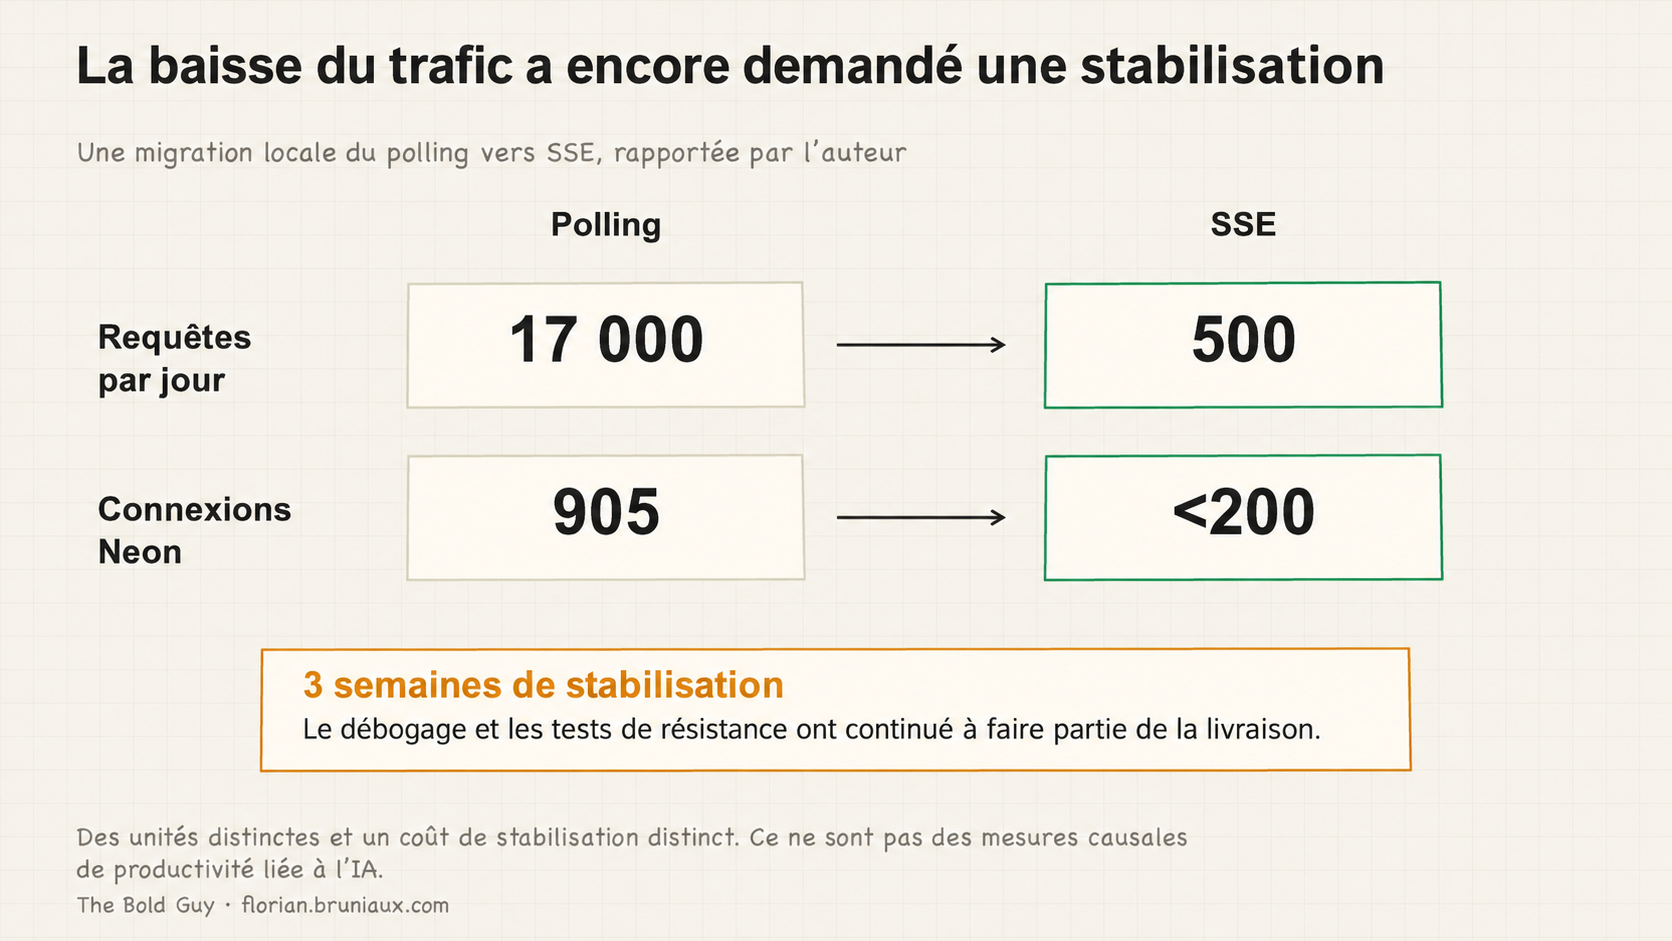
En février 2026, nous avons migré du polling vers les Server-Sent Events pour la fonctionnalité temps réel du plan de travail. Les chiffres paraissent propres rétrospectivement : 17 000 requêtes par jour sont tombées à 500 (-97%). Le pooling de connexions Neon est passé de 905 connexions actives à moins de 200.
Les métriques omettent les semaines entre la décision de migrer et l’obtention d’un SSE stable en production : le comportement de fermeture propre du SSE (auto-fermeture à 100 secondes, reconnexion à 100ms), le nettoyage des flux orphelins (nous avons nettoyé 20 000 flux orphelins en décembre rien que pour l’implémentation SSE du chat antérieure), et les patterns Redis Pub/Sub qui n’échouent pas silencieusement sous charge.
La fonctionnalité est sortie vite, mais les séquelles ont pris trois fois plus de temps à stabiliser. Le gain de vélocité était réel, et la facture de débogage qui l’accompagnait l’était aussi.
L’IA a rendu la migration plus rapide et a rendu plus facile le fait de sauter les parties qui étaient censées vous ralentir : réfléchir aux cas limites, tester le comportement de reconnexion, et comprendre ce qui se passe quand le client se déconnecte en plein flux.
2. Vélocité des bugs égale à la vélocité des fonctionnalités
Novembre 2025 a été le mois le plus intense : 289 commits, 9 releases. La codebase a grandi vite. Les fonctionnalités sont arrivées vite. Les bugs sont arrivés au même rythme.
Le code généré par l’IA est souvent correct pour le chemin principal et incorrect dans les cas limites. Il peut passer les tests tout en échouant pour les utilisateurs dans des circonstances spécifiques : un bouton qui n’apparaît pas au bon moment, un clic qui redirige vers la mauvaise URL, ou une vérification de permissions qui passe alors qu’elle ne devrait pas.
Ce sont les conséquences prévisibles d’une livraison rapide sans investissement proportionnel dans la couverture des cas limites. Avec l’IA, on peut livrer 5 fonctionnalités dans le temps qu’il fallait pour en livrer 1, dont 5 fonctionnalités partiellement testées.
3. Bascule de contexte amplifiée par les projets menés en parallèle
L’IA rend possible de mener 5 projets open source en parallèle tout en construisant un produit à temps plein. Le débit et la surcharge cognitive sont réels, mais cette dernière s’accumule différemment de celle liée à la gestion d’une équipe.
Chaque projet a son propre contexte : stack, conventions, issues ouvertes, et utilisateurs. L’IA vous aide à réintégrer ce contexte rapidement. Le choix de l’endroit où porter son attention reste le vôtre, tout comme le fait de remarquer quand trois projets ont divergé de leur périmètre d’origine ou quand des décisions d’architecture entrent en conflit entre projets.
La bascule de contexte amplifiée par l’IA est un type de problème différent de la bascule de contexte que l’on vit en gérant des personnes. Elle est plus rapide, entraîne moins de friction et il est donc plus facile d’en faire plus que ce qui est soutenable.
Les garde-fous que nous avons construits
La douleur, plutôt qu’un plan, a produit ces garde-fous.
« Never merge without user approval » (traduction : « Ne jamais merger sans approbation de l’utilisateur »), 11 décembre 2025
Une règle Claude Code ajoutée à CLAUDE.md après que l’IA a mergé un PR sans ma confirmation explicite. Une ligne. L’incident s’est produit en mode YOLO (approuver tout rapidement), où l’IA fait exactement ce que vous avez dit vouloir, y compris la chose que vous avez dite vouloir dans un moment de distraction. La règle ralentit une étape spécifique volontairement. L’instruction consigne la limite prévue. Pour la faire respecter, il faut configurer un contrôle sur l’action. Claude Code sous le capot explique les hooks spécifiques aux événements et les vérifications de permissions côté client.
Règle Critical Thinking
Le comportement par défaut de l’IA est d’accepter l’énoncé du problème et de le résoudre. Le garde-fou Critical Thinking force une étape avant l’acceptation : remettre en question l’hypothèse. Est-ce le bon problème à résoudre ? Y a-t-il une approche plus simple ? Quelles sont les conséquences de second ordre ?
Ajouté à la suite de livraisons répétées de solutions techniquement correctes au mauvais problème. L’implémentation était correcte. Le besoin n’avait pas été remis en question avant de l’implémenter.
Le protocole UVAL
Le protocole UVAL complet développe quatre étapes : Comprendre avant de demander, Vérifier en reformulant, Appliquer en modifiant plutôt qu’en copiant, Apprendre en capturant l’insight. Le protocole a été écrit spécifiquement pour contrer la tendance à livrer du code qu’on ne peut pas expliquer trois semaines plus tard.
Comment distinguer la bonne vélocité de la mauvaise
La question n’est pas « are you shipping fast? » (traduction : « est-ce que vous livrez vite ? »). C’est « are you shipping with understanding? » (traduction : « est-ce que vous livrez avec compréhension ? »).
La bonne vélocité, c’est des fonctionnalités qui arrivent avec des explications de leur structure, des cas limites pris en compte avant la livraison, une couverture de tests qui reflète leur comportement, et un code sur lequel le prochain développeur (ou vous, dans trois mois) peut raisonner sans reconstituer les décisions à partir de zéro.
La mauvaise vélocité laisse derrière elle de belles métriques et des questions sans réponse sur le raisonnement. Trois semaines plus tard, quelqu’un demande pourquoi le rafraîchissement du token est déclenché à chaque requête plutôt qu’à l’expiration, et vous ouvrez le fichier sans explication.
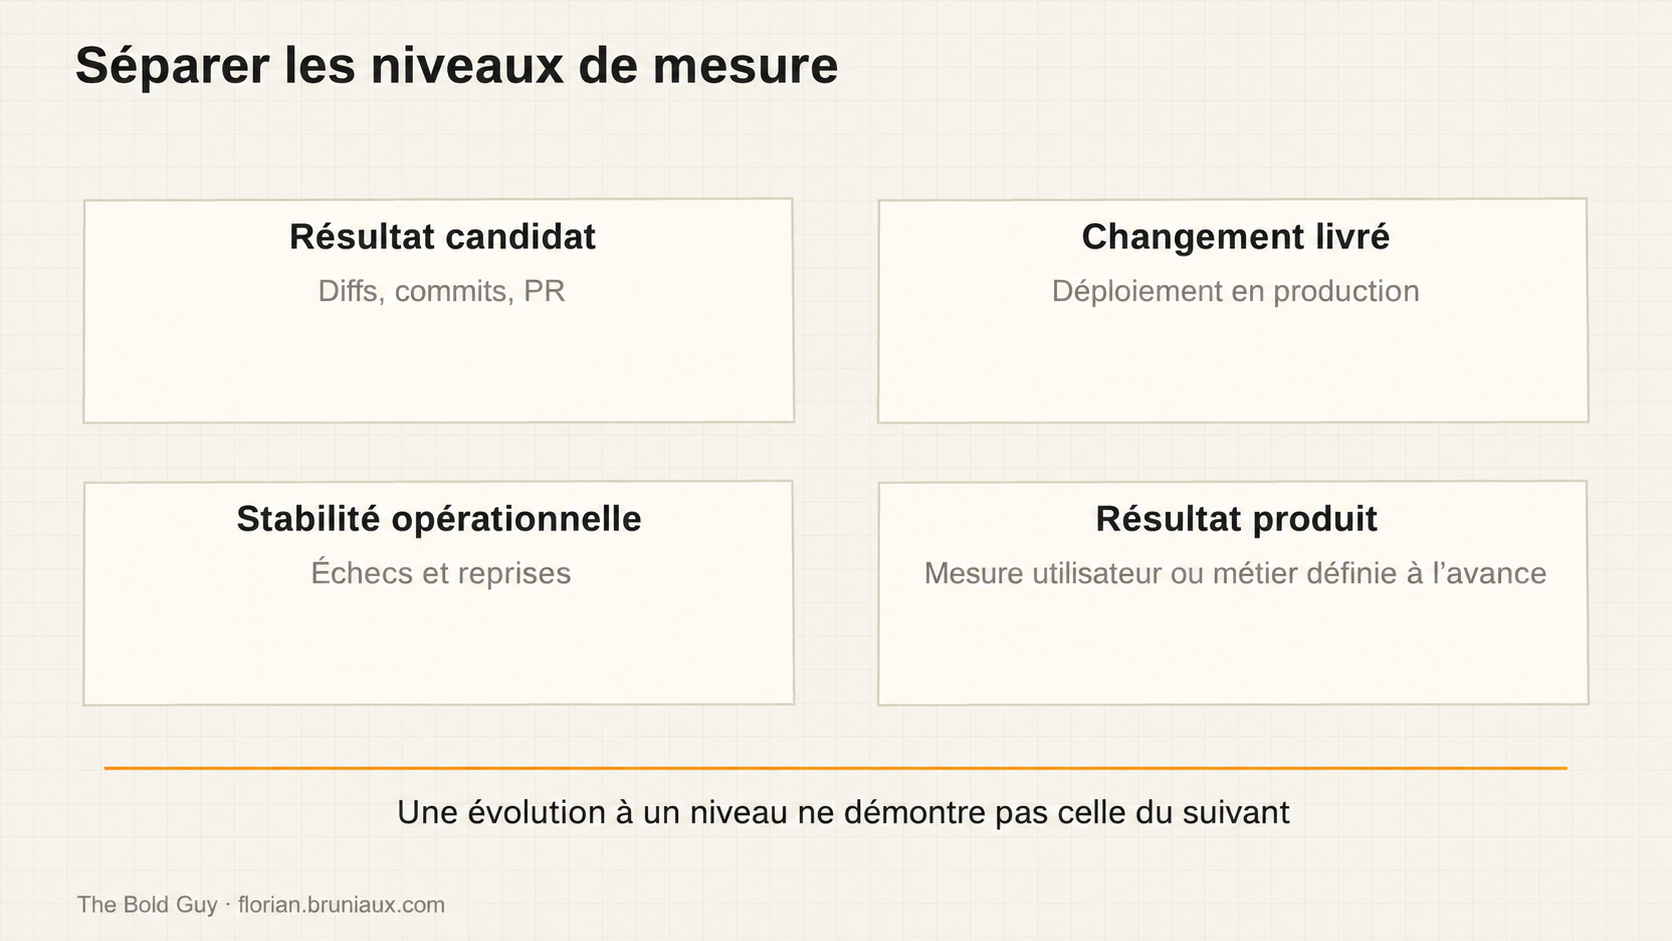
Les commits ne vous diront pas quel type de vélocité vous avez. Vous le découvrez en code review, quand quelqu’un demande pourquoi le code est structuré ainsi et que vous devez faire une pause avant de répondre, ou dans une session de débogage trois mois plus tard où personne ne peut reconstruire le raisonnement derrière un flux d’authentification qui fonctionnait bien jusqu’à ce que ça ne marche plus.
Le chiffre de vélocité seul ne peut pas distinguer une équipe qui apprend d’une équipe qui accumule une dette qu’elle remboursera dans six mois.
Sept mois de vélocité et de dette
Sur 7 mois :
- 1 100 commits, 49 releases : débit réel
- 20 → 150 étudiants actifs (×7,5) : croissance produit
- 283 tests ajoutés en janvier : rattrapage de couverture
- Duplication de code : 55% → 8% : remboursement de dette
- 70+ issues SonarCloud résolues : traitement de ce que la vitesse a laissé derrière
- SSE : -97% de trafic : le gain après les séquelles
Les gains et les coûts sont dans le même jeu de données. Un récit qui ne montre qu’un seul côté rate la dynamique réelle : le développement assisté par l’IA produit plus, plus vite, dans les deux directions.
D’après mon expérience, les garde-fous arrivent après le premier incident qui rend l’écart visible. Je n’ai pas trouvé de moyen de faire en sorte que ça arrive avant l’incident.
Ce que sept mois de données ont exigé
La vélocité de l’IA est réelle dans les deux directions, et les équipes l’apprennent généralement après avoir livré quelque chose qu’elles ne peuvent pas expliquer trois mois plus tard. La discipline utile, c’est de reconnaître si un commit fait avancer le produit ou fait avancer le compteur de dette. Les garde-fous coûtent du temps à concevoir, à appliquer et à maintenir, mais ils empêchent le multiplicateur de travailler contre vous. J’ai commencé avec une règle et je l’ai appliquée de façon constante.
Les garde-fous mentionnés ici, y compris le protocole UVAL, sont documentés dans le Claude Code Ultimate Guide. Si vous avez construit des vérifications de vélocité similaires dans votre propre workflow, j’aimerais en entendre parler.
YSNK
(Vous devriez maintenant savoir)
- L’IA multiplie votre processus : les pratiques solides livrent plus vite, et les lacunes s’accumulent au même rythme que les fonctionnalités
- La facture de débogage d’une migration rapide arrive après la migration. Prévoyez les séquelles en plus de la date de livraison
- La vélocité des bugs suit la vélocité des fonctionnalités par défaut, sauf si vous ajoutez une couverture de tests proportionnelle à mesure que vous augmentez la production
- « Never merge without user approval » (traduction : « Ne jamais merger sans approbation de l’utilisateur ») existe parce que le mode YOLO fait exactement ce que vous avez demandé, y compris la chose que vous avez dite dans un moment de distraction
- Une pause avant de pouvoir expliquer pourquoi le code est structuré ainsi signale une mauvaise vélocité plus clairement que le journal des commits
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source