Claude Code sous le capot
Les concepts que j’aurais aimé connaître avant la première semaine : boucle agentique, portée des instructions, gestion du contexte, invocation des skills, hooks et contrôles de permission du client.
Aller au résumé ↓ Florian Bruniaux
TL;DR
Je pense qu’il faut comprendre comment fonctionne Claude Code (la boucle, le modèle de mémoire, la sémantique d’exécution) avant de régler sa configuration, parce que j’ai passé des semaines à régler des fichiers que je ne comprenais pas. Et je considère la maintenance de cette configuration comme un vrai travail d’ingénierie, pas comme un coût à réduire : sur mon installation, elle représentait 30 à 50 % des commits pendant les périodes de maintenance active. Cela change la répartition du temps et la personne qui en est responsable dans une équipe.
| Sujet | Détails |
|---|---|
| La boucle agentique | Rassembler le contexte, agir avec les outils, inspecter les résultats, puis continuer. |
| La portée des instructions | Les instructions utilisateur, de projet et limitées à certains chemins ajoutent du contexte. La mémoire automatique est un mécanisme distinct. |
| Le budget de contexte | Fichiers, messages et sorties d’outils partagent le contexte disponible du modèle. Inspecter son utilisation et conserver les décisions avant de le vider. |
| L’invocation des skills | Le modèle peut sélectionner un skill, ou on peut l’invoquer explicitement. Son déclenchement ne prouve pas que le résultat est correct. |
| Les contrôles à l’exécution | Les permissions et les hooks propres à chaque événement peuvent limiter les appels d’outils. Il faut vérifier leur portée et leur comportement en cas d’échec. |
Contrats techniques vérifiés une première fois le 12 septembre 2026 ; limites de délégation et conservation des données revérifiées le 15 octobre. Les anecdotes historiques ci-dessous conservent leur périmètre d’origine.
Quand j’ai commencé avec Claude Code, j’ai passé des semaines à modifier des fichiers de configuration que je ne comprenais pas. Ce n’était pas par négligence. Je lisais attentivement la documentation, reprenais les configurations de développeurs que je respectais, et passais mes soirées à régler des choses qui n’en avaient pas encore besoin. Je m’appuyais sur un vocabulaire dont je devinais le sens, et l’écart entre ce que je pensais que Claude Code faisait et ce qu’il faisait réellement me coûtait plus de temps que je ne m’en rendais compte.
À un moment, je me suis arrêté pour décortiquer la documentation. Je me suis concentré sur l’architecture : la boucle agentique, le catalogue d’outils, le modèle de mémoire et la sémantique d’exécution. Deux jours de lecture qui auraient dû être mon premier jour. Après ça, la configuration a commencé à prendre du sens.
C’est l’article que j’aurais aimé trouver avant ces deux jours. Si vous découvrez Claude Code, Par où commencer est une meilleure porte d’entrée : il donne les repères, la progression recommandée et les raisons de cet ordre. Celui-ci va plus loin, en supposant que vous avez déjà dépassé la question du vocabulaire.
La boucle est plus simple qu’elle en a l’air
Claude Code fonctionne en boucle. Vous soumettez un prompt, Claude raisonne dessus, appelle des outils si nécessaire, lit les résultats et répond. Puis la boucle recommence.
Les outils permettent à Claude d’inspecter des fichiers, de chercher, de modifier et de lancer des commandes. Leurs noms et leur disponibilité dépendent de la version du client et de la configuration. Le modèle utile, c’est la boucle elle-même. La vue d’ensemble de l’architecture d’Anthropic décrit les outils et le contexte qui la rendent possible.
Cela change le rôle de CLAUDE.md : des instructions persistantes qui prennent place aux côtés de la tâche en cours et des fichiers que Claude lit. Une nouvelle fenêtre de contexte ne prouve pas qu’aucune connaissance ne persiste. Claude Code dispose aussi d’une mémoire automatique et peut reprendre des sessions enregistrées ; inspectez les sources actives plutôt que de supposer un rappel parfait ou une remise à zéro complète.
Les instructions écrites ont plusieurs portées
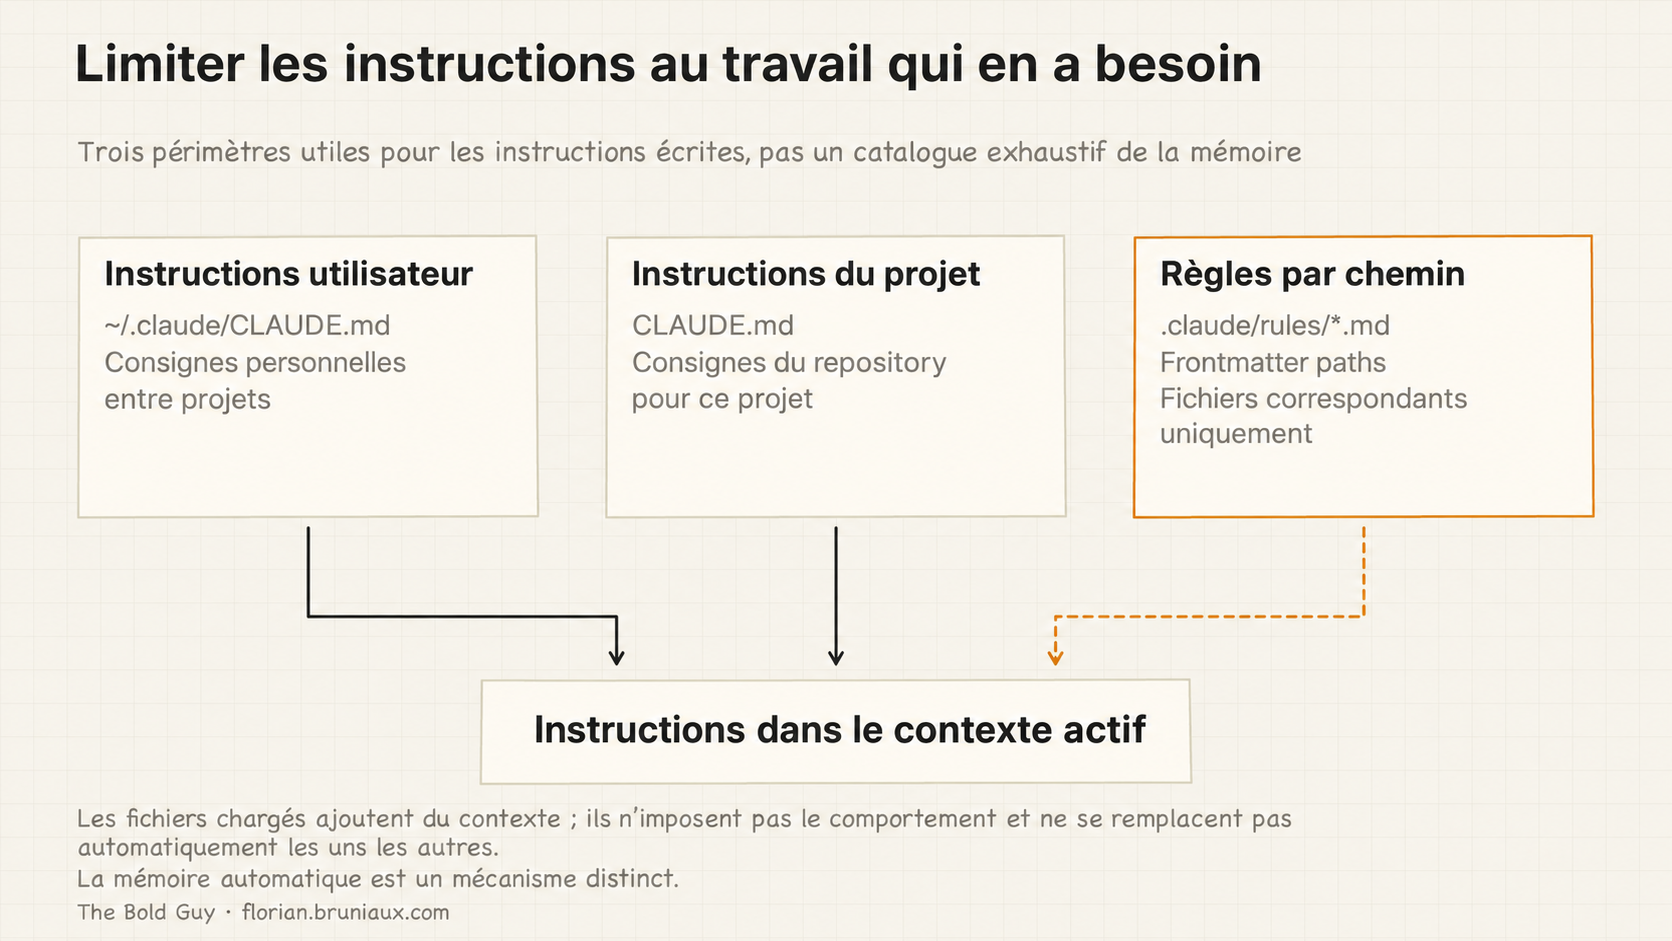
Trois portées sont utiles pour organiser les instructions écrites : les consignes utilisateur dans ~/.claude/CLAUDE.md, celles du projet dans CLAUDE.md, et les règles conditionnelles sous .claude/rules/ avec un frontmatter paths. L’inventaire n’est pas complet : il existe aussi des politiques administrées, des fichiers locaux et une mémoire automatique.
Dans mon installation, le fichier utilisateur porte les préférences de communication et les conventions de workflow. Le fichier du projet décrit la stack, l’architecture et les commandes. Les règles qui ne concernent que le travail sur l’API doivent se limiter aux chemins correspondants plutôt que d’être chargées pour chaque tâche.
Les fichiers chargés sont concaténés dans le contexte. Un fichier plus spécifique ne remplace pas mécaniquement toutes les instructions contradictoires. La référence sur la mémoire documente ces portées et leurs conditions de chargement. Testez le comportement séparément.
Depuis la version 2.1.277, Claude Code peut aussi charger directement le fichier AGENTS.md du dépôt. Par défaut, il s’en sert en l’absence de fichier CLAUDE.md de projet ou local applicable. Si vous conservez les deux, vérifiez le réglage Project instructions dans /config et les fichiers chargés via /memory.
La fenêtre de contexte est un budget
Le contexte de Claude Code contient les instructions, la conversation, le contenu des fichiers et les résultats des outils. Sa capacité dépend du modèle et de la configuration. Utilisez /context pour inspecter son utilisation ; le client peut compacter automatiquement à mesure que la fenêtre se remplit. Les sorties d’outils contribuent à cette pression, c’est pourquoi j’utilise rtk pour réduire les sorties de commandes trop bavardes. L’économie dépend de la commande et de ce qu’il faut conserver. Voir l’explication de la gestion du contexte.
Les deux outils pour gérer cela sont /compact et /clear. Compact remplace les détails de la conversation antérieure par un résumé, qui peut omettre des informations utiles. Clear réinitialise la conversation active ; les transcriptions enregistrées et les fichiers persistants d’instructions ou de mémoire sont distincts. Notez les décisions et le travail restant avant de vider le contexte, puis vérifiez ce que la session suivante restaure réellement.
Les points de reprise avant un /clear fonctionnent comme des commits : écrivez dans un fichier l’état actuel, les décisions prises et les tâches restantes. Au démarrage de la nouvelle session, chargez ce point de reprise et confirmez que Claude l’a compris. Comparez l’état restauré aux fichiers avant de continuer ; un point de reprise peut être incomplet ou périmé.
Plus une tâche est longue, plus elle doit être décomposée. Une tâche bien décomposée avec plusieurs points de reprise /clear donne de meilleurs résultats que la même tâche exécutée dans une longue conversation qui se dégrade vers la fin. D’après mon expérience, les profils produit comprennent souvent cela plus vite que les développeurs. Ils décomposent des besoins en epics et stories depuis des années, et cette habitude de structurer le travail en étapes avec des points de reprise correspond précisément au modèle mental nécessaire pour gérer une longue session Claude.
Les skills permettent une invocation automatique ou explicite
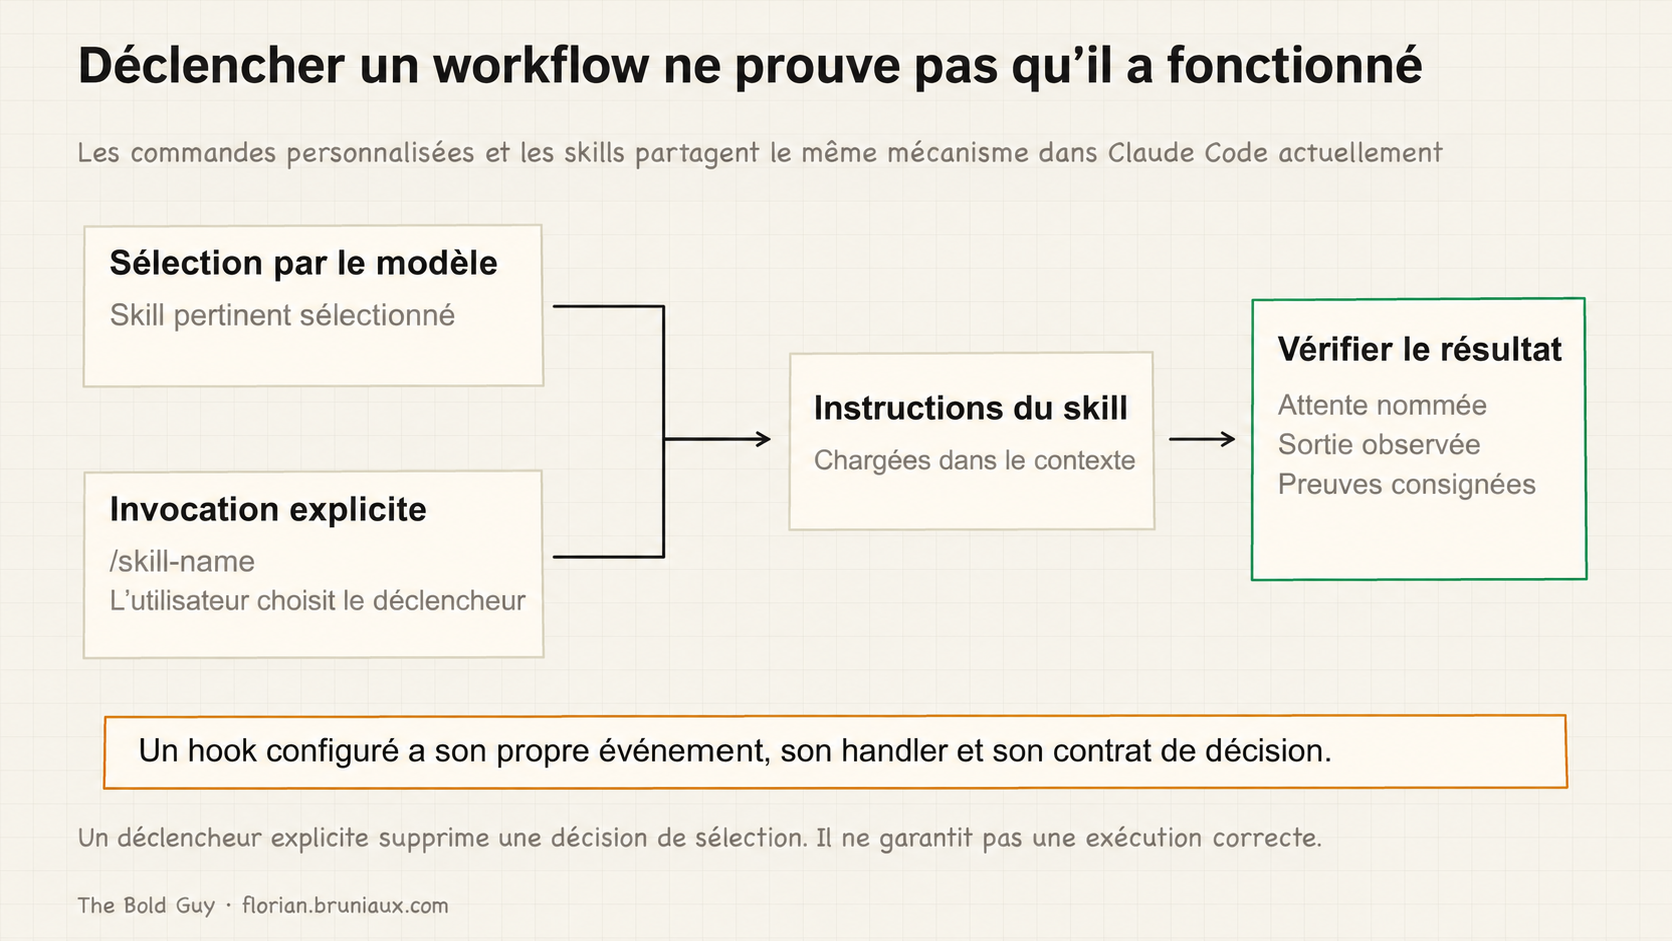
Le choix de conception porte sur qui déclenche la procédure. Un modèle peut sélectionner un skill pertinent, ou vous pouvez l’invoquer avec /skill-name. Claude Code a désormais fusionné les commandes personnalisées dans les skills ; les anciens fichiers de commandes fonctionnent encore.
Pour un workflow qui ne doit s’exécuter que sur demande, disable-model-invocation: true empêche l’invocation automatique. Cela contrôle la sélection, pas la justesse du travail produit. Une release ou un déploiement exige toujours ses vérifications et l’autorisation requise. Voir la référence d’Anthropic sur l’invocation des skills.
Les hooks assurent des contrôles propres aux événements
Les hooks exécutent des gestionnaires configurés lors d’événements pris en charge. Un gestionnaire synchrone PreToolUse peut refuser un appel d’outil en attente. Un gestionnaire PostToolUse s’exécute après que l’outil a terminé avec succès ; il ne peut pas annuler une écriture de fichier déjà effectuée. D’autres événements exposent d’autres décisions. La référence des hooks définit ces contrats.
Un premier cas utile consiste à protéger des fichiers nommés : inspecter l’écriture proposée, évaluer la politique et renvoyer le refus pris en charge par l’hôte. Cela exige un enregistrement actif, un événement correspondant, un parsing correct et un résultat traité. Une erreur quelconque ou un timeout ne garantit pas un blocage universel.
Les limites de délégation dépendent de la version
Un sous-agent nommé possède son propre prompt, ses outils et son contexte. Il peut isoler une investigation bavarde et renvoyer un résultat ciblé au parent. Un fork de conversation est différent : il hérite du prompt et de l’historique du parent.
La documentation des sous-agents, revérifiée le 15 octobre 2026, décrit une limite d’imbrication configurable, avec trois niveaux sous la conversation principale par défaut. Les anciennes versions utilisaient d’autres valeurs par défaut. « Subagents can never spawn » (traduction : « Les sous-agents ne peuvent jamais en créer d’autres ») n’est donc pas une règle produit stable.
Deux modèles de tâches restent utiles. Le modèle en équipe confie à différents reviewers des parties d’un même problème. Le modèle par lots applique la même procédure à des périmètres distincts. Attribuez les responsabilités et utilisez des worktrees lorsqu’une isolation est nécessaire ; une fenêtre de contexte distincte n’isole pas à elle seule les modifications du système de fichiers.
L’observation, la reprise et la compaction dépendent aussi des capacités du client. N’en déduisez pas une taille de résumé fixe ni une isolation complète des entrées pour chaque type de worker. Commencez par un cas borné et inspectez ce qui revient réellement.
Les modes de permission contrôlent les décisions sur les outils
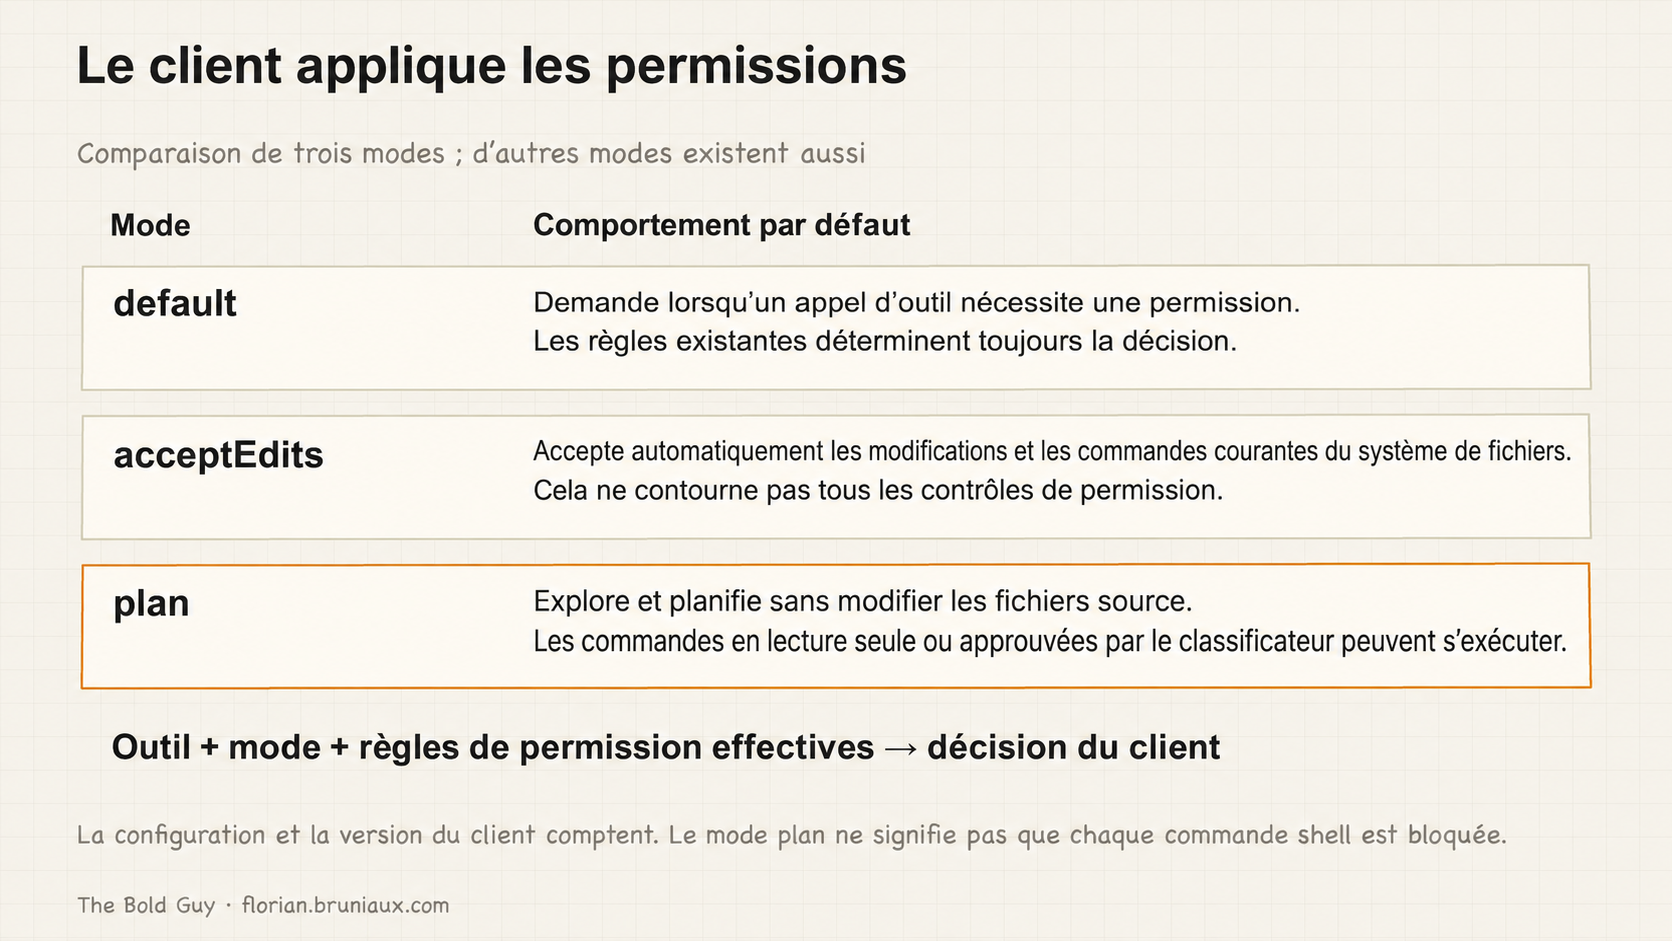
Claude Code applique les règles de permission ; il ne se contente pas de les suggérer au modèle. La référence des permissions distingue plusieurs modes. Trois exemples utiles sont default, qui demande lorsqu’un appel a besoin d’une permission ; acceptEdits, qui accepte les modifications et les commandes courantes du système de fichiers ; et plan, qui explore sans modifier les fichiers sources.
Le mode Plan peut exécuter des commandes shell en lecture seule et, lorsque le classificateur correspondant est disponible, des commandes approuvées. Cela ne signifie pas que chaque appel Bash est bloqué. De même, acceptEdits n’est pas le mode qui contourne toutes les permissions. Vérifiez le mode actif et les règles effectives avant de vous fier à une limite.
Trois vérifications au niveau du compte
Trois points qui figurent rarement dans les supports d’onboarding.
Vérifiez la conservation des données selon le type de compte et la préférence de confidentialité réellement utilisés. Dans la documentation d’utilisation des données revérifiée le 15 octobre 2026, les comptes grand public qui autorisent l’amélioration des modèles ont une conservation de cinq ans ; ceux qui la refusent et les comptes commerciaux standard ont une conservation de 30 jours. Les dispositifs Enterprise éligibles à la conservation nulle exigent une activation distincte. Les transcriptions CLI locales ont normalement leur propre nettoyage à 30 jours, tandis que les sessions démarrées ou poursuivies le plus récemment dans Claude Desktop ou Cowork en sont exemptées par défaut. Enterprise ne signifie pas automatiquement conservation nulle ni certification de conformité.
Si vous déployez Claude Code dans une équipe, vérifiez le réglage de bascule vers l’API. Quand un utilisateur atteint la limite de son abonnement, une option permet de basculer automatiquement vers l’API facturée au token. Cette option était activée chez un de mes collègues sans qu’il le sache. Quelques jours d’utilisation normale ont produit une facture de 300 à 400 €. La vérification prend 30 secondes pendant le déploiement. Si vous la manquez, vous le découvrez sur la facture. C’est précisément pour éviter cet échec que j’ai conçu ccboard : il rend visibles les coûts, la santé des hooks et l’état des MCP au fil de leur évolution, pas un mois plus tard.
Le troisième point est une observation sur le rôle. À un moment, si votre installation est un peu élaborée, vous consacrerez une part réelle de votre temps à la configuration elle-même : ni à écrire des fonctionnalités, ni à faire de la code review, mais à ajuster des règles, mettre à jour des hooks et affiner des agents lorsque le workflow évolue. Sur mon installation actuelle, cela représente entre 30 et 50 % des commits pendant les périodes de maintenance active. Considérer cela comme un vrai travail d’ingénierie, plutôt que comme un coût à réduire, change la répartition du temps et la personne qui en est responsable dans une équipe.
Choisir l’article suivant selon son objectif
Ce ne sont pas les seuls concepts, mais ce sont ceux pour lesquels l’écart entre une compréhension superficielle et le comportement réel cause généralement le plus de friction au début.
Pour une référence structurée plutôt qu’un parcours narratif, l’analyse approfondie de l’architecture du guide couvre la même boucle, le catalogue d’outils et le modèle de mémoire dans un format de consultation, utile pour vérifier un détail plutôt que tout lire du début à la fin.
Si vous cherchez encore dans quel ordre apprendre tout cela, la carte d’onboarding organise les ressources par rôle et selon les parcours Start, Build et Scale. Cet article supposait que vous aviez déjà dépassé la question du vocabulaire ; celui-là explique comment y arriver.
Pour voir ces mécanismes en pratique sur une codebase de production pendant sept mois, Claude est mon deuxième contributeur décrit les tendances des commits, ce que Claude prend en charge et ce qui reste du travail humain.
Ces mécanismes ont aussi un volet sécurité. Les commandes locales des hooks et les serveurs MCP peuvent s’exécuter avec les permissions de leur processus hôte, et le guide de la surface d’attaque audite directement cette couche, avec cinq scripts de défense prêts à placer dans .claude/hooks/.
Le guide de migration Plan-Execute applique ces primitives à un exemple de planificateur Opus et de workers Sonnet dans des worktrees distincts. Son exemple de 243 fichiers est une esquisse de conception, pas une exécution documentée ni un résultat de performance mesuré.
Une boucle, un contexte explicite, des contrôles vérifiés
Claude Code devient plus facile à inspecter quand on distingue la boucle, les sources d’instructions, les chemins d’invocation et les contrôles de permission. Les instructions influencent le comportement. Les contrôles du client restreignent les actions prises en charge. Les preuves recueillies dans le client actif indiquent quelle limite a effectivement tenu.
Il m’arrive encore de me tromper sur un point : décider qu’une tâche est assez simple pour se passer du mode Plan, et avoir tort. Si vous avez une heuristique fiable pour le décider, je serais curieux de la connaître.
YSNK
(Vous devriez maintenant savoir)
- Inspecter les outils et le contexte disponibles dans votre client réel plutôt que supposer un nombre d’outils ou une taille de contexte fixes
- Les instructions écrites, la mémoire automatique et les sessions reprises conservent des types d’informations différents
- L’invocation explicite d’un skill contrôle le déclenchement ; elle ne garantit pas un résultat correct
- Les permissions et les hooks ont des contrats différents, et un hook après exécution ne peut pas annuler une action rétroactivement
- Vérifier les paramètres de conservation et de facturation propres au compte, ainsi que les limites de délégation selon la version du client
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source