D’un profil non technique à la production en 10 jours avec Cursor AI
Un non-développeur a modifié 80 fichiers en production en 10 jours avec Cursor AI. Chronologie exacte, configuration IA et implications pour les équipes d’ingénierie en 2026.
Aller au résumé ↓ Florian Bruniaux
TL;DR
Ma règle de recrutement pour 2026 : la question n’est plus de savoir écrire du code de zéro, mais de comprendre assez votre système pour l’étendre avec l’IA dans la boucle. Augustin, sans expérience du code, a livré sur cette base une PR de 80 fichiers en 10 jours, sur du frontend et des patterns reproduits, tandis que backend, modèles de données et sécurité restaient aux développeurs expérimentés. Je m’attends à ce que de plus en plus de non-développeurs contribuent au code d’ici 2027, dans le périmètre ouvert par l’équipe.
| Sujet | Détails |
|---|---|
| Qui | Augustin, profil produit, sans expérience du code, utilisait Lovable pour prototyper |
| Objectif | Contribuer à la codebase de production de Méthode Aristote |
| Outil | Cursor (choisi plutôt que Claude Code pour l’expérience visuelle de l’IDE) |
| Jour 10 | Première PR en production : 80 fichiers modifiés, 15 corrections de bugs |
| Jour 21 | Plusieurs PR par jour sur le frontend et les patterns répétés ; backend et sécurité restaient aux développeurs expérimentés |
| Les 3 facteurs | Config IA adaptée (-59 % de lignes), architecture structurée (3 couches, patterns reproductibles), progression mesurée |
| Ce que cela signifie | Contribuer demande désormais une compréhension structurelle, pas de savoir écrire le code de zéro. |
Contributeur non technique (2026) : personne qui connaît le domaine métier du produit et maîtrise les outils IA, sans expérience préalable du code, capable de livrer en production dans une codebase assistée par IA aux patterns cohérents.
Décembre 2025. Augustin est venu me voir avec une demande directe : « Train me. I want to ship to production. » Traduction fidèle : « Forme-moi. Je veux livrer en production. »
Il n’était pas développeur. Il avait utilisé Lovable pour prototyper des interfaces, mais bloquait devant la vraie codebase : aucune expérience du terminal, pas de TypeScript, aucune compréhension des liens entre routeurs tRPC et couches de services. Je construisais la plateforme comme AI Founding Engineer depuis 5 mois, avec une configuration ajustée pendant mes soirées.
Mon patron m’a demandé mon avis. Selon lui, l’équipe d’ingénierie de Cartesia (le groupe auquel nous appartenons : développeurs expérimentés, TDD strict, des années de pratique) aurait immédiatement refusé. « That’s not how this works. » Traduction fidèle : « Ça ne fonctionne pas comme ça. »
J’ai répondu : « Deal. Let’s go. » Traduction fidèle : « D’accord. On y va. »
Windows imposait une autre installation
Premier frein : Windows contre Mac
Tout mon workflow tournait sur macOS. Commandes Unix, hooks shell, configurations zshrc, commandes slash : rien de cela ne fonctionnerait sur sa machine. Avant de penser IA, nous avions un problème de compatibilité d’OS.
Nous avons comparé Claude Code et Cursor pour sa situation. La conclusion était nette : Cursor était plus adapté. Moins de dépendance au terminal, une expérience d’IDE plus visuelle, une interface qui ne suppose pas de savoir ce qu’est une invite shell.
Le problème de config IA
Ma configuration Claude Code avait grandi sur des mois d’itération. À l’arrivée d’Augustin, mon CLAUDE.md généré de 703 lignes couvrait toute mon installation : 6 modules fonctionnels actifs, environnement macOS, tous les serveurs MCP configurés, ton de communication direct_brutal, règles d’usage de RTK et stack complète.
Lui donner cette configuration aurait ajouté du bruit. La documentation MCP couvrait des outils qu’il n’utilisait pas. La configuration contenait des réglages shell macOS pour quelqu’un sous Windows et une méthode de débogage avancée pour quelqu’un qui apprenait encore ce qu’est un chemin de fichier.
La solution a été un système de profils. Son profil YAML produisait 289 lignes, contre 703 pour le mien. Exclure les sections sans rapport réduisait le nombre de lignes d’environ 59 %. Ce n’est pas une réduction mesurée de tokens ou de facture.
# profiles/augustin.yaml
id: augustin
display_name: "Augustin"
os: windows
tool: cursor
communication:
  tone: ultra_concise
modules: [] # No advanced modules, not relevant yet| Couche | Florian (703 lignes) | Augustin (289 lignes) |
|---|---|---|
| Fondation (partagée) | Métier, types de sessions, rôles utilisateurs | Identique, toujours incluse |
| OS et outils | macOS, zsh, hooks RTK | Windows, interface Cursor |
| Ton de communication | Conseiller direct/brutal | Ultra-concis |
| Modules fonctionnels | 6 actifs | Aucun |
| Serveurs MCP | Stack complète configurée | Exclus |
| Débogage avancé | Méthode complète | Exclu |
| Résultat net | 703 lignes | 289 lignes (-59 %) |
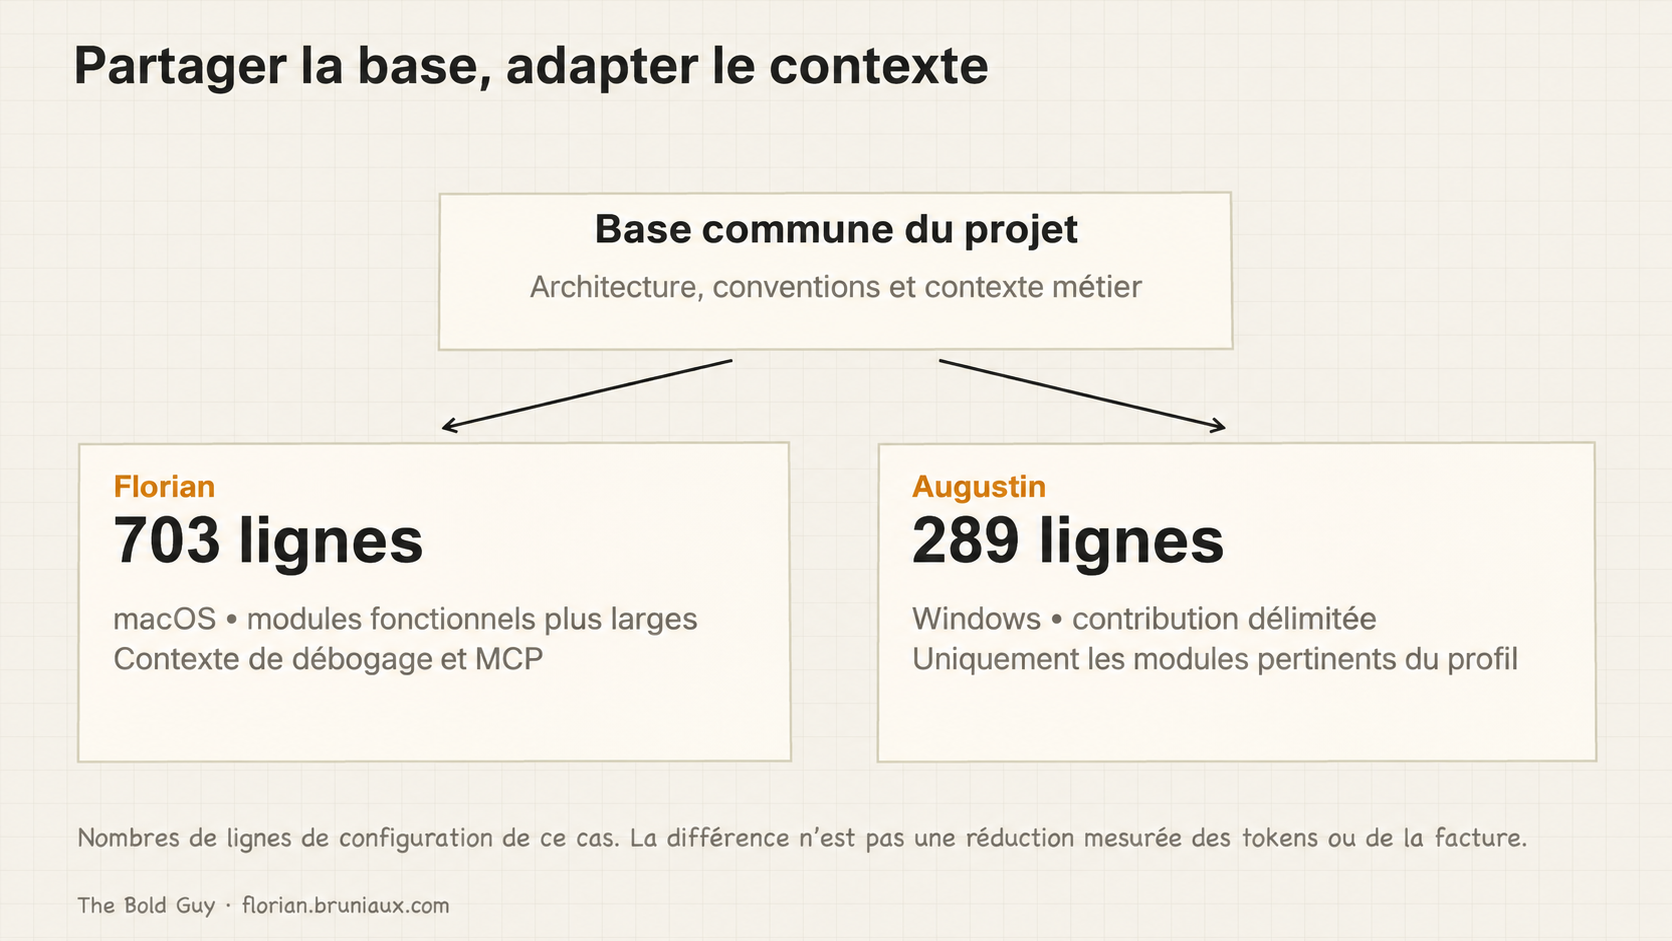
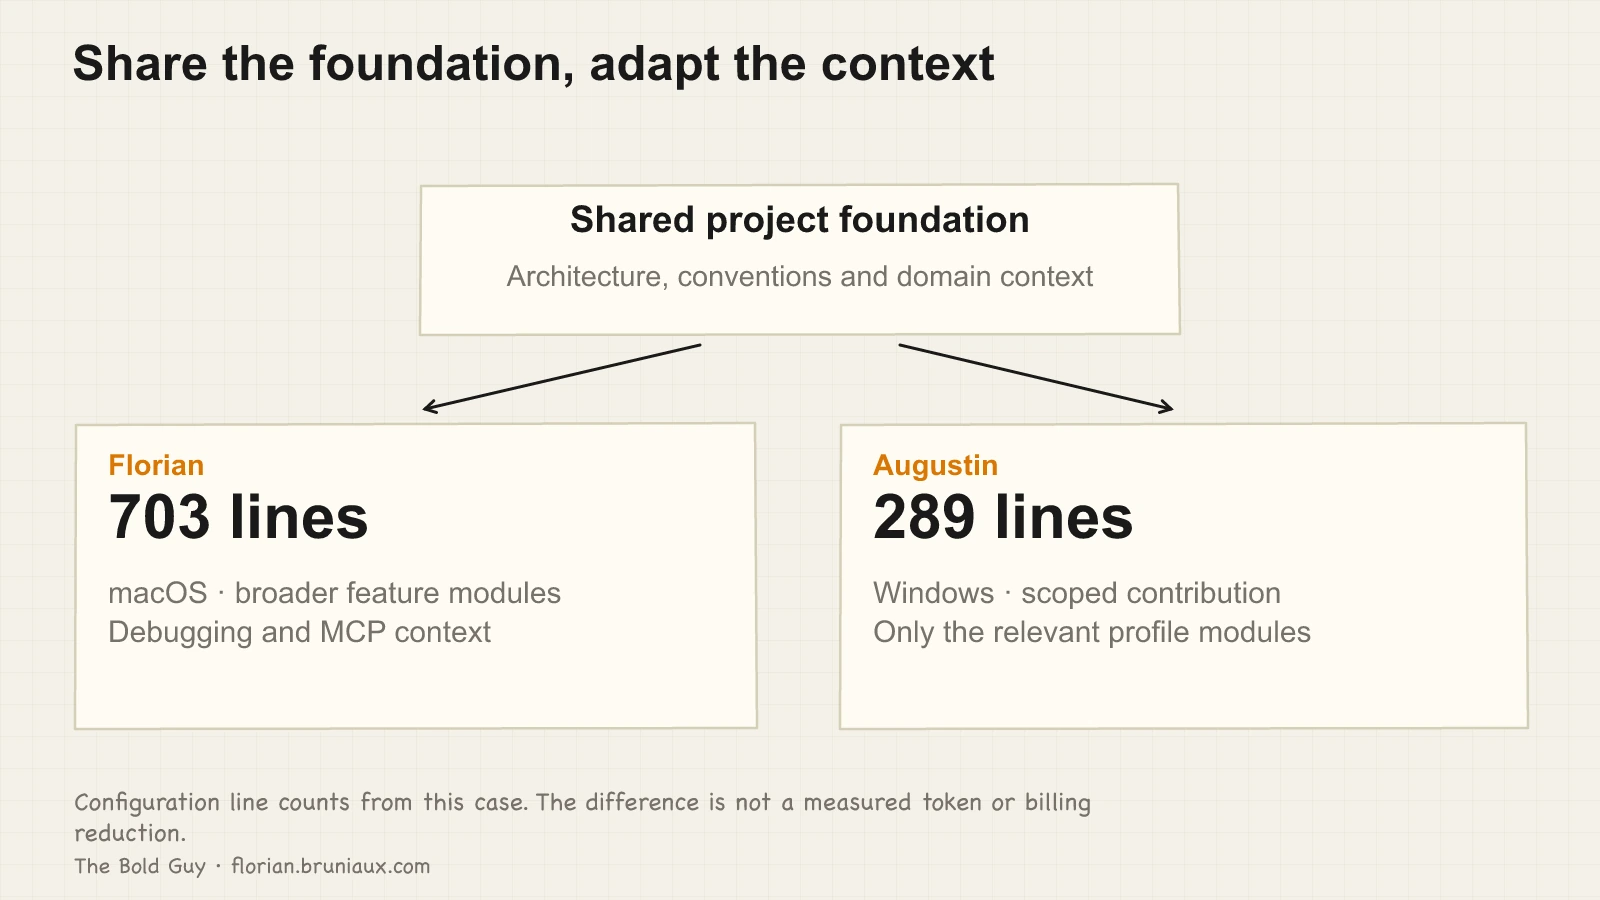
Le fichier plus court n’est pas le plus intéressant. Ce qui comptait davantage était ce qui restait inclus : le métier. L’IA d’Augustin savait déjà qu’une « session » dans notre codebase signifiait SUPERVISED (1 heure avec un tuteur) ou AUTONOMOUS (30 minutes seul), avec le cycle SCHEDULED → STARTED → COMPLETED. Elle connaissait la tolérance de 15 minutes avant annulation, les 7 rôles utilisateurs et leurs permissions.
Cette connaissance métier venait de la fondation partagée par tous les profils. Quand Augustin demandait de l’aide pour un bug du composant de planification, l’IA ne devinait pas le sens de « session ». Elle le connaissait déjà.
Son IA était calibrée pour son niveau, pas le mien, mais portait la même compréhension de ce que faisait le produit.
La première semaine : itérer, pas former
Nous n’avons pas fait une semaine de séances où j’expliquais la codebase. Nous avons itéré chaque jour. Hooks incompatibles Windows. Skills supposant des chemins Unix. Problèmes de compatibilité Cursor nécessitant des contournements. Beaucoup d’allers-retours. Cela prenait du temps, mais construisait une configuration réellement adaptée à son installation.
De zéro fichier à la production en 10 jours
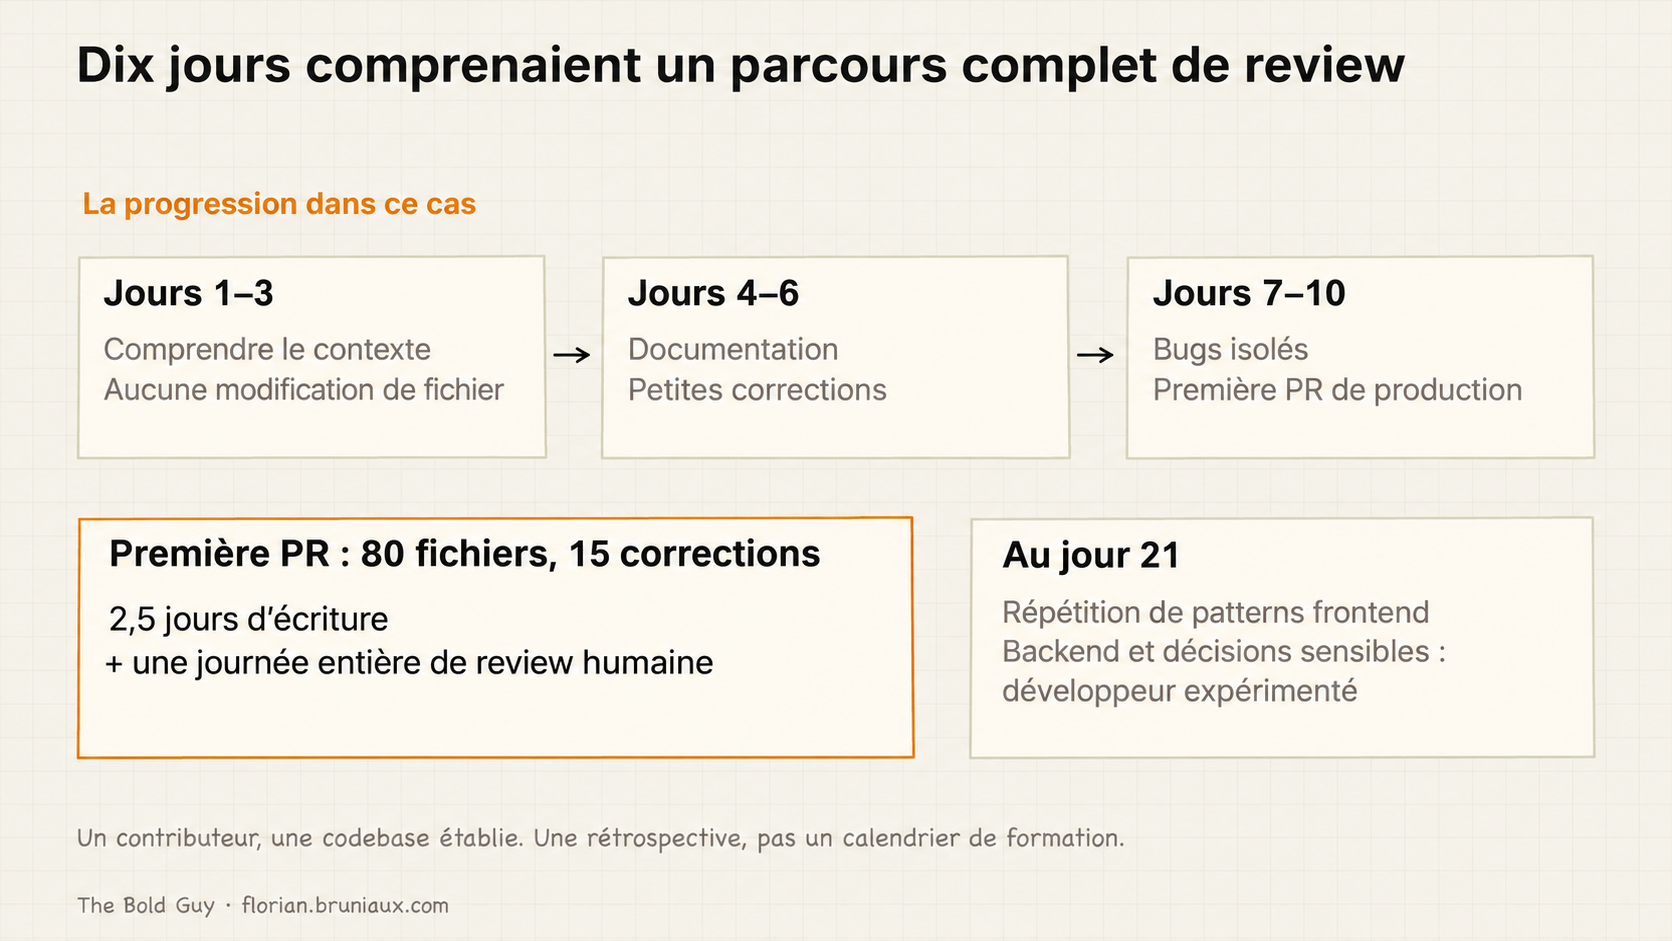
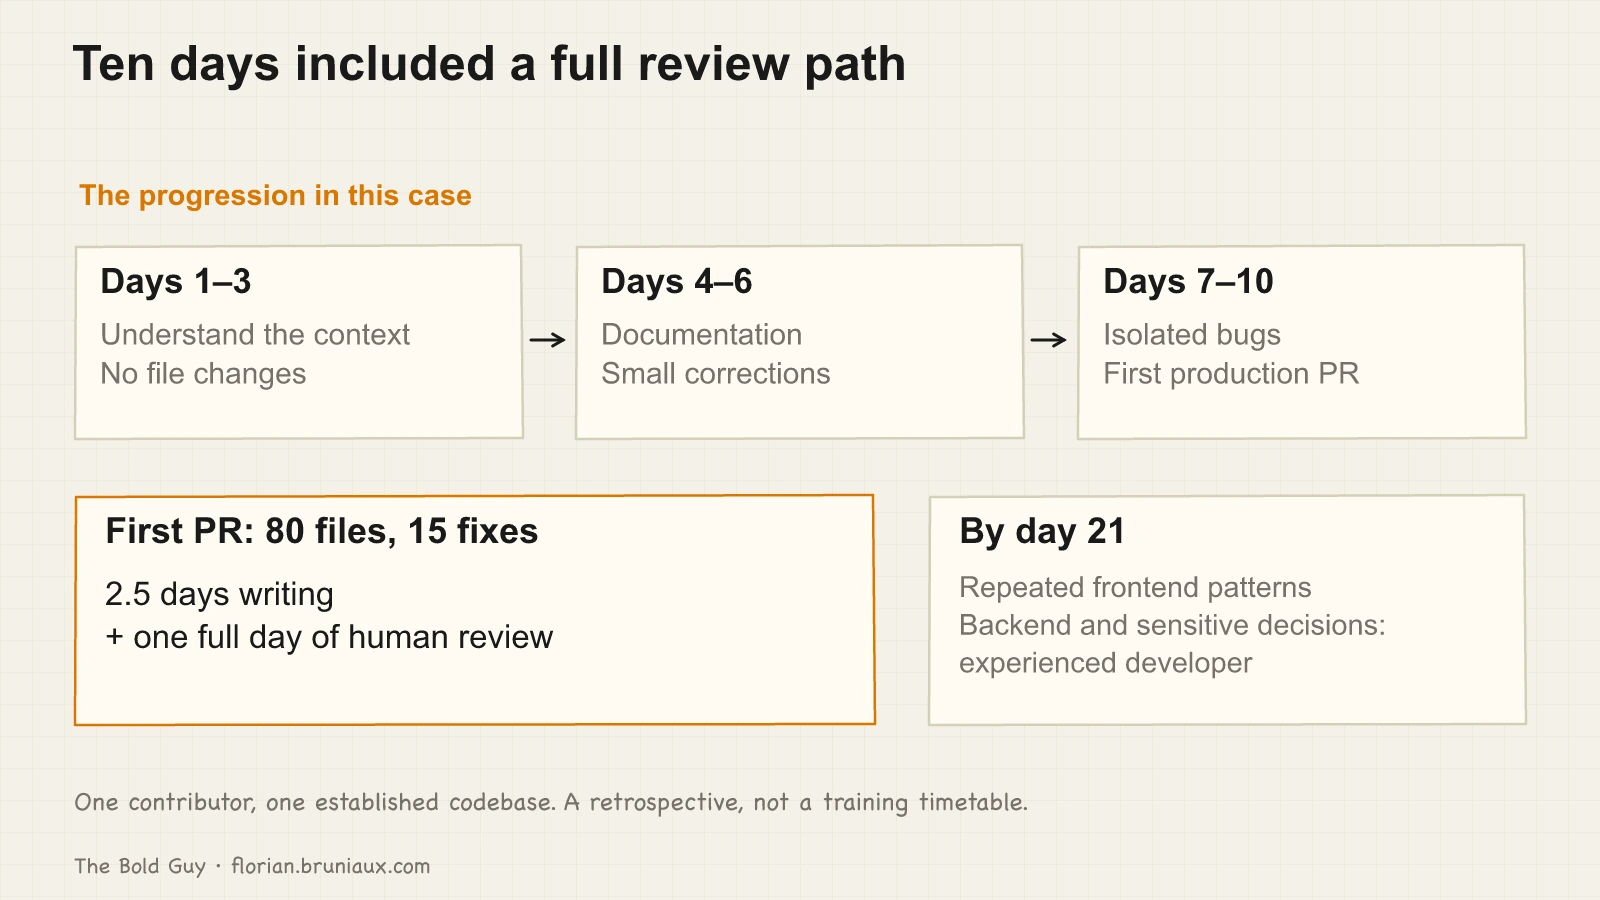
La chronologie conserve la progression exacte plutôt que la lisser pour le récit.
Jours 1 à 3 : zéro code, tout le contexte
Augustin interrogeait la codebase avec l’IA de Cursor pour comprendre l’existant. Il améliorait les specs dans Notion avec l’aide de l’IA, sans écrire de code, mais pour clarifier les exigences. Zéro fichier modifié, volontairement.
L’architecture en 3 couches compte ici. Chaque service suit le même pattern : les Routers valident et transmettent, les Services portent la logique métier et les permissions, les Repositories gèrent le CRUD. C’est cohérent sur plus de 45 services. Quand le pattern est cohérent, l’IA peut l’expliquer de façon fiable. Sinon, elle donne une moyenne de patterns contradictoires.
Jours 4 à 6 : changements sans risque
Les changements étaient volontairement petits : coquilles corrigées, fichiers Markdown de la base de connaissances mis à jour avec la terminologie métier, correctifs de documentation. Rien touchant à la logique applicative.
Cette dernière catégorie n’était pas triviale. Augustin connaissait le métier mieux que moi. Il travaillait avec les fondateurs depuis des mois. En mettant à jour la base de connaissances, il alimentait le système avec les règles métier que l’IA utiliserait pour aider chaque développeur. Ces changements sans risque étaient aussi utiles.
L’objectif n’était pas de créer de la confiance par la réussite, mais de se familiariser avec le processus : modifier, voir le changement dans Cursor, comprendre un commit, une PR et les retours de review.
Jours 7 à 10 : bugs isolés avec l’IA de Cursor
Je lui donnais des tickets précis. « The button doesn’t appear at the right moment. » Traduction : « Le bouton n’apparaît pas au bon moment. » « This click redirects to the wrong URL. » Traduction : « Ce clic redirige vers la mauvaise URL. » Des bugs que j’avais identifiés comme isolés, bien bornés et sûrs à déléguer.
Il utilisait l’IA de Cursor pour comprendre les composants concernés, modifier et tester localement. Je pointais le fichier exact si nécessaire.
Jour 10 : première PR en production
80 fichiers modifiés. 15 corrections de bugs dans une PR.
Deux jours et demi de travail de son côté. Une journée entière de review du mien.
“Functionally, everything was broken. But it worked.”
Traduction fidèle : « Fonctionnellement, tout était cassé. Mais ça marchait. »
Cette citation est exacte. La PR avait des bugs de gestion des cas limites. Ce n’était pas seulement du CSS et des redirections. Elle contenait de la vraie logique de hooks React, où des hypothèses fausses sur le cycle de vie produisent des pannes subtiles et intermittentes. La review les a détectées. J’ai moi-même utilisé Claude pour naviguer dans le diff de 80 fichiers, en lui demandant de signaler les patterns suspects au regard de sa connaissance de l’architecture. Le risque de relire du code généré qu’on ne comprend pas totalement va dans les deux sens. La dette de compréhension n’est pas seulement le problème de celui qui livre.
La version finalement fusionnée était propre. Mais ce qui m’est resté, c’est que quelqu’un n’ayant jamais ouvert un terminal pouvait modifier 80 fichiers, avec une journée de review plutôt qu’une semaine, pour un résultat livrable.
J’étais plus fier de ce merge que de chacune des 49 releases livrées les 7 mois précédents. Le code avait des défauts, mais le merge prouvait que le modèle fonctionnait. Quelqu’un d’autre était entré dans le système que j’avais construit et avait livré quelque chose de réel.
Jour 21 : plusieurs PR par jour
Trois semaines après avoir découvert Cursor, Augustin livrait au rythme de développeurs seniors de mes meilleures équipes. Son périmètre excluait backend, conception de modèles de données et couche sécurité. Sur le frontend et la reproduction de patterns, le débit était réel et mesurable.
Les 3 facteurs de réussite
1. Un contexte IA adapté
Le système de profils faisait comprendre le projet à son IA avec le bon niveau de détail. Règles métier, conventions d’architecture et patterns précis de la codebase, sans le bruit des outils avancés sans rapport avec son travail.
La bonne quantité de contexte produit des réponses utiles. Trop de contexte perturbe le modèle (qui commence à hésiter ou à moyenner des informations sans rapport), trop peu lui fait halluciner les conventions du projet. Les 289 lignes n’étaient pas minimales pour faire simple ; elles correspondaient à son workflow, avec toute la fondation métier et architecturale partagée entre profils.
La distinction compte : son IA ne connaissait pas seulement la structure du code. Elle comprenait ce que le produit devait faire. C’est ce qui lui permettait de naviguer dans un changement de composant sans traiter la codebase comme une bibliothèque inconnue.
2. Une architecture reproductible
L’architecture en 3 couches sert la transmission au-delà de la qualité du code.
Quand je crée un service, toute la chaîne est reproductible : routeur tRPC avec validation Zod, service avec logique métier et contrôles de permissions, repository avec requêtes Prisma typées. L’IA connaît ce pattern car il est cohérent dans plus de 45 services. Elle peut l’appliquer car la place de chaque logique est sans ambiguïté.
Augustin ne crée pas d’architecture nouvelle. Il reproduit des patterns établis, et cette distinction est la clé. Si la codebase était incohérente (patterns différents selon les endroits, logique métier dispersée), les sorties de l’IA refléteraient cette incohérence. La discipline architecturale crée les conditions d’une contribution non technique. Elle ne s’ajoute pas après coup : si elle manque à l’arrivée d’une personne, cela se voit immédiatement dans la qualité de ce que cette personne produit avec l’IA.
3. Une progression mesurée
Les jours 1 à 3 sans toucher au code n’étaient pas perdus. C’était un investissement dans le contexte avant la production.
La progression était délibérée : comprendre avant de modifier, modifier sans risque avant les changements à conséquences, bugs isolés avant fonctionnalités multi-composants. Chaque étape construisait la base de la suivante. Sauter des étapes aurait donné des premiers commits plus rapides et une progression globale plus lente.
Quand une personne arrive, la tentation est de lui donner immédiatement quelque chose de réel pour prouver le modèle. Une approche plus fiable consiste à laisser la compréhension se construire avant de produire. Cela semble contre-intuitif quand on vise la vélocité, mais le rythme d’Augustin au jour 21 a validé la patience du jour 3.
Le binôme humain-IA après le jour 21
La répartition est claire :
Florian : backend, services, modèles de données. Il pose les fondations et fait les choix d’architecture.
Augustin : frontend, reproduction de patterns. Pas d’innovation technique de son côté, mais une vraie constance dans la reproduction des patterns établis.
| Contributeur | Commits | Partie | Rôle |
|---|---|---|---|
| Florian | 902 | 82 % | Backend, architecture, review |
| Nico | 60 | 5 % | Design produit |
| Augustin | 53 | 5 % | Frontend, reproduction de patterns |
Sur les 902 commits de Florian, la majorité était coécrite avec Claude, ce qui en fait le deuxième contributeur le plus actif selon la coécriture. Les binômes humain-IA sont visibles dans le workflow, comme mode opératoire quotidien plutôt que métaphore. Le détail des commits et le sens de cette part de coécriture figurent dans Claude est mon deuxième contributeur.
Deux autres personnes suivent actuellement le même onboarding. Ben (le fondateur) a commencé avec des tickets plus simples. Matisse, profil produit, a commencé à contribuer à la découverte produit. Le système éprouvé par Augustin se diffuse, un profil YAML à la fois.
Ce que cela dit du recrutement en 2026
Le filtre traditionnel est l’aisance d’implémentation : savez-vous écrire le code de zéro ? Il avait du sens quand le goulot était l’écriture. En 2026, la question pertinente est de comprendre assez un système pour l’étendre avec l’aide de l’IA. Ce sont deux filtres qui sélectionnent des personnes différentes.
Augustin ne sait pas écrire un routeur tRPC en partant des principes de base. Il sait en étendre un parce que le pattern est établi, que l’IA le comprend et que la review détecte les lacunes. C’est une capacité différente du développement traditionnel, utile sur le frontend et la reproduction de patterns.
Les développeurs restent nécessaires. L’architecture en 3 couches permettant sa contribution nécessitait quelqu’un comprenant la raison de ces couches. Détecter les cas limites dans sa PR du jour 10 exigeait aussi un raisonnement sur le système de bout en bout. Configurations de serveurs MCP, garde-fous de sécurité et optimisation de base de données restent pour l’instant hors de son domaine.
En pratique, le vibe coding structuré utilise des prompts dans des contraintes et une architecture conçue pour être reproductible.
Ce qui a changé est le point d’entrée. Il fallait auparavant maîtriser la couche d’implémentation pour contribuer à une codebase. Il faut maintenant assez de compréhension structurelle pour étendre des patterns avec l’IA dans la boucle, et un processus de review qui détecte ce que l’IA laisse passer. Ce sont des compétences différentes. Elles existaient déjà, mais n’étaient pas utiles dans ce contexte précis avant que les outils IA ne rendent l’écart franchissable.
L’équipe Cartesia aurait refusé cette expérience. Elle avait raison selon son modèle. J’en avais vu assez pour penser que ce modèle méritait un test, et les 10 jours suivants m’ont donné une réponse concrète.
Les conditions derrière ces 10 jours
Une personne non technique a livré 80 fichiers en production en 10 jours et atteignait le débit de développeurs seniors au jour 21. Le système de profils fournissait un contexte calibré dans la version de 289 lignes incluant tout le métier. L’architecture donnait à ce contexte des patterns cohérents à étendre, et la progression laissait la compréhension précéder la production. Les trois devaient être présents. La question de recrutement pour 2026 est de savoir si quelqu’un comprend assez votre système pour l’étendre avec l’IA, et si la codebase soutient ce travail. Le résultat d’Augustin dépendait de l’infrastructure déjà en place.
Le système de profils décrit ici (profils YAML modulaires produisant des CLAUDE.md différents par développeur) fait partie de l’architecture de configuration IA construite chez Méthode Aristote. Documenté dans le Claude Code Ultimate Guide.
YSNK
(Ce que vous devriez maintenant savoir)
- Le choix d’outil s’est joué sur la friction d’environnement avant l’IA : Windows contre hooks shell et config zshrc réservés au Mac, ce qui rendait l’IDE visuel Cursor plus pratique que Claude Code
- Les jours 1 à 3 n’ont touché aucun fichier volontairement. Comprendre la codebase précédait toute sortie, et le rythme du jour 21 validait cette patience
- La review d’un diff de 80 fichiers généré par IA était elle-même assistée : le reviewer utilisait Claude pour signaler les patterns suspects selon sa connaissance de l’architecture. La dette de compréhension va dans les deux sens
- Deux autres profils non techniques ont depuis suivi le même onboarding, un fondateur et une personne produit, un profil YAML à la fois
- Le cadre transférable : le vibe coding structuré place les prompts dans des contraintes et une architecture reproductible, plutôt que de lancer un prompt en croisant les doigts. L’architecture doit exister d’abord
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source