Vous ne pouvez pas dépendre d’un fournisseur IA unique
Une chute boursière de 589 milliards de dollars en une journée, une plateforme de modèles pour entreprises et un serveur de secours à 25 000 € montrent trois échelles de dépendance fournisseur.
Aller au résumé ↓ Florian Bruniaux
The Real Cost of AI · Partie 6/9
TL;DR
Je partage la règle de Nicolas Martignole selon laquelle on ne peut pas dépendre d’un fournisseur IA unique, et je l’applique : j’utilise Claude Code et Codex côte à côte, en alternance. Je ne suis pas expert du matériel d’inférence, mais un serveur de secours à 25 000 € me paraît petit pour environ 300 développeurs : à moi seul, je pousse déjà un MacBook M5 Max avec 128 Go de RAM à ses limites. Pour servir des dizaines ou centaines de développeurs, je pense qu’il faut plusieurs grosses machines ou un très grand serveur, ainsi que plusieurs fournisseurs, avec des couches de redondance comme en sécurité et en infrastructure.
| Affirmation | Détail | Source |
|---|---|---|
| La règle | Impossible de dépendre uniquement d’Anthropic et Claude Code | Nicolas Martignole, Principal Engineer chez Back Market, 2 juillet 2026 |
| Le fil des preuves | Benchmark multi-fournisseurs via OpenRouter, puis thèse complète sur le caractère trompeur du prix affiché, puis distinction juridique entre Claude Max et l’API | Martignole, du 30 juin au 22 juillet 2026 |
| Le secours souverain | Serveur auto-hébergé à 25 000 € exécutant un modèle chinois à poids ouverts, gardé comme plan B en cas de coupure d’accès | Martignole, entretien avec Prompt Humain, 24 juillet 2026 |
| Version du même risque côté marchés | Nvidia a perdu 589 milliards de dollars de capitalisation en une séance, une perte présentée comme la plus grande perte journalière de l’histoire boursière américaine à cette date | Bloomberg, Reuters, WSJ, 27 janvier 2025 |
| L’affirmation de coût contestée derrière | Le rapport technique de DeepSeek cite 5,576 millions de dollars pour l’entraînement final de V3 ; R1 est hors de ce périmètre, et des estimations indépendantes situent les dépenses d’investissement réelles près de 1,6 milliard | Rapport technique DeepSeek ; TechCrunch, CNBC, SemiAnalysis, janvier-février 2025 |
| Même règle, autre échelle | Modèle de plateforme souveraine de modèles à la demande pour entreprises, plateforme IA de l’État français et reconstruction multi-datacenter imposée à une entreprise de jeux d’argent | Devoxx 2026, DINUM (État français), Devoxx Greece 2025 |
Nicolas Martignole expliquait une courbe de coûts depuis deux minutes quand il a livré le véritable sujet de la vidéo.
Back Market venait de passer quatre semaines à reprendre le contrôle de ses dépenses IA après des tests de modèles alternatifs, et il voulait nommer le mécanisme avant de poursuivre. « What’s the secret? You cannot depend solely on Anthropic and Claude Code. You’re taking on too much risk, and the price against the value it generates becomes far too excessive »1, disait-il le 2 juillet 2026 en plein benchmark. Traduction fidèle : « Le secret ? Vous ne pouvez pas dépendre uniquement d’Anthropic et de Claude Code. Vous prenez trop de risques et le prix devient beaucoup trop excessif par rapport à la valeur générée. »
Les sous-titres automatiques de sa chaîne transcrivent Claude Code en « Cloud Code » tout du long, un artefact connu de transcription, mais la règle tient : la dépendance à un fournisseur unique appartient au même registre que tout risque de concentration.
La première partie présentait Martignole comme l’ingénieur qui avait additionné une facture Anthropic de 214 $ ligne par ligne, face caméra.
Ce qu’il a construit après ce projet compte ici : une habitude documentée de tester publiquement sa dépendance à Anthropic, régulièrement.
Trois semaines de pièces à l’appui
La règle n’est pas une opinion isolée. Deux jours avant, le 30 juin, Martignole expliquait pourquoi son équipe évaluait OpenRouter, une couche de routage donnant accès à plus de 70 fournisseurs de modèles via un contrat unique.
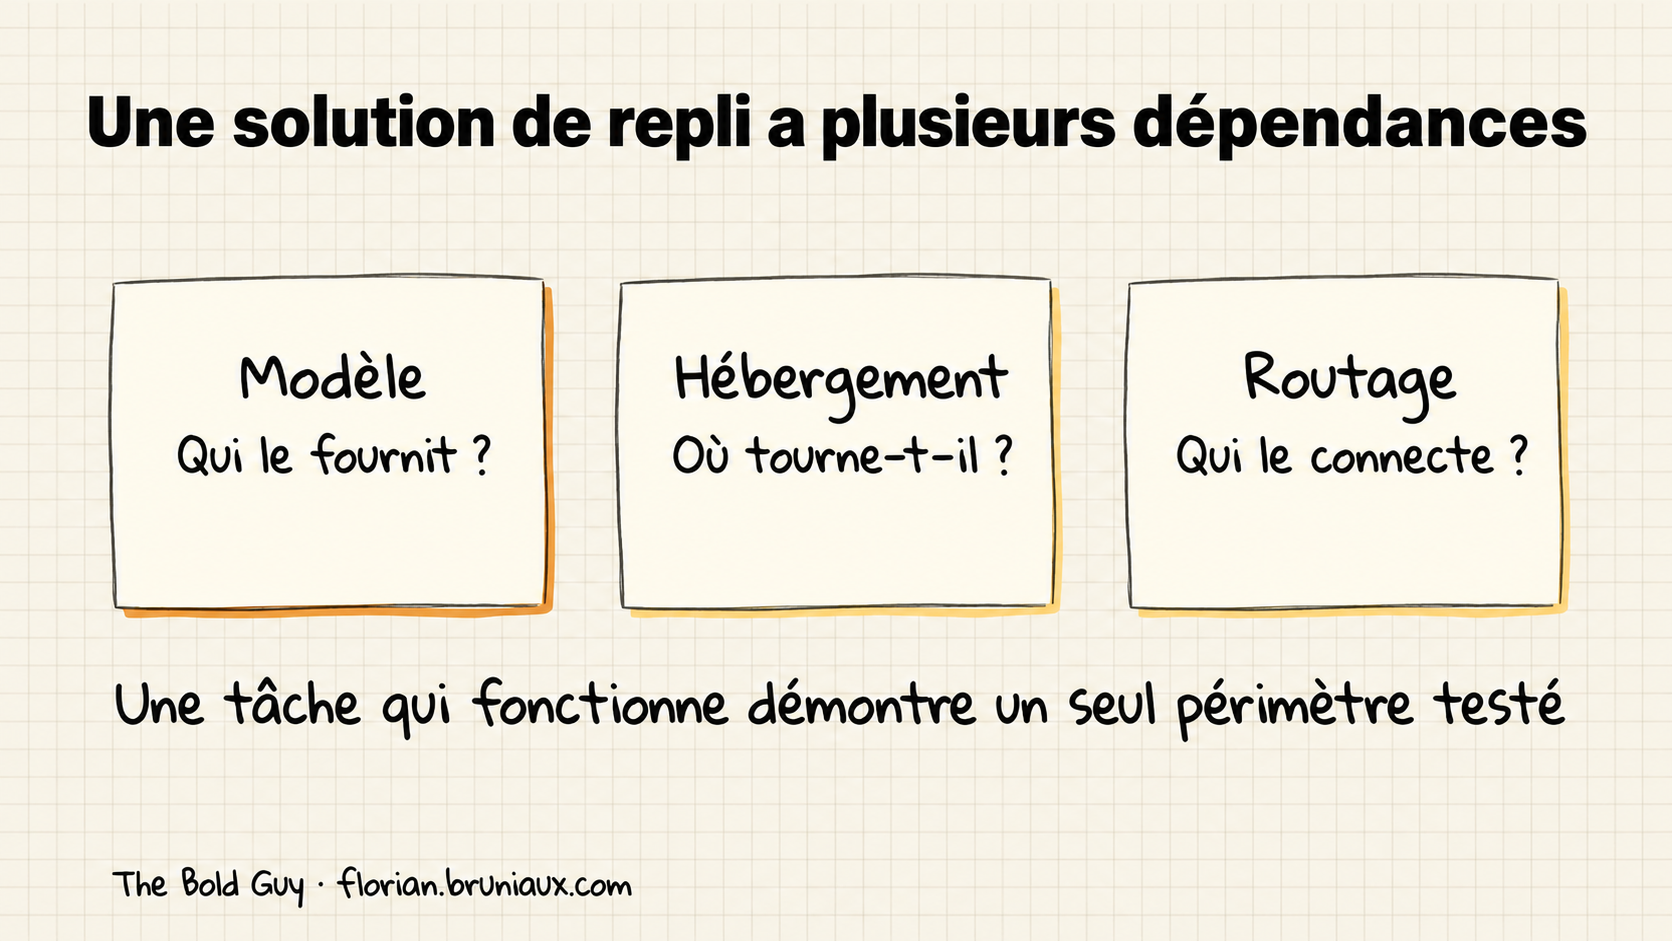
Distinguez fournisseur du modèle, hébergement et routage. Changer d’endpoint ne remplace pas nécessairement le fournisseur du modèle, et une passerelle peut elle-même devenir une dépendance.
Pour une entreprise de sa taille, les tokens moins chers comptaient moins que la structure contractuelle : un contrat plutôt que plusieurs, une passerelle plutôt qu’une douzaine d’intégrations et la possibilité de router par équipe, modèle ou budget sans renégociation. C’est la même logique que la fonction FinOps documentée en partie 4 : rassembler les leviers avant qu’un incident n’impose la question.
Neuf jours après la règle, le 11 juillet, Martignole développait l’argument : le prix par token affiché par un fournisseur prédit mal le coût réel d’une charge de travail, car le cache, la verbosité et la répartition entre tokens d’entrée et de sortie font varier la facture indépendamment du prix affiché.
La cinquième partie couvre cette thèse en détail.
Ce qui compte ici est l’ordre des vidéos : tests multi-fournisseurs d’abord, puis thèse tarifaire expliquant leur utilité, une séquence qui ressemble moins à une réaction à chaud qu’à la constitution d’un dossier sur trois semaines.
Onze jours plus tard, le 22 juillet, il bouclait le sujet par une distinction que la plupart des équipes négligent.
Il décrivait les offres Free, Pro et Max de Claude comme relevant d’un type de contrat, et API, Console, Team et Enterprise d’un contrat commercial distinct (cet article n’a pas vérifié les conditions d’Anthropic face à sa description).
« You don’t really get a choice on price. What you actually get is a choice of legal framework »2 (traduction fidèle : « Vous n’avez pas vraiment le choix du prix. Vous avez plutôt le choix du cadre juridique »), disait-il, avant de nommer ce qui change selon le contrat plutôt que la facture : selon lui, les deux textes protègent différemment les intérêts du client et apportent des garanties différentes sur les données.
Dans sa conception, la gouvernance commence à la page de signature avant d’atteindre la grille tarifaire.
Le secours souverain
Tester les alternatives est une couche de protection.
Martignole en garde une deuxième qui n’apparaît jamais dans une vidéo de benchmark.
Dans un entretien du 24 juillet 2026 avec Prompt Humain, il décrivait le véritable plan de repli de Back Market si l’accès à Anthropic était coupé ou si les prix dépassaient ce que l’équipe pouvait absorber : « with a €25,000 server and a Chinese open-weight model, we’re seriously considering self-hosting in case access gets cut »3. Traduction fidèle : « Avec un serveur à 25 000 € et un modèle chinois à poids ouverts, nous envisageons sérieusement l’auto-hébergement en cas de coupure d’accès. »
Pour quelques squads, c’est une assurance raisonnable contre un point de défaillance unique ; pour une organisation d’ingénierie d’environ 300 personnes, c’est sous-dimensionné, comme l’argumente la section suivante.
Le même entretien retrace le passage antérieur de Claude Code seul à Open Code avec OpenRouter, pour la même raison déclarée : répartir la facture de modèles entre plusieurs fournisseurs avant qu’une migration forcée ne soit la seule option.
Cette installation utilise des clés API, pas des identifiants d’abonnement Claude, dont la page juridique et de conformité d’Anthropic interdit le routage par des développeurs tiers via les offres Free, Pro ou Max.
Les conditions fournisseurs ont bougé en 2026. Depuis le 7 octobre, Max, Ultra et Team incluent des crédits API mensuels. Ils couvrent l’Agent SDK et claude -p avec une clé de l’organisation Console Claude liée au compte. Avec une connexion par abonnement, ces usages restent imputés au quota. Conditions Anthropic
La hausse de Sonnet 5 prévue en septembre a été annulée. Pour un nouveau budget, la partie 5 donne un exemple de calcul API et la partie 1 indique comment relever les limites Codex du compte.
Le marché voyait le même risque depuis l’orbite
Bloomberg couvre cette peur sous un autre angle, pièces datées du 27 janvier 2025 à l’appui.
L’action Nvidia a chuté de 17 % en une séance après que R1 de DeepSeek a semé le doute sur la quantité de calcul réellement nécessaire à l’IA de pointe, effaçant 589 milliards de dollars de capitalisation, plus du double du précédent record quotidien de 279 milliards établi par Nvidia en septembre précédent.
Bloomberg, Reuters et le WSJ convergent entre 589 et 593 milliards de dollars et l’ont présenté comme la plus grande perte journalière de capitalisation de l’histoire boursière américaine à cette date.
Une brève Bloomberg du jour notait que l’investisseur Marc Andreessen parlait déjà de « Sputnik moment » de l’IA (traduction : « moment Spoutnik »). La partie 8 revient sur ce mouvement de 589 milliards face aux investissements en gigawatts auxquels il réagissait.
Le chiffre censé avoir déclenché la panique nécessite une réserve. Le rapport technique de DeepSeek cite bien 5,576 millions de dollars pour l’entraînement final de V3, un vrai chiffre régulièrement appliqué à tort dans les titres.
La distillation de R1, le matériel, les chercheurs et les expérimentations antérieures sont tous hors de ce montant.
TechCrunch et CNBC signalaient cette lacune quelques jours après la chute ; SemiAnalysis est allé plus loin, estimant les dépenses d’investissement réelles de DeepSeek plus proches de 1,6 milliard de dollars.
Le chiffre boursier tient : Nvidia a perdu au moins 589 milliards en une journée. Le coût d’entraînement censé l’expliquer reste contesté : le citer sans réserve déforme donc ce qui est connu.
Quelle taille pour le secours
- 25 000 € achètent environ une station RTX PRO 6000 (médiane eBay de 19 500 USD au 30 septembre 2026 selon vramglass, un prix de place de marché). Cela permet de faire tourner quelques sessions à contexte long, ou environ 10 à 20 à contexte court avec de plus petits modèles : quelques squads.
- 30 à 90 sessions simultanées nécessitent un nœud de classe 8xH100 ou 8xB200. Louer 8xH100 chez CoreWeave coûte 6,16 USD/GPU-h (computeprices.com, 28 septembre 2026), environ 8 700 USD/mois à 8 h x 22 jours. Je n’ai pas de prix d’achat sourcé pour un tel nœud.
- Un Hetzner GEX131 (RTX PRO 6000) coûte environ 890 EUR/mois (blog Qovery).
Je construirais sur ce schéma : repli API entre plusieurs fournisseurs, niveau sur site pour les travaux prioritaires (incidents, sécurité, releases) et exercices de bascule, comme le font déjà les équipes sécurité et infrastructure.
Deux réserves. Les nombres de sessions par nœud sont des extrapolations Perplexity, pas des mesures. Certaines sources sont faibles : un benchmark Llama 4 Maverick d’avril 2025, des prix de place de marché, et la recherche présente Qwen2.5-Coder comme actuel.
Même règle, plus grande échelle
La règle de Martignole dépasse une équipe d’ingénierie. Une conférence Devoxx 2026 sur une plateforme souveraine de modèles à la demande, donnée par un architecte solutions en ingénierie de plateforme IA, expose la version entreprise : couche d’abstraction et passerelle devant les modèles, modèles sous-jacents interchangeables et indépendance fournisseur comme exigence dès le départ.
« You can’t be 100% independent, but try to be as independent as possible » (traduction fidèle : « Vous ne pouvez pas être indépendant à 100 %, mais essayez de l’être autant que possible »), conseille la conclusion, autour d’une discipline de gouvernance, tout surveiller, et d’une discipline architecturale, garder le contrat avec le modèle distinct du modèle lui-même.
L’administration numérique française applique une version publique du même schéma.
Arnaud Robin, Chief Product Officer de LaSuite à la DINUM, la direction numérique de l’État français, décrivait le projet d’infrastructure IA du pays dans une conférence d’avril 2026 : un « cloud de confiance », souverain, exécutant une inférence GPU mutualisée qui héberge plusieurs LLM et permet à toute administration de construire sur cette base partagée plutôt que dépendre d’un fournisseur externe unique.
Il décrivait la mission face caméra : la DINUM existe pour rendre l’État « more efficient, simpler, and above all more sovereign » grâce aux outils numériques4 (traduction fidèle : « plus efficace, plus simple et surtout plus souverain »), avec la souveraineté citée en dernier et mise le plus en avant.
L’histoire de Novibet montre ce qui arrive lorsque ce choix cesse d’être facultatif.
La plateforme de jeux d’argent opérait en Europe depuis un seul data center jusqu’à ce que des règles nationales commencent à imposer que les données des utilisateurs restent dans leur pays, ce qu’aucun data center européen unique ne pouvait satisfaire.
Un seul data center pour plusieurs pays concentrait aussi le risque autrement : un incident réseau ou une panne cloud aurait touché tous les utilisateurs de tous les marchés à la fois.
Novibet a reconstruit une architecture multi-datacenter, gardant un centre de trading centralisé et répartissant les opérations régionales entre pays, transformant contrainte de conformité et manque de résilience en une migration plutôt que deux.
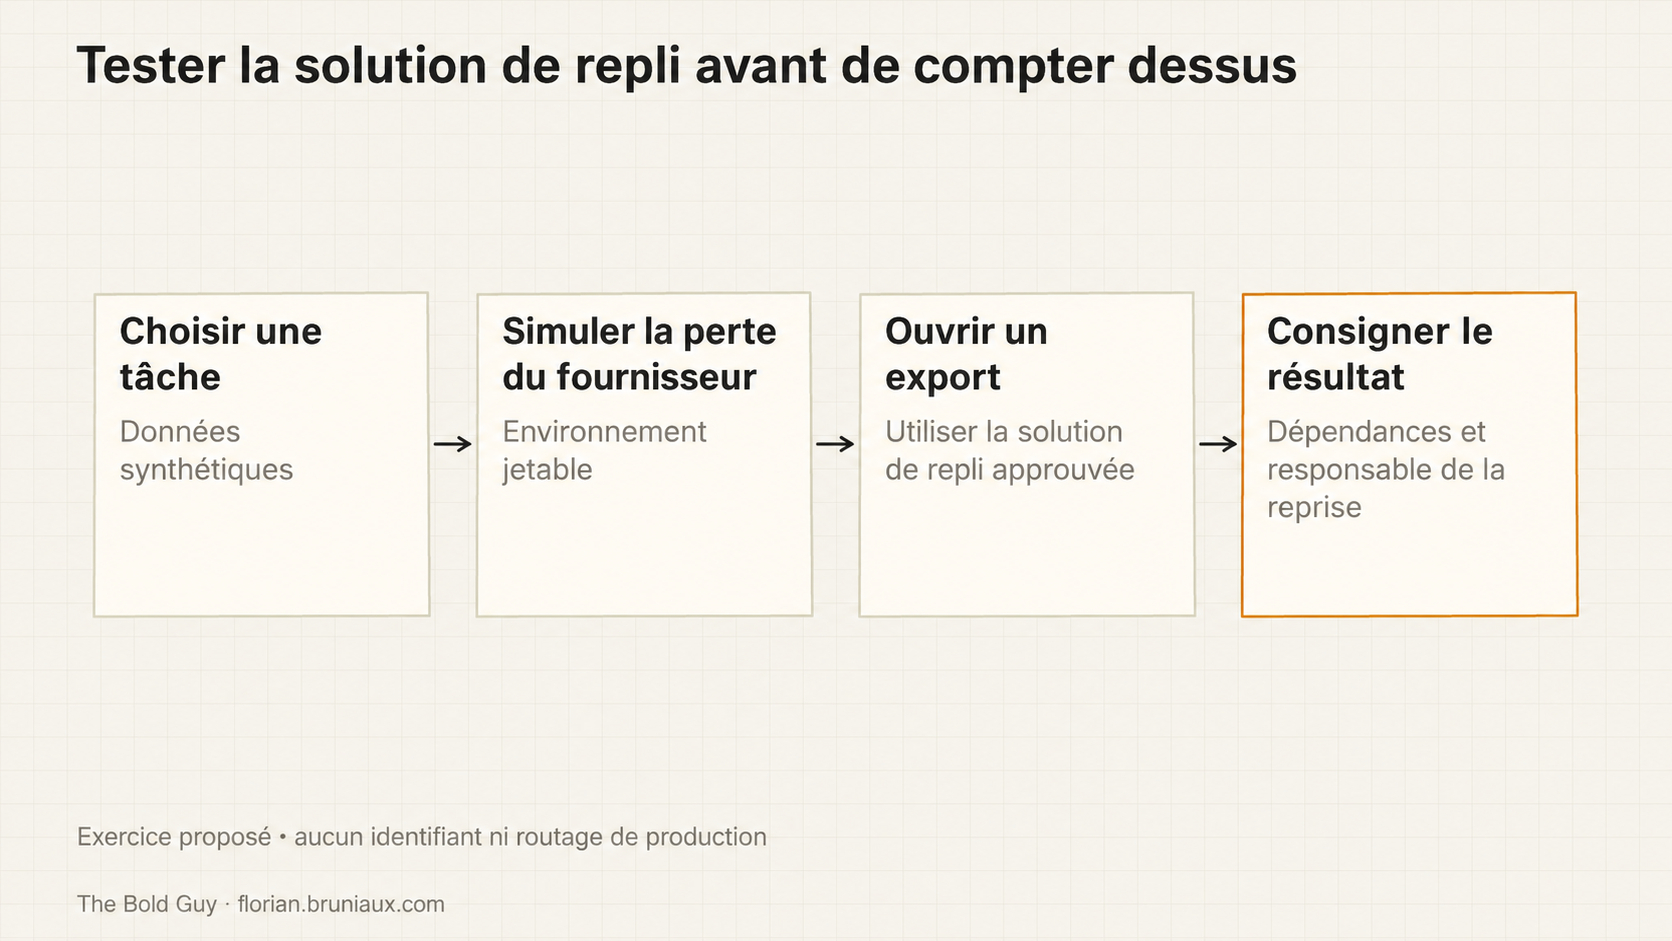
Tester les dépendances derrière le repli
Le chapitre IFTTD sur la souveraineté (archivé le 13 septembre 2026) reformule une partie de la question autour de l’accès continu aux données. Posséder un serveur ou un export ne suffit pas si son ouverture nécessite encore un fournisseur d’identité, un service de clés ou un outil propriétaire indisponible.
Choisissez une tâche représentative et des données synthétiques. Dans un environnement jetable, simulez la perte du fournisseur choisi, ouvrez un export et tentez la tâche via le repli approuvé.
Consignez les dépendances d’authentification, de modèle, de format et d’outils, le comportement dégradé et la responsabilité de reprise. Gardez identifiants et routage de production hors de l’exercice.
Distinguez le changement d’hébergeur et le remplacement du modèle : un autre endpoint du même modèle peut réduire une dépendance en en conservant une autre.
Un repli fonctionnel pour une tâche n’établit pas une indépendance fournisseur générale. Le livrable utile est un périmètre testé avec les dépendances restantes, pas une étiquette de souveraineté.
Live AIDD : garder certaines opérations utilisables sans modèle
À 1:12:00 du live AIDD du 16 octobre 2026, je décris comment je demande à l’agent d’écrire des outils Python et shell, puis lui apprends à utiliser le même CLI que je peux exécuter moi-même. Je présente un repli en cas de panne Claude : exécuter directement une opération et retransmettre sa sortie quand l’agent revient. Le triage d’erreurs Sentry est mon exemple.
Ce repli dépend du fonctionnement de l’outil choisi sans le fournisseur indisponible. Le live décrit mes outils et une voie de reprise proposée, sans exercice de panne ni mesure du délai de reprise. Le guide du code au merge couvre leur réutilisation avec la mémoire de session. Ce retour vient du live AIDD, distinct de la conférence Dev With AI du 12 octobre, avec sous-titres automatiques et quelques minutes d’ouverture manquantes.
Deux vues du même risque
Une analyse croisée du catalogue Bloomberg et du témoignage de Martignole montre l’écart : sur près de 800 récapitulatifs tech Bloomberg, 68 couvrent la souveraineté, les contrôles d’exportation de puces et la montée des modèles chinois, sous l’angle du capital et de la géopolitique.
Martignole couvre le même risque depuis une organisation d’ingénierie de 320 personnes, où il apparaît comme une vidéo de benchmark, une clause contractuelle et un serveur à 25 000 € que personne n’espère brancher. Il a cadré la bataille en termes culturels et économiques après avoir exclu les explications techniques et générationnelles.5
Bloomberg fournit la vue à l’échelle des marchés ; Martignole, celle d’une organisation d’ingénierie.
YSNK
(Ce que vous devriez maintenant savoir)
- La règle de Martignole énoncée face caméra : impossible de dépendre seulement d’Anthropic et Claude Code, car le risque de concentration dépasse la valeur quand le prix bouge
- Il l’a testée publiquement sur trois semaines : benchmark multi-fournisseurs OpenRouter, thèse du prix par token expliquant l’utilité des tests, puis distinction juridique entre contrats Claude Max et API
- Son véritable repli est un serveur auto-hébergé à 25 000 € exécutant un modèle chinois à poids ouverts, gardé en cas de coupure Anthropic. Je le trouve sous-dimensionné pour environ 300 développeurs : il couvre quelques squads
- Le marché a chiffré un risque lié à une autre échelle : la sortie de R1 de DeepSeek a effacé 589 milliards de dollars de capitalisation Nvidia en une séance, une perte présentée comme la plus grande perte journalière de l’histoire boursière américaine à cette date
- La même règle dépasse une équipe : la DINUM exploite un cloud souverain multi-modèles, et Novibet a dû reconstruire en multi-datacenter lorsque son infrastructure à fournisseur et lieu uniques a rencontré les règles de résidence des données
Footnotes
-
Français original, avec l’erreur de sous-titrage « Cloud Code » corrigée en « Claude Code » : « Le secret c’est quoi ? Vous pouvez pas être dépendant uniquement d’Anthropic et de Claude Code. Vous prenez un risque trop important et les prix par rapport à la valeur qui est générée sont beaucoup trop excessifs ». Nicolas Martignole, 2 juillet 2026. ↩
-
Français original : « Vous n’avez pas vraiment un choix de prix. En fait, c’est plus un choix de cadre juridique ». Nicolas Martignole, 22 juillet 2026. ↩
-
Français original : « avec un serveur à 25 000 euros et un modèle chinois open weight, on envisage sérieusement de s’auto-héberger en cas de coupure d’accès ». Nicolas Martignole, entretien avec Prompt Humain, 24 juillet 2026. ↩
-
Français original : « plus efficace, plus simple et surtout plus souverain ». Arnaud Robin, DINUM, avril 2026. ↩
-
Français original : « la vraie bataille n’est ni technique, ni générationnelle, mais culturelle et économique ». Nicolas Martignole. ↩
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source