Productivité du développement avec IA : pourquoi un gain ne suffit pas pour vos prévisions
Une conférence de recherche de Stanford, des estimations de DX et deux études de terrain mesurent des formes différentes de production de code avec IA. Aucune ne fournit de prévision budgétaire universelle.
Aller au résumé ↓ Florian Bruniaux
The Real Cost of AI · Partie 3/9
TL;DR
Le code assisté par IA peut être rentable, mais 20 à 30 % n’est pas une prévision par défaut pour un business case. Cette fourchette vient du témoignage d’un praticien de DX ; Yegor Denisov-Blanch a présenté une estimation nette de 15 à 20 % après reprises dans une conférence de recherche. Deux études de terrain de 2026 ont mesuré davantage de pull requests mergées dans des conditions de déploiement particulières, sans mesurer la valeur de ces modifications. Le budget d’un CTO exige une mesure de référence locale, le coût total d’acceptation et un résultat produit visé.
| Affirmation | Chiffre | Source |
|---|---|---|
| Estimation de productivité nette après reprises | 15 à 20 % | Conférence de recherche de Yegor Denisov-Blanch en 2025, qui décrit un programme couvrant plus de 100 000 ingénieurs et un pilote distinct d’environ 120 développeurs ; aucune méthode complète pour l’estimation principale n’est fournie ici |
| Gain apparent de production avant reprises | 30 à 40 % | Même conférence ; ce n’est pas une mesure de valeur produit |
| Estimation de vélocité d’un praticien | 20 à 30 % ; Intercom a rapporté 41 % d’économies de temps développeur liées à l’IA en plus | Justin Reock, DX, août 2025 ; la mesure d’Intercom a un autre dénominateur |
| Évolution des PR mergées après adoption d’agents CLI | Environ 24 % de plus chez les utilisateurs ayant adopté ces agents | Murphy-Hill et al., déploiement Microsoft ; les PR mergées sont un indicateur indirect de production, pas de valeur livrée |
| Débit de PR mergées et charge de review dans une entreprise | 2,09 fois le niveau de PR avant la consigne ; environ deux fois la charge par reviewer | He et al., étude de cas en entreprise ; adoption non randomisée et pas d’attribution causale exacte |
| Taux de merge des PR générées par IA contre humaines | 60 % contre 80 % | Nick Arcolano, Head of AI & Research chez Jellyfish, 250 000 développeurs suivis, juin 2026 |
| « 2x requests might mean 2x bugs » (traduction : « 2 fois plus de demandes pourraient signifier 2 fois plus de bugs ») | Avertissement indépendant, même conclusion | Thomas Bentkowski, Product Manager chez Doctolib, septembre 2025 |
| Cas bas, review insuffisante | Reprises rapportées, aucun chiffre net donné | Max Sumrall, Software Engineer chez Picnic, Devoxx, avril 2026 |
| Cas haut 1 : PR entièrement autonomes | 1 300 par semaine selon le chiffre rapporté à l’époque, review humaine toujours obligatoire | Steve Kaliski, Stripe, corroboré sur stripe.dev, à Stripe Sessions 2026 et dans le podcast How I AI |
| Cas haut 2 : bond du débit d’une équipe | De 3,5 à 70 PR par ingénieur et par semaine, de GPT-5.2 à GPT-5.5 (famille GPT-6 non couverte) | Ryan Lopopolo, Member of Technical Staff chez OpenAI, témoignage de juin 2026, « on my team » (traduction : « dans mon équipe ») |
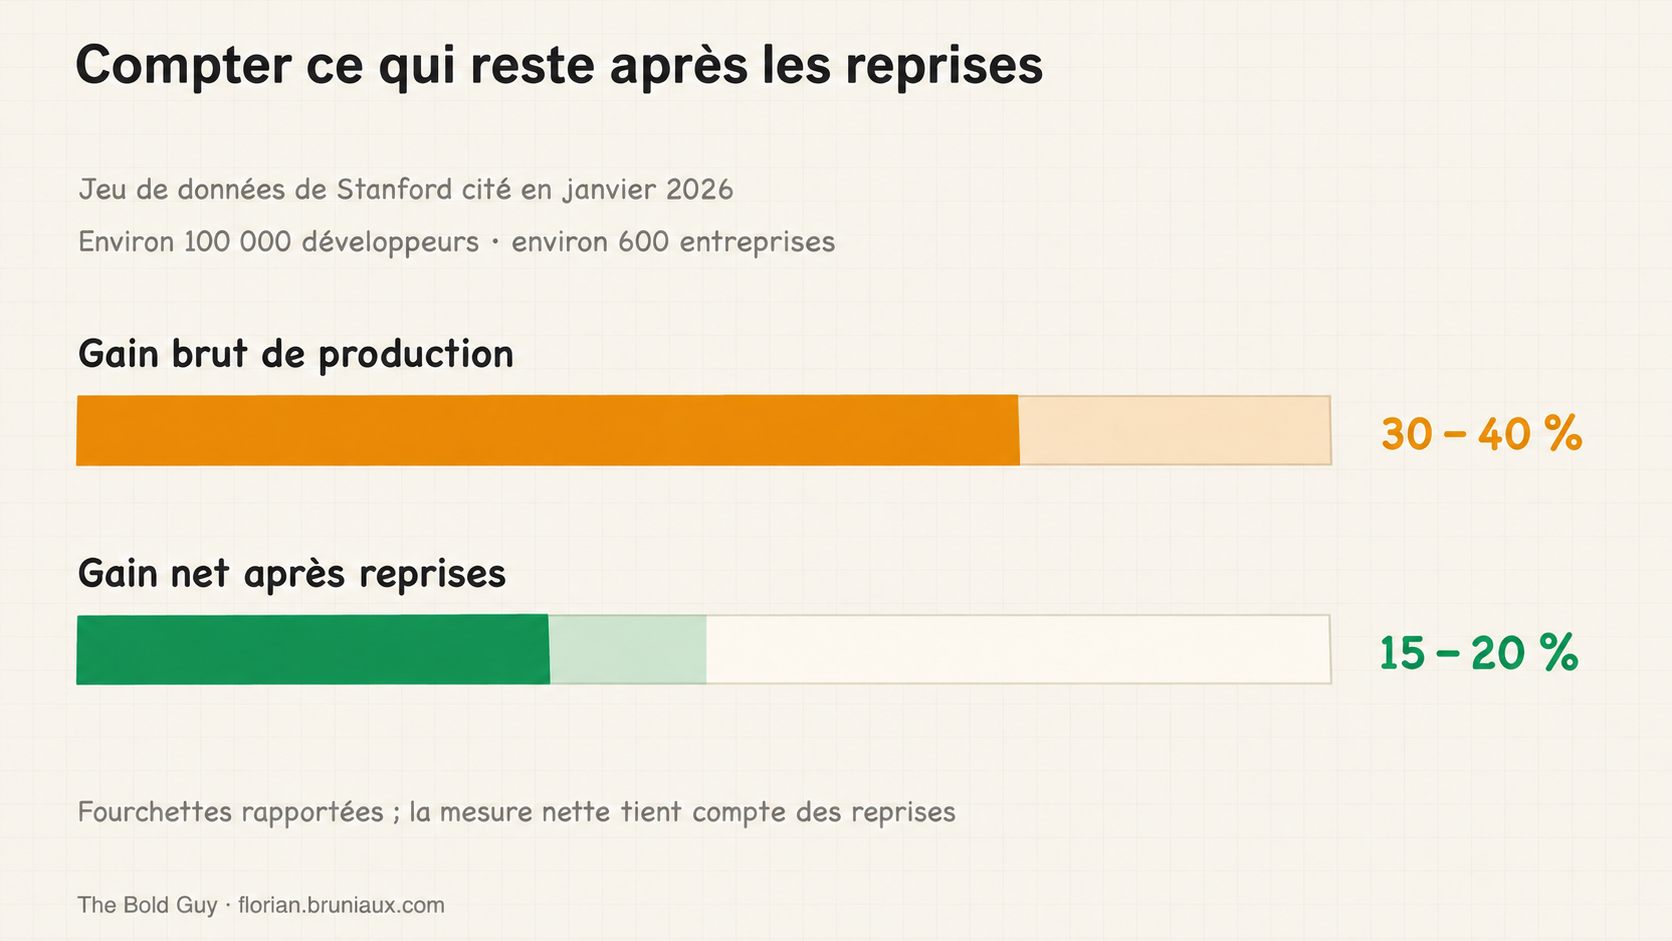
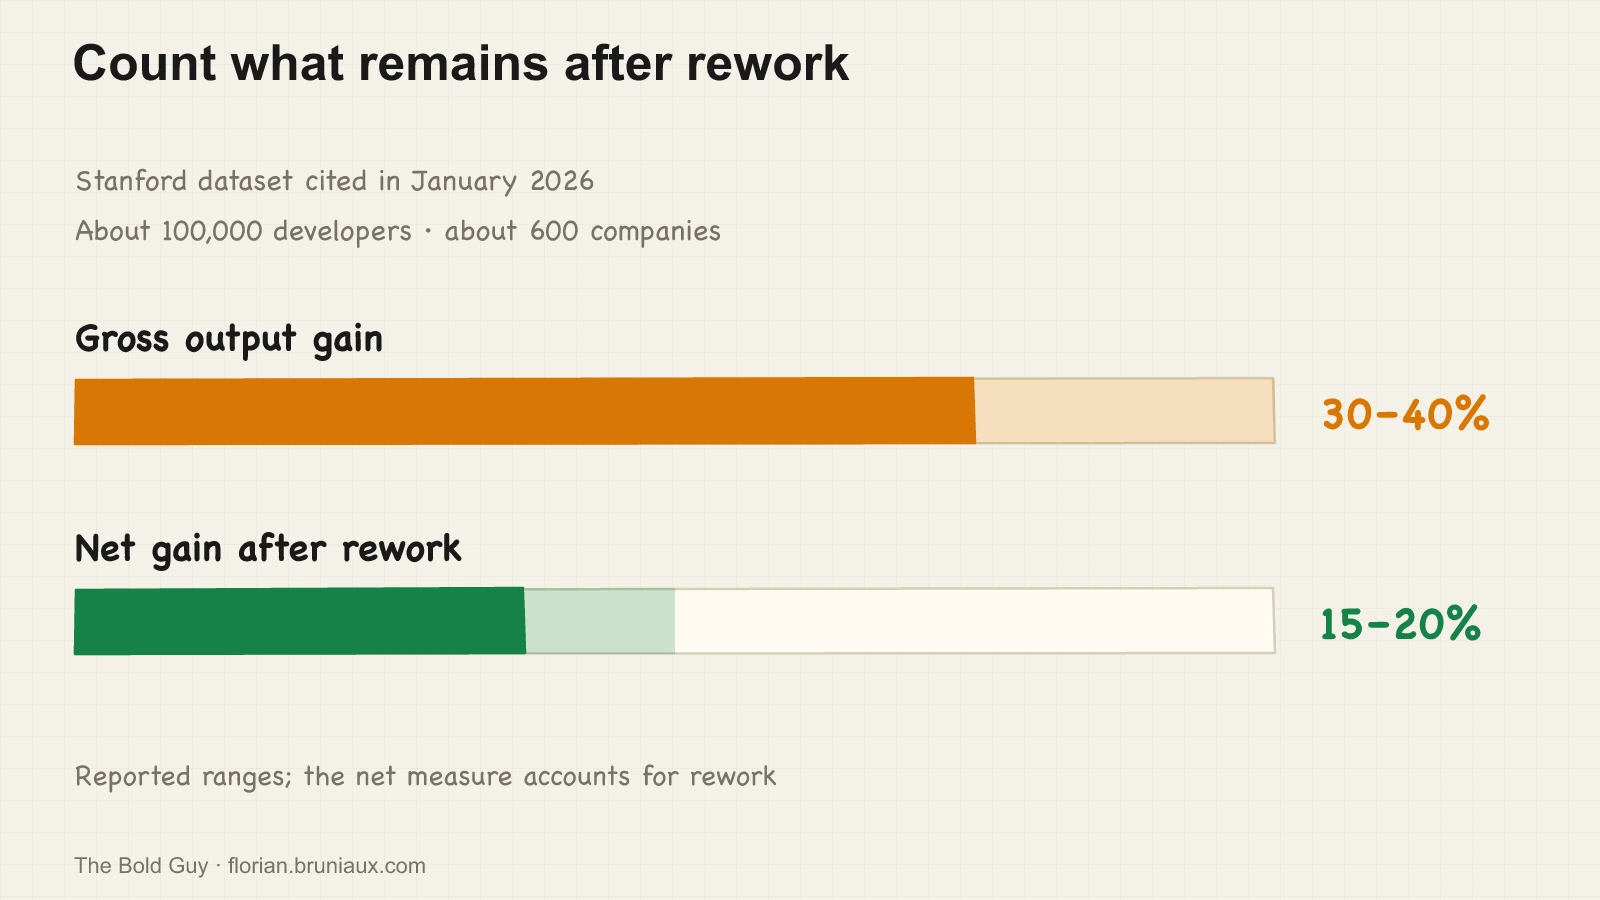
Dans une conférence de recherche de 2025, Yegor Denisov-Blanch a décrit des données Git longitudinales couvrant plus de 100 000 ingénieurs dans plus de 600 entreprises. Il a utilisé un pilote distinct d’environ 120 développeurs pour montrer pourquoi la production ajoutée et les reprises sur le code récent doivent être comptées séparément. Sa présentation donnait un gain apparent de production de 30 à 40 % et une estimation agrégée de 15 à 20 % après reprises.
La conférence rend la distinction de mesure visible, mais ne publie pas de protocole d’étude complet permettant de reconstruire l’estimation principale. Ces chiffres doivent être attribués à la présentation de l’intervenant, pas transformés en rendement contrôlé et transférable à toute équipe. La recherche porte sur l’activité visible dans Git ; elle ne peut pas, à elle seule, établir la valeur client.
DX décrit une autre mesure, pas une seconde estimation du même résultat
Dans une conversation d’août 2025, Justin Reock, Deputy CTO chez DX, a chiffré ce qu’il observe chez les clients : « more realistically, looking at numbers like 20, 25, 30% increases in velocity, I think is a good number, and it’s certainly making an impact. » Traduction : « De façon plus réaliste, des chiffres comme 20, 25, 30 % d’augmentation de vélocité me semblent être de bons chiffres, et cela a certainement un effet. »
Il a nettement écarté les chiffres plus élevés. « It’s not the 100x improvements », a-t-il dit. Traduction : « Ce ne sont pas des améliorations d’un facteur 100. » « That’s a lot of information that’s very good for creating YouTube subscribers and upvotes, but not necessarily increased productivity for organizations. » Traduction : « Ce sont beaucoup d’informations très utiles pour gagner des abonnés YouTube et des votes positifs, mais pas nécessairement pour augmenter la productivité des organisations. »
Un client a largement dépassé cette fourchette. Les données publiques de DX montrent qu’Intercom a obtenu une hausse de 41 % des économies de temps développeur liées à l’IA, que Reock a qualifiée de résultat atypique plutôt que typique.
Ces chiffres ne confirment pas indépendamment l’estimation de Stanford. Reock parle de vélocité, tandis que les 41 % d’Intercom concernent les économies de temps développeur liées à l’IA. Aucun ne fournit une distribution générale de résultats nets pour l’entreprise. Avant d’utiliser 20 à 30 % dans un budget, une équipe doit définir quelle mesure s’améliorerait, comment compter les reprises et quel résultat produit justifierait la dépense.
Deux études de terrain comptent les pull requests mergées
Murphy-Hill et ses collègues ont étudié le déploiement de Claude Code et GitHub Copilot CLI chez Microsoft début 2026, auprès de dizaines de milliers d’ingénieurs. Leur analyse associe l’adoption à environ 24 % de pull requests mergées en plus par rapport à ce que les utilisateurs concernés auraient mergé sans cette adoption sur la fenêtre d’observation de quatre mois. Les auteurs présentent les PR mergées comme un indicateur indirect de production et les distinguent explicitement de la valeur livrée par ces PR.
Une seconde étude longitudinale suit une entreprise très engagée dans l’IA lors d’une consigne imposant de doubler les PR mergées par ingénieur. Dans un panel de 802 développeurs et 196 212 PR, le débit par personne a atteint 2,09 fois son niveau antérieur à cette consigne en avril 2026. La charge par reviewer a environ doublé et la review automatisée a dépassé la review humaine ; les taux de merge et de revert sont restés stables. L’adoption n’étant pas attribuée aléatoirement, les auteurs n’imputent pas tout ce changement à l’IA. Des taux de merge et de revert stables laissent aussi la valeur produit et la maintenance à plus long terme non mesurées.
Les deux études établissent que davantage de PR peuvent être mergées dans ces contextes. Elles ne convertissent pas le débit de PR en pourcentage de productivité nette comparable à l’estimation de Denisov-Blanch, et aucune ne peut déterminer le budget d’une équipe à partir de son chiffre principal. La mesure suivante relève du service et du produit : effort de review, corrections, stabilité opérationnelle et résultat utilisateur visé.
Là où le volume induit en erreur
Nick Arcolano, Head of AI & Research chez Jellyfish, dispose d’un jeu de données qui suit 250 000 développeurs du secteur. Dans une conversation de juin 2026, il a décrit un mécanisme d’échec qui aide à comprendre pourquoi le volume surestime la production : les pull requests générées par IA sont mergées à un taux inférieur à celles écrites par des humains.
« The average for Q1 for humans was about 80% of pull requests that were open ultimately got merged », a-t-il dit. Traduction : « Au premier trimestre, en moyenne, environ 80 % des pull requests ouvertes par des humains finissaient par être mergées. » « What we see with agentic PRs is 60/40 instead of 80/20. So you’re talking about double the amount of PRs that are kind of dying on the vine. » Traduction : « Avec les PR agentiques, nous observons 60/40 au lieu de 80/20. Cela signifie donc deux fois plus de PR qui, en quelque sorte, restent en plan. »
Deux fois plus de code ne se traduit pas par deux fois plus de production livrée quand une part beaucoup plus grande de ce volume ne passe jamais la review.
Une autre équipe était arrivée à la même conclusion par le chemin inverse, neuf mois plus tôt, sans lien avec les données de Jellyfish. Thomas Bentkowski, Product Manager chez Doctolib, décrivait la métrique interne de son équipe en septembre 2025 : « if we are producing twice as many requests compared to three months ago, it means that we double our productivity, right? Well, no, because we might as well have doubled the number of bugs as well. So doubling the number of requests alone doesn’t mean anything. » Traduction : « Si nous produisons deux fois plus de demandes qu’il y a trois mois, cela signifie que nous doublons notre productivité, non ? Eh bien non, parce que nous pourrions tout aussi bien avoir doublé le nombre de bugs. Donc doubler le nombre de demandes, à lui seul, ne signifie rien. »
Les données d’un fournisseur et le témoignage d’un product manager portent le même avertissement depuis des positions différentes. Le volume brut de demandes est une métrique de vanité tant que personne ne vérifie ce qu’il devient en aval.
L’équipe de Bentkowski fait l’objet de la vérification la plus poussée de cette série sur une seule entreprise : la partie 7 suit le déploiement de Doctolib de 30 à 600 à travers deux conférences qui se corroborent (quatre conférences Doctolib au total), puis le distingue de trois autres initiatives Doctolib documentées ailleurs.
Le cas bas, quand personne ne vérifie
Le volume sans review suffisante a un cas bas rapporté. À Devoxx, Max Sumrall, ingénieur logiciel chez Picnic, a décrit en avril 2026 ce qui s’est passé quand son équipe a laissé partir du code généré par IA sans examen suffisant : « the code is shipped and then it needs to be touched again and again and again to actually make it work. » Traduction : « Le code est livré, puis il faut y retoucher encore et encore et encore pour qu’il fonctionne réellement. »
Sumrall décrit le même type de coût de reprise que mesure l’étude de Stanford, sans rapporter de chiffre net.
Le témoignage de Picnic montre un mécanisme possible de reprises, pas la position de l’équipe par rapport à l’estimation de 15 à 20 %. L’intervenant rapporte des corrections répétées mais aucun chiffre comparable de productivité nette. Le récit n’isole pas la qualité du modèle des pratiques de review.
Les deux chiffres qui ne vont pas sur le même graphique que les autres
Deux chiffres issus du même ensemble de témoignages dépassent largement 15 à 20 %, et tous deux sont cités comme s’ils représentaient la norme plutôt que l’extrême.
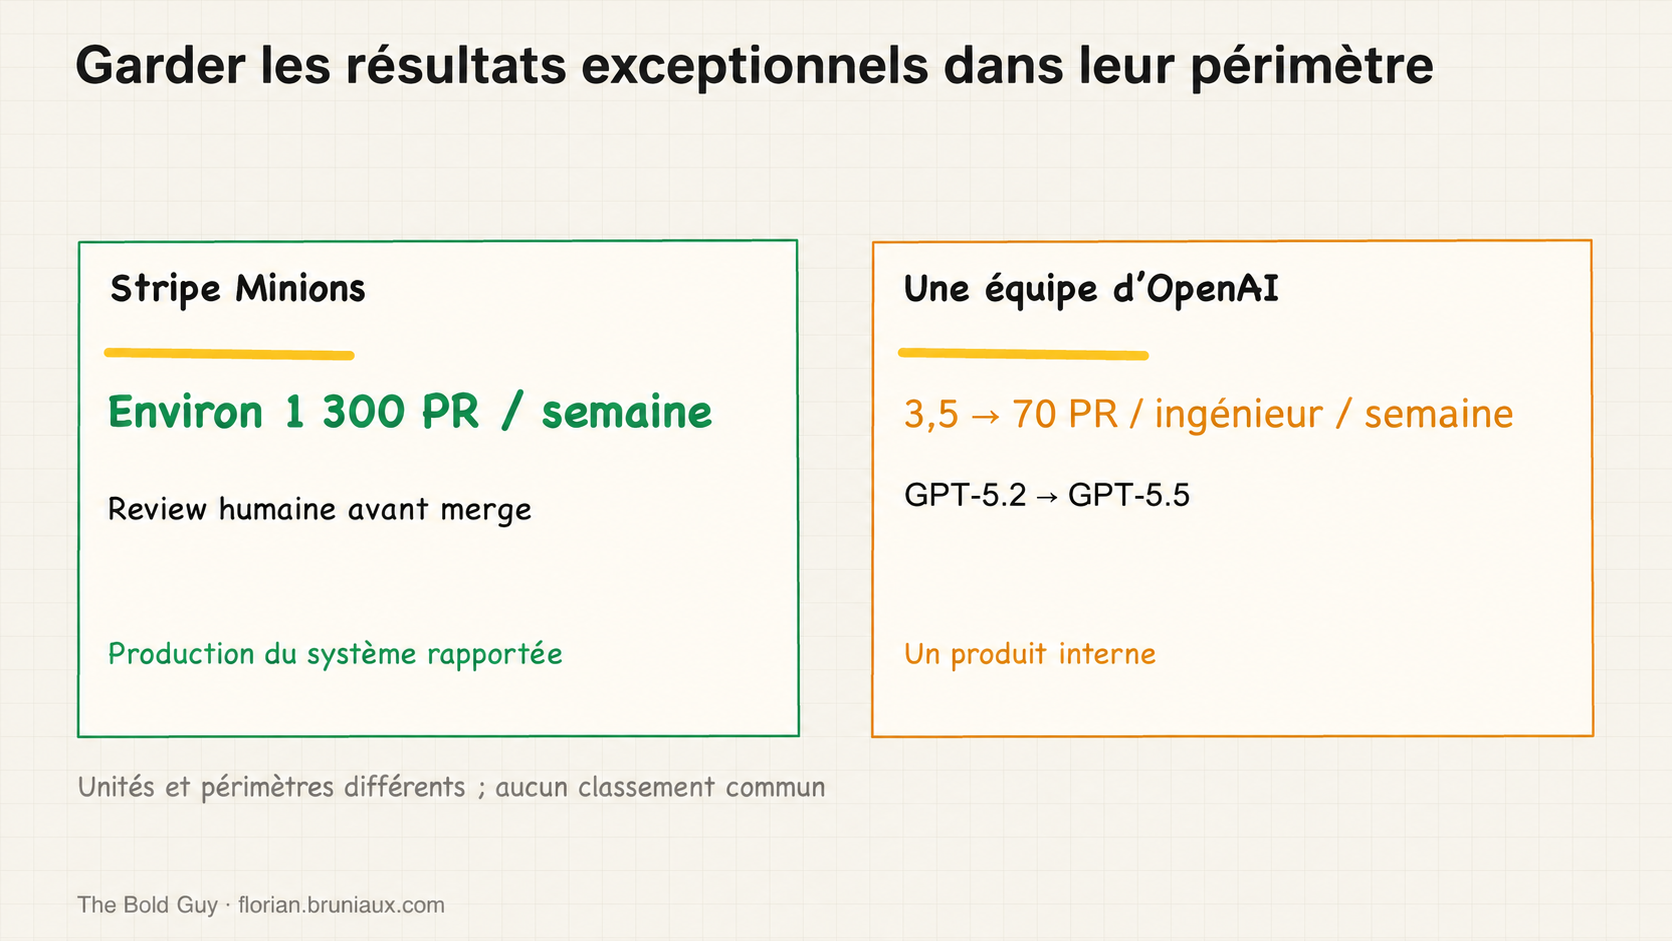
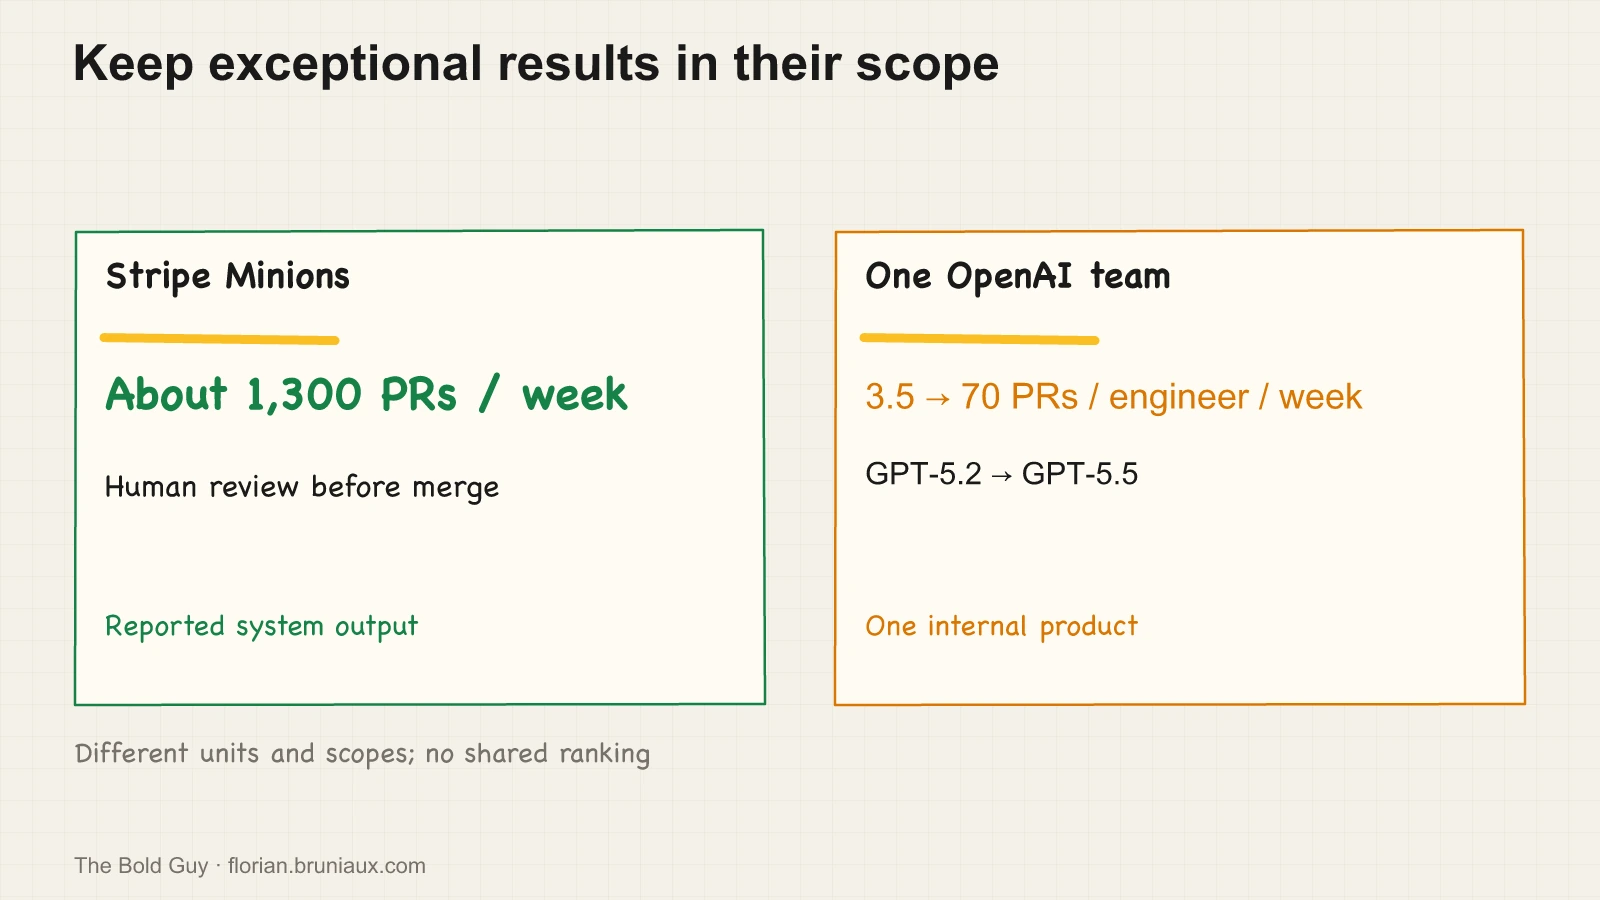
L’agent de développement interne de Stripe, appelé Minions, générait, selon les chiffres rapportés à l’époque, environ 1 300 pull requests par semaine sans qu’un humain écrive le code, selon Steve Kaliski, ingénieur chez Stripe qui a décrit le système à trois occasions distinctes : le blog d’ingénierie de Stripe, une keynote à Stripe Sessions 2026 et un épisode du podcast How I AI.
Les trois convergent vers le même chiffre et la même réserve : les humains cessent d’écrire le code, mais la review humaine avant merge reste obligatoire.
Ce que Stripe revendique est plus restreint que l’autonomie : une phase de développement sans frappe humaine, suivie d’une phase de review qui n’a pas disparu.
Le second chiffre vient d’une équipe précise d’OpenAI. Ryan Lopopolo, Member of Technical Staff chez OpenAI associé au terme « harness engineering », a décrit la trajectoire de son équipe dans une conversation de juin 2026 : « at the beginning of sort of the 5.2 era, we were looking at maybe three and a half PRs per engineer per week on my team. Now with 5.5, we’re looking at 70. » Traduction : « Au début de ce qu’on pourrait appeler l’ère 5.2, nous étions peut-être à trois PR et demie par ingénieur et par semaine dans mon équipe. Maintenant, avec 5.5, nous sommes à 70. »
Ce bond est explicitement rattaché à une équipe qui construit un produit interne, suivie sur deux générations de modèles.
Le témoignage nomme GPT-5.2 et GPT-5.5 et ne couvre aucun modèle ultérieur. La documentation tarifaire d’OpenAI vérifiée le 15 octobre 2026 indique que GPT-5.5 a été retiré de Codex avec connexion ChatGPT le 14 octobre ; les sessions avec clé API ne sont pas affectées. Le témoignage de juin reste une preuve historique, pas une recommandation actuelle de modèle. Il n’isole pas non plus l’effet du changement de modèle des évolutions du harnais et du workflow.
Il dit quelque chose de réel sur ce que le harness engineering peut produire dans un environnement précis et délibérément instrumenté. Il ne dit rien sur ce qu’un ingénieur moyen d’OpenAI, ou de toute autre entreprise, devrait s’attendre à voir sur son tableau de bord au trimestre suivant.
Les deux chiffres sont vrais dans leur périmètre, et tous deux le perdent à force d’être répétés sur scène, jusqu’à ce que « one OpenAI team going from 3.5 to 70 PRs a week » (traduction : « une équipe d’OpenAI passe de 3,5 à 70 PR par semaine ») devienne discrètement « OpenAI is 20x more productive now » (traduction : « OpenAI est désormais 20 fois plus productif »).
Un troisième cas est arrivé en septembre 2026 avec la même forme et une différence à conserver. Dans un retour d’ingénierie sur sa propre charge de CI, Anthropic rapporte que ses ingénieurs « on average ship 8x as much code per quarter as they did from 2021-2025 » et que « Claude authors 80% of that code and it also plays a large role in reviewing and approving PRs as well ». Traduction : « livrent en moyenne 8 fois plus de code par trimestre qu’entre 2021 et 2025 » et « Claude écrit 80 % de ce code et joue aussi un rôle important dans la review et l’approbation des PR ».
La différence est que la chose mesurée est le volume de code, et Anthropic le dit au lieu de laisser le lecteur en déduire une productivité.
Addy Osmani, à propos des mêmes chiffres, conserve la réserve qui disparaît généralement à la troisième répétition : « Lines of code isn’t (of course) a direct measure of value. » Traduction : « Les lignes de code ne sont (bien sûr) pas une mesure directe de la valeur. »
Une mesure honnête du volume reste une mesure de volume. Elle va aux côtés des 1 300 pull requests hebdomadaires de Stripe (selon le chiffre rapporté à l’époque), pas à côté d’un taux de merge ou d’un gain net.
L’écart qui prépare la question suivante
Comparons les registres. Denisov-Blanch a présenté une estimation agrégée de 15 à 20 % après reprises. DX a décrit une fourchette de vélocité de 20 à 30 %. Microsoft a mesuré environ 24 % de PR mergées en plus chez les utilisateurs ayant adopté les agents CLI, tandis qu’une entreprise de l’étude sur la consigne de doublement a atteint 2,09 fois son débit antérieur de PR avec environ deux fois la charge de review. Ces mesures ont des populations et des dénominateurs différents ; aucune n’est un rendement observé sur le budget d’une nouvelle équipe.
Les extrêmes propres à chaque cas sont les 1 300 pull requests autonomes par semaine de Stripe (selon le chiffre rapporté à l’époque) et le bond d’un facteur 20 d’une équipe OpenAI instrumentée, de 3,5 à 70 pull requests par ingénieur et par semaine.
Aucun de ces chiffres n’est faux. Tous deux servent pourtant, dès maintenant, à décider du budget d’un déploiement de code assisté par IA dans des entreprises.
La partie 1 de cette série suivait le coût d’exécution d’un agent une fois que le volume apparaît. La partie 2 montrait pourquoi presque personne ne peut chiffrer de façon vérifiée le retour de cette dépense.
Pour le business case d’un CTO, partez de la référence de l’équipe et d’un pilote borné. Comptez le coût complet du travail accepté, y compris les tentatives abandonnées, la review et les reprises, puis observez un résultat prédéfini au niveau du service ou de l’utilisateur. Les chiffres externes aident à choisir quoi mesurer et où chercher une contrainte ; ils ne peuvent pas fournir le résultat de cette comparaison locale.
La vélocité de l’IA est bidirectionnelle traite le problème jumeau côté livraison : livrer plus vite et accumuler de la dette plus vite dans le même mouvement.
La partie suivante aborde le FinOps : qui est responsable du budget de code assisté par IA, et comment les décisions de routage sont testées par rapport à ce budget.
YSNK
(Vous devriez maintenant savoir)
- La conférence de recherche de Stanford présente une estimation agrégée de 15 à 20 % après reprises, mais ne fournit pas ici de protocole complet pour transférer ce chiffre à une autre équipe
- L’estimation de vélocité de 20 à 30 % de DX et la hausse de 41 % des économies de temps liées à l’IA d’Intercom utilisent des mesures différentes ; aucune ne confirme un rendement par défaut pour un business case
- Deux études de terrain de 2026 rapportent davantage de PR mergées dans des déploiements précis, environ 24 % chez les utilisateurs Microsoft ayant adopté les agents CLI et 2,09 fois le taux antérieur à la consigne dans une entreprise où la charge de review a environ doublé ; les PR ne sont pas de la valeur produit
- Les pull requests générées par IA sont mergées à un taux inférieur à celles écrites par des humains, 60 % contre 80 % selon les données de Jellyfish portant sur 250 000 développeurs, ce qui explique pourquoi le volume brut surestime la production réelle
- Les 1 300 PR autonomes hebdomadaires de Stripe (selon le chiffre rapporté à l’époque) et le passage d’une équipe OpenAI de 3,5 à 70 PR par ingénieur et par semaine sont réels, mais ce sont des extrêmes propres à leurs cas, pas la norme du secteur
- Un cas bas existe aussi : Max Sumrall de Picnic a rapporté du code généré par IA livré sans review suffisante et nécessitant des reprises répétées
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source