Le FinOps appliqué aux tokens : qui est responsable de la facture IA
Le FinOps cloud a commencé par une étude de coût, puis a désigné un responsable pour suivre ce coût. Trois cas de praticiens montrent cette séquence appliquée aux factures de tokens.
Aller au résumé ↓ Florian Bruniaux
The Real Cost of AI · Partie 4/9
TL;DR
Avec Opus 5.5, je pense toujours qu’un petit modèle devant le grand vaut la peine. Je n’ai pas encore exécuté le protocole de review : c’est un pari à mesurer, pas un résultat. C’est aussi l’hypothèse derrière Agent Router, dont le code est public. Le protocole de review ci-dessous permet de mesurer ce que le routage apporte. L’unité que je suis est la tâche acceptée, tentatives échouées et triage compris, pas le token, et je m’attends à une facture croissante à mesure que les agents reçoivent plus de travail.
| Décision | Test actuel |
|---|---|
| Référence de review | Mesurer Opus 5.5 sur les changements acceptés avant de conserver l’ancienne politique de routage |
| Filtre par petit modèle | Compter les économies et les changements risqués qu’il empêche le reviewer de voir |
| Reviewer supplémentaire | Exiger une contribution vérifiée après recouvrements et fausses alertes |
| Responsable des coûts | Suivre séparément dépenses de toutes les tentatives, quota et triage humain |
Opus 5.5 donne une nouvelle décision au FinOps : savoir si le modèle recommandé par défaut par Anthropic pour la plupart des charges (Fable 5.2 se situe au-dessus à 8 $ / 40 $ par million de tokens pour les raisonnements exigeants) peut terminer le travail à un coût assez bas pour simplifier le routage. La cinquième partie détaille les tarifs actuels.
Un petit modèle devant chaque review est une architecture envisagée dont les économies et omissions doivent être remesurées. La grille de novembre en partie 5 inclut Sonnet 5.5, Haiku 5.5 et les candidats GPT-6, avec seuils de taille de prompt et facturation API distincts du quota d’abonnement. Un filtre moins cher nécessite toujours son propre test d’acceptation.
La présentation du FinOps IA sur le site du guide Claude Code cartographie les régimes de coûts et leviers derrière ces choix de routage.
Retester le filtre face à une référence Opus 5.5
Passez un jeu réservé de changements au reviewer Opus 5.5 borné, puis comparez le routage filtré proposé sur les mêmes tâches. Gardez les défauts de référence indépendants cachés aux deux parcours.
Comptez le coût complet du filtre, les reviews admises, les défauts vérifiés qu’il écarte et le temps humain nécessaire pour les récupérer.
Le filtre mérite sa place si le workflow obtenu atteint la qualité requise à un coût total intéressant. S’il ajoute surtout un appel d’inférence et un mode d’échec, simplifiez le parcours.
La même règle s’applique à un reviewer généraliste supplémentaire. Le protocole publié de référence de review Opus 5.5 définit la comparaison d’effort et l’arbitrage. Ces exécutions restent à réaliser. Quand un reviewer indépendant mérite sa place précise ce qu’il doit apporter au-delà des recouvrements et fausses alertes.
Les cas de praticiens antérieurs ci-dessous expliquent l’apparition de ces routages. Leurs choix de modèles décrivent leurs équipes à l’époque, tandis que la décision d’adoption ici part d’Opus 5.5.
En juin 2025, une table ronde techready réunissait trois praticiens cloud pour parler du FinOps en pratique : mesurer et maîtriser la dépense cloud avant qu’elle ne surprenne l’équipe financière.
Le modérateur Seifeddin Mansri a posé une question précise. Le FinOps est-il apparu de bas en haut, poussé par des équipes d’ingénierie inquiètes de leur facture AWS ou GCP ? Ou de haut en bas, imposé par des décideurs voulant maîtriser les coûts avant d’approuver une migration ?
Les histoires du panel suivaient les deux voies, et celle venue d’en haut comportait une séquence que la dépense IA reproduit maintenant.
Martin, responsable FinOps chez SNCF Connect and Tech, décrivait cette version de l’intérieur : migration complète vers AWS en 2020 et 2021, avec une étape obligatoire, une étude de coût total de possession, réalisée avant le démarrage. « The company decided to migrate fully to Amazon in 2020 and 2021, and there was a study done beforehand to evaluate the TCO, okay, we’re going to the cloud, how much is that going to cost us, partly to defend the case that it would cost less on the cloud. It’s always a very complicated calculation », expliquait-il.1 Traduction fidèle : « L’entreprise a décidé de migrer entièrement vers Amazon en 2020 et 2021, et une étude a été faite avant pour évaluer le TCO : nous allons dans le cloud, combien cela va-t-il coûter, en partie pour défendre le fait que cela coûterait moins cher dans le cloud. C’est toujours un calcul très compliqué. »
Martin a rejoint ensuite l’équipe FinOps, recruté en interne depuis un rôle DevOps, pour continuer à répondre à cette question de coût après la migration.
Cette séquence, d’abord une étude de coût puis un responsable désigné pour suivre ce coût, a désormais son pendant dans les dépenses IA, après que la version cloud de la discipline est devenue un intitulé de poste.
Trois cas du corpus montrent le passage des factures d’infrastructure aux factures de tokens : un petit modèle qui garde l’entrée d’un modèle cher, un modèle local testé face à un montant en dollars et une empreinte carbone, et un développeur appliquant la même logique à un projet personnel sans comité budgétaire à l’horizon.
Un modèle peu coûteux lit le diff avant le modèle coûteux
Sneha Tuli, Principal Product Manager chez Microsoft, a décrit le mécanisme à DevCon Fall 2025 d’aidevcon, dans une conférence publiée le 21 novembre 2025. Son équipe avait déployé la code review assistée par IA dans l’entreprise : plus de 90 % des pull requests, touchant plus de 95 % des développeurs.
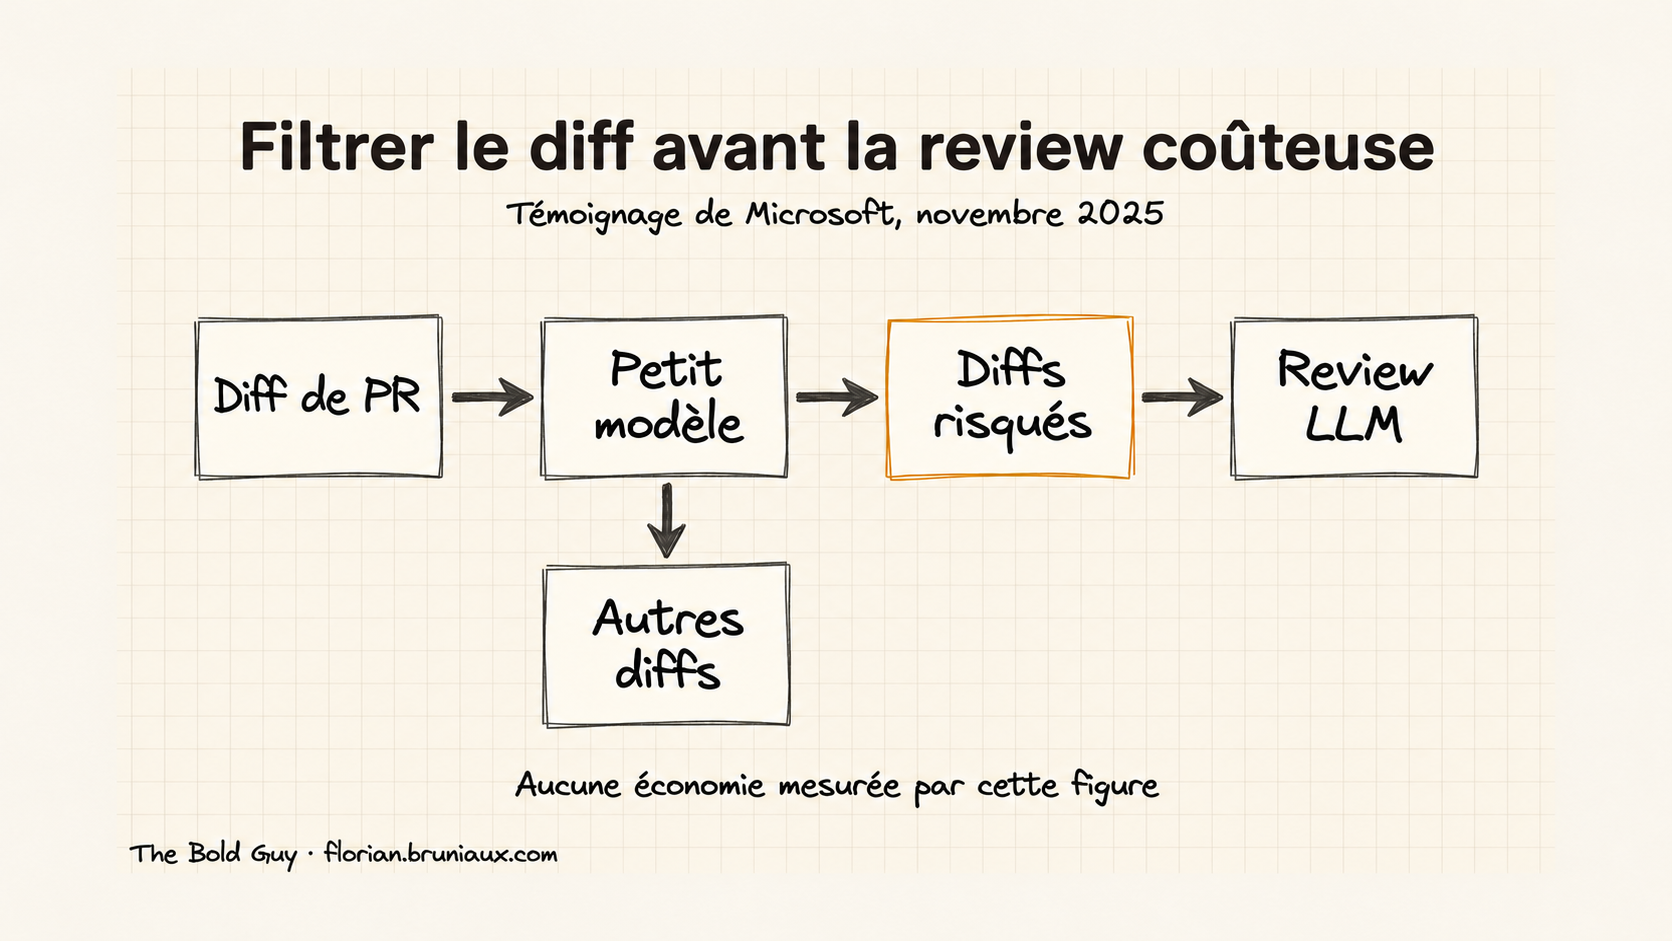
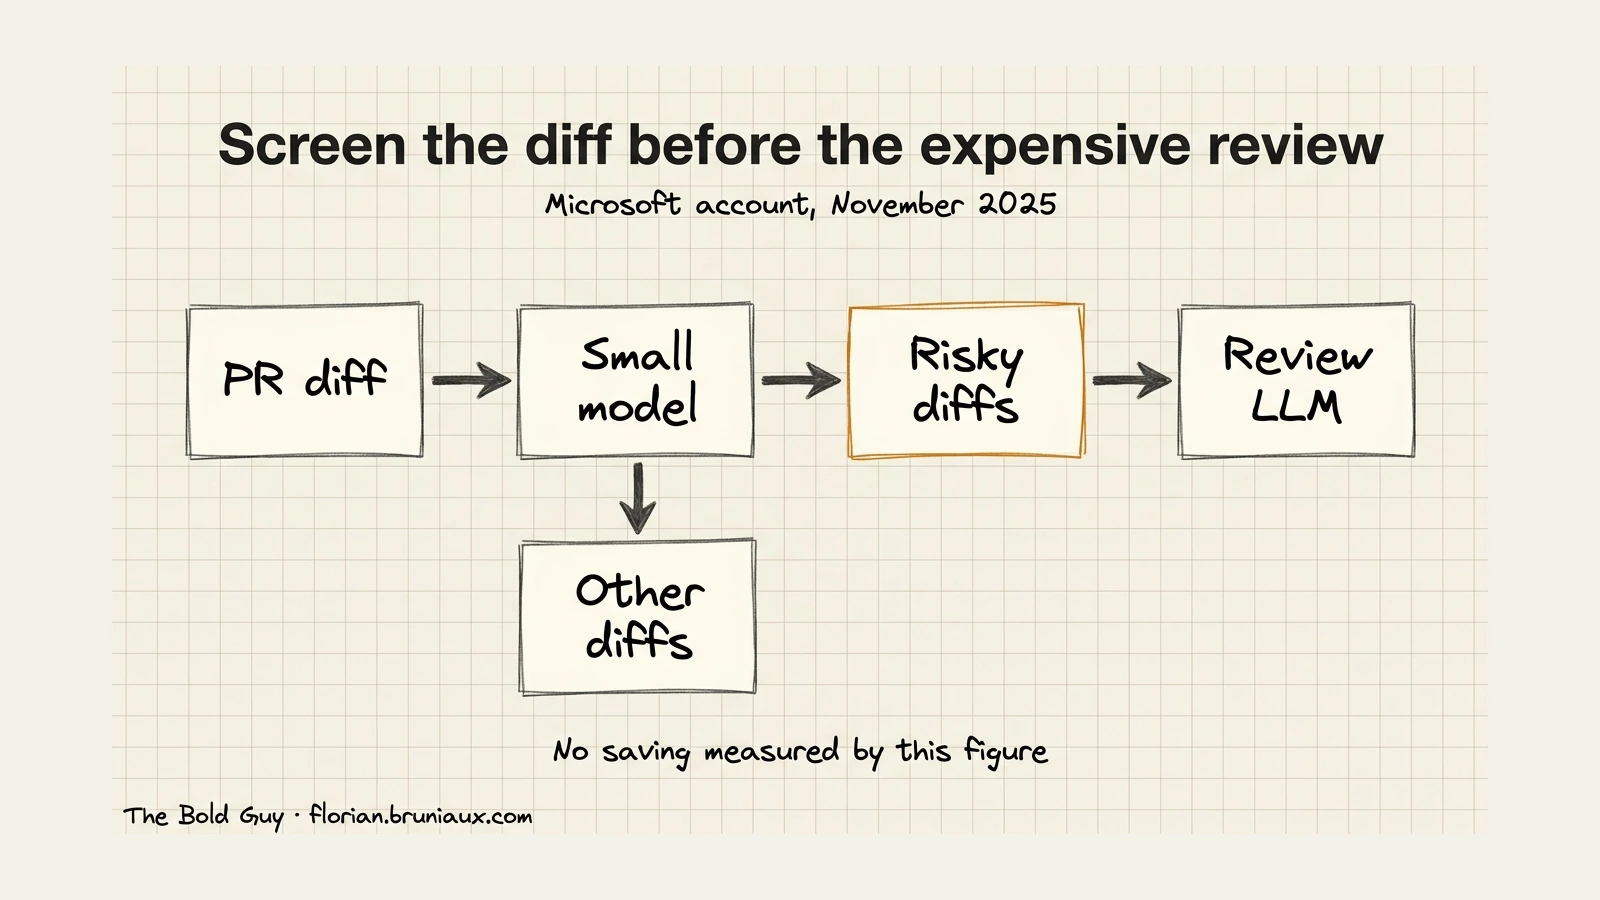
Il fallait d’abord résoudre un problème de confiance. « We had to earn trust. Initially we were kind of spamming the developers with a lot of comments, so we created a small language model based on past reviews. Any time a PR was created, the diffs were passed through this SLM, which was hosted by us. Not only did it save cost, but only important, risky diffs were now getting sent to the LLM. This reduced the noise significantly. » Traduction fidèle : « Nous devions gagner la confiance. Au début, nous spammions un peu les développeurs avec beaucoup de commentaires. Nous avons donc créé un petit modèle de langage fondé sur les reviews passées. À chaque création de PR, les diffs passaient dans ce SLM que nous hébergions. Cela réduisait les coûts et seuls les diffs importants, risqués, étaient désormais envoyés au LLM. Le bruit a nettement diminué. »
Le filtre remplit deux fonctions. Tuli rapporte une économie, car un petit modèle examinant chaque diff coûte moins par diff qu’un LLM de pointe. Elle rapporte aussi moins de bruit pour les développeurs, seuls les diffs signalés comme risqués par le SLM atteignant le modèle qui rédige les commentaires.
Elle ne donne aucun chiffre d’économie.
Doctolib essaie la même réponse pour le coût et le carbone
Thomas Bentkowski, Product Manager chez Doctolib, a nommé ensemble coût et impact environnemental parmi cinq freins rencontrés en étendant les outils IA de 30 à 600 ingénieurs, dans une conférence publiée le 24 septembre 2025.
Sur le coût, envoyer assez de volume à un modèle de pointe cher facturé par million de tokens « could indeed create a huge bill at the end » (traduction : « pourrait effectivement produire une énorme facture à la fin »), disait-il.
Sur l’impact environnemental, il restait prudent quant aux limites de ce qui est effectivement documenté. « There’s no real big papers available yet on the carbon footprint emitted by those LLMs », disait-il, « but we are trying to contextualize the usage of those LLMs inside the global scheme of everything. » Traduction fidèle : « Il n’existe pas encore vraiment de grandes publications disponibles sur l’empreinte carbone de ces LLM, mais nous essayons de replacer leur usage dans le tableau global. »
En septembre 2025, Doctolib testait ce même type de réponse. « Recently OpenAI released gpt-oss with 20 billion parameters, which is great to actually work in local », expliquait Bentkowski, « so we’re trying to leverage those on specific use cases and limiting the LLM usage running into data centers. » Traduction fidèle : « OpenAI a récemment sorti gpt-oss à 20 milliards de paramètres, ce qui est très bien pour travailler en local. Nous essayons donc de l’utiliser sur des cas précis et de limiter l’usage des LLM exécutés en data centers. »
L’expérience visait à répondre aux questions de coût et d’impact environnemental en traitant localement des cas d’usage restreints. Bentkowski n’a rapporté ni économie mesurée ni réduction d’empreinte dans la conférence.
Appliquer la même décision à un projet personnel
Le retour de Nicolas Martignole de décembre 2025 sur un jeu de rôle séparait narration fréquente et travail de code moins fréquent, avec des budgets modèles différents.
La décision transférable est d’identifier l’appel répété, sa qualité requise et son coût. La paire historique de modèles ne détermine pas le routage actuel.
Pour une configuration Opus 5.5, comparez un parcours simple à toute séparation proposée sur les tâches réellement répétées par l’application. Incluez les nouvelles tentatives et le coût de maintenance d’un autre adaptateur de modèle.
Un rôle peu coûteux par appel peut dominer le total s’il tourne à chaque interaction. L’étude de cas de l’observateur mémoire local mesure ce problème d’appels répétés avec des limites explicites de délai et de qualité. Le rapport OpenRouter chez Back Market examine une autre réponse : budgets par personne et sélection des fournisseurs pour une équipe.
Séparer l’adoption du coût du travail
Le retour d’Uber Engineering sur son usine logicielle (27 août 2026) rapporte un coût par 1 000 requêtes inférieur de près de 34 % et un coût par session inférieur de 52 % à leurs pics respectifs, avec un modèle fixe. Son benchmark uReview combine PR à bugs connus, précision, rappel, F1, coût, latence, dépassements de délai et bruit.
Ce retour décompose la dépense en 6 facteurs :
users × sessions/user × turns/session × requests/turn
      × tokens/request × price/token
Cette décomposition aide à choisir une intervention. Plus de sessions peut refléter l’adoption ; plus de requêtes dans une même tâche peut refléter des recherches répétées, appels d’outils échoués ou corrections. Séparez entrées, sorties, lectures et écritures de cache lors du chiffrage. Un tarif moyen unique peut cacher le changement de répartition.
Ce sont des observations internes d’Uber, pas une expérience appariée reproduite ici. Un modèle fixe seul ne garde pas constants les types de tâches ni l’acceptation, et aucun des deux coûts unitaires n’établit le coût par changement accepté. Pour la comparaison de routage ci-dessus, gardez les mêmes tâches et règle d’acceptation, puis ajoutez review, reprises et tentatives échouées à la période de comptabilisation. La méthode d’économie unitaire IA du guide définit plus précisément ce dénominateur.
Mise à jour du 6 novembre 2026. Pour suivre les usages d’une équipe, l’offre RTK Pro mérite aussi un coup d’œil. Sa page présente le suivi des tokens par équipe et par projet, ainsi que la gestion des coûts. J’ai contribué à RTK dès ses débuts et je suis toujours le projet, même si je ne travaille plus activement sur son code. Ce lien est une piste à examiner, pas un résultat mesuré d’économie.
Là où la version individuelle manque de signal
Le moteur de jeu de Martignole fonctionne encore avec une clé API facturée à l’usage, comme son reçu de 214 $ de la première partie : chaque choix de modèle apparaît comme une ligne inspectable. Un utilisateur de Claude Code par abonnement n’a pas cela.
La deuxième partie couvrait le même angle mort côté dépense : un compte Claude Max ou Pro n’a aucune facture par appel à lire, et le calcul fait face caméra par Martignole ne dispose donc d’aucune donnée d’entrée.
Un forfait n’a pas de ligne de facture prouvant qu’un modèle moins cher a économisé quoi que ce soit, car le prix mensuel fixe masque le calcul des tokens exposé par défaut dans un compte à l’usage.
Les limites d’usage s’appliquent toujours : Anthropic a annoncé un crédit séparé pour claude -p et l’Agent SDK en juin 2026, puis l’a suspendu ; cet usage est donc toujours décompté des quotas de l’abonnement (centre d’aide Claude).
Cartographier la boîte à outils de réduction de tokens traite directement cette version : ce que devient une discipline de réduction de tokens sur Claude Max ou Pro, avec prix mensuel fixe et fenêtre de contexte comme principal levier restant.
Le FinOps organisationnel décrit ici, rôle dédié, étude TCO, petit modèle filtrant les diffs, suppose l’existence d’une facture sur laquelle fonder l’optimisation. Sa version individuelle doit construire son signal depuis les habitudes d’usage, sans facture pour vérifier le calcul.
Ce que le FinOps comprend encore mal
Les cas antérieurs faisaient des prix des tokens un déclencheur visible de maîtrise des coûts. L’évaluation Opus 5.5 ajoute une unité de décision plus utile : la tâche acceptée, tentatives échouées et triage compris.
La troisième partie montrait l’écart que ce chiffre doit gérer : un gain de productivité mesuré de 15 à 20 % face aux multiplicateurs commerciaux dépassant 10x, et un vrai budget doit se construire sur l’un de ces chiffres plutôt que l’autre.
C’est l’écart qu’un rôle FinOps doit combler, en chiffrant le coût d’un token et en évitant les tokens coûteux par le routage.
Le FinOps IA pratiqué ci-dessus suppose que le prix par token mesure la dépense. Ce n’est généralement pas le cas.
Certains tokens coûtent bien plus que d’autres sur le même modèle : ceux qu’un agent bavard brûle pour atteindre une réponse qu’un agent plus concis atteint plus vite, et ceux qu’il renvoie inchangés à chaque tour faute de cache.
La partie suivante démonte cette hypothèse.
YSNK
(Ce que vous devriez maintenant savoir)
- Le FinOps IA commence à reproduire la séquence de migration cloud de SNCF Connect : étude de coût d’abord, puis responsable désigné pour suivre ce coût
- La review IA de Microsoft couvre plus de 90 % des pull requests, et un petit modèle n’envoie que les diffs risqués au LLM ; Sneha Tuli rapporte une réduction des coûts et du bruit
- En septembre 2025, Doctolib testait un modèle local à 20 milliards de paramètres (gpt-oss) pour traiter coût des tokens et empreinte carbone, sans économie mesurée rapportée dans la conférence
- Une référence Opus 5.5 permet de tester si un filtre ou reviewer supplémentaire mérite encore son coût d’exécution et de maintenance
- Un forfait Claude Max ou Pro n’a pas de facture par appel montrant une économie. La version organisationnelle du FinOps suppose l’existence d’une facture sur laquelle fonder l’optimisation, et la version individuelle n’en a pas
Footnotes
-
Français original : « l’entreprise a décidé de migrer intégralement sur Amazon sur 2020 et 2021, et il y a eu une étude qui a été faite avant pour évaluer le TCO, ça allait nous coûter combien, pour en fait aussi défendre le fait que ça allait coûter moins cher sur le cloud, c’est toujours très compliqué comme calcul ». Martin, SNCF Connect and Tech, table ronde techready, juin 2025. ↩
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.