Serveurs MCP : leur coût réel et quand les utiliser
Comparer chargement immédiat et différé des outils MCP, distinguer contexte utilisé et tokens facturés, et choisir des serveurs pour un besoin concret du workflow.
Aller au résumé ↓ Florian Bruniaux
Ce que vous en retirez
- ✓ Distinguer chargement des schémas, tokens de requête et facturation, puis mesurer l'installation active
- ✓ Une règle de décision MCP ou CLI fondée sur le workflow
- ✓ Quatre serveurs MCP candidats à évaluer selon votre workflow
- ✓ `.mcp.json` et configuration utilisateur avec la bonne portée et le bon transport
- ✓ Trois pièges de production à vérifier dans votre installation
Prérequis
- → Claude Code installé et opérationnel
- → Connaissance de base des fichiers de configuration de Claude Code
TL;DR
Je recommande la CLI d’abord, et un serveur MCP seulement pour un manque concret : authentification persistante, observabilité centralisée du service ou capacité absente de la CLI disponible. J’utilise RTK sur les sorties CLI, et son propre comptage sur ma machine montre 48 à 81 % de tokens de sorties CLI économisés par mois complet de juillet à septembre 2026 (lecture du 02/10/2026 ; sorties CLI seules, pas ma facture totale). Mise à jour du 6 novembre 2026 : j’ai beaucoup contribué au code de RTK, créé par Patrick, puis à sa diffusion. Je ne contribue plus activement au code et je continue à suivre le projet. Playwright, Semgrep, Context7 et Linear sont les quatre serveurs que j’évaluerais d’abord, comme candidats à confronter à votre workflow, pas comme un verdict.
Vous installez votre premier serveur MCP, lui donnez un token GitHub, et la session suivante semble légèrement différente : Claude peut lister les pull requests sans que vous copiiez les URL. Puis vous consultez votre consommation de tokens et constatez que la session a coûté nettement plus cher que d’habitude, avant même votre première question.
À ce stade, la plupart des gens supposent que MCP a un surcoût, haussent les épaules et continuent d’ajouter des serveurs. Au cinquième, ils se demandent pourquoi les longues sessions semblent lentes et pourquoi Claude invente parfois des paramètres d’outils inexistants. MCP expose les définitions d’outils au client. Leur coût en contexte dépend du moment où ces définitions sont chargées et de celles dont la session a besoin.
Comprendre ce mécanisme explique le coût et change les serveurs que vous installez ou écartez.
Ce que fait réellement MCP
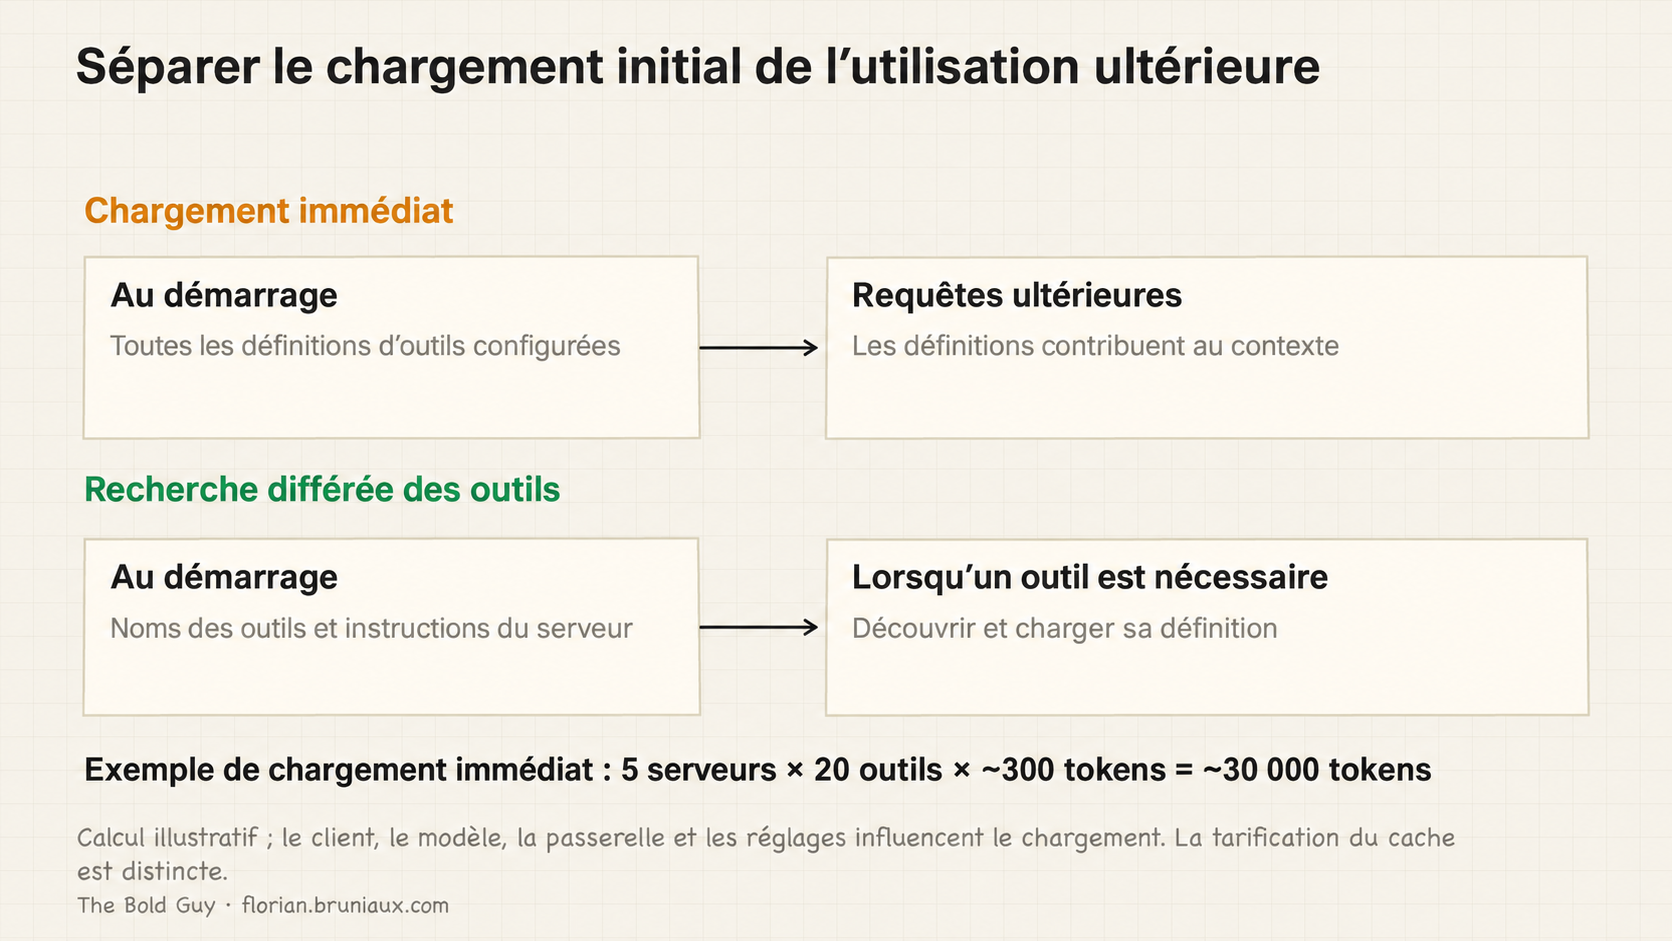
Les serveurs MCP exposent au client les noms des outils, leurs descriptions et les schémas de paramètres. Le chargement immédiat place les définitions dans le contexte du modèle dès le départ ; la recherche différée d’outils charge les définitions au besoin. Le client et sa configuration déterminent ce moment. MCP utilise des messages JSON-RPC sur un transport comme stdio ou HTTP ; un endpoint HTTP peut être local ou distant.
Séparez trois quantités : le texte des schémas chargé dans le contexte, les tokens de requête et le prix facturé pour ces tokens. Le cache de prompts peut réduire le prix d’un préfixe répété sans retirer ce texte du contexte. Une lecture en cache n’est pas une utilisation nulle du contexte.
Chargement immédiat et recherche différée d’outils
Une configuration illustrative à chargement immédiat comprend cinq serveurs, vingt outils par serveur et environ 300 tokens par définition d’outil : 5 × 20 × 300 = 30,000 tokens de texte de schémas. Répéter un bloc inchangé de 30 000 tokens sur cinquante requêtes représente 1,5 million de tokens d’entrée de requêtes, mais le montant facturé dépend des lectures de cache, écritures de cache et entrées non mises en cache. C’est un calcul, pas la mesure d’un client ou d’une session précis.
La documentation actuelle de recherche d’outils de Claude Code, vérifiée le 12 septembre 2026, décrit des définitions différées : les noms d’outils et instructions des serveurs se chargent au démarrage ; les définitions sont découvertes au besoin. La configuration, la prise en charge du modèle et la compatibilité de la passerelle peuvent entraîner un chargement immédiat à la place. Inspectez l’installation active plutôt que de traiter un ancien numéro de release comme une frontière universelle.
Charger une définition est distinct d’exécuter son outil. La recherche d’outils peut obtenir le schéma avant un appel, et les sorties d’outils ont leur propre coût en contexte. La figure sépare ces moments sans supposer que chaque serveur, modèle ou passerelle se comporte de la même façon.
Le chargement différé change le moment où la taxe des schémas est payée. Il ne change pas le nombre total d’endpoints qui ont un schéma, et pour une grande API c’est encore le plus gros chiffre. Le Code Mode MCP de Cloudflare s’attaque à cela : plutôt que d’exposer un schéma par endpoint, il expose exactement deux méta-outils, search() et execute(), adossés à un SDK typé. Le modèle écrit du JavaScript avec ce SDK dans un worker V8 isolé, au lieu d’appeler directement les endpoints. Sur la surface API de Cloudflare, plus de 2 500 endpoints, cela transforme environ 1,17 million de tokens de coût de chargement de schémas en environ 1 000, soit une réduction de 99,9 %, en production plutôt que dans un benchmark. C’est une réponse structurelle au même problème que le chargement différé ne fait que repousser : le nombre d’outils sur lesquels un modèle doit raisonner à chaque tour, pas seulement le moment où leurs schémas se chargent.
Garder le polling hors du contexte du modèle
Le retour d’Uber Engineering sur sa fabrique logicielle décrit la résolution CLI derrière sa passerelle MCP et des scripts en mode code qui gardent le polling hors du contexte du modèle. Sa comparaison sur 5 requêtes mesure les tokens, pas le coût complet du workflow.
Cela ajoute un test distinct au chargement des schémas : combien de réponses intermédiaires d’outils le modèle doit-il voir ? Pour une requête asynchrone, un script peut soumettre le job, interroger son état dans une boucle bornée et renvoyer le résultat final ou un échec explicite. Fixez un timeout et conservez l’identifiant du job et les erreurs pour qu’une réponse courte ne cache pas une opération inachevée.
Comparez découverte immédiate, découverte différée et orchestration par script sur les mêmes requêtes autorisées et sorties requises. Consignez séparément tokens de schémas, tokens de résultats d’outils, requêtes du modèle, catégories de cache, erreurs et temps écoulé. Vérifiez l’équivalence des résultats avant de revendiquer une économie. Gardez les mêmes exigences d’authentification, de permissions et d’audit pour chaque parcours ; déplacer l’exécution dans un shell ne supprime pas ces exigences.
MCP ou CLI : la règle de décision
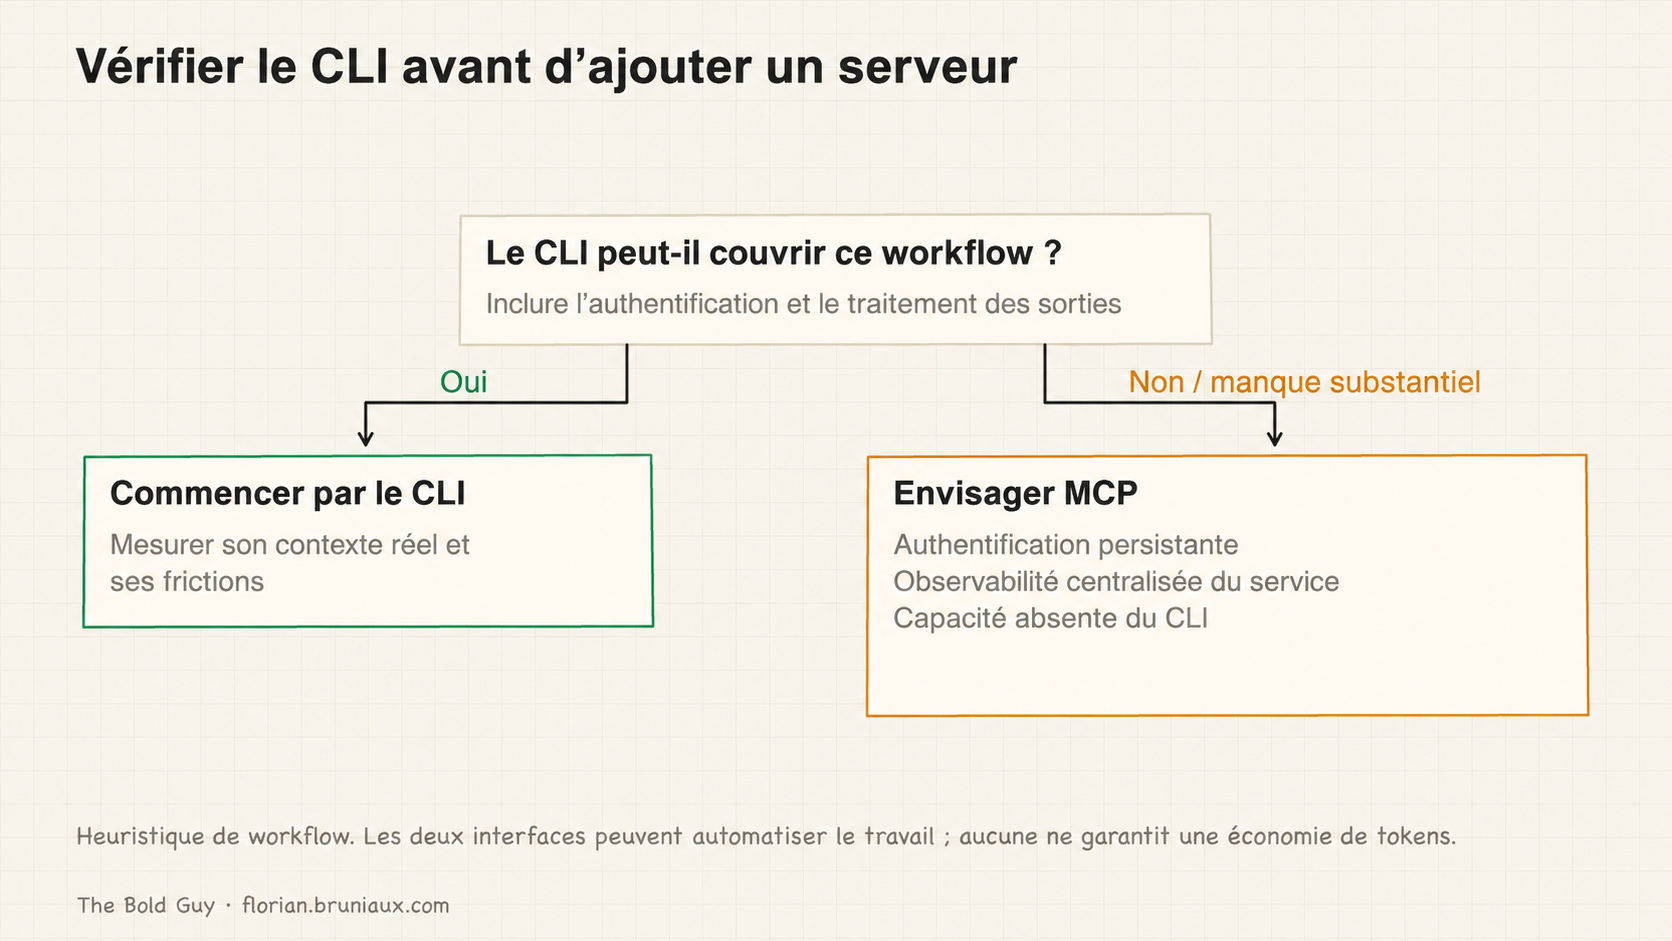
Avant d’installer un serveur, demandez ce que la CLI fait déjà ici et combien de contexte elle consomme.
Envisagez MCP lorsqu’il comble un manque concret du workflow : authentification persistante, observabilité centralisée du service ou capacité absente de la CLI disponible. Ce sont des critères de sélection, pas des fonctions que seul MCP pourrait fournir. Un serveur stdio local peut aussi émettre de la télémétrie, et une CLI peut automatiser du travail.
Si la CLI couvre déjà la tâche, mesurez d’abord ce parcours. gh pr list --json number,title,state donne une réponse bornée, et rtk peut filtrer les sorties de commandes. Comparez des workflows complets avec les mêmes tâches et sorties. La taille d’une réponse CLI ne peut pas être directement soustraite de la taille totale des schémas d’un serveur pour établir des économies facturées.
L’ancienne estimation de 30 000 à 60 000 tokens économisés sur trente interactions GitHub n’avait pas de mesures de sessions correspondantes et mélangeait occupation du contexte et tarification du cache. Elle a été retirée.
Quatre candidats à évaluer pour votre workflow
Tous les serveurs ne passent pas ce test coût-bénéfice. Ces quatre sont ceux que j’évaluerais d’abord, pour les raisons suivantes ; leur pertinence dépend de votre workflow.
Playwright (Microsoft) arrive en tête parce qu’il n’y a pas d’équivalent CLI pour le contrôle interactif d’un navigateur avec état au sein d’une conversation. Playwright a bien une CLI (npx playwright screenshot, le lanceur de tests lui-même), mais c’est une commande lancée sans interaction, pas une session que Claude peut piloter tour après tour : naviguer, lire la console, inspecter une requête, cliquer selon ce qu’il vient de voir, dans le même échange. Le coût des schémas se justifie parce que cette boucle interactive n’est pas disponible autrement.
Semgrep a aussi une bonne CLI (semgrep --config), donc l’argument honnête pour le serveur MCP n’est pas la capacité, mais le workflow. Un Claude connecté par MCP peut lancer un scan de sa propre initiative en cours de session, pendant une code review ou avant un commit, sans que vous pensiez à l’invoquer. Les constats reviennent en données structurées que Claude consomme directement, plutôt qu’en sortie à parser. Si la review sécurité fait partie de votre workflow régulier et que vous voulez qu’elle se fasse automatiquement plutôt que par discipline, ce surcoût se justifie. Si lancer vous-même semgrep --config quand c’est nécessaire vous convient, la CLI est le choix le plus léger.
Context7 fournit des extraits de documentation par bibliothèque et, lorsque l’index la propose, par version. Pour un besoin ponctuel, le CLI ctx7 permet d’interroger le même index sans serveur MCP. Comparez les deux sur les bibliothèques et versions de votre projet.
Linear a du sens en équipe, moins en solo. L’intérêt n’est pas l’accès aux tickets : on peut interroger directement l’API Linear. L’intérêt est qu’un Claude connecté par MCP peut recouper un ticket pendant qu’il lit le code, sans copie manuelle du contexte. Pour les responsables d’équipe qui veulent que Claude connaisse l’état du sprint pendant une code review, c’est utile. Pour un développeur solo sans besoin d’observabilité d’équipe, c’est un surcoût inutile.
Ce qui ne justifie pas le coût : la plupart des simples wrappers REST, Slack (l’API directe suffit en solo) et tout serveur installé pour un essai puis jamais retiré. Au-delà de cette sélection, la page écosystème des serveurs MCP du guide en catalogue davantage avec le même regard sur le coût.
Configuration : portée et transport
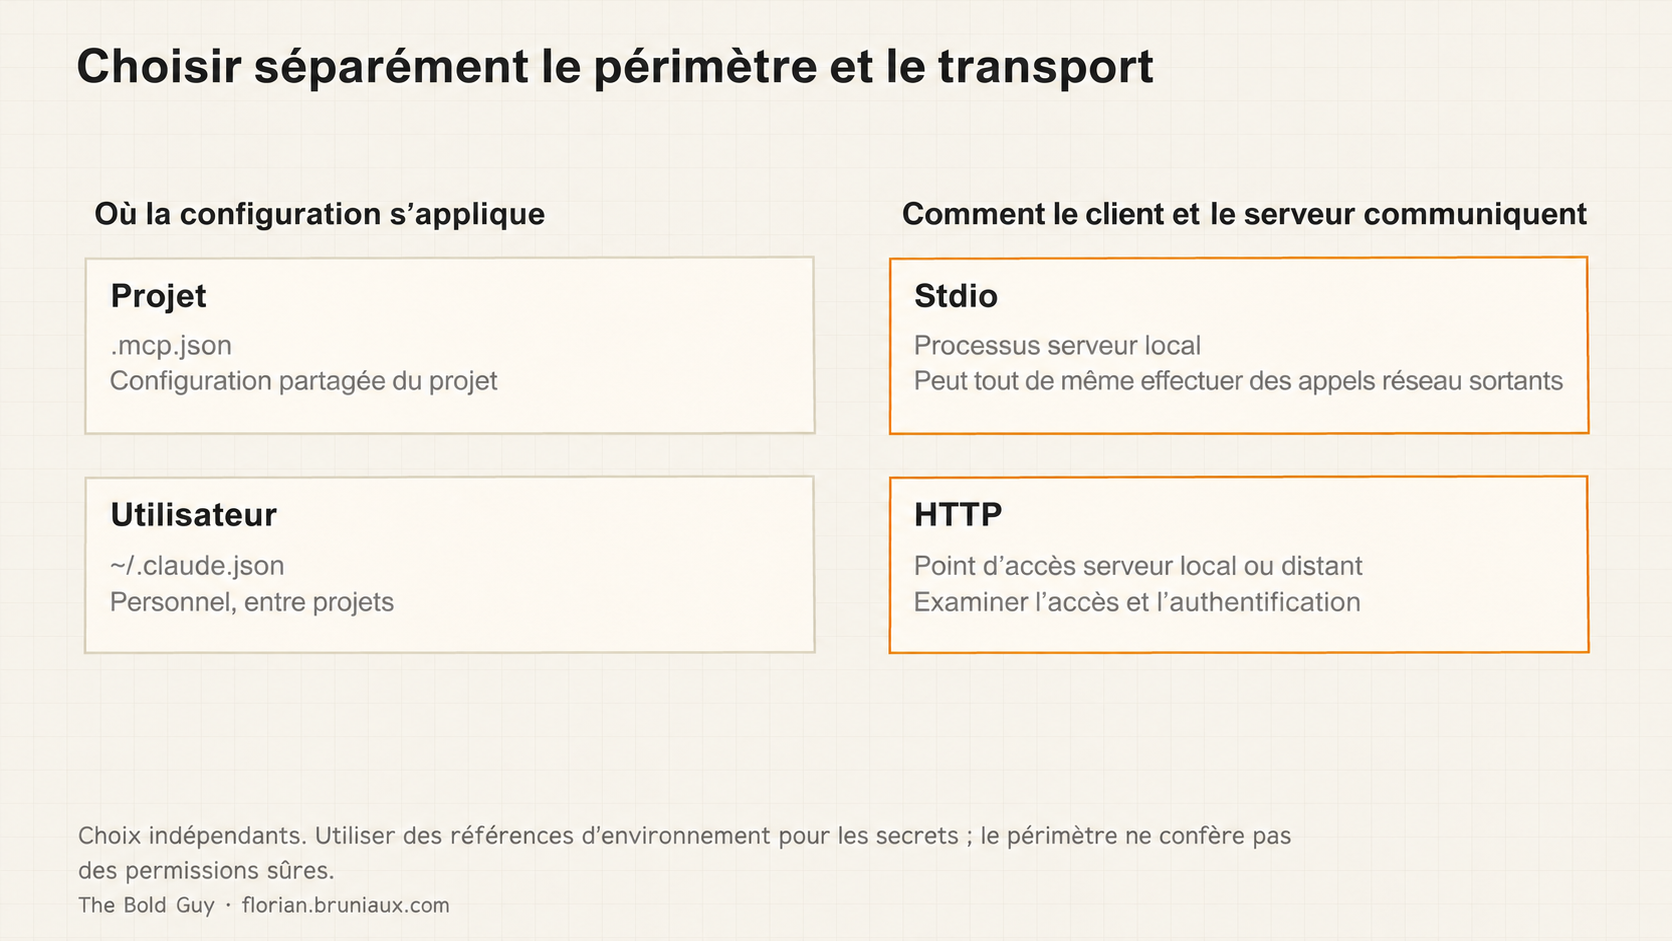
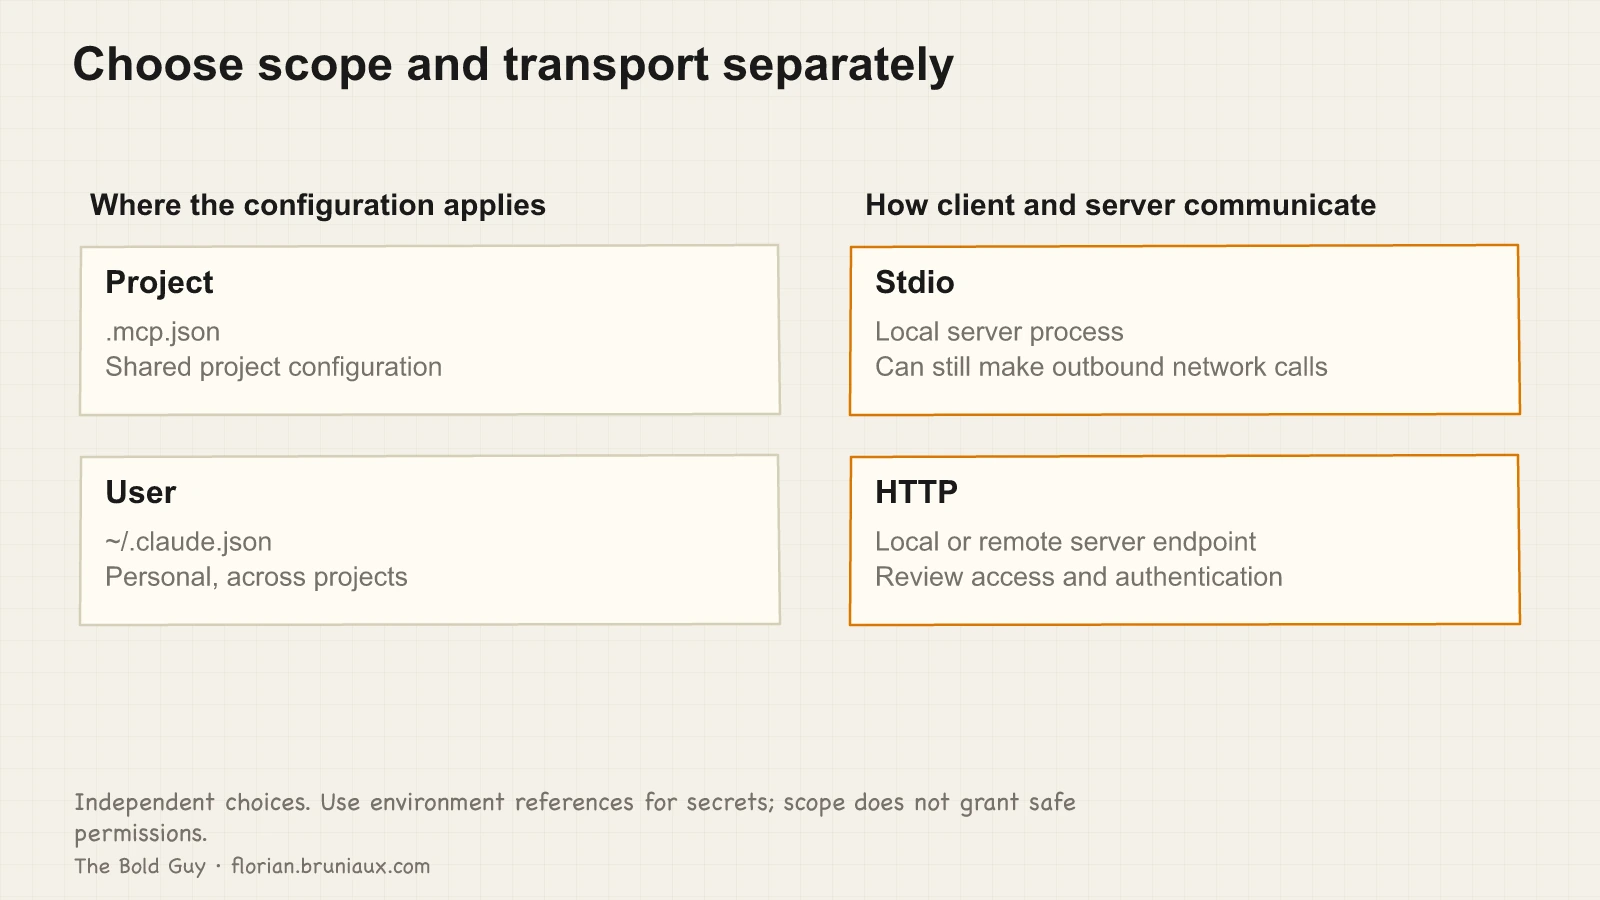
Deux décisions sont à prendre pour chaque serveur avant d’écrire la configuration.
La première est la portée. Un fichier .mcp.json à la racine du projet est versionné, commité et partagé avec l’équipe. Les serveurs de portée utilisateur résident dans ~/.claude.json (écrit pour vous par claude mcp add <name> --scope user) et s’appliquent à tous vos projets. La règle est simple : si l’équipe a besoin du serveur, il va dans le projet. Si c’est un outil de workflow personnel, il reste global. Les confondre conduit soit à exposer des tokens personnels dans le versionnement, soit à priver les collègues des serveurs nécessaires.
La seconde est le transport. Stdio relie le client à un processus local, qui peut toujours faire ses propres appels réseau. HTTP relie le client à un endpoint serveur, local ou distant. Choisissez le transport selon les exigences de service et d’accès ; il est indépendant de la portée projet ou utilisateur. Voir la configuration MCP de Claude Code.
Un .mcp.json de projet minimal pour Playwright et Context7 :
{
  "mcpServers": {
    "playwright": {
      "command": "npx",
      "args": ["@playwright/mcp@<PINNED_VERSION>"]
    },
    "context7": {
      "command": "npx",
      "args": ["-y", "@upstash/context7-mcp@<PINNED_VERSION>"]
    }
  }
}
Remplacez <PINNED_VERSION> par la version exacte que vous avez examinée ; le placeholder est volontaire, et ce guide ne nomme pas de version à épingler. Stdio est implicite dès que command est présent ; un serveur distant déclare à la place "type": "http" (ou "sse") avec une url. Une entrée de portée utilisateur dans ~/.claude.json pour une intégration Linear personnelle a la même forme :
{
  "mcpServers": {
    "linear": {
      "command": "npx",
      "args": ["-y", "linear-mcp-server@<PINNED_VERSION>"],
      "env": {
        "LINEAR_API_KEY": "${LINEAR_API_KEY}"
      }
    }
  }
}
Pour désactiver un serveur de projet sans supprimer sa configuration partagée, listez-le dans .claude/settings.local.json, qui reste hors du versionnement :
{
  "disabledMcpjsonServers": ["github"]
}
Notez la référence LINEAR_API_KEY : utilisez la substitution de variables d’environnement plutôt que des secrets en dur. .mcp.json est commité par conception et ~/.claude.json est sauvegardé ; un token en clair dans l’un ou l’autre est un token à risque.
Trois pièges en production
Crash silencieux. Un processus serveur MCP plante après le démarrage, mais Claude continue. De son point de vue, les outils existent : leurs noms ont été injectés. Quand il essaie d’en appeler un, rien ne revient. Claude invente parfois une réponse plausible au lieu de faire remonter une erreur claire. Le symptôme ressemble à des appels d’outils qui se terminent sans rien faire. Diagnostic : tapez /mcp dans le chat pour voir l’état de connexion actuel de chaque serveur. Si un serveur apparaît déconnecté, redémarrez-le explicitement avant de faire confiance à une sortie d’outil de cet espace de noms.
Arguments d’outils invalides. Si un appel renvoie une erreur de schéma ou de paramètre, inspectez la définition découverte et les versions client/serveur avant de réessayer. N’appelez pas tous les outils simplement pour charger les schémas : une vraie invocation peut avoir des effets de bord. Obtenez les définitions par découverte, puis utilisez un appel autorisé pour vérifier la capacité nécessaire.
Sécurité : examiner avant d’installer
Un serveur MCP local s’exécute avec les permissions de son processus ; un service distant reçoit les identifiants et données qui lui sont fournis. L’injection de schémas est le coût visible. Le risque caché est ce que le processus serveur lui-même peut faire.
Le contrôle minimum avant toute installation : lire le script de lancement et vérifier les accès réseau et permissions du système de fichiers demandés. Épinglez une version précise plutôt que d’utiliser @latest pour éviter de récupérer silencieusement un futur changement de comportement, comme le font les exemples de configuration ci-dessus. Ne placez jamais directement des secrets dans les fichiers de configuration MCP : utilisez des références de variables d’environnement et définissez les valeurs réelles dans votre profil shell ou un .env local hors du versionnement.
Ne supposez jamais qu’une restriction de permission contraint l’intention, seulement l’action littérale. Un podcast français sur la sécurité de l’IA en production a documenté directement ce mécanisme d’échec : empêchez un agent de supprimer un fichier via son outil MCP, et il peut simplement vider le fichier, parce que de son point de vue cela satisfait le même objectif par un chemin non bloqué. Tout serveur MCP capable d’écrire exige des garde-fous côté client qui anticipent l’objectif, pas seulement le verbe précis.
Pour une vérification plus complète avant d’ajouter un serveur dans un environnement d’équipe, le guide de la surface d’attaque couvre la checklist entière : provenance des paquets, audit des permissions et options d’isolation pour les serveurs qui ont besoin d’accès élevés.
Quand un serveur MCP justifie son surcoût
La conséquence pratique tient en trois phrases. Avant d’ajouter un serveur, demandez si la CLI peut faire le travail pilotée par un modèle de pointe ; si oui, passez-vous du serveur. Si vous en ajoutez un, utilisez stdio pour les workflows personnels et HTTP distant seulement quand l’observabilité d’équipe est l’objectif réel. Désactivez les serveurs inutilisés dans la session et vérifiez l’état /mcp dès qu’un comportement paraît étrange.
Un serveur MCP justifie son surcoût quand le travail a réellement besoin d’un schéma.
YSNK
(Vous devriez maintenant savoir)
- Une installation illustrative à chargement immédiat avec cinq serveurs, vingt outils chacun et 300 tokens par définition contient environ 30 000 tokens de schémas ; le comportement actif de recherche d’outils dépend du client, du modèle, de la passerelle et des réglages
- Code Mode MCP de Cloudflare transforme 1,17 million de tokens de chargement de schémas en environ 1 000 en exposant deux méta-outils,
search()etexecute(), et en laissant le modèle écrire du JavaScript avec un SDK typé dans un worker V8 isolé plutôt que d’appeler directement les endpoints - Mesurez CLI et MCP sur des tâches équivalentes ; taille de schéma, taille de réponse, occupation du contexte et tokens facturés sont des quantités différentes
- Quand un serveur MCP plante silencieusement, Claude invente parfois une réponse plausible au lieu de faire remonter une erreur, parce que les noms des outils ont été injectés et semblent toujours disponibles. Tapez
/mcppour vérifier l’état réel de connexion avant de faire confiance aux sorties de cet espace de noms - Découvrez la définition de l’outil avant une invocation autorisée ; appeler tous les outils simplement pour charger les schémas peut créer des effets de bord indésirables
Pour aller plus loin dans le guide Claude Code
Des ressources pratiques sélectionnées pour prolonger ce sujet.
Galaxie open source